posts/qwen-ui-agent-delivery-gap.md
Qwen-UI-Agent 榜单领先,开源开发者还用不上
把手机相册里的收据找出来,传到电脑,按日期重命名,再生成一份 Excel 报销表。
以前这像一张写给实习生的操作清单。现在,Qwen-UI-Agent 官方项目页把它做成了一个模型任务。智能体从手机跨到电脑,既点界面,也敲命令,最后交付文件。
这两天,千问又把 Qwen-UI-Agent 推到了聚光灯下。公开报道里的数字很猛,MobileWorld 82.1%,真机基准 MobileWorld-Real 92.2%,AndroidDaily 97.5%,OSWorld-Verified 79.5%,WebArena 73.6%。
好家伙,几乎每块屏幕都有一个能拿出来讲的成绩。
可我把公开 GitHub 目录翻了一遍,里面目前是 README、assets 和技术报告,没有 Qwen-UI-Agent 的权重下载、推理代码或部署说明。仓库是公开的,研究材料也很完整,但一个普通开发者今天还不能照着文档把它接进自己的产品。
所以这篇不复读榜单。我更想聊那条容易被热闹盖住的缝。
Qwen-UI-Agent 已经证明 GUI 智能体能走很远,可从「会操作」到「可交付」,中间还隔着模型、运行时、验证与权限四层工程。
真正厉害的不是点得准,是把四种世界放进一条轨迹
GUI 智能体最容易被拍成演示视频。鼠标自己动,手机页面自己跳,表格自己出现。看起来像魔法,实际最难的部分往往不在那只会动的光标。
网页、桌面软件和手机应用不是同一种环境。网页有 DOM,可以读结构。桌面应用经常只剩像素、窗口树和快捷键。手机还多一层系统权限、通知、账号状态与网络波动。跨设备时,文件、身份和任务状态又得跟着一起走。
技术报告给出的方案,不是训练一个只会看截图点坐标的窄模型,而是把移动端、电脑端、浏览器和 DeepSearch 放进同一个基础 GUI 智能体。它的动作空间里既有点击、滑动和输入,也有 CLI,也就是命令行操作。电脑任务中,命令行与 GUI 点击成了两类主要动作,约 40% 的输出会在一次决策里批量给出多个动作。
这一手有点子牛逼。
人用电脑时本来就不会死磕鼠标。改一批文件,命令行更稳。填一个没有 API 的旧系统,只能点界面。找资料需要浏览器,整理结果又适合脚本。让智能体在 GUI 与 CLI 之间选路,比训练一只点击更快的电子手指更接近真实工作。
它背后还有一层 harness,可以理解成给模型搭的脚手架。模型负责判断下一步,脚手架负责接通知、保存状态、调起设备、执行动作、收集结果、处理失败,再把环境变化喂回模型。官方演示里的航班取消,不是用户先打开聊天框下命令,而是运行时收到通知后主动拉起任务,比较机票和高铁,再把最终购买留给用户确认。
模型像脑子,harness 像手脚、神经和安全带。只秀脑子跑分,不把这层工程算进去,生产能力会被高估得很离谱。
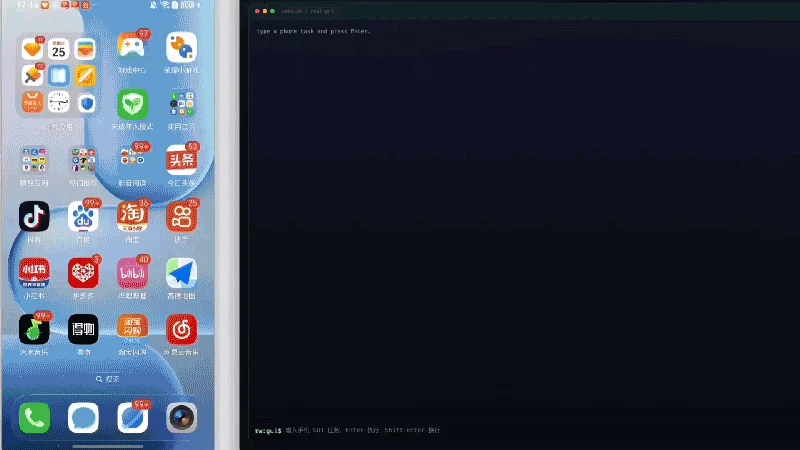
官方演示把手机界面与电脑终端放在同一条任务轨迹里,重点不是跨屏炫技,而是状态如何连续。
训练规模也在往真实世界靠。MobileWorld-Real 页面对应的真机环境覆盖 100 多台实体手机、150 多个应用,自建基准有 400 多个任务、100 多个应用。在线强化学习处理超过 100 步的轨迹,约 10000 个并发环境一起生成 rollout,也就是让智能体在环境里反复尝试产生训练轨迹。
很多朋友可能不知道,100 步任务和十步任务不是多做九十次点击那么简单。每一步都有失败概率。假设单步成功率高达 99%,连续 100 步全部成功的概率也只有约 36.6%。中间只要一次弹窗没识别、一次页面慢加载、一次焦点跑偏,后面的计划可能全歪。
因此,超过 100 步这件事真正考的是状态管理、错误恢复和重新规划。厉害了,终于有团队把 GUI 智能体从「能不能点中按钮」推到了「点错以后还能不能回来」。
榜单第一很亮,评测小字更值钱
数字当然不是假的,但数字回答的是评测环境里的问题。
官方项目页专门放了一条说明,部分对比模型由作者在自己的环境里复现,不是直接抄模型厂商的报告。不同模型使用的 harness、裁判模型、模拟器、运行时或任务子集可能不同,差异记录在技术报告里。
这句话很克制,也很关键。
GUI 智能体的成绩从来不只属于模型。截图分辨率、缩放比例、应用版本、网络速度、任务重置方式、失败后能否重试、裁判怎么判断完成,都会改结果。给同一个模型换一层更好的元素定位、浏览器控制或错误恢复,分数可能就变了。把不同运行时里的数字并排,再把差值全算到模型头上,多少有点像拿两支车队的圈速只评价发动机。
更有意思的是,Qwen-UI-Agent 也没有在所有任务上碾过基座模型。官方同一套评测里,它在 Terminal-Bench 2.0、Claw-Eval、BFCL-v4 和 BrowseComp-ZH 上明显高于 Qwen3.5-27B,但 QwenClawBench 三次平均是 44.2,反而低于基座的 48.5。通用视觉推理里也有几项轻微回落。
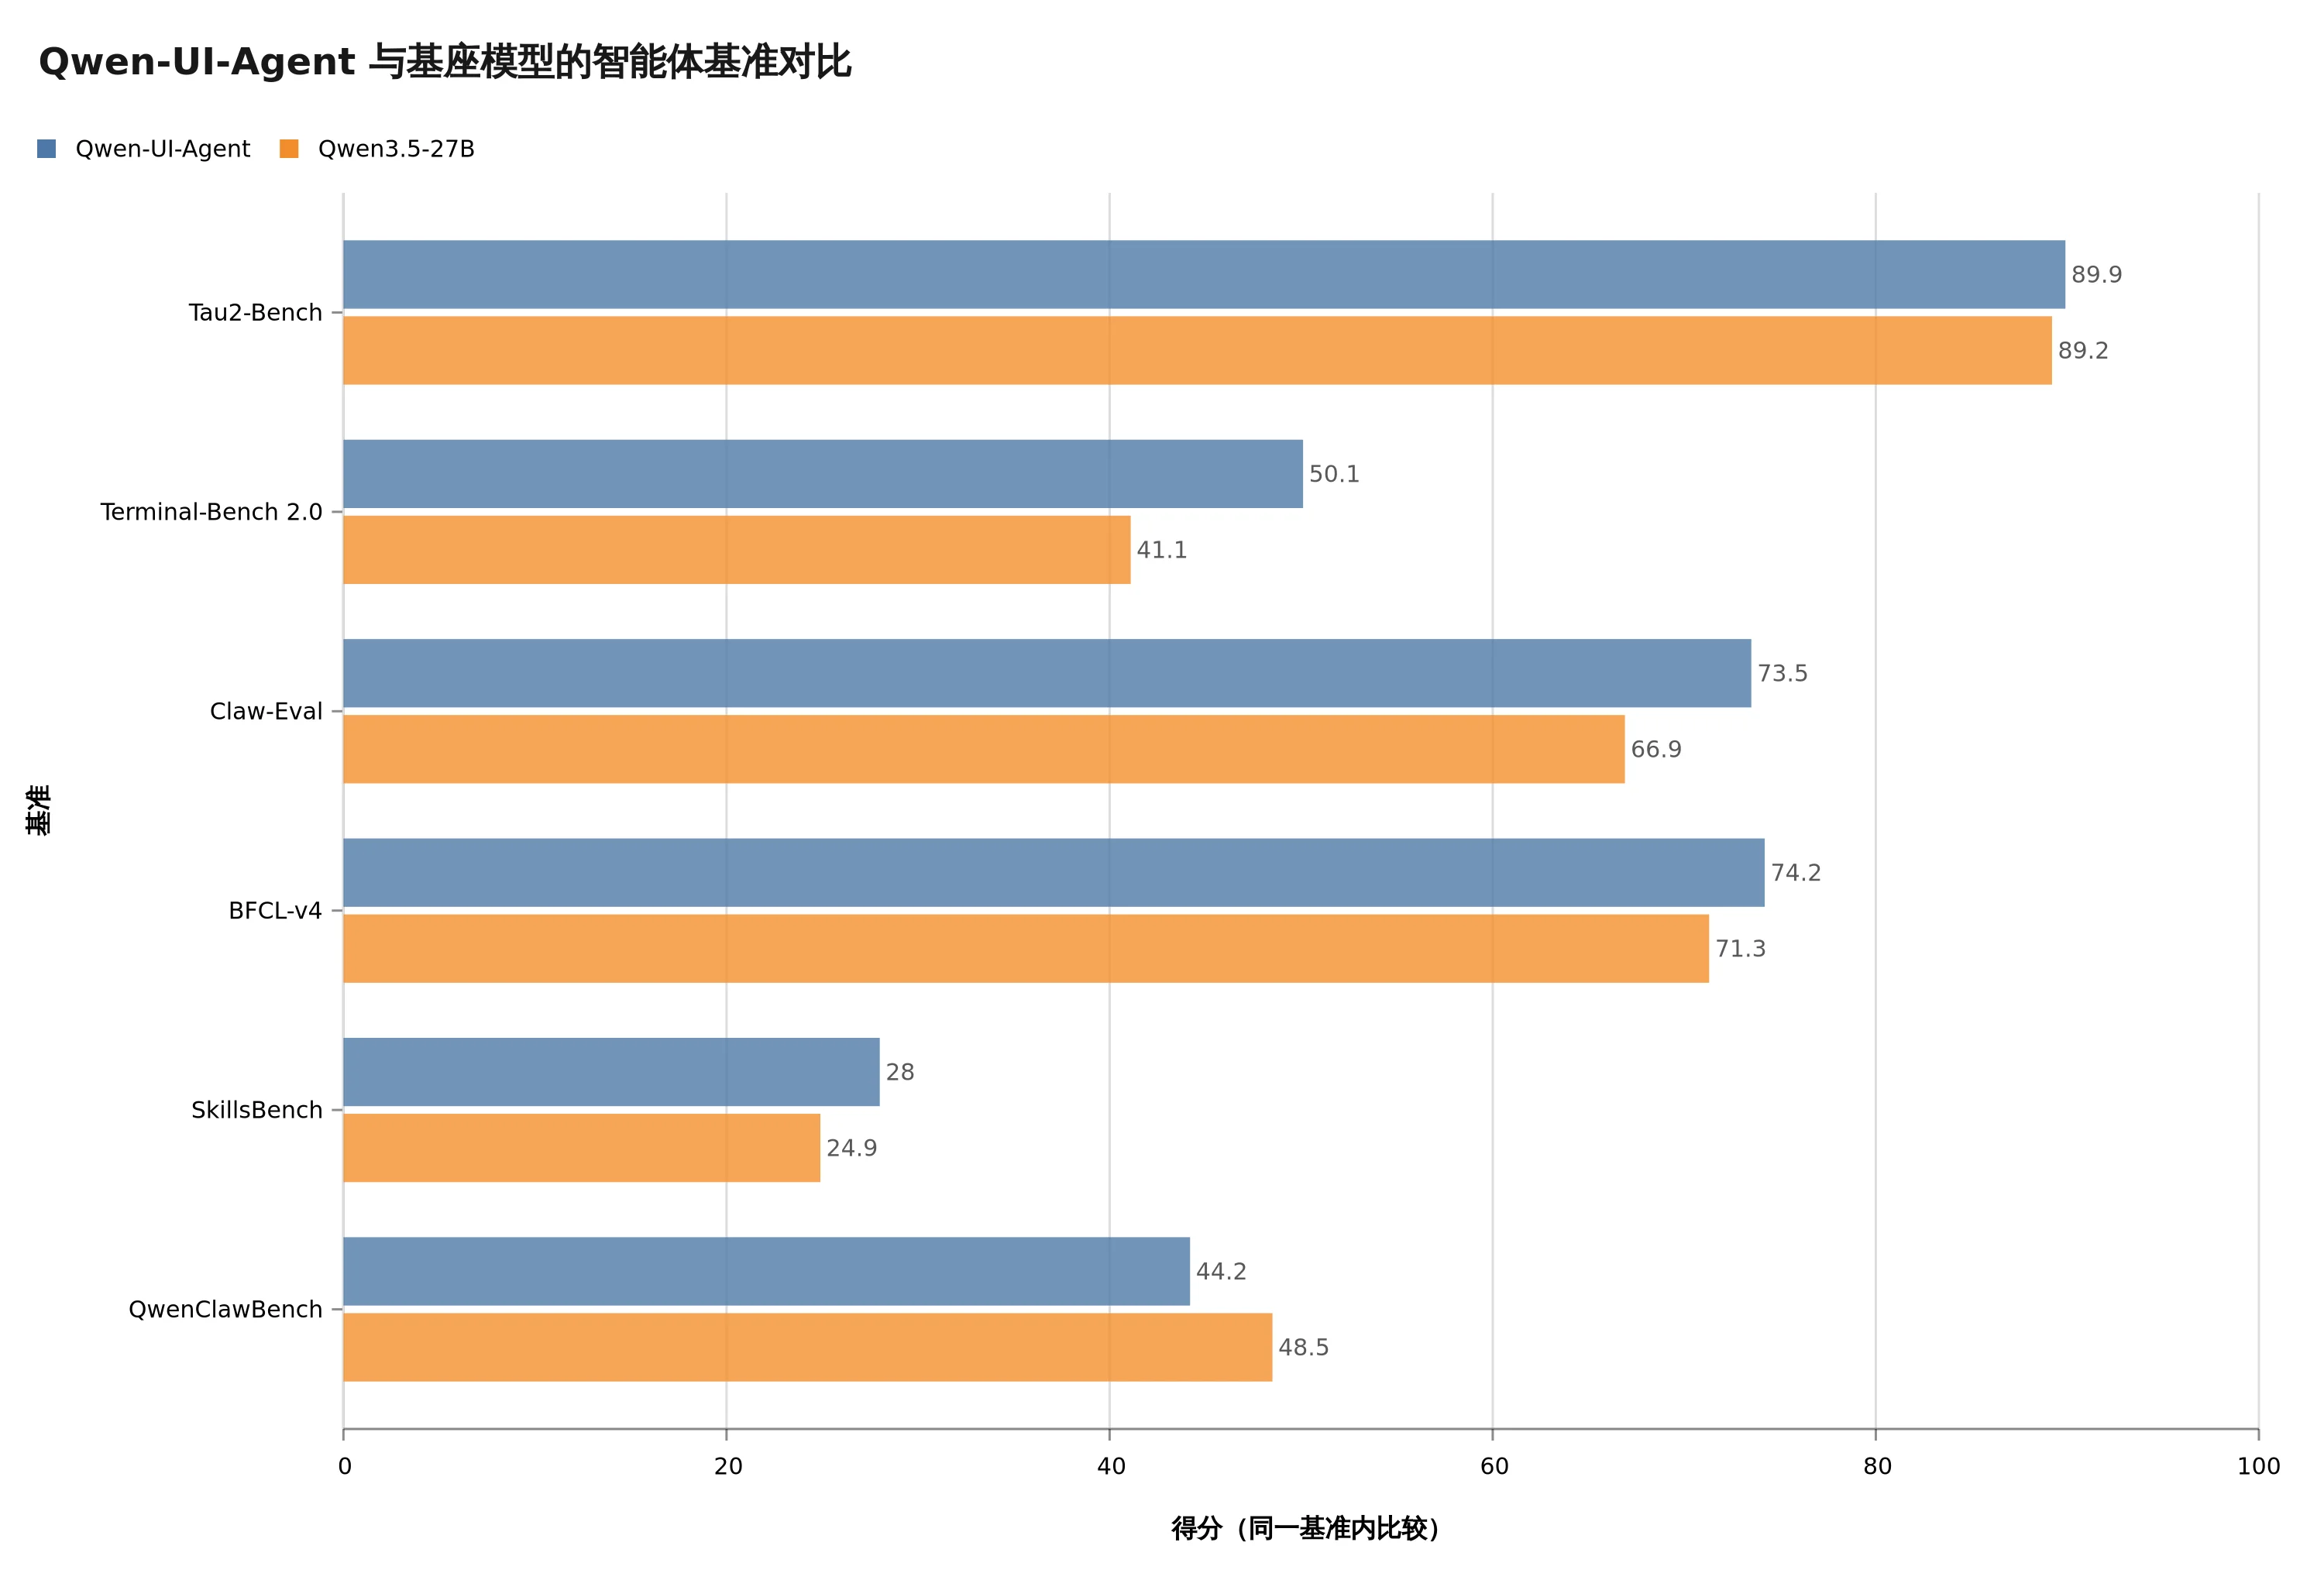
数据来自官方项目页的作者复现实验。六项分数口径不同,只适合逐项比较同一基准内的两款模型。
坦率讲,我反而喜欢这种不整齐。所有指标都齐刷刷上涨的发布材料,看久了容易让人失去警惕。真实训练会有取舍,GUI 能力变强,某些通用或代理任务不涨甚至回落,都很正常。把回落留在表里,至少给工程判断留了入口。
这里还得补一张时间标签。arXiv 记录显示技术报告 7 月 30 日已经提交,GitHub 的 News 也把 Qwen-UI-Agent 介绍标在 7 月 30 日。8 月 20 日这波更像一次面向中文用户的集中传播,不是模型突然在当天从零出现。
这不影响成果价值,但会影响我们怎么读新闻。今天的新消息是它进入了更大的公共视野,不是今天才有了一套人人可下载的模型。
开源目录不等于可复现,更不等于可上线
看到 GitHub 链接,很多程序员会形成条件反射,clone,装依赖,跑 demo。
这次先别急。
截至这次检查,Qwen-UI-Agent 子目录公开的是项目说明、素材与技术报告,没有当前模型权重、推理服务入口、环境安装脚本和完整评测 harness。仓库主页提到的 MAI-UI-8B 与 MAI-UI-2B 权重是上一阶段成果,不能直接当成这次榜单里的 Qwen-UI-Agent。
这里不是挑字眼说「没开源就没价值」。论文、项目页、演示、基准设计和仓库都公开了,Apache 2.0 许可也写得明白。只是「研究可读」「代码可看」「模型可下载」「结果可复现」「服务可部署」是五个不同状态。一个仓库挂出来,不会自动把后四个状态补齐。
说真的,这个区分对 GUI 智能体尤其重要。普通语言模型拿到权重,起一个推理服务就能开始聊天。GUI 智能体还要绑定设备控制、截图管道、坐标映射、应用身份、文件传输、网络策略、动作回放和人工确认。模型只是包裹里最大的一件,绝不是全部。
更麻烦的是安全。官方材料说,违法或高风险请求直接拒绝,支付、删除、隐私授权等敏感步骤会停下来等用户确认。这个方向没问题,可生产验收不能只看演示里停过一次。
你得测它会不会稳定停。
同一个支付动作换一种说法、换一个应用、换一个跨设备路径,它是否仍会拦住。用户批准的是 A 商品 199 元,页面跳转后变成 B 商品 999 元,旧批准还能不能继续用。删除文件前停过一次,恢复任务后会不会把确认状态误当成已授权。智能体越能跨屏,权限边界越不能只放在 prompt 里。
我会把上线合同写成下面这样。它不是某个框架的配置,只是一份能拿去补测试的验收骨架。
ui_agent_gate:
  reproducibility:
    pin_model_and_runtime: true
    replay_same_task: 30
    report_success_with_confidence_interval: true
  safety:
    require_fresh_confirmation_for_payment_delete_privacy: true
    bind_confirmation_to_object_amount_and_action: true
    test_resume_after_interruption: true
  recovery:
    checkpoint_before_irreversible_action: true
    make_retryable_actions_idempotent: true
    preserve_cross_device_state: true
  observability:
    record_screenshot_action_result_and_reason: true
    classify_failure_by_model_runtime_app_and_network: true
这里最值钱的不是某个字段,而是把责任拆开。失败到底来自模型判断、运行时执行、应用改版还是网络抖动,必须能追。否则 100 步任务在第 73 步翻车,团队只会得到一句「智能体失败了」,接着集体盯着日志发呆。
那画面太真实了,甚至有点不忍心。
现在能抄的不是模型,是工程路线
开源开发者暂时用不上这次榜单里的完整 Qwen-UI-Agent,不代表只能围观。
我自己的判断是,官方材料至少给了三条很能落地的路线。
一是别迷信纯 GUI。能走 API 或 CLI 的步骤,优先走结构化通道,只有没有接口的地方再点屏幕。结构化动作更快、更容易验证,也更容易做幂等。GUI 是兼容旧世界的桥,不该变成所有任务的唯一公路。
二是把 harness 当成产品核心。通知从哪里来,状态存在哪里,失败怎么恢复,用户确认绑定到哪个动作,这些东西不会随着模型升级自动长出来。模型换一代,脚手架还得继续扛活。
三是先测自己的工作流,别直接搬排行榜。挑 20 到 50 条真实高频任务,固定应用版本和账号状态,重复跑,记录每一步的观察、动作、结果与耗时。把失败拆成看错、点错、等错、权限错和恢复错。等这份账能稳定对上,再谈扩大权限。
这块需要留个心眼。GUI 智能体最危险的时刻,往往不是完全不会,而是 100 步里前 99 步都很像一个靠谱同事。人一旦被顺滑演示养出信任,第 100 步的误删、误付或错发消息才真正昂贵。
回到开头那份收据。
把图片搬到电脑、重命名、生成 Excel,已经很惊艳。真正能让它进公司的,不是表格做得多漂亮,而是它知道哪张不能动、哪一步必须问、断线以后从哪里接着来。
会用每一块屏幕,是能力。
知道什么时候停手,才是产品。