posts/qwen38-27b-mac-completion-time.md
Qwen3.8 27B 慢一半,干完活却没更久
28.6 tok/s,降到 14.0 tok/s。
同一台 Mac Studio,同样约 17GB 的 Q4 量化,同样是 27B 稠密模型。只看这两个数字,Qwen3.8 27B 像是一次很难解释的倒退。
好家伙,新一代慢了一半。
可 TerminalBytes 的五轮实测 里还有另一组数字。前代生成 2058 个 token,用了约 72 秒;Qwen3.8 生成 955 个 token,用了约 67 秒。
每个 token 更慢,完整答案反而早了 5 秒。
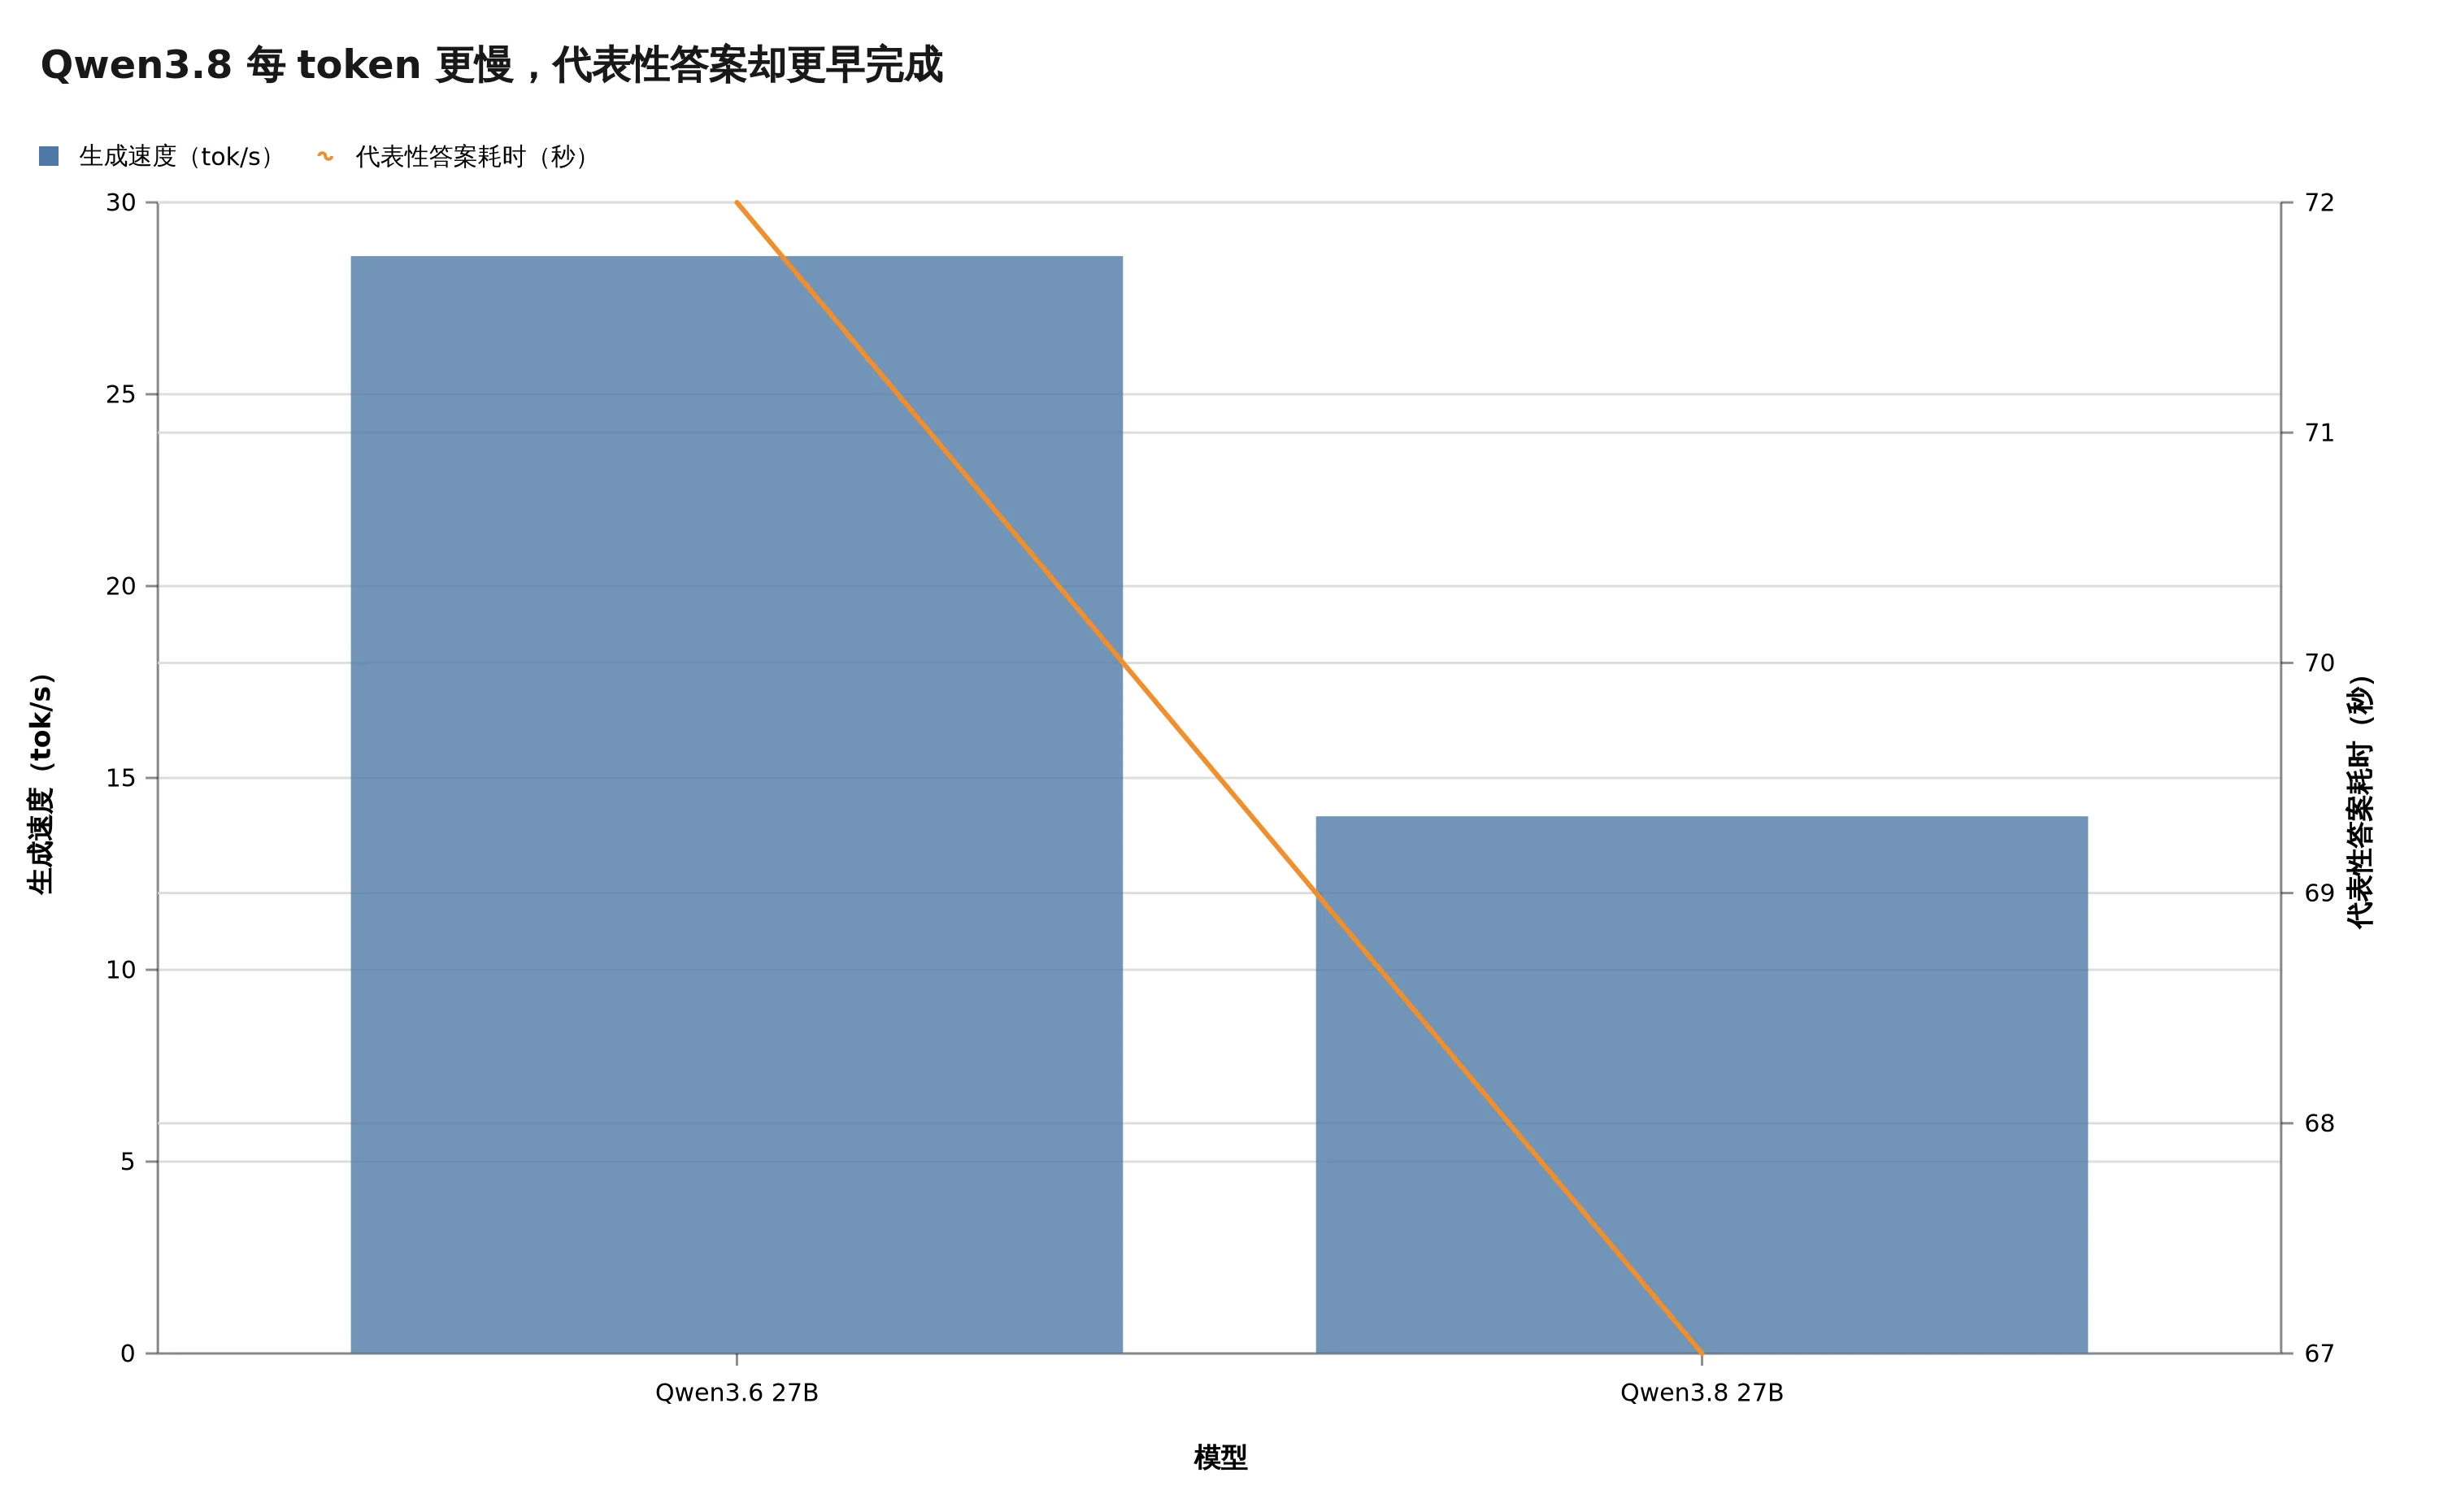
这组反差挺重要。我们给本地模型看跑分,经常盯着 tok/s,也就是 tokens per second,每秒能吐出多少 token。它很好测,也特别适合放进表格,可一旦模型开始跑 Agent 任务,tok/s 只解释模型吐字的速度,不解释它多久把活干完。
我没有同款 M3 Ultra,也没有在手上复跑作者的五组提示词,所以不替这几个小数点做额外担保。能确认的是,原文把机器、量化、轮次、命令和结果都摊开了,Qwen 的 官方模型卡 也能交叉核对模型规格。比起一张只剩结论的榜单,这份材料值得聊。
tok/s 量到的,只是一段路
Qwen3.8 27B 是 273 亿参数的稠密模型,原生支持图像与视频,带 262144 token 上下文窗口,使用 Apache 2.0 许可。模型与工具链入口也集中在 Qwen3.8 官方仓库。它的新混合注意力架构,在当前 Ollama Metal 内核上的生成速度还没有追平前代。
这部分不神秘。新架构刚出来,运行时优化往往要补课。作者测到 Qwen3.6 27B 平均 28.6 tok/s,Qwen3.8 27B 平均 14.0 tok/s;提示处理速度却分别是 95.0 和 93.1 tok/s,差距主要落在生成阶段。
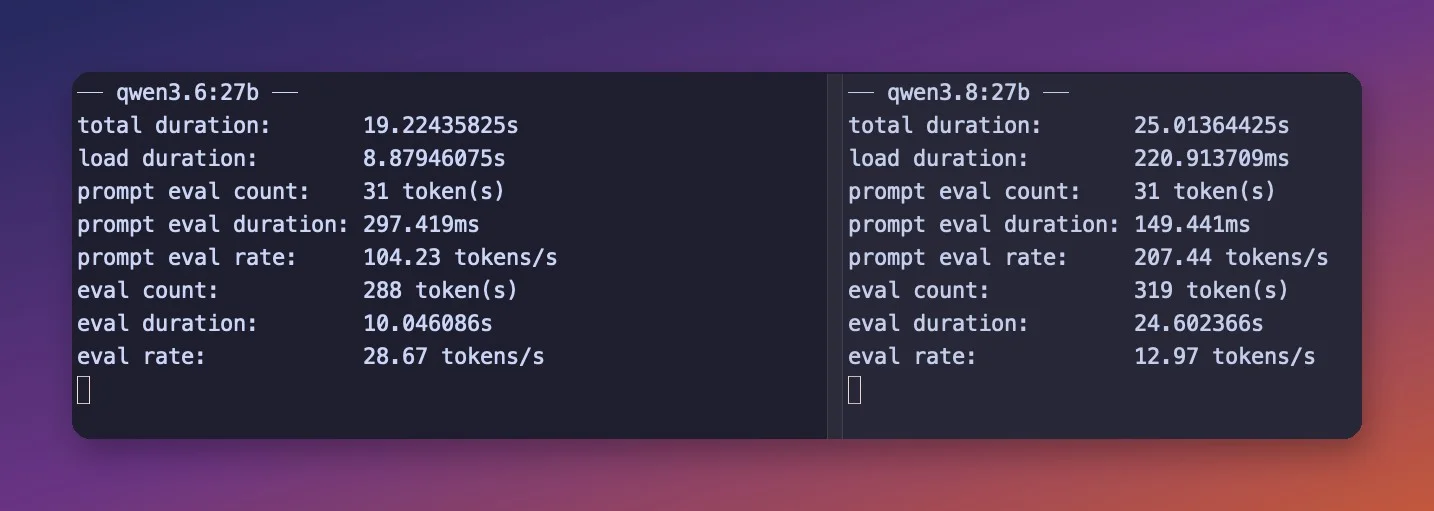
如果任务只是聊天,14 tok/s 的确会直接影响体感。字一个个蹦出来,快慢很明显。
可 Agent 不只是聊天。它要读上下文、选择工具、等工具返回、检查结果,有时还要发现失败后重来。完整任务更接近下面这笔账。
任务总耗时 ≈ 输入处理 + 模型生成 + 工具等待 + 失败重试 + 验证返工tok/s 只站在第二项里。
这里还要把首 token 延迟单独拎出来。模型先读完提示、装好 KV cache,再开始生成,用户看到第一个字之前已经等了一段时间。短问答里,首 token 慢两秒可能比后面少吐两百个 token 更刺眼;后台任务里,界面没有人盯着打字,完整结果什么时候通过验证更重要。同一个模型放进聊天窗口与夜间批处理,测速表的权重本来就不该一样。
再往 Agent 里走,外部工具会把差距继续搅乱。一次数据库查询可能等 300 毫秒,一次网页抓取可能等 8 秒,一次失败的浏览器操作可能触发整轮重试。模型从 14 提到 28 tok/s,如果工具链仍在超时,收益很快被淹掉;模型输出缩短一半,同时减少一次无效工具调用,省下来的却是两段等待。速度优化要对着最长的那根柱子下手。
Qwen3.8 在原文的同类技术提示词上,单次回答多在 890 至 1090 token;前代常落在 1950 至 3340 token。哪怕单位生成速度减半,只要少绕一大圈,最终交付仍可能更早。
注意,我说的是「可能」。短答案也可能是漏步骤,67 秒结束不自动等于质量更高。真正公平的比较,还得让两份答案过同一套验证。代码任务跑测试,结构化抽取验 schema,工具调用检查参数与副作用。完成得快,却没完成,不叫低延迟。
这也是很多模型榜单容易把人带偏的地方。吞吐像看一辆车的最高时速,Agent 任务更像送货。走错路、漏一箱、到门口才发现地址不对,仪表盘上的速度再漂亮也救不了交付时间。
1-bit 跑得更快,也犹豫得更久
原文里最有意思的不是 14 tok/s,而是 Unsloth 的 1-bit GGUF。
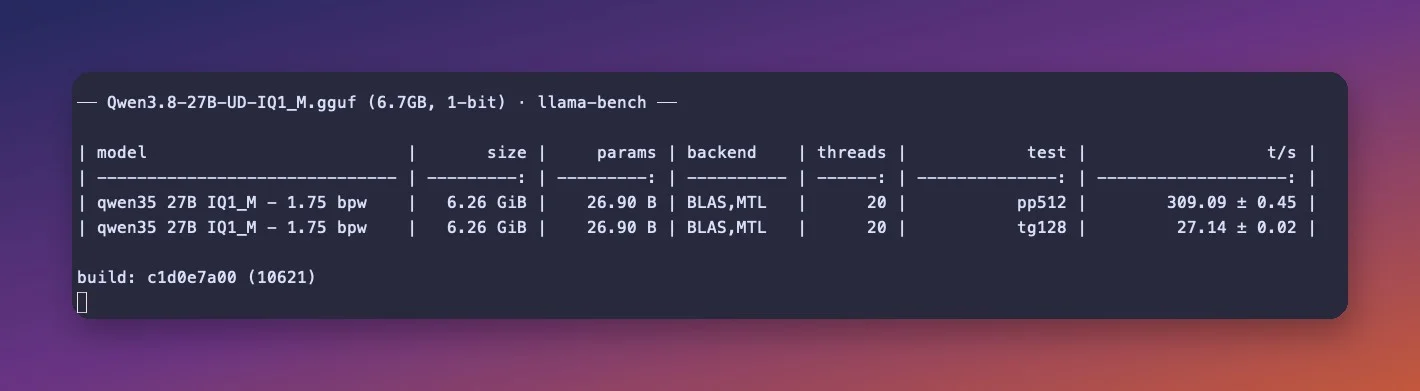
它只有 6.7GB,在 llama.cpp 里能跑到 27.2 tok/s,提示处理达到 309 tok/s。27B 模型塞进接近 7B 模型的内存,厉害了。
然后问题来了。
作者问事实题,它能答对澳大利亚首都,也能解释背后的城市折中。让它写一个简单 Bash 单行命令,它先给出可工作的答案,接着开始反复推翻自己,额外烧掉约 400 token 列替代方案,迟迟不肯提交最终结果。
知识还在,决断先坏了。
Unsloth 的量化说明 也明确提醒,1-bit 不适合 Agent 与工具调用,建议至少从约 9.8GB 的 Q2_K_XL 起步。这里没有玄学。量化不是给所有能力均匀打八折,它可能保住事实记忆,却先伤到长任务里的规划、停止判断和工具选择。
放进 Agent 循环,后果会被放大。模型多犹豫一次,可能只是多生成 200 token;模型改错一次工具参数,可能要再走一轮调用、等待、解析和验证。27 tok/s 看着比 14 tok/s 快,最终却可能被返工拖在后面。
棒棒的,排行榜赢了,任务还没交。
所以挑本地量化档位时,别只拿知识问答测「聪不聪明」。至少再放一组结构化输出、一组工具选择、一组需要明确停止的多步任务。看它会不会给出合法 JSON,会不会选对工具,会不会在证据足够后收手。
这些才是 Agent 真正会踩的坑。模型答对一道常识题,只能证明知识没有完全掉光;它能连续十次选对工具、产出合法参数、在验证失败后改对一次并及时停止,才更接近可用。两类测试放在一起,才能看见量化到底把哪块能力削薄了。
本地 Agent 该怎样重做测速表
如果团队正在比较 Ollama、llama.cpp 或不同量化,不需要先造一套宏大的评测平台。拿二十个日常任务,固定提示词、工具与验证器,就能把第一版表做起来。
保留 tok/s,但别让它坐主位。旁边至少记录完整任务耗时、一次通过率、工具调用次数、重试次数、最终输出 token、验证失败原因。耗时最好同时看中位数和 P95,也就是大多数任务的常态,以及最慢那一小撮到底有多难受。
同一个任务,每个模型或量化跑三至五次。随机性别藏起来,波动本身就是运行时风险。原文里 Qwen3.6 的生成速度稳定在 28.5 至 28.8 tok/s,Qwen3.8 则在 13.2 至 15.4 之间,这个 spread 已经比单个平均数多说了一层。
接着把失败分开看。是模型没理解任务,还是工具参数错了;是输出格式不合法,还是模型做对后又自我否定;是上下文太长把内存挤爆,还是旧运行时根本不认识架构。故障桶分清楚,升级模型、换量化和修 Harness 才不会互相背锅。
Qwen3.8 就有一个很具体的运行时坑。旧版 llama.cpp 可能直接报下面这个错。
llama_model_load: error loading model: unknown model architecture: 'qwen35'这不是模型文件损坏,而是运行时还不认识新架构。更新 llama.cpp 后再排查,能少走不少弯路。Ollama 则需要 0.32.12 或更新版本,最短启动命令来自它的 Qwen3.8 模型页。
ollama pull qwen3.8:27b
ollama run qwen3.8:27b --verbose --think=false "your prompt"
内存选择也别只看文件能不能塞下。原文给出的实用档位里,16GB 能装 1-bit 或 Q2,Q4 约 16 至 17.6GB,现实里更适合 32GB 内存。模型文件之外,还得给上下文、KV cache 和视觉投影留位置。硬塞进去和稳定跑任务,中间还隔着一段路。
慢模型未必慢,快模型也会浪费时间
这篇实测没有证明 Qwen3.8 27B 一定比前代快。样本只有一台 M3 Ultra、五轮生成和一组作者自己的技术提示词,运行时继续优化后,数字还会变。
它证明的是另一件更朴素的事。
Agent 的速度单位,不该只剩 tok/s。
你真正等的是一次可验证的结果,不是一串更快滚过终端的 token。输出短一点、少调错一次工具、早点停止无效思考,带来的收益可能比吞吐翻倍还大。反过来,量化把模型压得很轻,却让它反复改口,省下的内存会从重试里一点点交回来。
我自己的感受是,本地模型走到今天,已经不缺「能跑起来」的惊喜了。接下来更值钱的问题,是它能不能安静、稳定、可预测地把那些无聊小事做完。
14 tok/s 不算漂亮。
可如果 67 秒后活真的交了,它就比 28.6 tok/s 还在绕路的模型更快。