posts/qwen38-max-0902-arena-price.md
Qwen3.8-Max 领先 4 分,误差却有 19 分
1691,1687,1674。
这是 Code Arena WebDev 当前榜单前三名的分数。Qwen3.8-Max-0902 暂居第一,Claude Opus 5 Max 第二,Kimi K3 Max 第三。
千问赢了 4 分。
然后榜单在 Qwen 的 1691 后面,又放了一个很容易被截图裁掉的数字,正负 19 分,状态还是 Preliminary,也就是初步结果。Claude Opus 5 Max 是正负 8 分,Kimi K3 Max 是正负 11 分。
好家伙,领先 4 分,自己的误差半径却有 19 分。
所以今天最热闹的「千问登顶」当然是真的,最容易被误读的也正是这四个字。当前排名第一,不等于已经证明它在统计上稳定胜过 Opus,更不等于你的仓库、你的工具链、你的线上故障也该把第一名交给它。
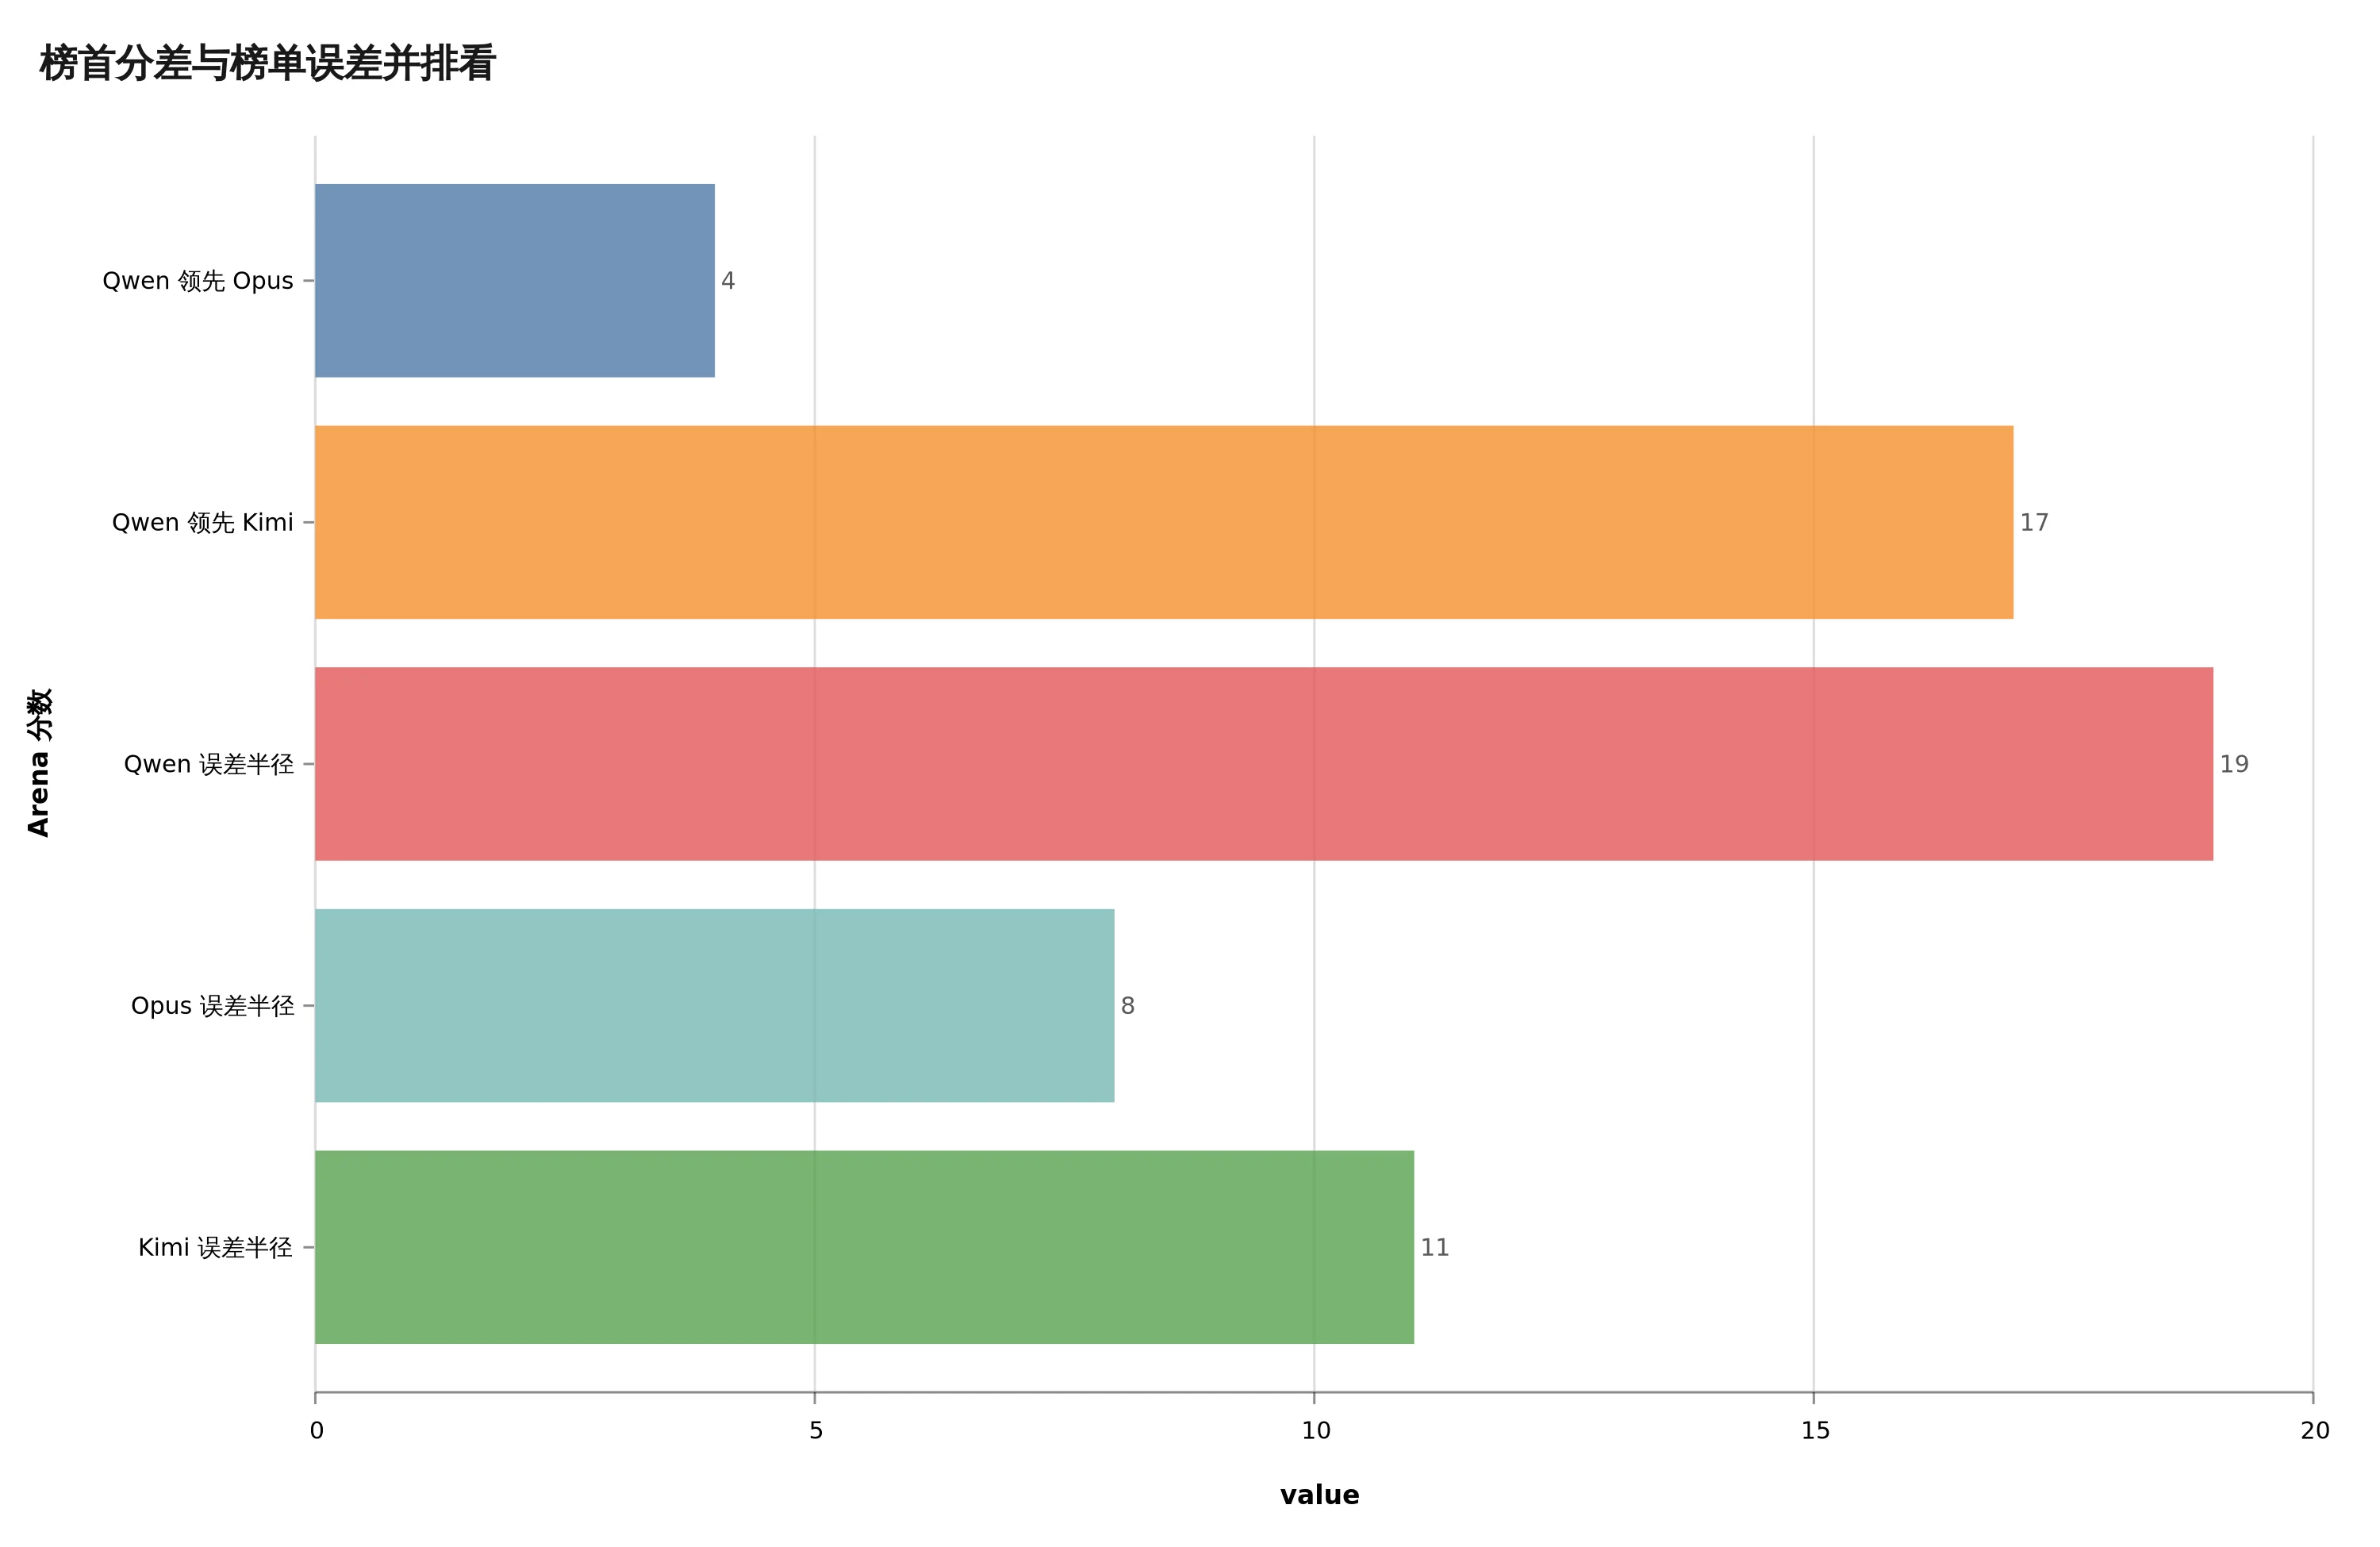
图,当前 4 分领先明显小于 Qwen 的正负 19 分误差半径,榜单数值仍会随投票变化
这不是给 Qwen 泼冷水。
Qwen3.8-Max-0902 确实是一轮值得看的更新。官方模型页称它针对工程级项目、长周期自主开发、多工具编排和端到端交付继续加强,保留 100 万 Token 上下文,还支持函数调用、结构化输出、缓存、批处理和网页搜索。
在一个会让模型自己规划、写文件、执行命令、反复修订的前端榜单里冲到第一,至少说明它不是只会补全几行代码。它能把一个需求一路推到可交互网页,结果还能赢到更多真人投票,这个信号有价值。
有点子牛逼。
可信号和结论不是一回事。
Arena 对 Code Arena 的说明写得很清楚,WebDev 的评价核心是功能、可用性和还原度。用户给出需求,两套模型在匿名条件下生成可运行应用,人再判断哪一个更好。榜单用大规模成对比较聚合出分数,并公开置信区间和波动。
这种评测比只考一个函数的静态题更接近真实使用。网页能不能打开,按钮能不能点,布局是不是像需求,普通人都能直接看见。它还允许模型使用创建文件、编辑文件和运行命令等工具,不再是把一段代码扔进答案框就收工。
但它依然只照亮了真实开发的一部分。
WebDev 里的真人偏好很重要,也天然会奖励几秒钟内能被看见的东西。页面漂不漂亮,交互顺不顺,需求有没有被直观兑现,这些信号很强。数据库迁移能不能回滚,权限边界会不会漏,十天后的改动是否还守得住原来的约束,评审时能不能解释那段诡异 diff,这些信号弱得多。
Arena 后来专门拆出七类前端任务,包括品牌营销、参考设计、数据分析、消费产品、游戏、模拟和内容创作。官方自己也在提醒大家,一个总榜会遮住模型在不同任务上的差异。
你如果每天做落地页和数据看板,这张榜很有参考价值。你如果维护支付服务、数据库内核或者一坨有八年历史的 Java 单体,直接拿它当采购结论,多少有点勇。
我自己的判断是,今天 Qwen 更确定的优势,不是那 4 分,而是价格。
官方给出的标准输入价格是每 100 万 Token 2 美元,输出是 6 美元,隐式缓存输入 0.25 美元,显式缓存读取 0.17 美元。Qwen 与 Arena 对外使用的混合口径是每 100 万 Token 5 美元,并称它处在价格与得分的 Pareto 前沿。
Pareto 前沿不是什么神秘黑话。把价格放在横轴、效果放在纵轴,如果某个模型又贵又差,它会被别的点完全盖住。留在边界上的模型,要么同价更强,要么同等效果更便宜。
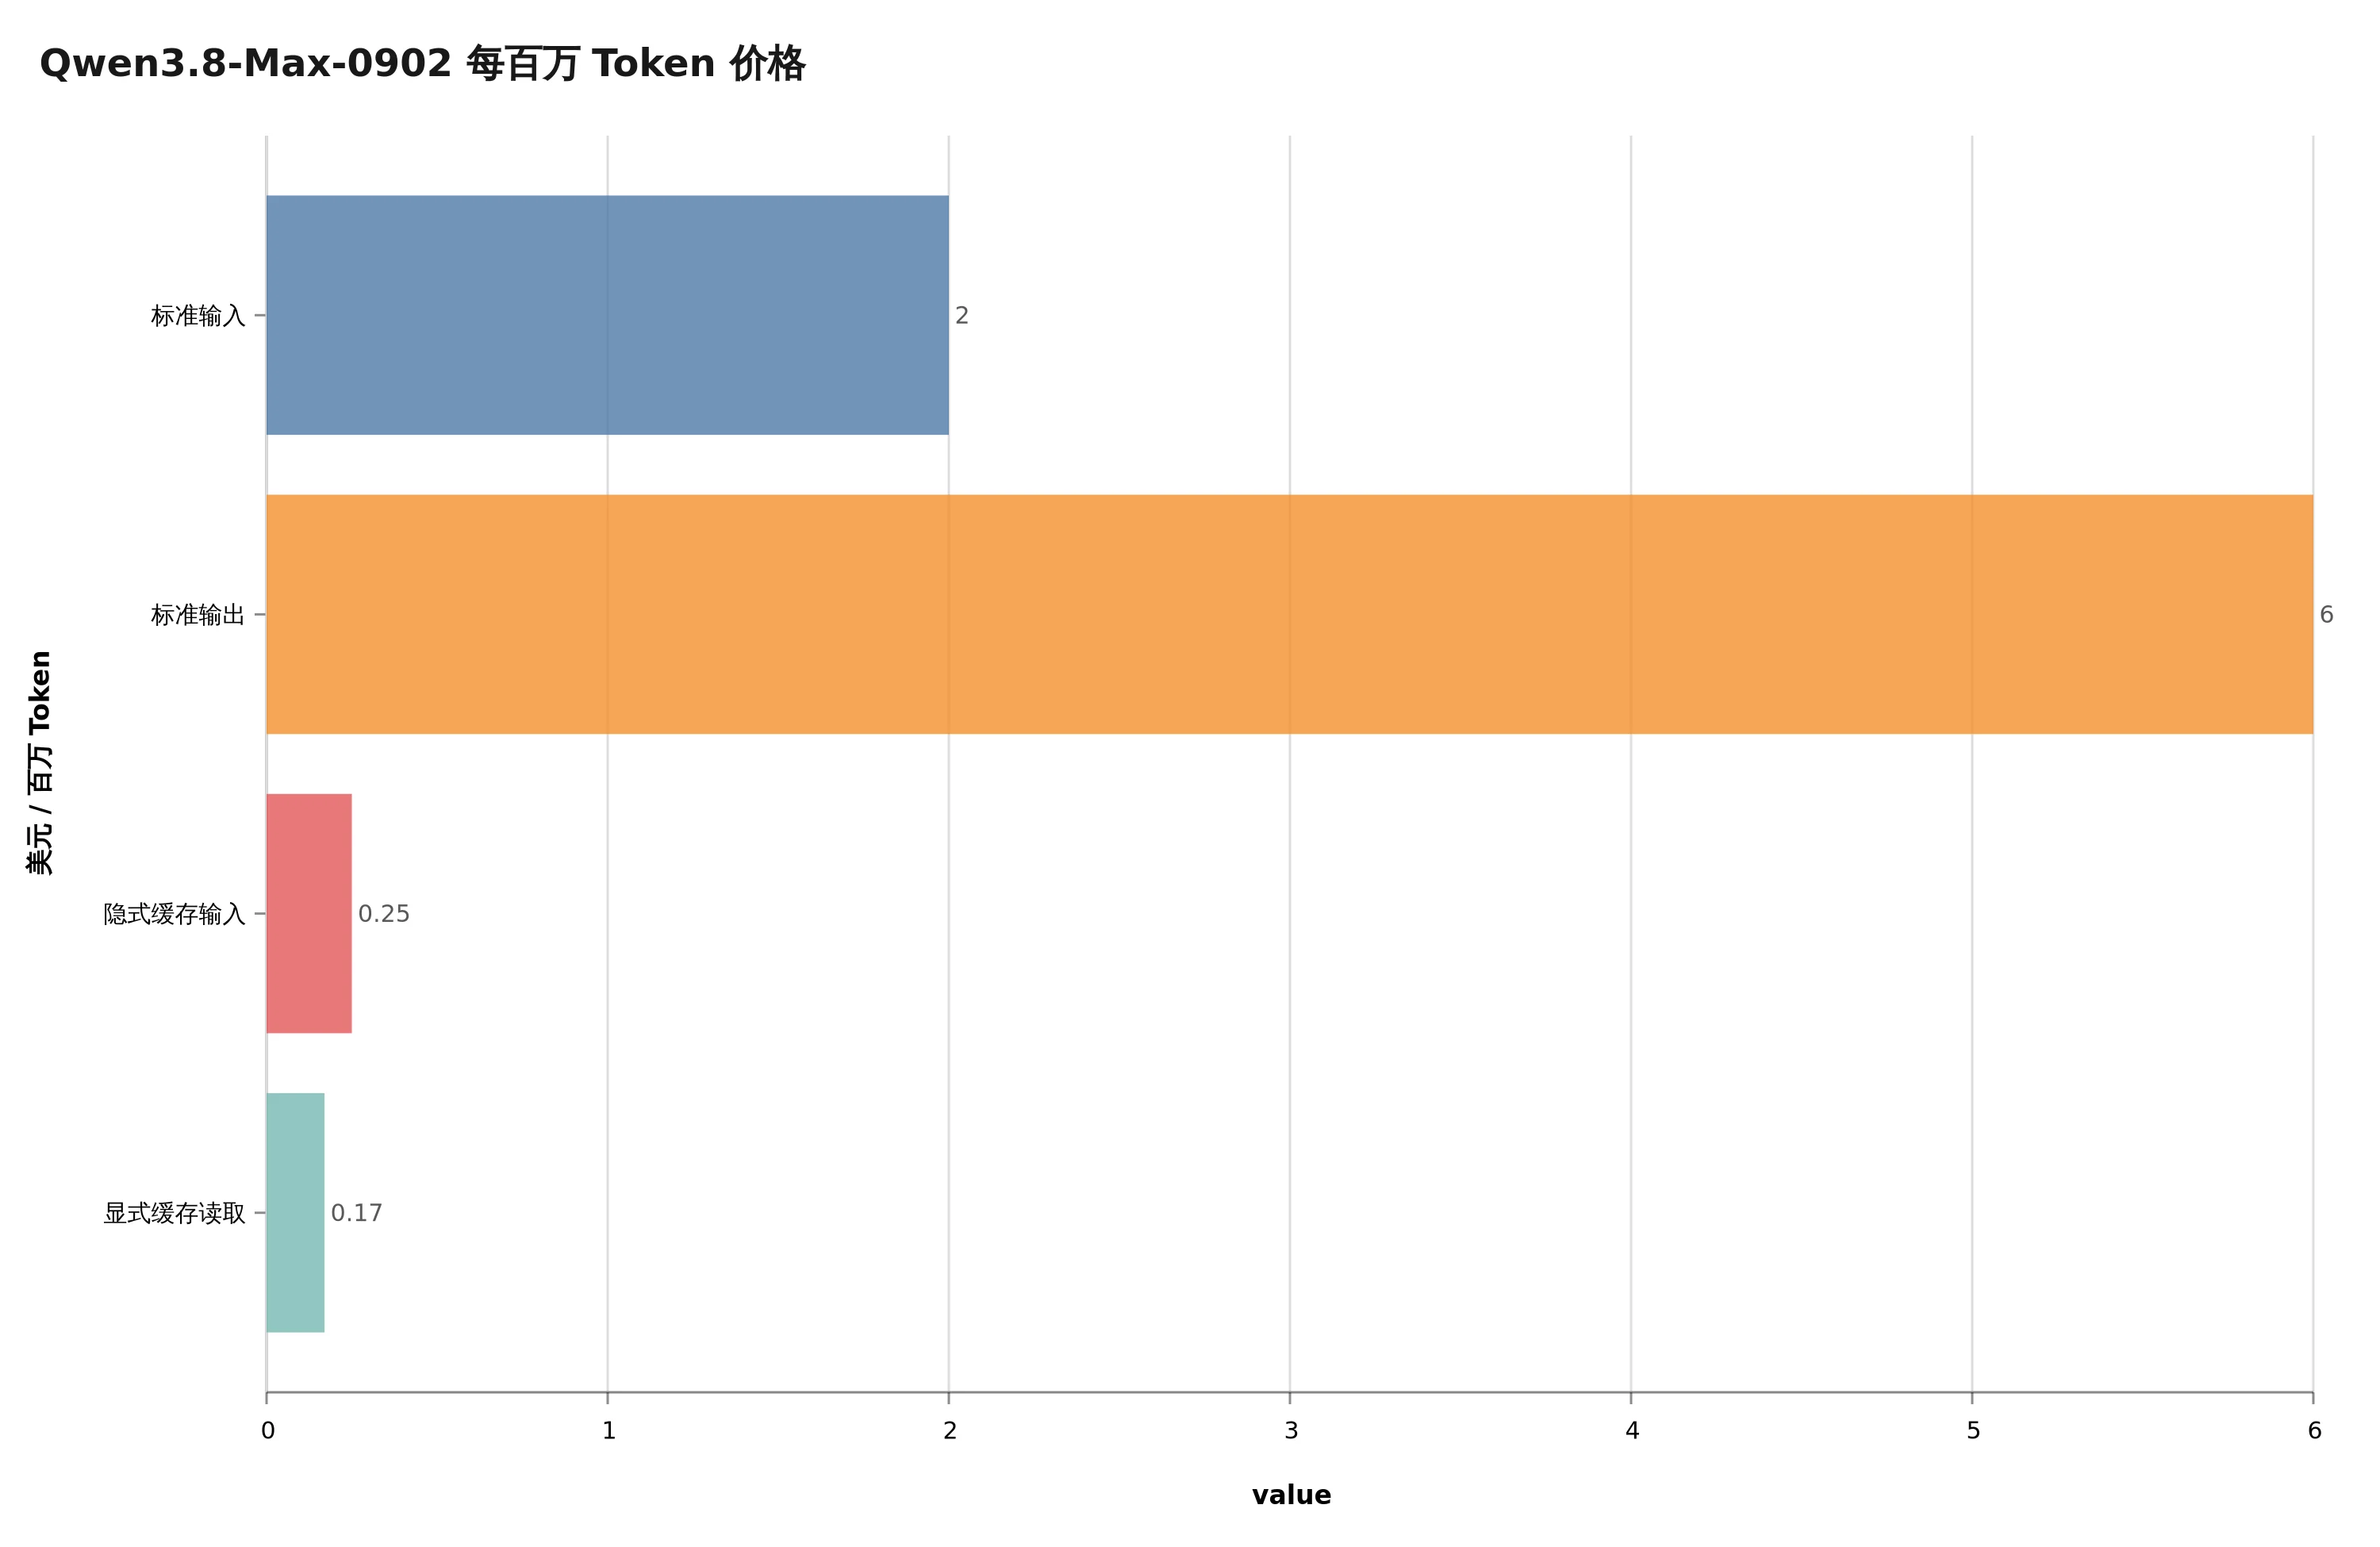
图,QwenCloud 官方价格,单位为美元每 100 万 Token,缓存读取与标准输入不是同一计费项
这个位置比一张金牌更能改变工程决策。
因为 Agent 不是只请求一次。它会读系统提示词、仓库说明、工具定义和历史上下文,调用失败再重试,改完文件跑测试,测试挂了继续读日志。单次看只差几美元,乘上几十轮和每天几千个任务,财务同事很快就不想跟你 lunch 了。
不过 5 美元也别直接抄进预算表。混合价是榜单统一比较用的口径,你的输入输出比例可能完全不同。
假设一个明确标为假设的任务,模型读入 80 万 Token,输出 12 万 Token,不考虑缓存和工具侧费用。按 QwenCloud 的标准价,输入约 1.6 美元,输出约 0.72 美元,合计 2.32 美元。换成一个大量生成代码、输出更长的任务,账单结构马上会变。
再加上缓存,事情更复杂。共享系统提示词、仓库索引和固定工具说明如果能稳定命中缓存,0.17 或 0.25 美元这一档会很香。每次请求前缀都被时间戳、随机 ID 或动态注入打散,缓存价格只是官网上一行漂亮数字。
这块需要注意一下。Qwen 的缓存文档讲的是共享前缀复用。想吃到优惠,前缀本身得稳定。把稳定规则放前面,把每轮变化的任务状态放后面,既是上下文设计,也是成本设计。
那团队要不要换?
别用「第一名所以全量切」回答,也别用「误差重叠所以没价值」回答。更稳的办法,是先把自己最常见的工作切成三桶。
第一桶是视觉与产品任务,落地页、后台看板、组件复刻、交互原型。这些跟 Code Arena 的测量对象接近,可以给 Qwen 更高的先验权重。直接拿 30 到 50 个真实需求做匿名对照,别让评审提前知道模型名。
第二桶是仓库工程任务,修回归、跨文件重构、升级依赖、补测试。这里要补上榜单没覆盖好的验收。最终测试通过只是起点,还要看有没有改坏无关文件、是否遵守仓库约定、重试了几轮、有没有留下无法解释的大 diff。
第三桶是高代价任务,权限、支付、数据迁移、基础设施。别让任何单一排行榜替你签字。模型可以先做方案和草稿,合并与执行仍走现有审查、回滚和人工批准。
每个任务至少记六样东西,是否完成、人工接管次数、总 Token、墙钟时间、工具失败次数、最终 diff 大小。再加一个很朴素的指标,每完成一个可接受任务到底花多少钱。
同一个任务也别只跑一次。模型输出有随机性,工具状态也会波动。三次都能独立做完,和第一次碰巧过测试、后两次开始改配置文件,完全不是一回事。样本量不用一上来做成论文,先保证关键任务每个模型至少重复三轮,再看中位成本和最差结果。平均数很好看,线上事故通常躲在尾巴里。
别只算每百万 Token 单价。
便宜模型如果为了同一个 bug 重试八轮,最后还得人接管,它不便宜。贵模型一次做对,反而可能省。模型选择真正该优化的是每个成功任务的总成本,而不是价目表上最小的那个数字。
这时候 Qwen 的函数调用和 100 万上下文才有机会兑现。上下文够大,能放更多仓库材料,不代表应该把整个仓库一股脑塞进去。工具调用更强,也不代表可以一次给它生产数据库写权限。
上下文是预算,工具是权限,排行榜是先验。
一个都不是最终答案。
更实际的上线方式,是先把 Qwen 放进影子流量。它接收跟现网模型相同的任务,但不直接提交结果。连续跑几天,把两边的完成率、成本、延迟和人工接管放在一起看。视觉任务明显占优,就先切视觉任务。长仓库任务不稳,就继续留在原模型。
甚至没必要押一个总冠军。
前端生成走 Qwen3.8-Max-0902,复杂规划走另一套模型,简单修改交给更便宜的模型,高风险动作最后过确定性检查器。路由多一点配置,却比每次榜单换位就全公司迁移省心得多。
厉害了,排行榜本来想替你减少选择,看到最后反而提醒你要把选择做得更细。
坦率讲,我很喜欢 Qwen 这次把价格一起摆到前台。模型榜单已经挤到肉眼难分的区间,今天领先 4 分,下一批投票可能就换位。继续拿第一名当唯一故事,热闹有了,工程信息越来越少。
5 美元混合价不一样。它逼着其他模型回答一个更具体的问题,你多出来的那几分,到底值多少钱。
Qwen3.8-Max-0902 现在是 Code Arena WebDev 第一名,这句话可以放心写。后面最好补上另外半句,它还是初步排名,误差区间重叠,WebDev 也不是你的完整生产环境。
真准备换模型的话,今天就从自己的 30 个任务开始。匿名对照,保留日志,按成功任务算总账,再决定切哪一桶流量。
榜首会变。
账单和事故,最后都留在自己的系统里。