posts/qwen38-memory-hierarchy.md
Qwen3.8 加了 51B 查表参数,模型开始像数据库了
这次模型里,有 510 亿参数不打算老老实实待在 GPU 上做矩阵乘法。
它们更像一张巨大的查找表,可以放进主机内存,需要时提前取出来,再和 GPU 上正在进行的计算接上。
8 月 26 日,Qwen 开放了 Qwen3.8-Flash-Next 的权重。它有 1250 亿主模型参数,每个 token 只激活 60 亿,另外再挂上 510 亿 N-gram Embedding 参数。官方把它定义成 Qwen4 架构的早期预览,角色类似当年的 Qwen3-Next,先把底盘放出来,让社区替下一代模型踩坑。
好家伙,别人还在比谁的参数更大,Qwen 已经开始讨论哪些参数该计算,哪些参数只负责查表,哪些记忆该压缩,哪些内容又值得回头精确检索。
这比一张跑分表有意思多了。
我自己的判断是,Qwen3.8-Flash-Next 最重要的变化不是 125B 只激活 6B,也不是训练成本只有 Qwen3.7-Plus 的九分之一。它把一个越来越明确的方向摆上了台面。
大模型正在从一坨均匀的参数,变成一套有分层记忆、索引、缓存和数据搬运策略的系统。
听起来是不是越来越像数据库了。
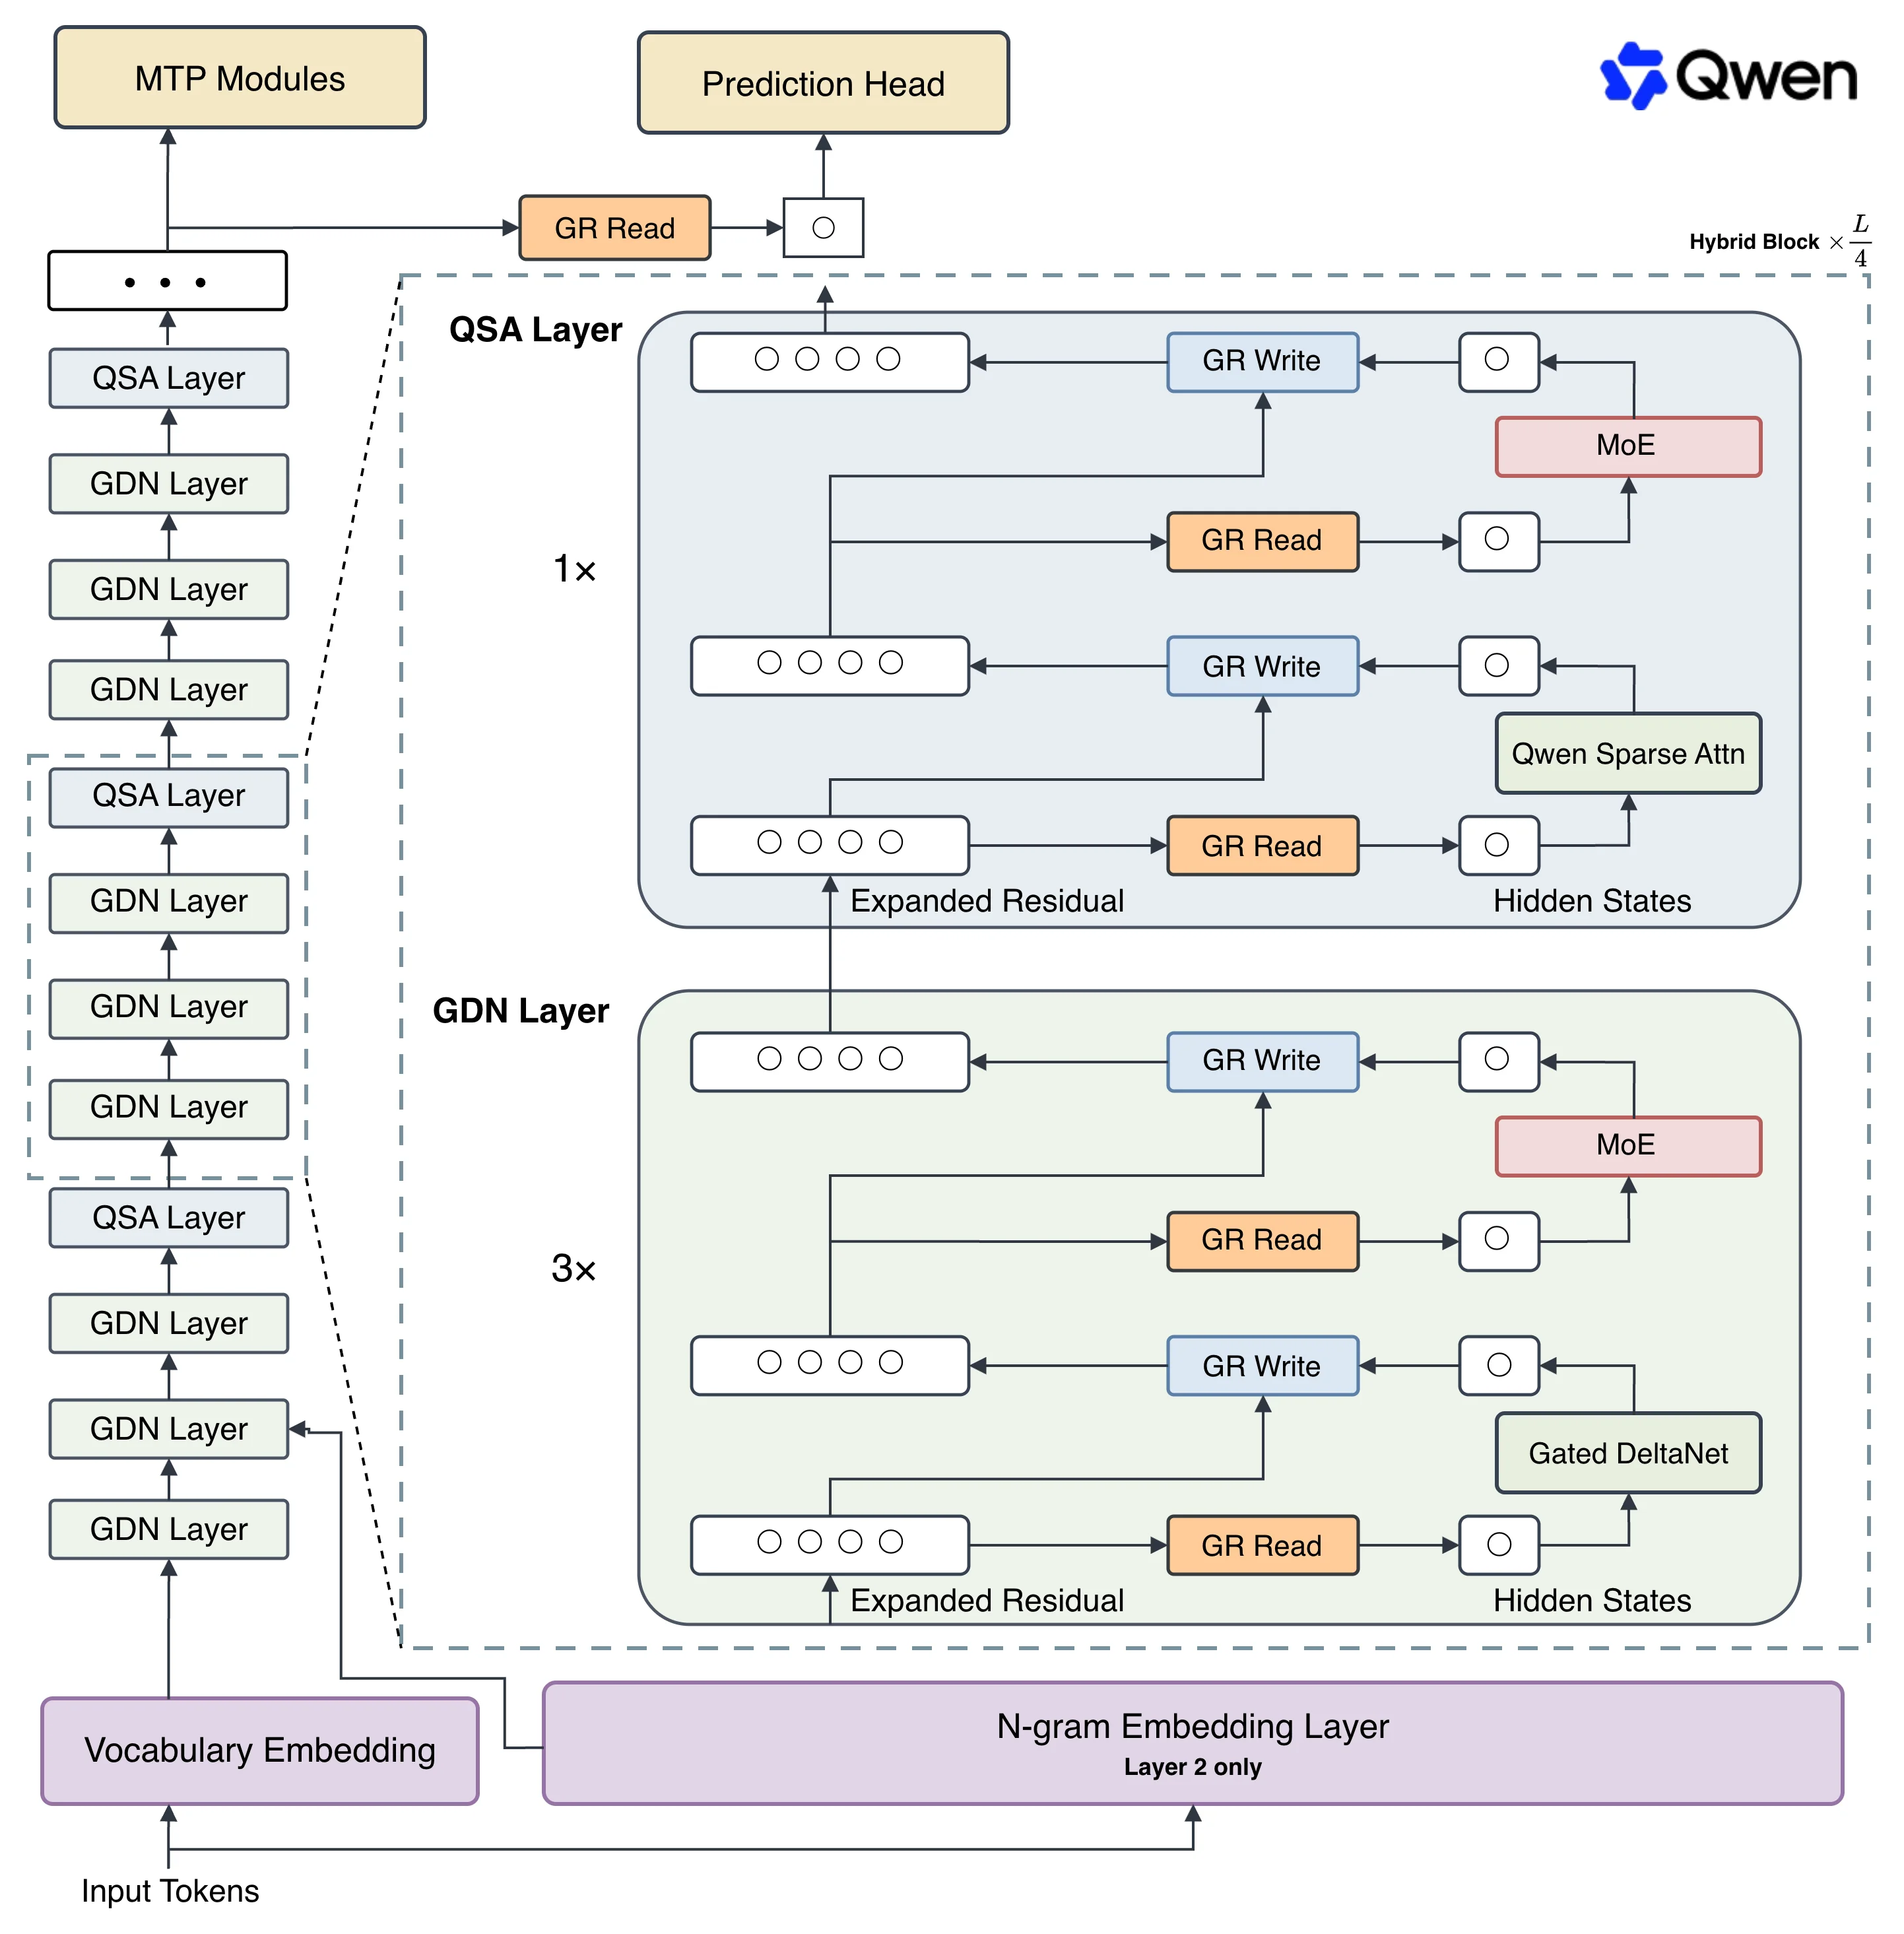 官方架构图里,查表记忆、GDN、QSA、门控残差和 MoE 已经被放进同一条数据路径。
510 亿参数不走算力主干
先看最奇怪的那部分。
普通 Embedding 会根据单个 token 去查一张表,把离散编号变成模型能处理的向量。Qwen3.8-Flash-Next 加进去的 N-gram Embedding,多看了前面几个 token,把一小段局部上下文拼成地址,再去查对应表示。
比如「数据库」和「数据」「库」是不同的局部模式。「token budget」「prefix cache」「pull request」也都有高频组合。模型没有必要每次都从深层网络里重新推导这些短模式,可以先从一块确定性寻址的记忆里捞出线索。
这个设计受到 DeepSeek Engram 和 Gemma 3n 的启发。Qwen 给它加了 510 亿参数,却说几乎不增加每个 token 的矩阵乘预算。原因很朴素,查表位置可以提前算出来,数据也可以放在 Host Memory,也就是主机内存里,通过异步预取和模型计算重叠。
厉害了。
过去扩模型容量,常见做法是继续堆 Transformer 层、增大隐藏维度或者加更多专家。那些参数一旦被激活,就要认真吃 GPU 算力。N-gram Embedding 走的是另一条路,容量继续长,主要代价却变成内存占用、寻址和搬运。
它有点像给模型外挂了一块只读的局部模式库。GPU 负责难推理,主机内存负责存大量常见片段,预取器负责别让两边互相干等。
当然,类比到这里就该刹车了。它不是传统数据库,没有 SQL,也不会把一段事实按主键原样取回。这里查到的是局部模式的向量表示,后续还要进入网络计算。但从工程视角看,两者开始共享同一类烦恼。
命中模式是否集中,数据能否提前取到,主机内存带宽够不够,PCIe 或片间互联会不会卡住,预取失败时 GPU 要等多久。
算力没有消失。
账单只是换了抽屉。
记住和查找被拆成两条路
510 亿查表参数处理的是局部模式,长上下文还有另一套分工。
Qwen3.8-Flash-Next 每四层里有三层使用 Gated DeltaNet,简称 GDN。它不会反复回看全部历史 token,而是把历史持续压进一个固定大小的状态。剩下一层保留全局 Attention,再配上 Qwen Sparse Attention,也就是 QSA,去找当前真正需要的上下文。
官方给出的那句话很准确,GDN 负责高效记住,QSA 负责精准查找。
传统 Full Attention 像每次回答问题都把整间档案室翻一遍。上下文从 32K 拉到 1M 后,最贵的不只是在候选内容上做 Attention,连寻找候选内容的 indexer 都可能变成新瓶颈。
QSA 没有继续做 token 级海选。它先把序列聚成 micro-block,在块级判断哪些区域重要,再对入选区域执行 Attention。索引过程也被压缩了。
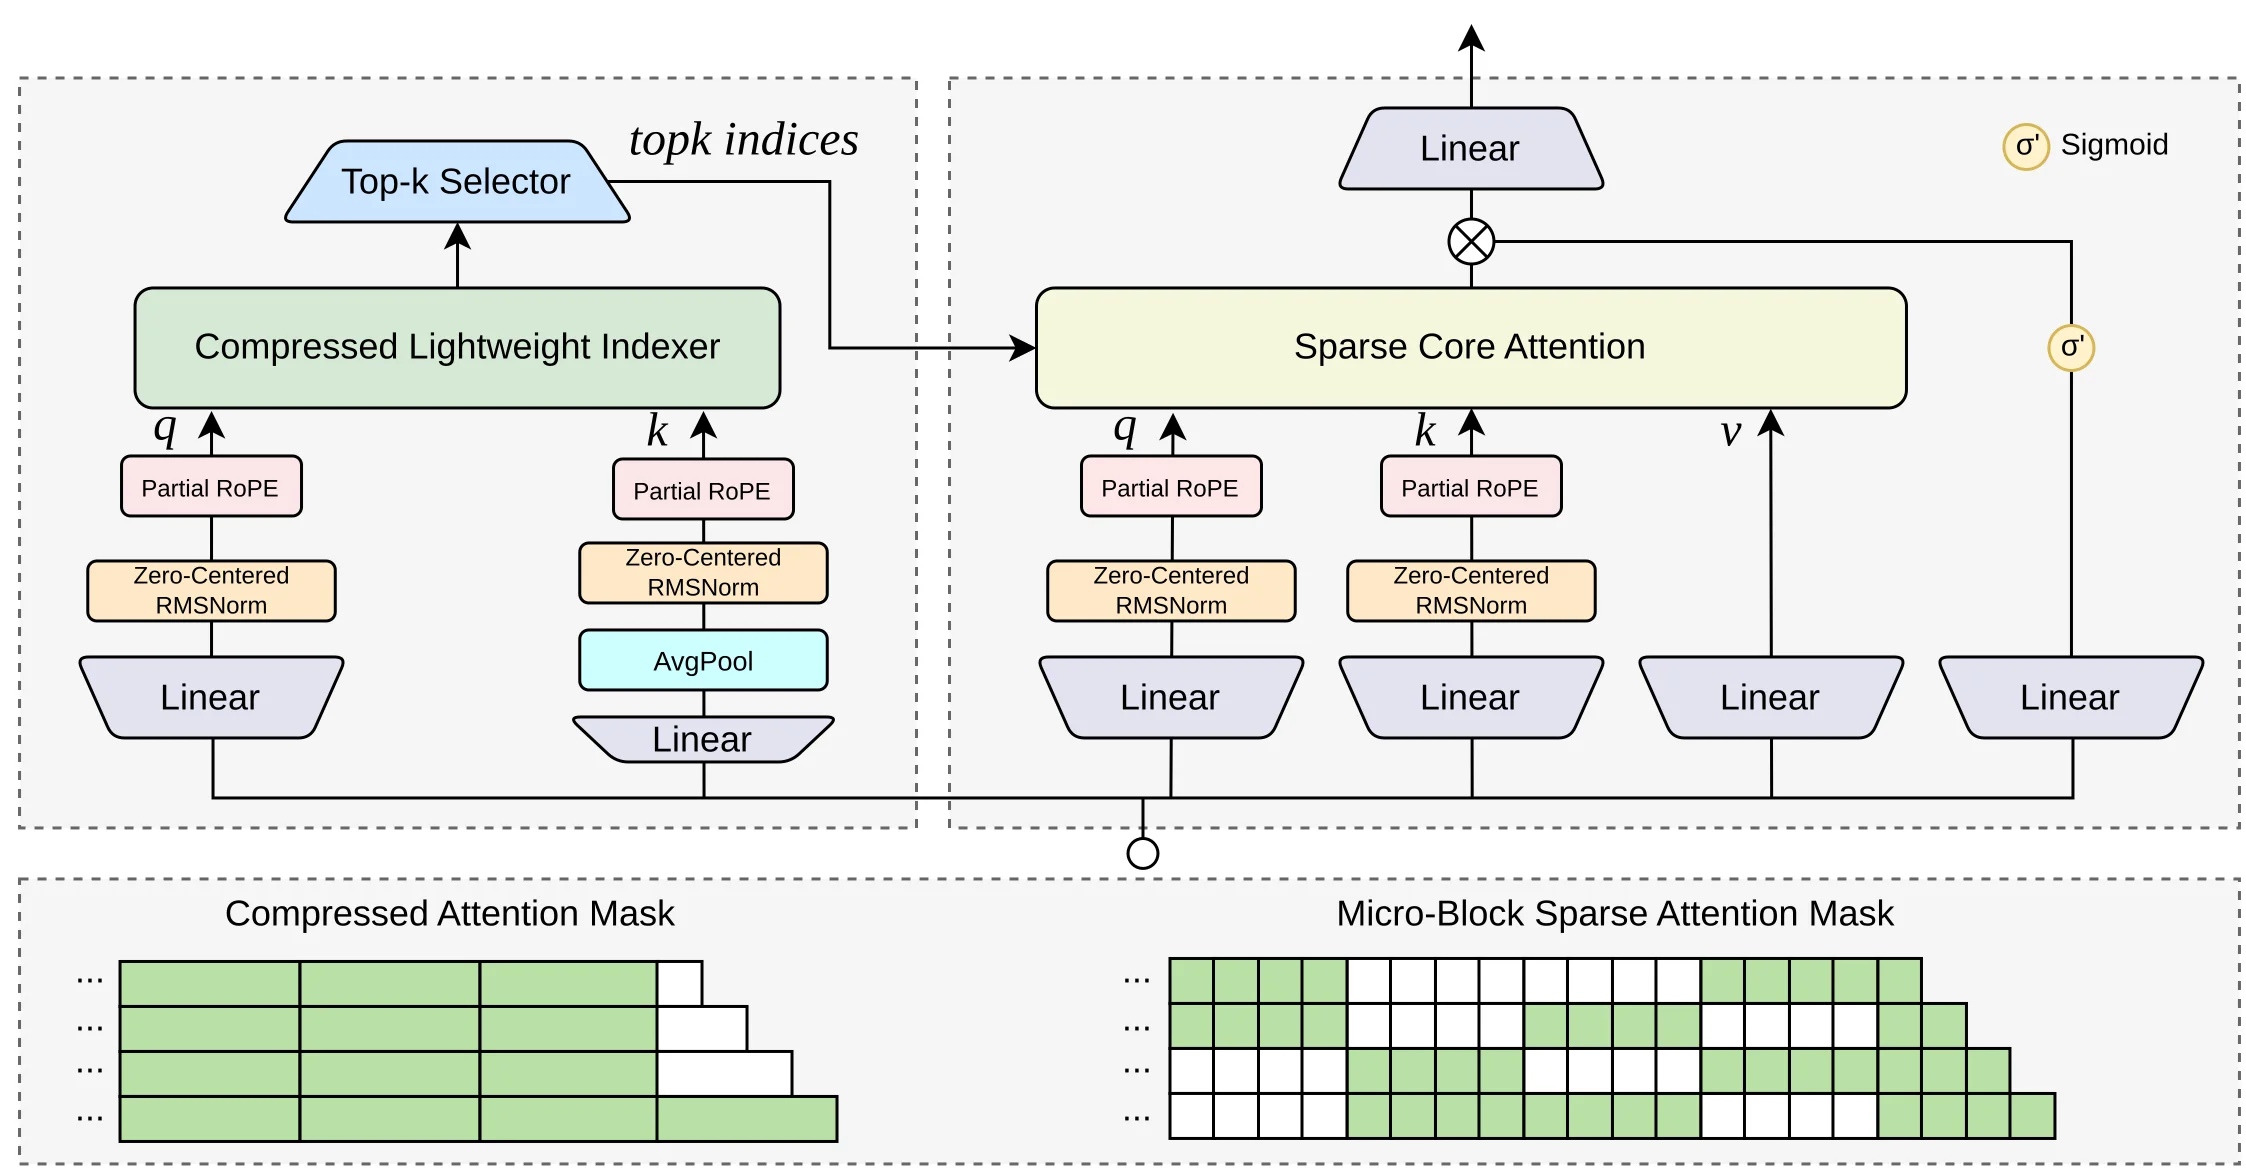 官方 QSA 结构图,左侧先压缩和筛选,右侧只对入选区域做精确计算。
这一手有点子牛逼。
它承认了一件很现实的事,模型不需要在每一层、每一个 token 上都保留同等精度的历史访问。多数时候,一个压缩状态足够把主线带下去。真遇到需要逐字核对的远距离内容,再让少数全局层去翻原文。
这和存储系统里的层级很像。热数据放近一点,冷数据压缩保存,索引先缩小范围,精确读取只发生在真正需要的位置。
官方架构说明给出的数字很亮。1M token 下,QSA 的 Attention Kernel 在 Prefill 和 Decode 阶段最高加速 7.6 倍和 4.9 倍。在 Prefix Cache 命中率 90% 的实验里,1M 上下文的 Prefill 吞吐达到 Qwen3.7-Plus 的 8.6 倍。
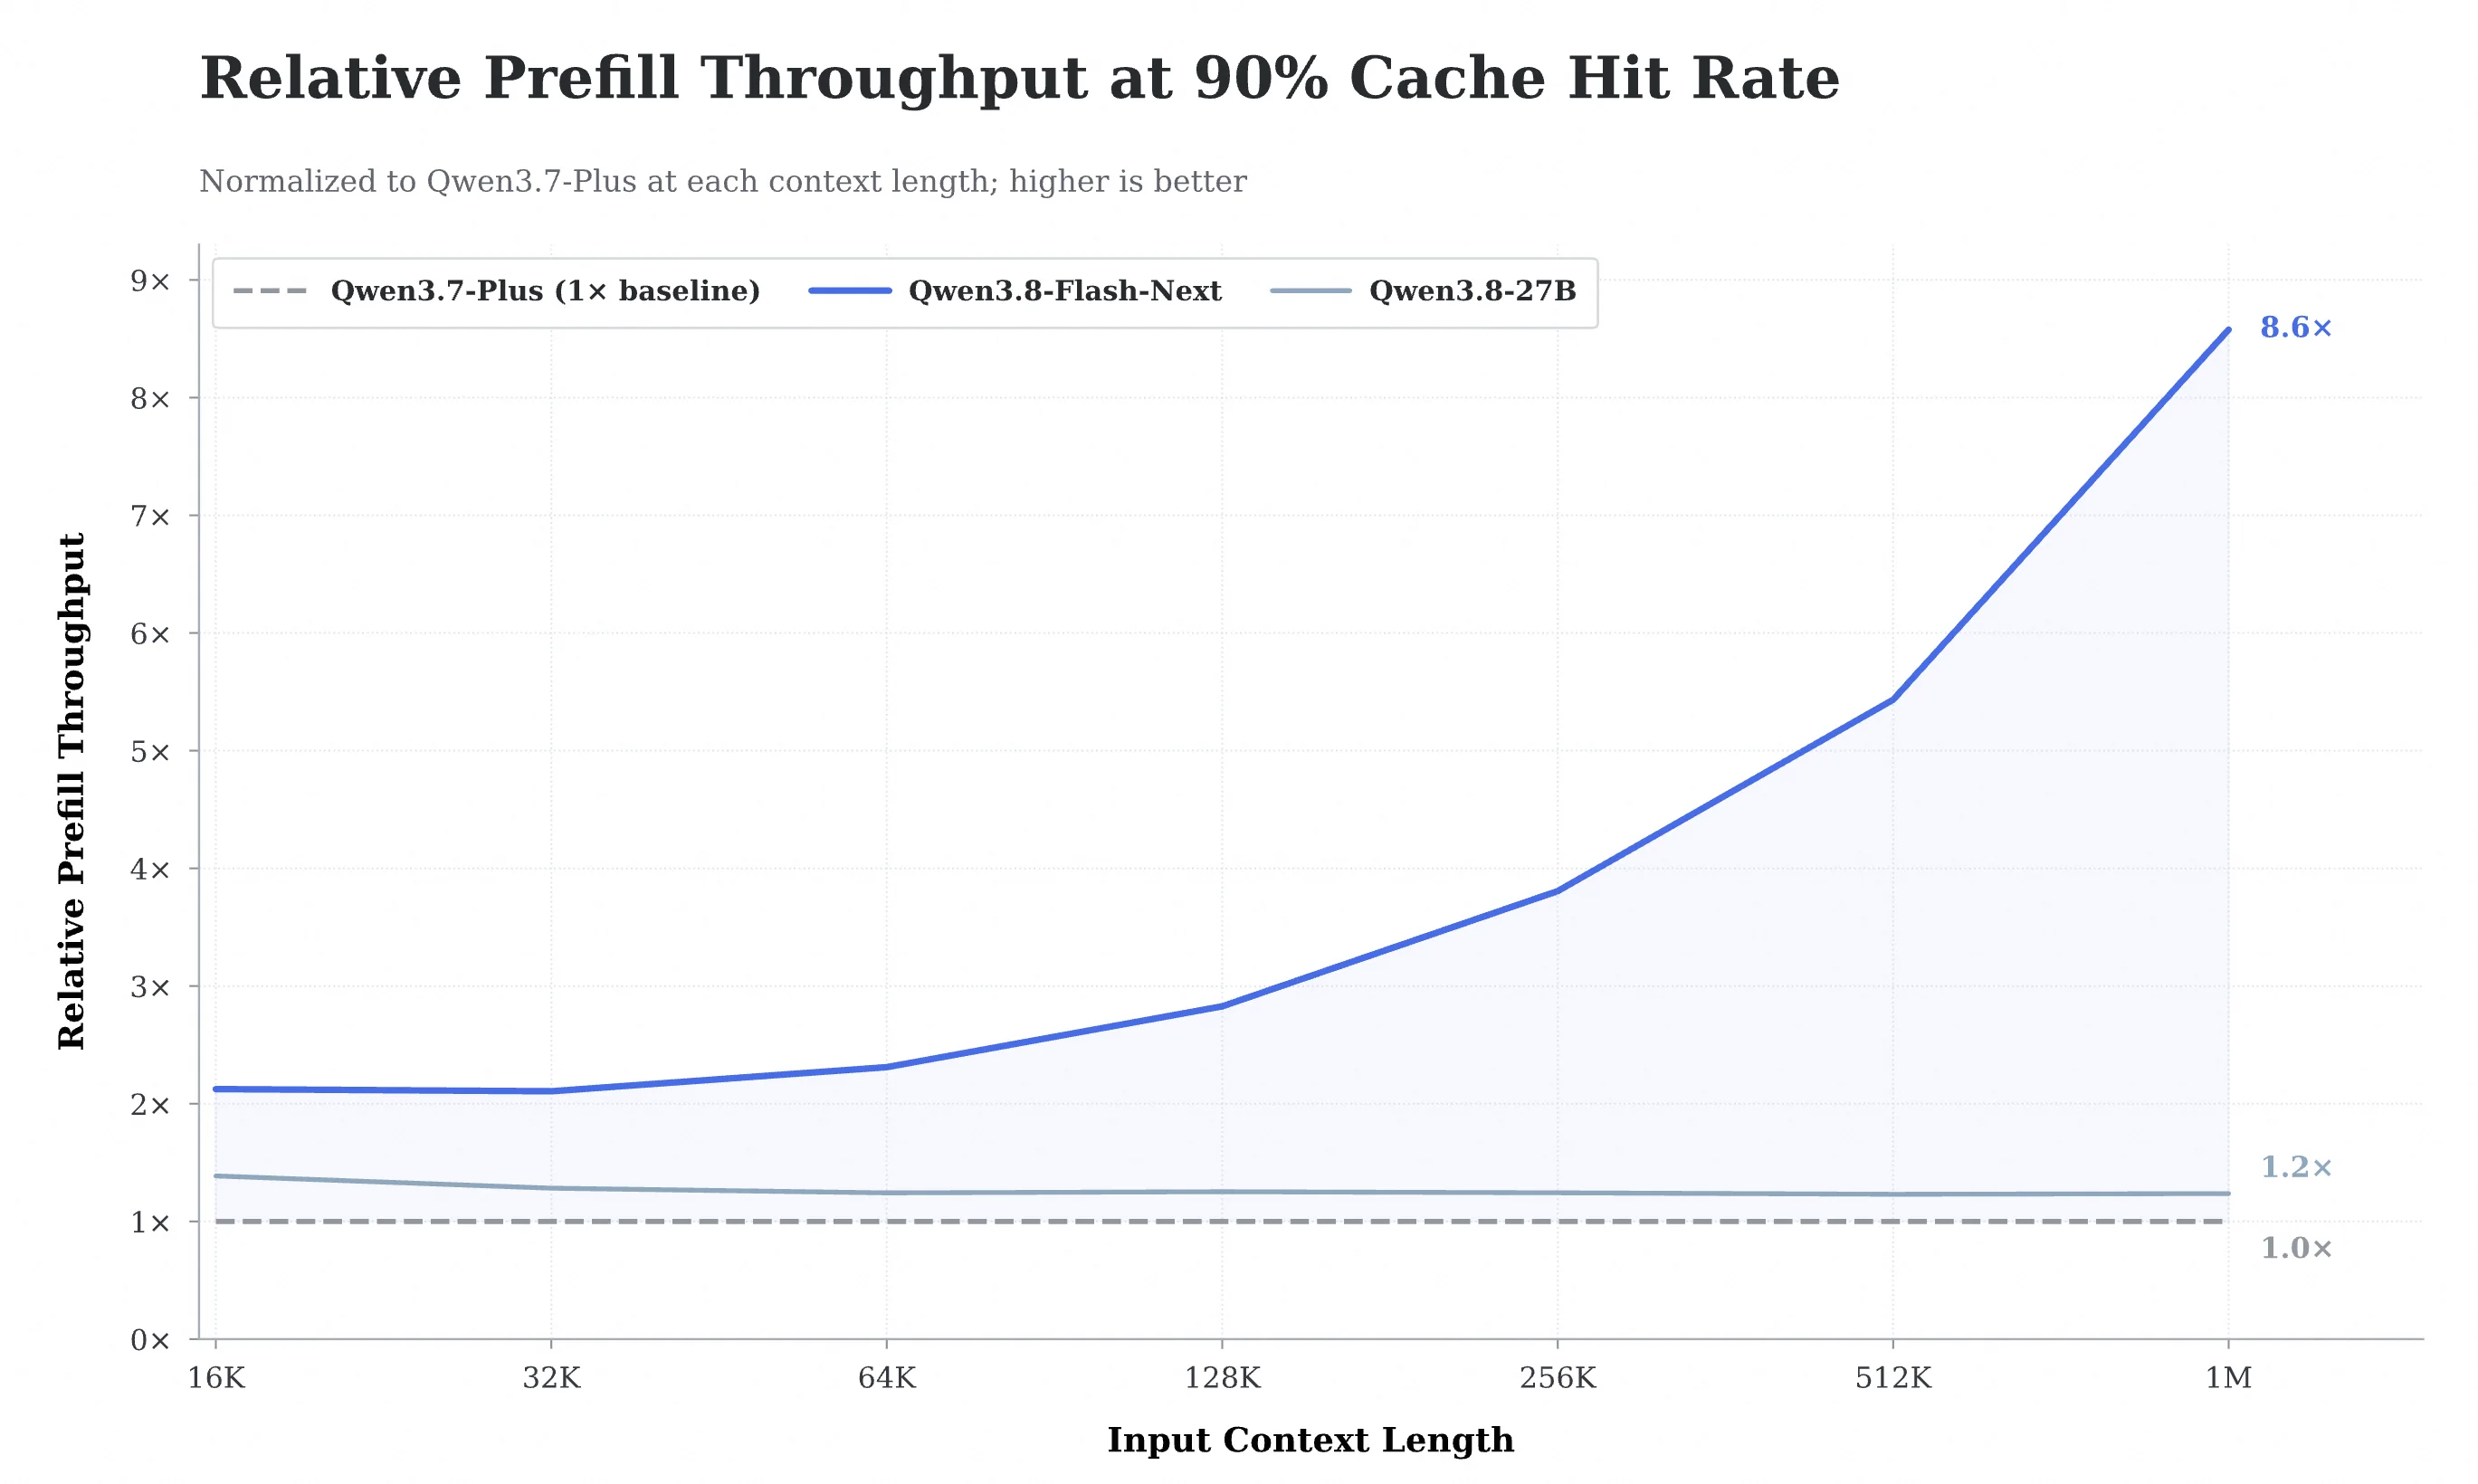 这张官方曲线很亮眼,也把最关键的前提写在标题里,缓存命中率是 90%。
这里有个容易被海报藏起来的条件。
90% Prefix Cache 命中率不是空气,它是一份工作负载合同。
如果线上请求的系统提示词稳定、共享文档前缀重复、会话形态相似,这个数字有机会接近现实。要是每个请求都塞进不同的长文档、不同的工具定义、不同的权限上下文,缓存不断失效,8.6 倍就不能直接抄进容量规划。
跑分测的是架构上限,线上付钱的是自己的流量分布。
四条残差车道也在解决记忆问题
再往模型内部走一步,Qwen 还把传统的单条 Residual Stream 扩成了四条并行分支。
Residual Stream 可以理解成贯穿各层的信息主干。每一层从里面读一些内容,做完计算再写回去。层数越来越深时,早期信息会不断和新内容混在一起,重要细节可能慢慢变淡。
Gated Residual 给这条主干加了分支和动态闸门。模型可以按当前内容决定从哪条分支读多少,向哪条分支写多少。官方分析里甚至观察到,有一条分支自然形成了从第一层 Attention 直达多数中后层的长通道。
你可以把它想成四条不同用途的传送带。有的不断处理眼前材料,有的把早期信息护送得更远。模型不必每一层都把所有东西倒进同一个桶里搅一遍。
Qwen 还把 Residual State 做到可以用 FP8 保存,继续降低访存量。这里再次出现了同一个主题。
不是单纯加算术,而是管理信息怎么留下、怎么流动、什么时候值得保真。
很多模型发布把参数量写在最上面,因为这个数字最好传播。但生产推理越来越像一门数据搬运生意。GPU 的 FLOPS 再高,权重、KV Cache、残差状态和查表结果送不到计算单元,昂贵的芯片照样会在原地等。
Qwen3.8-Flash-Next 的四项升级表面上分散在 Attention、Residual、Embedding 和 Optimization,顺着这条线看却很统一。
让需要精确计算的部分少一点,让可以压缩、查表、缓存和低精度存储的部分多一点。
便宜不是白来的
官方说训练开销只有 Qwen3.7-Plus 的约九分之一,还公布了不少漂亮成绩。SWE-bench Pro 是 62.5,CoWorkBench 是 73.9,Toolathlon Verified 是 73.5。权重已经放到 Hugging Face,完整设计也有一份公开的 技术报告。
这些数字值得看,但别急着把「每 token 激活 6B」翻译成「部署成本等于一个 6B 模型」。
不是哥们,剩下的参数又没有凭空蒸发。
125B 主模型权重仍要存,510 亿 N-gram 参数也要放进某种内存层级。MoE 的专家路由会带来负载均衡问题,Host Memory 预取会吃带宽,长上下文会继续扩大 KV Cache,QSA 的索引器也需要被观测。激活参数少,主要说明单步计算量被压低,不等于整套系统的容量、通信和调度成本都缩成 6B。
这也是我觉得「模型开始像数据库」这个判断值得拿出来讨论的原因。
数据库很少只按一次查询用了多少 CPU 核来选型。你还会看 working set 能不能放进内存,索引是否命中,冷数据从哪里读,P95 和 P99 延迟有没有突然抬头,扩容时数据怎么重新分布。
Qwen3.8-Flash-Next 也该这么验。
假设一支团队准备把它放进代码 Agent,至少要把测试分成几种真实流量。稳定系统提示词加重复仓库前缀,观察缓存高命中时的吞吐。每次更换大型代码库,观察冷启动和 Host Memory 预取。让请求在短补丁和 1M 上下文审仓之间切换,盯住 P95 延迟和显存峰值。再故意压低主机内存带宽,看吞吐到底从哪里开始塌。
这些不是为了给新模型泼冷水。
恰恰相反,架构把代价搬到了更便宜的层级,工程团队就该确认那一层真的接得住。否则发布稿里的成本优势,会在自己的机器上变成一条神秘的延迟长尾。
真正值得期待的是可组合的模型系统
Qwen 还在训练端换上了 Muon Optimizer,并重新拟合 Scaling Law。官方实验里,Batch Size Warmup 没有改善最终效果,反而多用了 18.8% 的优化步骤,于是最终训练直接从目标 Batch Size 开始。
这块很硬核,但它和前面的设计仍然对得上。
模型架构不再是先画好,训练和推理团队再来想办法伺候。Attention 怎么索引,残差怎么存,Embedding 放哪里,优化器给哪些矩阵,大家从一开始就在做协同设计。
我始终觉得,下一代大模型最有意思的竞争,可能不再是谁把同一种 Transformer 堆得最大。它会越来越像系统工程,模型里有压缩状态,有稀疏索引,有查表记忆,有专家路由,有不同精度的存储,也有为特定硬件写的 FlashQLA Kernel。
不同模块做不同的活。
棒棒的,模型终于不再要求每一块信息都坐头等舱。
当然,Qwen3.8-Flash-Next 只是 Qwen4 的预览,不是终局。官方榜单里也有它没有拿第一的项目,内部基准和厂商自报成绩还需要独立复现。开放权重的价值正好在这里,社区可以把 90% 缓存命中率拿掉,可以换硬件,可以测长尾,可以看那 510 亿查表参数在真实工作负载里到底省了什么、又堵住了哪里。
屏幕前如果有人准备试这版,我最想看的不是又一张综合跑分图。
我想看内存带宽、缓存命中率和 P99。
因为从这次开始,模型的聪明已经不只藏在参数里了。它也藏在数据有没有在正确的时间,抵达正确的地方。