posts/qwen38-mtp-speed-trap.md
Qwen3.8 开了 MTP,有人快 2.5 倍有人慢一半
一个加速开关,打开以后有可能让模型慢 56%。
你还会默认开吗?
这两天,Qwen3.8-27B 的本地推理社区跑出了两组很拧巴的数据。
在一张 Radeon Pro W7800 48GB 上,同一个 Qwen3.8-27B Q8_0,开启 MTP 以后,约 500 token 的生成速度从 22.1 tok/s 涨到 55.3 tok/s。8K 和 32K 上下文里也差不多,提升稳定在 2.4 到 2.5 倍。原始实测把配置、上下文和 ROCm 环境都列了出来。
另一边,一组 Ollama 负对照实验里,带 MTP 的 Qwen3.8-27B 处理可预测文本能跑 11.40 tok/s,换成不可预测文本只剩 5.14。没有 MTP 头的普通 GGUF 在两类文本上分别是 11.91 和 11.78,几乎不受影响。
一个快 2.5 倍,一个比无 MTP 基线慢约 56%。
好家伙,同样三个字母,一边是氮气加速,一边是手刹没松。
先把边界钉住。这几组数字来自不同机器、不同引擎,不能拿绝对速度横着比。真正值得追的是方向,同一个原生 MTP 头,为什么能在成对测试里同时出现大幅正收益和大幅负收益。
我的判断是,很多人把「模型带 MTP」「引擎用了 MTP」和「真实任务更快」当成了一件事。
它们其实是三道门。
头在权重里,不等于加速在请求里
MTP 全名叫 Multi-Token Prediction,多 Token 预测。
普通自回归模型像一个谨慎的码字员,每次只写下一个 token,写完再猜下一个。MTP 会多带一个较轻的预测头,先往前起草几个候选 token,再让主模型一次并行验收。草稿猜对了,几个 token 可以一起通过;猜错了,就从分叉处重新生成。
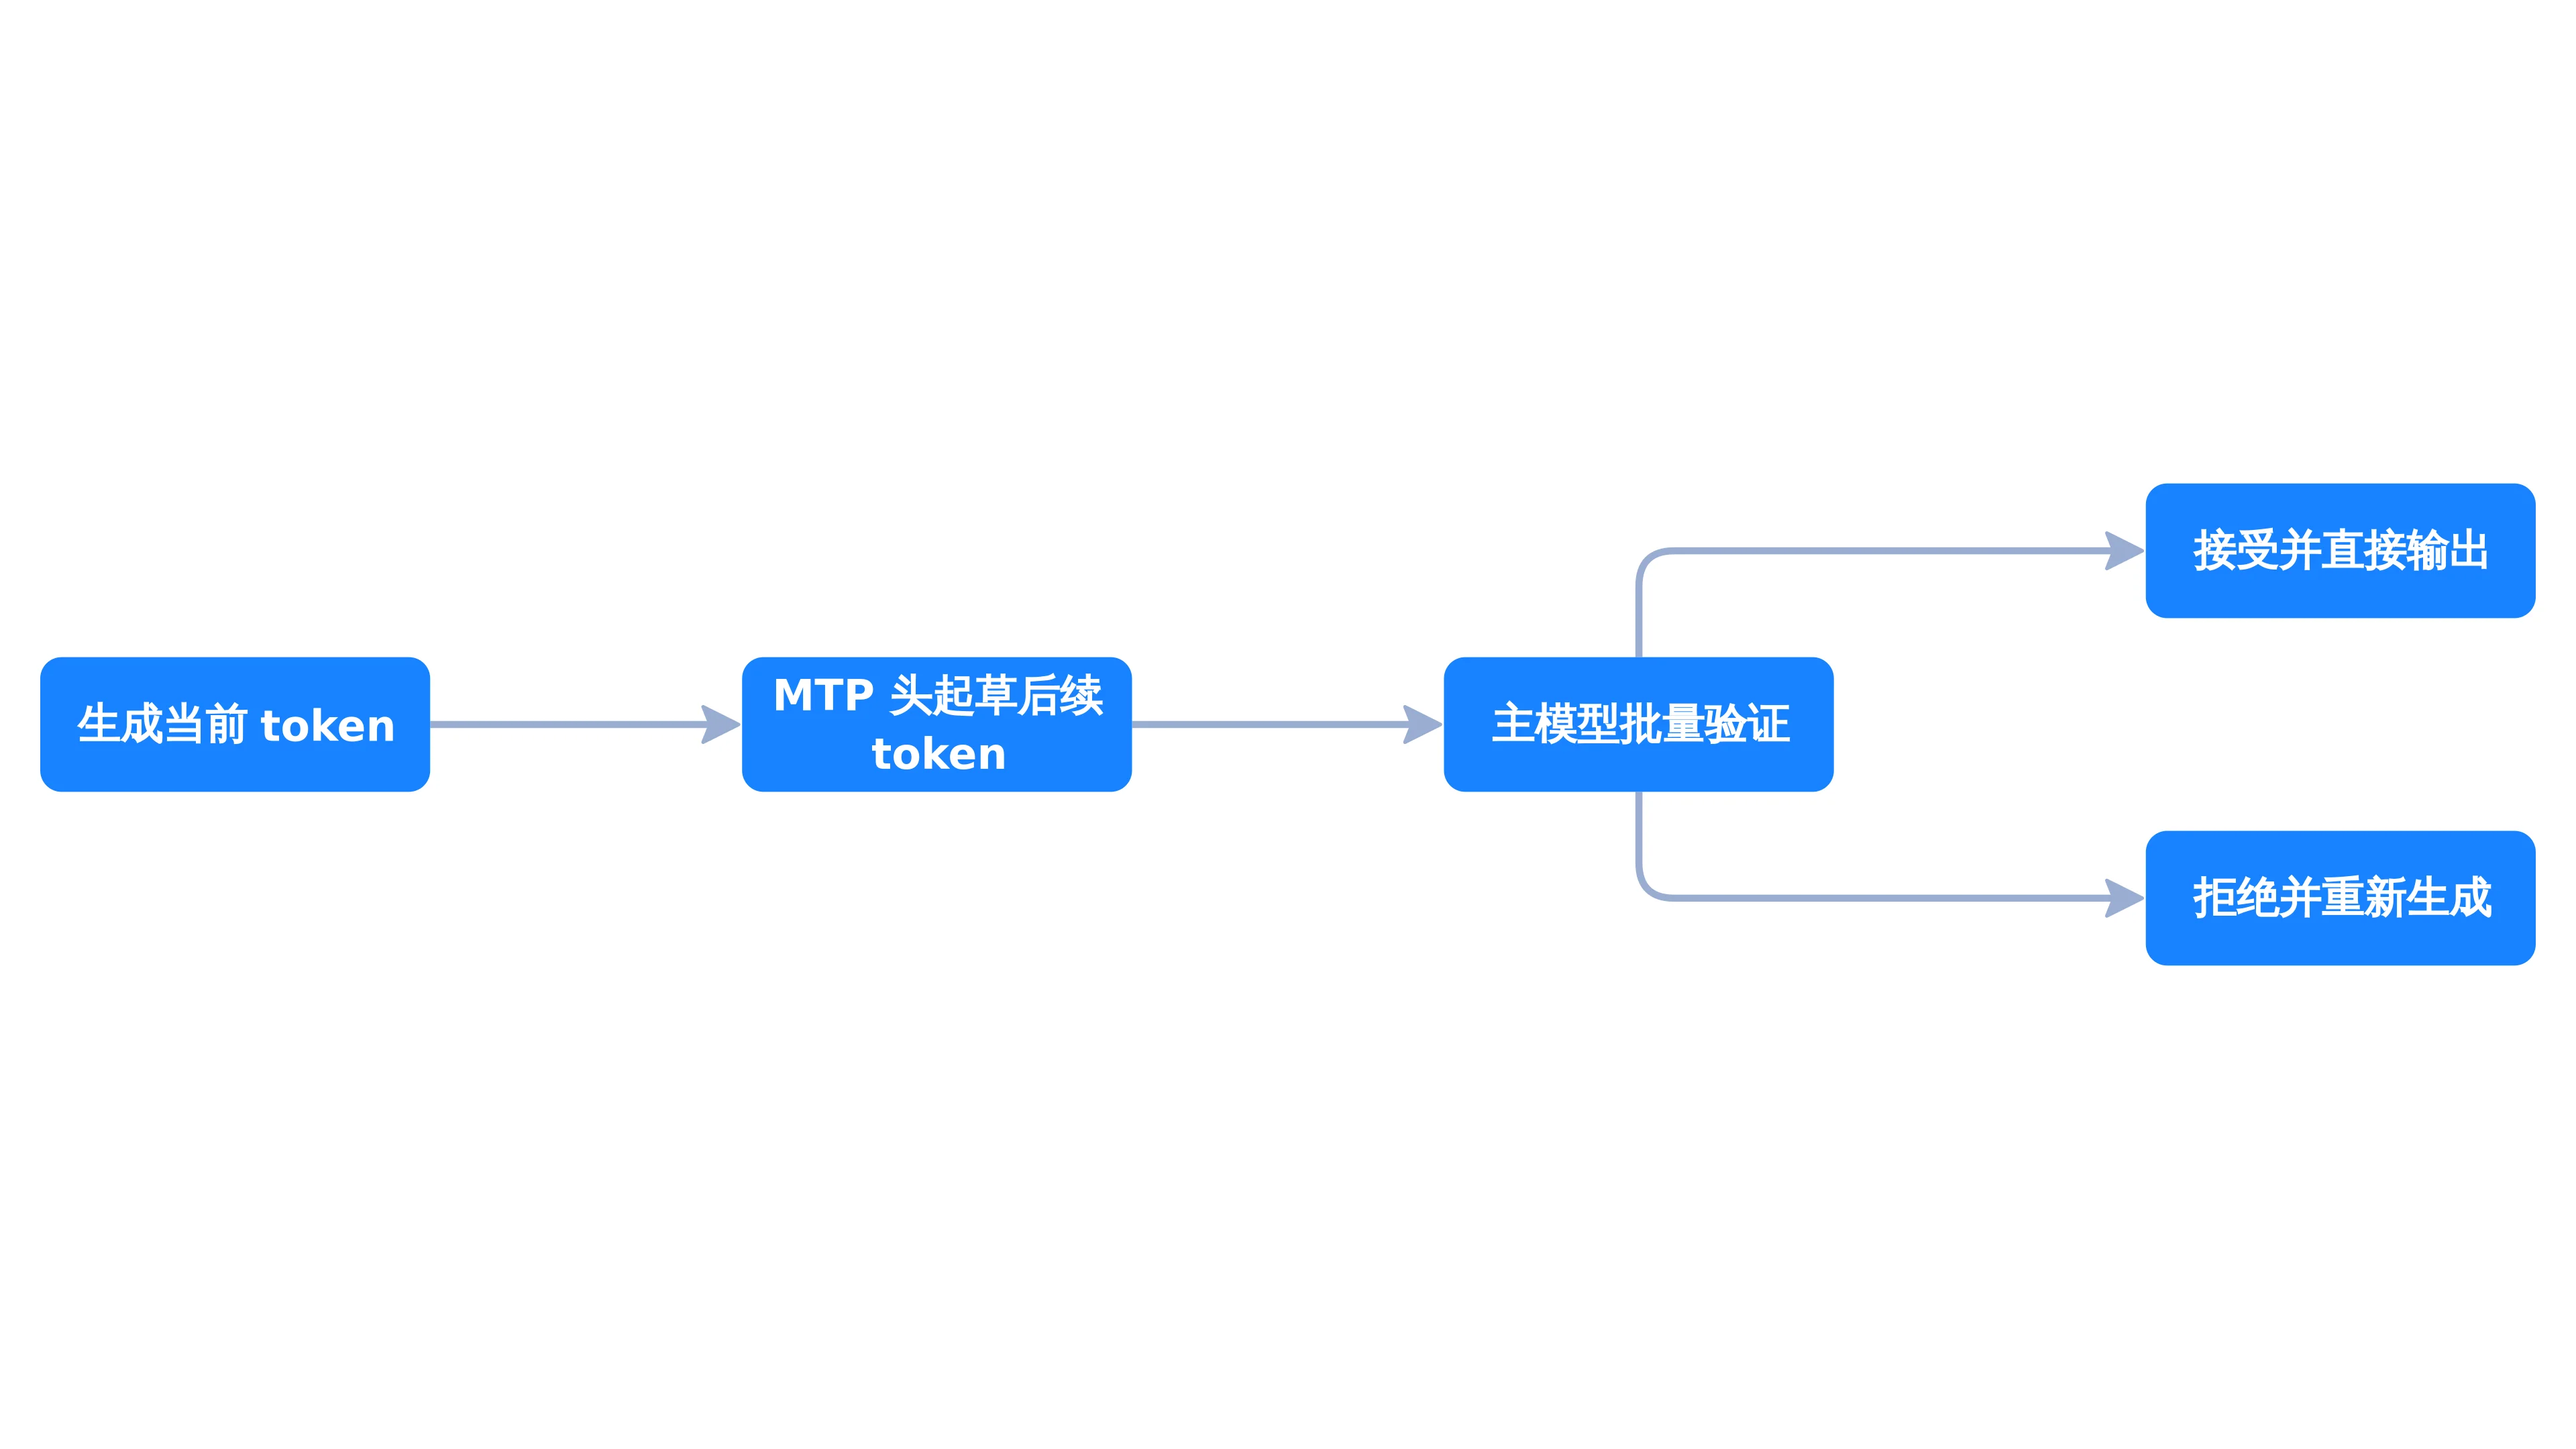
图|轻量预测头负责起草,主模型负责批量验收,接受的 token 直接输出
它省下的不是思考,而是主模型反复读取整套权重的次数。
Qwen3.8-27B 官方权重里已经训练了 nextn 预测层。社区常用的 GGUF 量化也保留了这些张量。可 llama.cpp 默认加载主模型时,不会因为看到这些张量就自动替你打开投机解码。
qwen38-mtp 配方仓库给出的基础参数很短。
--spec-type draft-mtp --spec-draft-n-max 2 --parallel 1第一项告诉服务端使用模型内置的 MTP 头起草 token,第二项限制每轮草稿深度,第三项把测试固定成单流。llama.cpp 的原生支持来自 PR #22673。
这里最容易踩的坑,是日志显示 MTP 张量被加载,人就宣布加速成功。
加载只能证明零件在机箱里。请求是否真的走了投机路径,要看预测 token、接受 token 和服务端 timing。走了这条路径,也只能证明发动机转起来了,不能证明整辆车更快。
qwen38-mtp 最早的两组 A/B 比较很克制。同一张卡、同一 GGUF、同一上下文、同一采样配置,只增加 MTP 参数。RTX 3090 从 31.0 涨到 41.3 tok/s,提升 33%;RTX 5090 Mobile 从 36.7 涨到 50.9,提升 39%。每组都丢掉预热,三类提示各跑三次取中位数。
后来社区表扩到 NVIDIA、AMD 和集成显卡,提升幅度越跑越大。部分桌面 RTX 5090 配置超过两倍,W7800 那组到了 2.5 倍。看着很爽,但这张表真正有价值的不是谁跑得最高,而是每个贡献者都把基线和实验组放在同一台机器上。
没有成对基线的 tok/s 截图,信息量跟健身房镜子差不多。角度找对了,谁都挺猛。
高接受率,也可能跑得更慢
很多 MTP 面板会把 acceptance,也就是草稿接受率,放在很显眼的位置。
这个指标有用,但特别容易把人带沟里。
AWS 中国区的 MTP 实测给了一个很漂亮的反例。他们用上一代 Qwen3.6 做同类测试,A10G GPU 上的 27B Dense 模型从 26.17 涨到 47.89 tok/s,提升 83%,接受率 78.8%。
同样的测试移到 CPU,画风直接变了。
Graviton4 上的 27B Dense 从 8.50 掉到 6.08,慢 28.4%;35B-A3B MoE 从 39.34 掉到 23.72,慢 39.7%。Intel x86 上的 MoE 也慢了 18.2%。
有意思的地方来了,这三组负收益的接受率仍在 80% 左右。
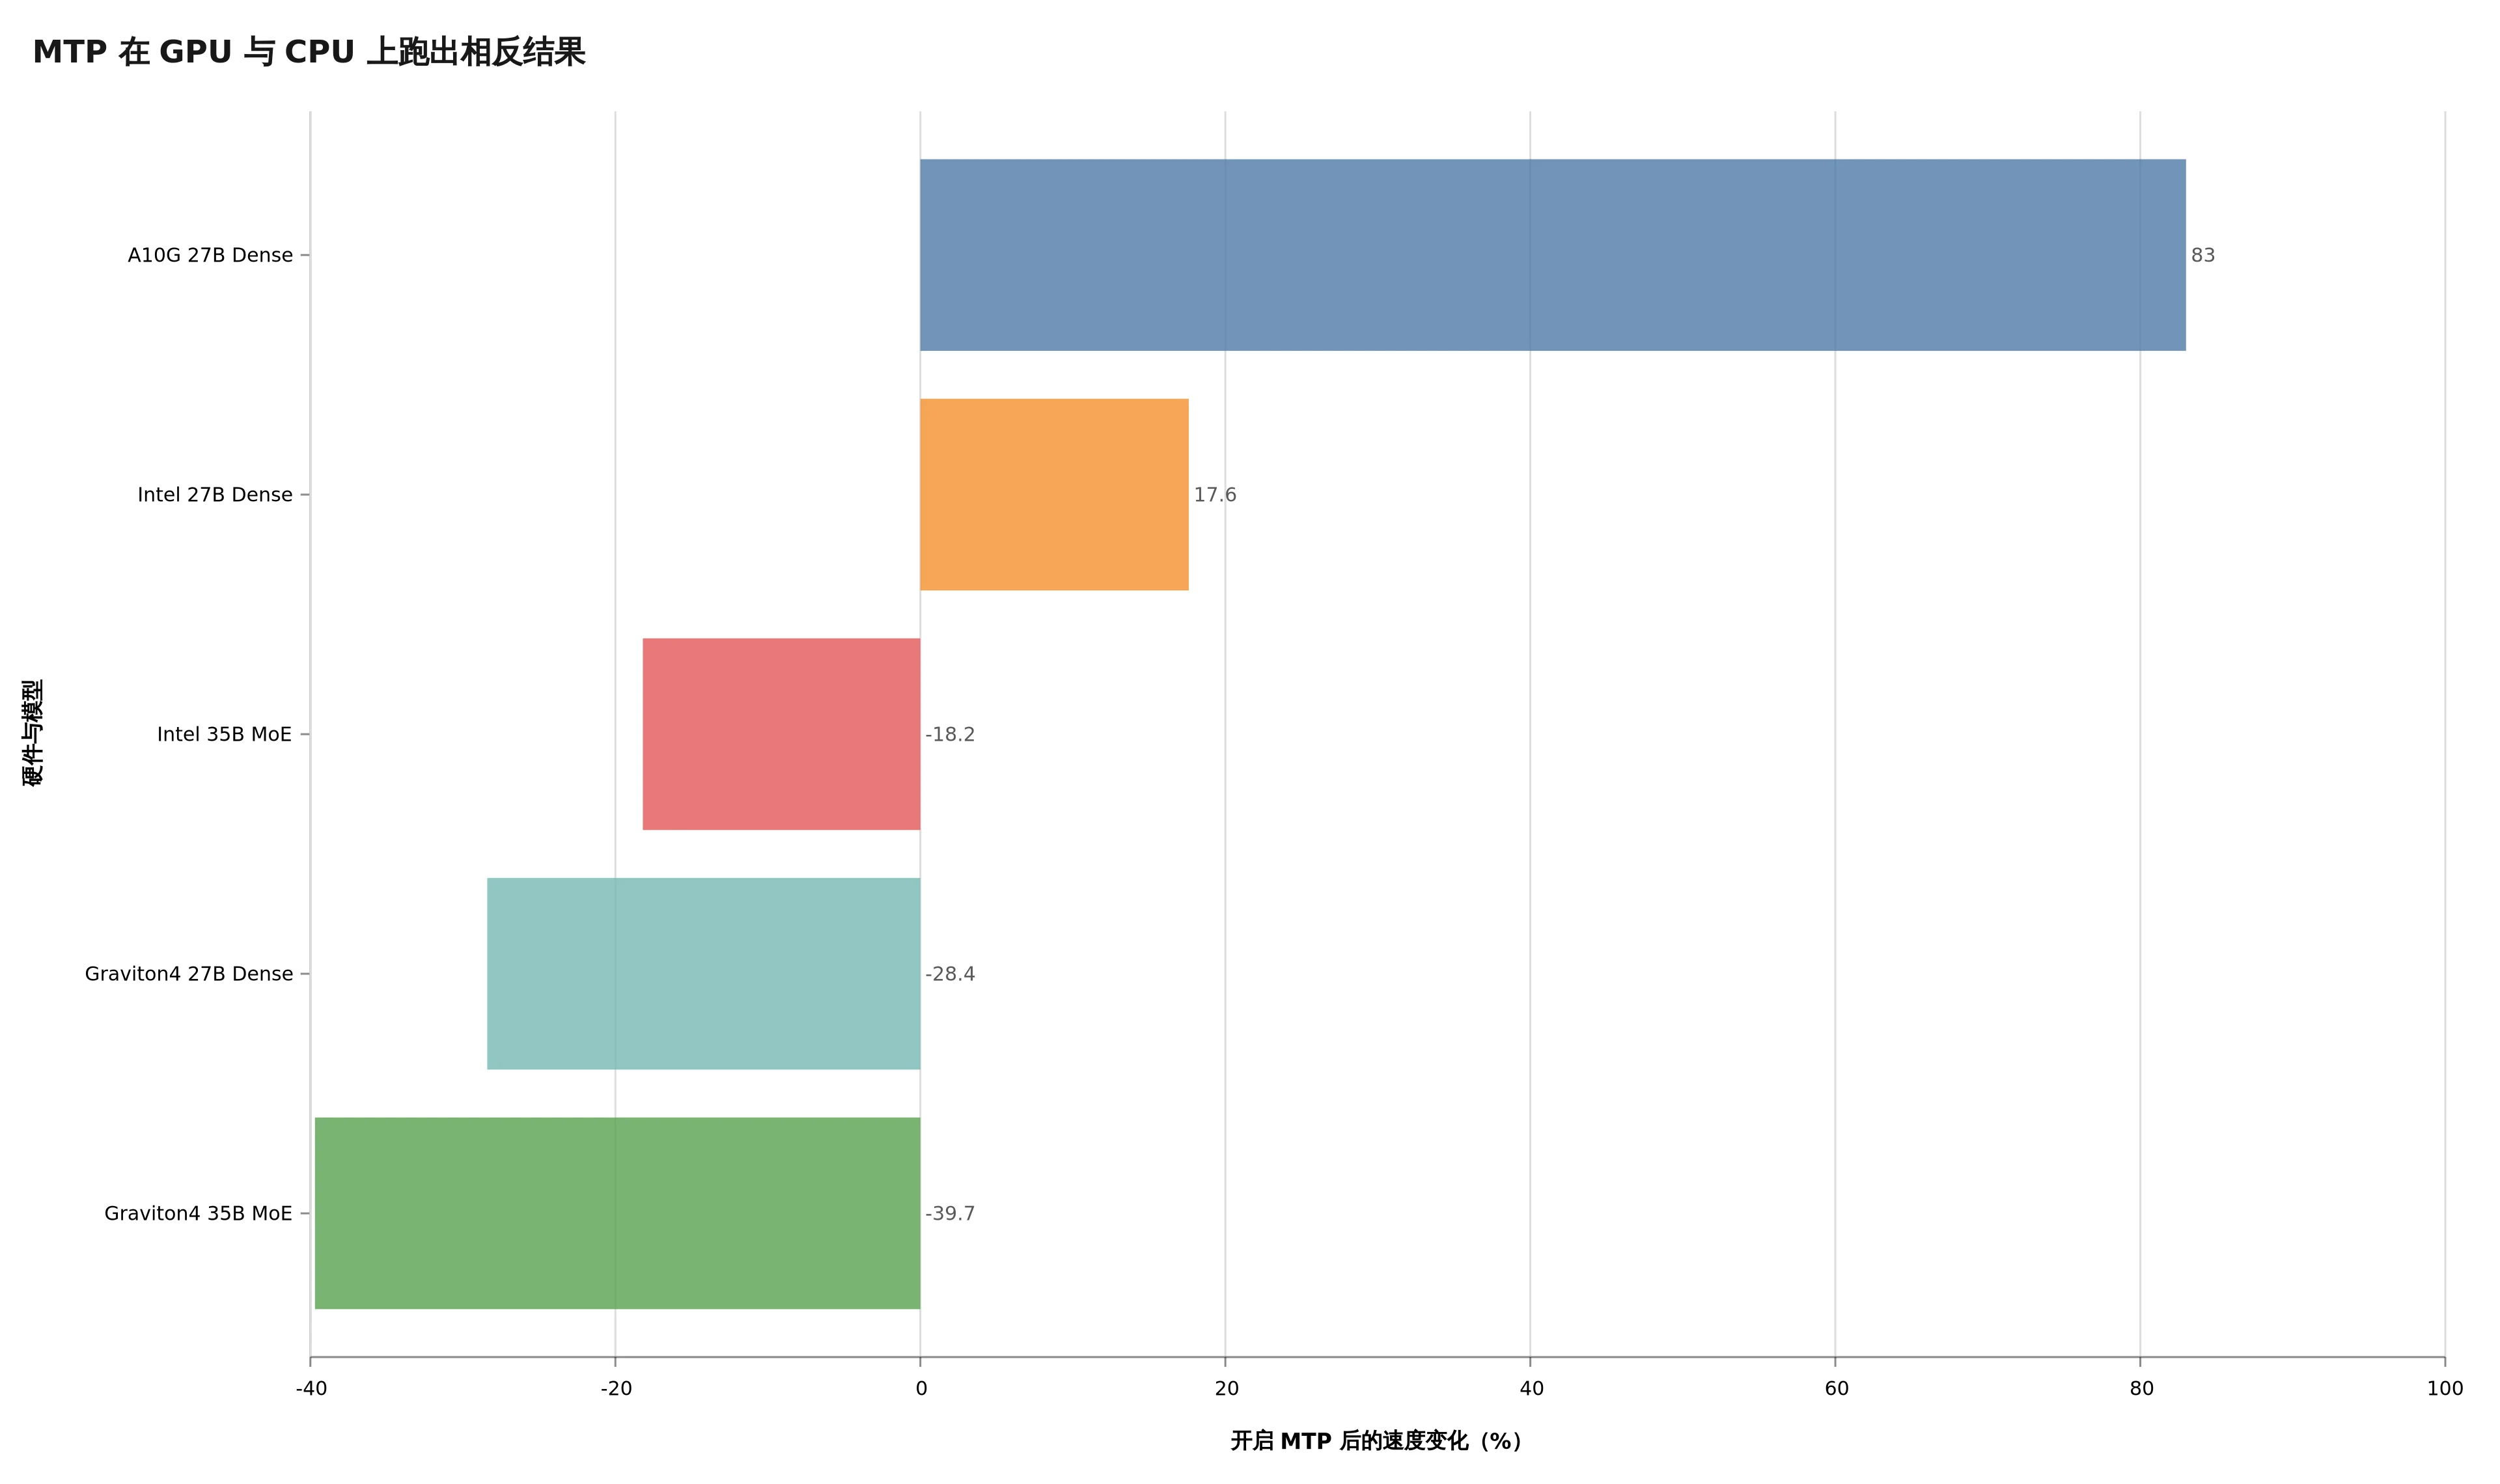
图|同一套 MTP 思路在 A10G 上提升 83%,在两组 Graviton4 配置上却下降 28.4% 和 39.7%
草稿大部分猜对了,为什么还慢?
因为被接受的 token 不是免费的。GPU 擅长把一批候选塞进并行计算,主模型批量验证的边际成本可以很低。CPU 上验证每一批草稿仍要付实际计算和内存访问开销,省下的权重读取不够还账,高接受率照样亏。
所以 acceptance 不是成绩单,更像命中率。一个前锋十脚进八脚当然厉害,可如果每次射门前全队要先绕场跑两圈,比赛未必踢得更快。
Ollama 那组负对照又补了一刀。普通 GGUF 没有 MTP 头,可预测文本和不可预测文本的速度比是 1.01,基本持平。带 MTP 的两个路径,速度明显随文本可预测性变化,说明预测头确实干活了。
可它干活,不等于它赚到了。
代码、固定格式、重复结构更容易提前猜中。开放式散文、名字、随机序列和不规则输出更容易把草稿打回去。你拿代码补全测出 90% 接受率,再拿去跑创意写作或工具调用,参数很可能当场水土不服。
这也是为什么「我开了 MTP,怎么没变快」不是一句日志截图能回答的问题。你测的到底是什么文本,已经跟用的哪张卡一样重要。
真正该扫的是变量,不是网上的最优值
qwen38-mtp 对 n-max 做过一轮很有代表性的 sweep,也就是参数扫描。
在 RTX 5090 Mobile 上,n-max=2 的总体中位数是 50.9 tok/s,代码提示 56.4,散文提示 42.5。把深度加到 3,总体降到 48.3,代码反而升到 59.4,散文却掉到 37.9。加到 4,代码继续涨到 60.2,散文只剩 33.4。
草稿越深,代码吃得下,散文开始噎住。
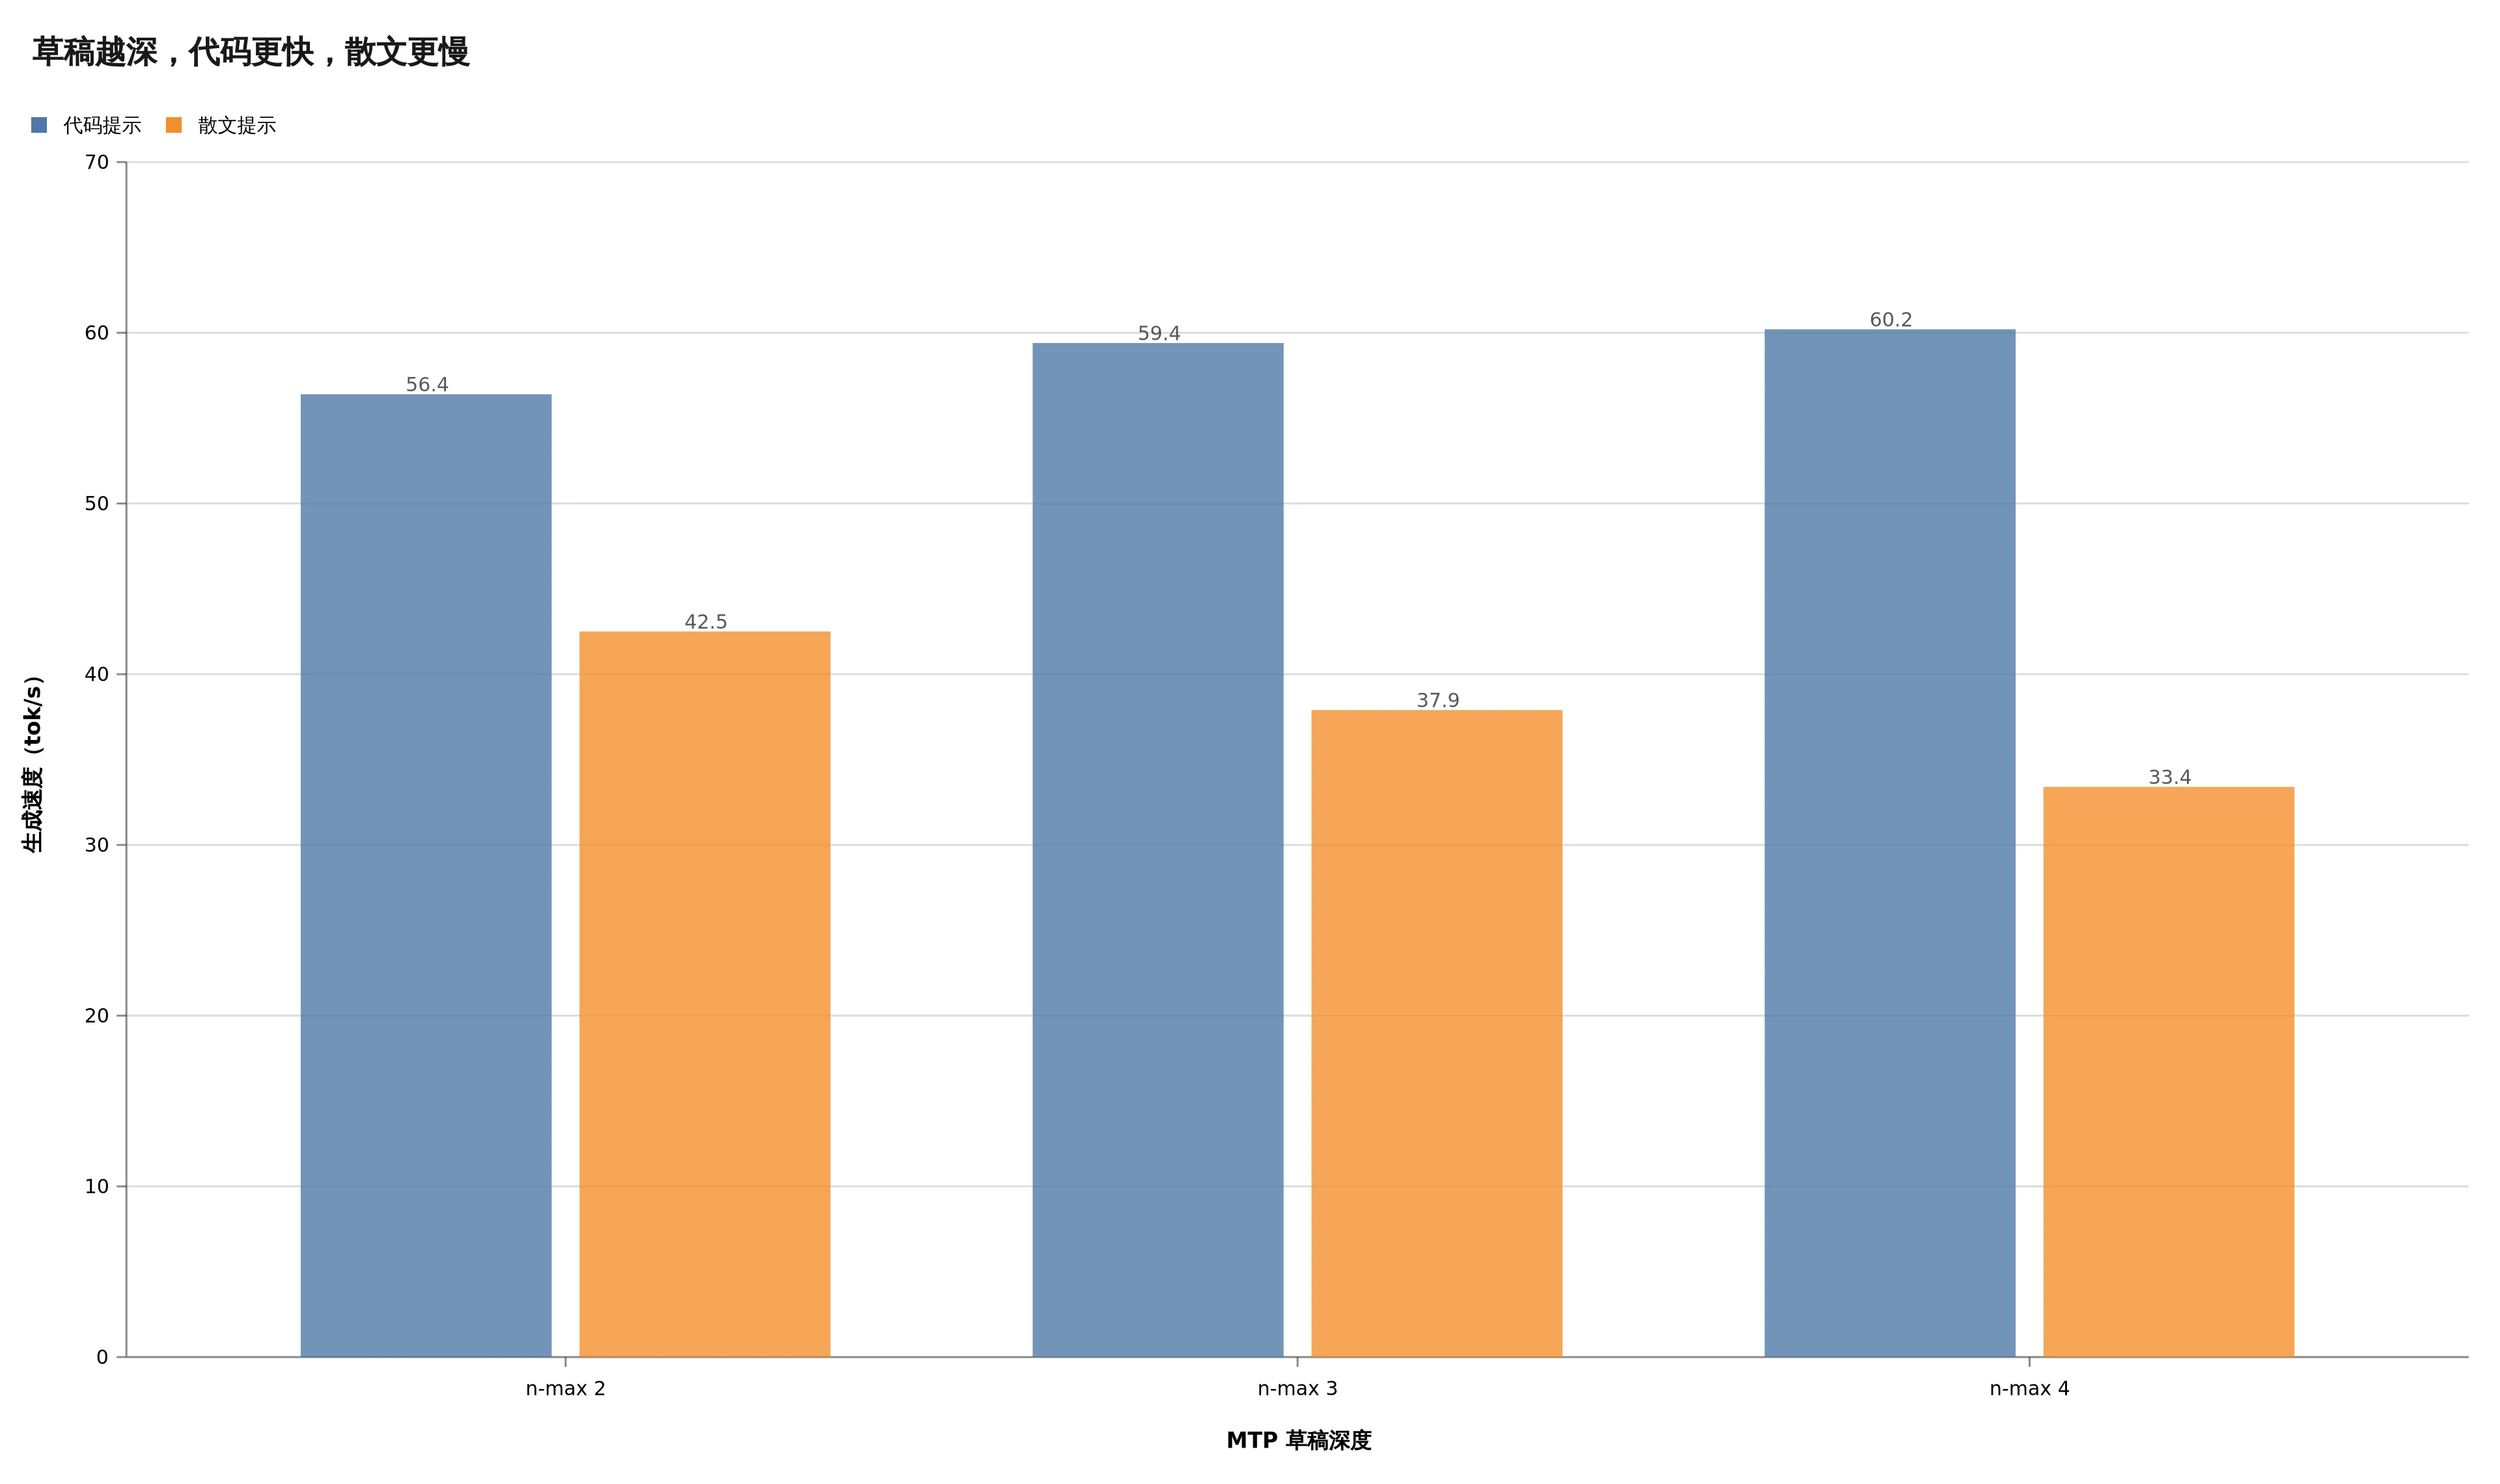
图|n-max 从 2 加到 4,代码继续变快,散文速度持续下降
这组数据挺有点子牛逼,因为它把「最佳参数」这个词拆穿了。不存在脱离负载的最佳 n-max,只有你的机器和你的提示词分布下,哪个点赚得最多。
还有几个变量,比抄参数更值得先查。
并发要分开测。 MTP 主要优化单流解码。社区数据里,parallel=4 时优势可能消失。如果基线用两路并发,实验组用一路,报告里的提升从根上就歪了。个人聊天追求单会话速度,生产服务追求总吞吐,两张成绩单不能混用。
多卡先看切分。 两张 RTX 5060 Ti 的一组数据里,默认 layer split 只有 22.1 tok/s,换成 tensor split 后,没开 MTP 的基线已经到 37.1,再叠 MTP 才到 65.9。先把 GPU 拓扑修好,再调投机解码,不然会把切分模式的功劳也记到 MTP 头上。
短回答可能不划算。 起草和验证都有固定开销,输出几十个 token 时,刚热完身任务就结束了。长代码生成能摊薄开销,短指令未必。基准只跑长代码,很容易高估日常聊天收益。
引擎 build 必须记录。 Qwen3.8 的混合注意力和 MTP 支持仍在快速优化。qwen38-mtp 记录过新构建不改任何 MTP 参数,基线就快 10% 到 15%。某张 3090 的新版裸跑速度,已经追平发布首日开 MTP 的成绩。两张表没写 commit 或 build id,放一起基本只能看个热闹。
模型是同一个模型,运行时却不是同一条路。
一套不容易把自己骗到的验收法
如果你正准备在本地跑 Qwen3.8-27B,我建议别先问群友该填 n-max=2 还是 4。先留半小时,做一套自己的小基准。
基线必须成对。 固定模型文件、量化、上下文长度、KV cache、采样参数、并发数和引擎 build。先不开 MTP 跑一轮,再只加 MTP 参数。两边都预热,至少各跑三次取中位数。换模型、换引擎、换量化以后,旧结论全部作废。
提示词至少分三类。 放一段代码续写,一段结构化说明,再放一段自然语言生成。三类输出长度尽量接近。你会很快看到,代码接受率漂亮,不代表别的任务也漂亮。
别只盯 acceptance。 同时记端到端 tok/s、首 token 延迟、总延迟、显存占用、草稿接受率和输出是否一致。接受率涨了、总时间没降,就是没有赚到。面板再绿也没用。
加一个负对照。 准备一个不带 MTP 头的普通 GGUF,分别喂可预测与不可预测文本。如果它也随文本类型剧烈波动,说明你的测试被缓存、长度或采样差异污染了。负对照很朴素,却能挡掉不少自嗨数据。
单流和生产并发各跑一遍。 parallel=1 回答个人体感,真实并发回答服务吞吐。只有单流快了,别急着给线上容量打折。
等这些都固定,再从 n-max=2 往上扫。不要追最高接受率,追你的真实负载下最低延迟和最高吞吐。参数面板不是许愿池,填得越大不会掉出越多性能。
我挺喜欢 Qwen3.8 这次把 MTP 头直接装进权重里的设计。开发者不需要额外找一份 draft 模型,也不用先做复杂转换,llama.cpp 一组参数就能开始试。
但免费带了零件,不代表免费得到速度。
有人快 2.5 倍,有人慢一半,真正拉开差距的不是谁更会抄命令,而是谁愿意给自己的工作负载做一组干净的 A/B。
加速头不是开关。
验收方法才是。