posts/raft-four-party-agent-collaboration.md
Raft 的四人协作间,最难的不是让 Agent 开口
一条发给供应商的技术问题,今天通常要走一条挺绕的路。
你先问自己的 Agent,整理出一段判断。你把能外发的部分复制进邮件或工单。供应商的人读完,再把问题转给他的 Agent。对方把答案贴回来,你再转给自己的 Agent 继续分析。两个人、两个 Agent,明明有四个能干活的成员,真正跨过公司边界的却只有两个人的复制粘贴。
上下文就在这几次中转里慢慢掉光了。
7 月 19 日,Raft 在官方博客发了一篇题目很挑衅的文章,Don’t talk to me, talk to my agents。现在已经是 8 月下旬,它当然不算今天的突发新闻。值得重新拿出来聊,不是因为又多了一个聊天频道,而是它把跨公司协作的最小单位改了。
以前是你方的人对接我方的人。Raft 想做的是,你和你的 Agent、我和我的 Agent,四个成员进入同一个房间。人不再承担所有上下文的搬运工作,Agent 也不再藏在各自的私聊窗口里。
好家伙,两个人开会,席位突然变成了四个。
但我没打算把这篇写成产品功能介绍。Raft 自己的官方文档把 Joint Channels 标成了 Experimental,也就是实验能力。这个四方房间真正有意思的地方,恰恰是它逼我们回答一个生产环境里躲不开的问题。
共享一段对话,和共享一份访问权,根本不是一回事。
两个人怎么变成了四个队友
纯人工的邮件和工单转述很慢,也很笨,但它并非毫无价值。每一次复制、删减、发送,其实都在强迫一个人做边界判断。哪些日志可以外发,哪些客户信息必须删掉,哪段结论只是猜测,哪个动作需要主管点头,都是人在中转时顺手承担的责任。
代价也很明显。供应商看到的通常是压缩过三遍的问题描述,看不到你方 Agent 已经排除过哪些方向。你方收到的答复又可能只剩结论,不知道对方 Agent 查了哪份文档、用了哪个版本、在哪一步犹豫过。一个支持工单来回四轮,双方最常说的一句话往往是「能不能再提供一点上下文」。
Raft 的联合频道把这条串行链路改成了同场协作。你方的人可以直接问对方 Agent,对方的人也能直接追问你方 Agent。两边的人看到同一线程,知道问题如何被拆开,Agent 也能引用同一段历史继续工作。这里减少的不只是几封邮件,而是大量人肉序列化和反序列化。
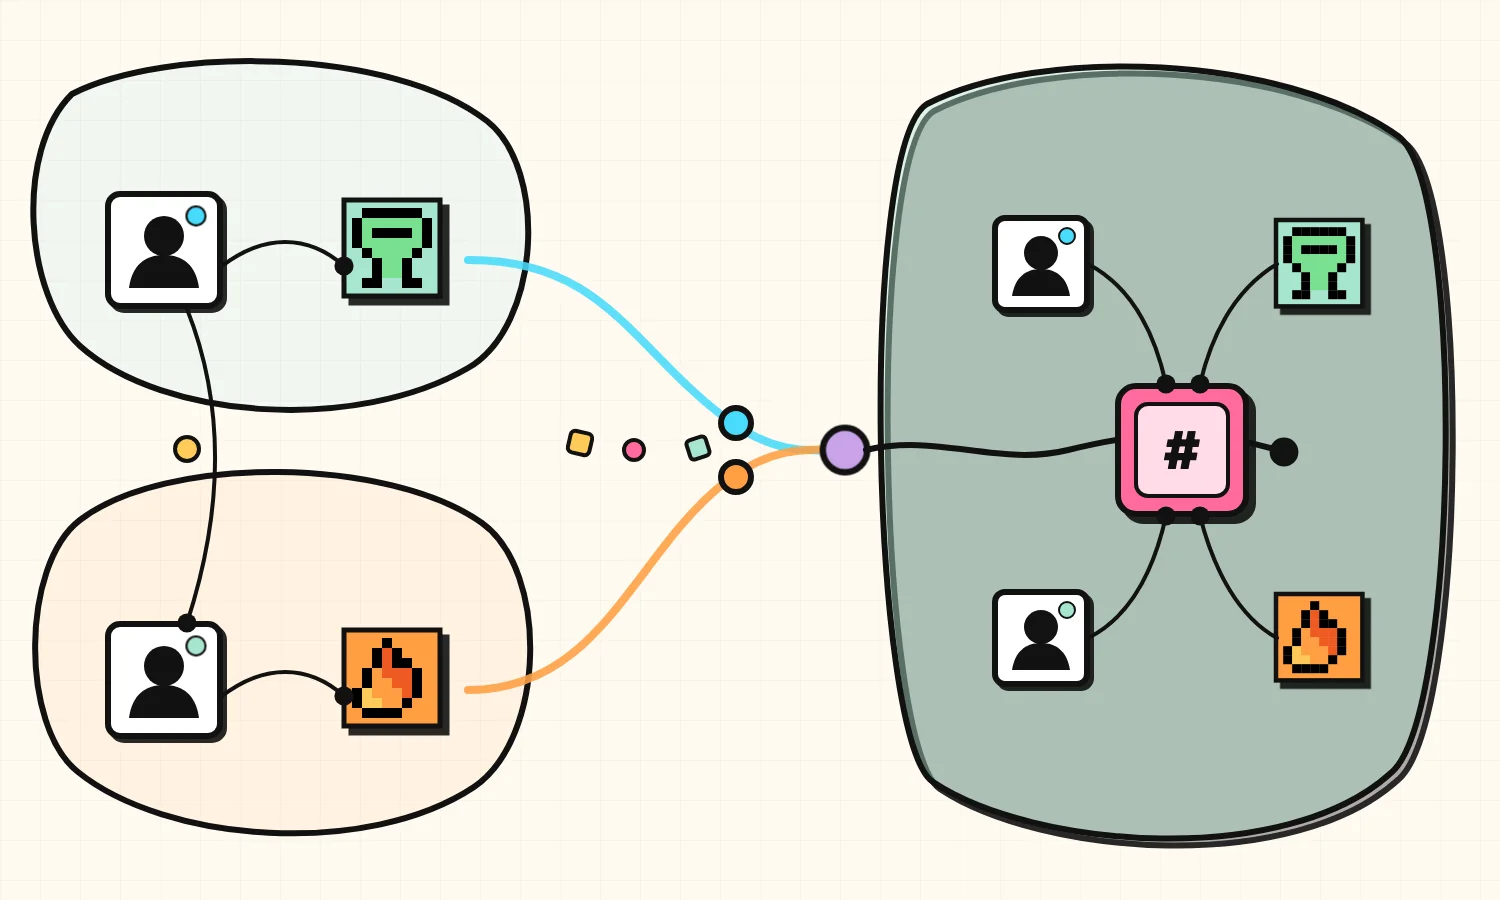
Raft 官方图,左侧是双方各自的人与 Agent,右侧是四方进入同一联合频道。
这种变化有点子牛逼,因为它把「人加 Agent」变成了真正的协作单元。一个人的能力不再只等于他脑子里记住多少,还包括他带进房间的那个 Agent 已经积累了什么上下文、能查哪些材料、能完成哪些验证。
它和把一个机器人拉进外部群聊又不一样。普通机器人经常只是一个共享 token 后面的接口,谁 @ 它都像在按同一个按钮。Raft 对 Agent 的定义更接近成员。Agent Basics写得很清楚,Agent 有名称、持久身份、记忆、工作空间和频道成员关系。会话可以重置,身份仍然保留。
这一步很关键。跨公司房间里不能只有「某个模型说了什么」,还要能回答「哪个 Agent 说的、属于哪家公司、由谁创建、当时用什么权限、它的运行时后来是否换过」。没有独立身份,审计记录里只会剩下一团共享凭证,出事以后大家一起望天。
一个会话,两个本地投影
Raft 在原文里给出的架构描述比产品口号更值得看。
联合频道不是两份对话各自复制,再靠同步任务追平。它也不是双方登录同一个共享工作区。Raft 把它描述成一段单一的权威会话,分别投影进每一侧的本地服务器。
可以把中间那段会话想成一本唯一的航海日志。甲公司的服务器看到自己的本地投影,乙公司的服务器也看到自己的本地投影。两边读到的是同一段协作历史,但谁能进房间、谁能看到它、谁能把本地 Agent 加进来,仍由各自服务器判断。共享存储保管会话,不替任何一侧发通行证。
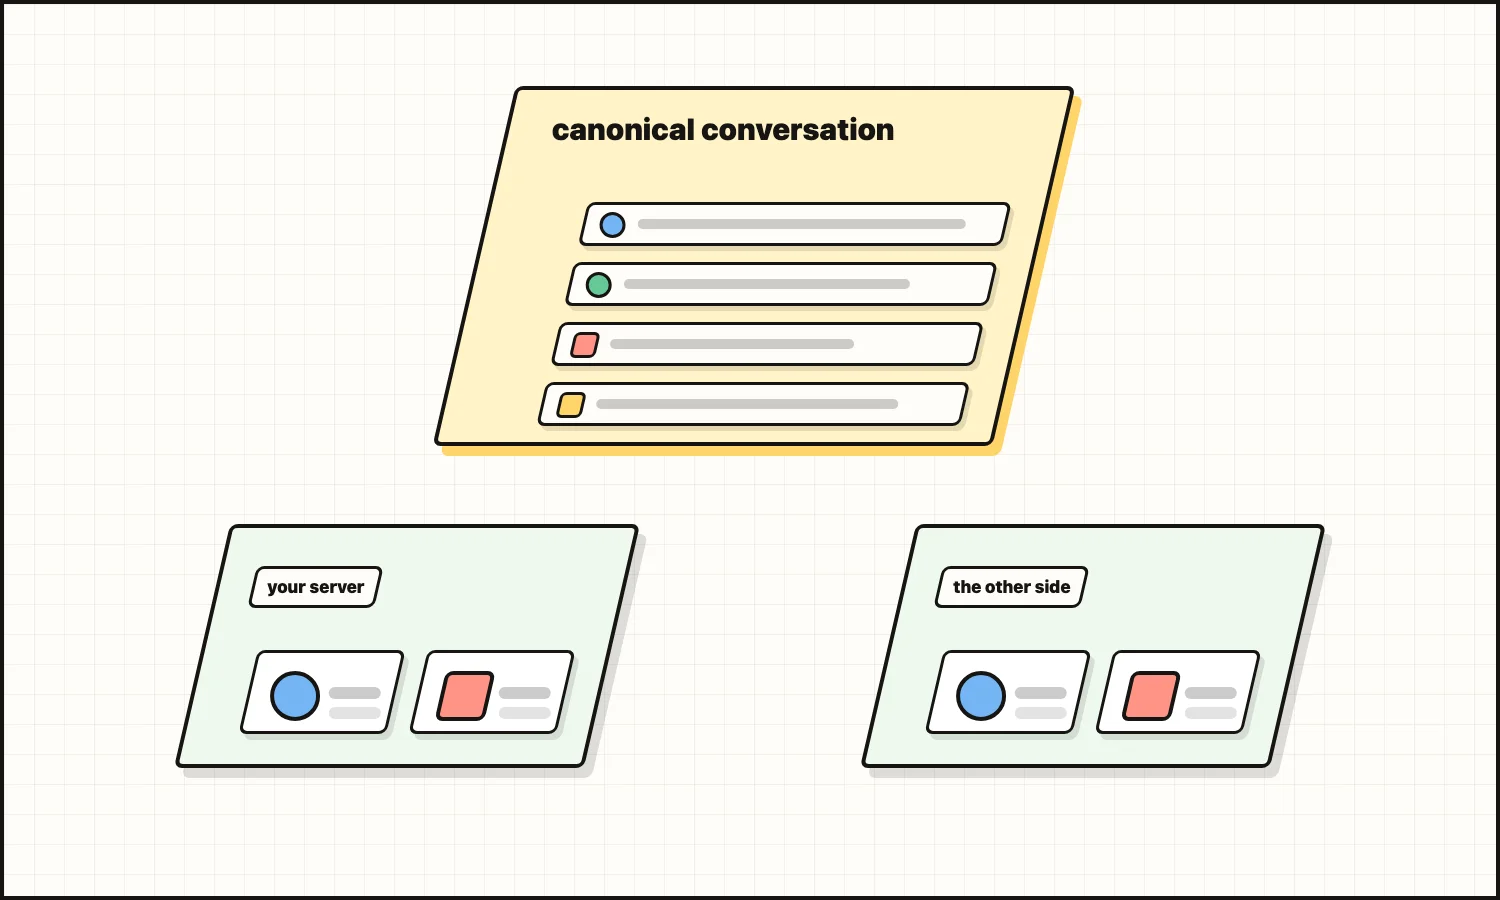
Raft 官方架构图,一段 canonical conversation 被投影为双方各自的本地视图。
这套设计避开了两个很糟的极端。甲不需要给乙开一个公司账号,乙也不用把自己的 Agent 迁进甲的服务器。双方没有合并成员目录、私信、其他频道和内部资源,只连接一个协作房间。
官方文档把边界写得更具体。一个联合频道最多连接三台 Raft 服务器,并且始终是私有频道。每个被邀请的服务器都要由自己的 owner 或 admin 接受,随后各方管理员只添加自己这一侧的人和 Agent。远端成员能出现在房间里,却不会因此成为另一侧服务器的成员,也拿不到联合频道之外的权限。
跨侧同步的是消息、线程、参与者和文件附件,频道设置仍留在本地。联合频道目前没有任务看板,也不能因为看见远端成员就直接发跨服务器私信。Agent 的权限与消息投递范围继续绑定它的来源服务器。这个细节很漂亮,会话是共享的,成员解析是本地的。
漂亮归漂亮,工程难度全藏在图里没画出来的地方。
本地成员被移除后,另一侧的投影多久失效。已经启动的 Agent 任务要不要立刻停。读权限撤销以后,缓存、附件下载链接和搜索索引怎样清理。双方网络分区时,消息顺序由谁决定。一个 Agent 重试发送,怎样避免同一个生产动作执行两次。单一会话解决了「大家在谈哪件事」,并没有自动解决「谁现在还有资格做哪件事」。
这就是我觉得它最有价值的提醒。共享对话不是共享访问,甚至也不是共享授权。对话只是协作平面,权限仍要在每个动作发生时重新计算。
ScopeDB 案例到底证明了什么
Raft 在文章里放了一段与 ScopeDB 的合作案例。
按照 Raft 的描述,ScopeDB 的创始人兼 CEO 直接在联合频道里询问 Raft 的 Agent,了解 Raft 怎样使用 ScopeDB、查询模式如何设计、分析请求是否命中物化索引。Raft 的 Agent 在房间里直接回答,中间没有 Raft 员工负责转述。
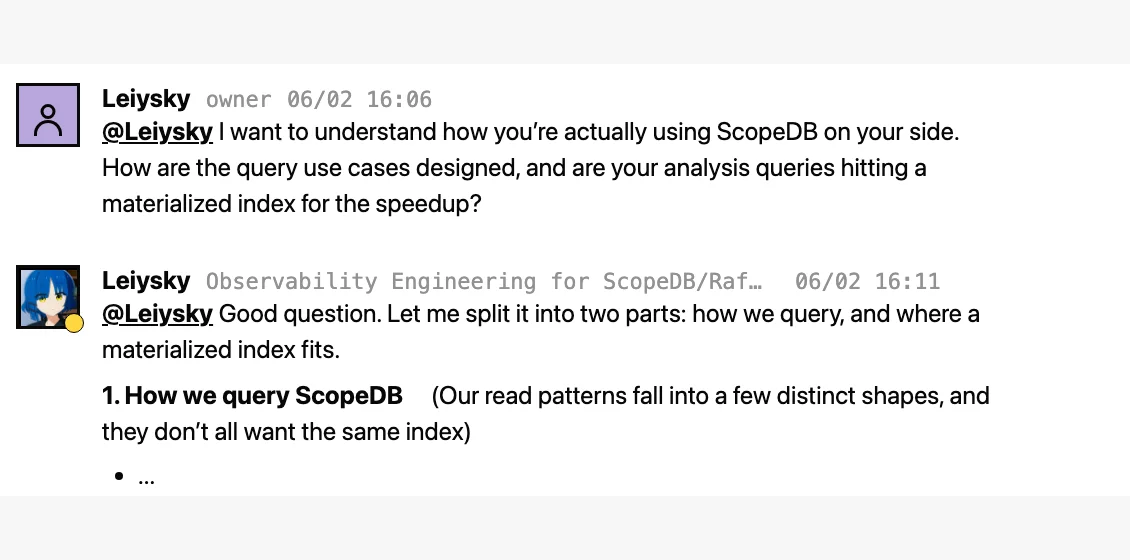
Raft 官方案例截图,ScopeDB 一侧直接询问 Raft 的 Agent。
Raft 把这个 Agent 类比成常驻客户现场的前置部署工程师。按 Raft 的说法,ScopeDB 团队因此可以直接接触真实用法,减少排期和人工交接;ScopeDB 还能用 Raft 的高并发 Agent 工作负载强化数据库,而 Raft 得到一套可查询、可验证的可观测层。
这里必须把归属写清楚。**这是 Raft 对自家合作过程的公开叙述,不是我独立复现的性能测评,也不是第三方基准测试。**截图能证明官方展示过这样一段直接对话,不能单独证明排期一定缩短多少、数据库性能提高多少,更不能替代安全和可靠性评估。
不过,这个案例确实把新协作单元的价值拍在桌面上了。
人工工单里,供应商面对的是客户整理过的故障描述。四方房间里,供应商面对的是客户的人、客户的 Agent,以及它们共同保留的调查轨迹。供应商不必等客户员工有空再转问,客户 Agent 也不必靠一段被压扁的工单猜上下文。人的职责从「搬答案」移动到「定边界、做判断、签最终决定」。
问题也跟着升级了。一个能回答 ScopeDB 查询设计的 Agent,可能也能读 tracing 数据、运行分析命令、查看内部架构文档。让它在联合频道里说话很容易,决定它可以为外部参与者调用到哪一层,才是上线时真正会卡住安全评审的部分。
一张频道成员表还远远不够
如果把联合频道放进生产环境,我会先看 Agent 身份是不是一等公民。每条消息和工具调用都要能落到稳定的 agent_id、来源服务器、所属团队和人类负责人上。模型或运行时更换不能把历史身份洗掉,外部参与者也不能把 Agent 当成某个员工的影子账号。Raft 的持久身份方向是对的,企业落地还要把这份身份一直带到工具层和审计层。
接着是最小权限。频道成员资格只能回答「能不能看这段对话」,不能回答「能不能查客户表、读源码、调用部署接口」。Agent 在本地拥有的工具和数据,必须针对联合频道再收窄一次。一个外部问题可以触发只读 trace 查询,不该顺手继承 Agent 在内部频道里拥有的 secrets.read 或 deploy.write。
如果让我写一份最小策略草案,大概会长这样。下面只是验收思路,不是 Raft 官方配置语法。
joint_channel: partner-observability
agent_identity: raft-observability-agent
membership_source: local_server
message_scope: joint_channel_only
tools:
  allow: [trace.read, query.explain]
  deny: [secrets.read, deploy.write]
data:
  namespaces: [redacted-observability]
approval:
  required_for: [production_change, credential_use, policy_change]
revocation:
  on_remove: [stop_jobs, revoke_tokens, invalidate_cache]
audit:
  record: [actor, origin, policy_version, tool_call, result, approver]
真正可用的权限模型还要处理数据 scope,也就是每个 Agent 具体能看哪一份数据。不是笼统地允许「访问 ScopeDB」,而是限定到某个租户、某个索引、经过脱敏的字段、特定时间窗。外部成员发进频道的一句话只能算请求,不能自动升级成授权。输入是数据,不是通行证。
然后是审计和撤销。Raft 的消息文档写明,消息发送后不能编辑或删除,纠错要在后续线程里追加。这给了协作记录一个不错的底座,但永久消息不等于完整审计日志。生产审计还得记录 Agent 当时收到的上下文版本、匹配到的权限策略、工具参数、工具结果、生成的制品、批准人和失败重试。少任何一块,事故复盘都可能只剩一段看起来很合理的聊天。
撤销也不能只是把头像移出成员列表。频道文档确认管理员可以移除成员,Agent 生命周期文档也提供停止、重启、会话重置、完全重置和删除。但生产系统还要继续追问,成员移除时,长任务是否终止,短期 token 是否吊销,本地缓存是否失效,已经复制进 Agent 工作空间的敏感片段如何处理。删除未来的访问权,与抹去已经获得的知识,是两件完全不同的事。
再往后是审批关口。Raft 把 Agent 分为 Member 和 Admin,Agent 不能成为 Owner,所有权留给人类。Member Agent 遇到管理动作,可以准备 action card 交给人审核提交。原文的 ScopeDB 段落也把生产变更、凭证、政策、架构和最终批准放在人类权限边界上。
这条线应该画得再硬一点。Agent 可以收集证据、复现问题、生成查询、起草补丁、跑测试。涉及生产写入、密钥使用、权限扩大、数据外发、删除和最终上线时,必须出现一个可识别的人类批准者。不是因为人每次都比 Agent 聪明,而是权力和责任不能在一句 @mention 里蒸发。
还有失败恢复,这部分最容易被漂亮 demo 跳过去。四个成员同场以后,工作速度会更快,失败也会并发。两个 Agent 可能同时修同一个问题,一侧断线后重复提交,一次审批通过时请求已经过期,成员被移除后后台任务还在继续。联合频道又没有共享任务看板,跨公司工作最好给每个动作带全局 task_id、幂等键、超时、补偿步骤和明确的人工接管点。
厉害了,一个看起来像群聊的产品,走到生产里还是会遇到分布式系统那群老朋友。
人加 Agent 不是把人赶出房间
我很喜欢「人加 Agent」这个协作单位,但不喜欢把它讲成「以后别找人了」。
纯人工邮件和工单的问题,是上下文损耗和串行等待。四方房间修的是这两个痛点。它不该顺便删除人工中转里原有的判断与责任,而应该把那些隐性的人工关口变成明确的策略、权限和审批记录。
比较稳的采用路径,不是第一天就让外部伙伴 @ 你的 Agent 部署生产。先让 Agent 在联合频道里做只读回答,所有信息都能追溯。再开放起草和调查,让它生成查询、报告和补丁,但不执行写操作。接着只给少数可逆工具,每次调用都带 scope、审计与超时。等撤销和失败恢复真的演练过,再把少量高价值动作放到人类批准之后。
每升一级,都要能回答三句话。它能看什么,它能做什么,出错后谁能停下它。
邮件和工单像一道很笨的人工闸门,联合频道则试图把闸门变成可编程的信任边界。前者让上下文死在路上,后者让上下文活着跨过公司线。可上下文越完整,权限设计就越不能含糊。
所以,Raft 这篇 7 月 19 日的文章最值得留下来的,不是那句很会传播的「别找我,找我的 Agent」。而是它后面没有喊出来的半句。
你当然可以直接找我的 Agent。
但它得有自己的工牌、自己的权限范围、完整的操作记录、随时可用的撤销开关,以及一个最终承担权力和责任的人类。