posts/rovo-mcp-v2-context-guardrails.md
Jira 接进 Agent 后,权限和上下文才是主流程
一份需求刚在 Confluence 里写完,开发要把它拆进 Jira。你通常会开三四个窗口,翻规格、查相似任务、补验收条件、找负责人,再把信息敲回工单。
现在,Agent 可以进来了。
Atlassian 在 9 月 8 日把 Rovo MCP v2 推到正式可用。它把 Loom、Goals、Projects、Teams、Focus、Talent、Bitbucket 接进同一条 MCP 服务,又给 Jira 和 Confluence 补了附件、白板、数据库、Sprint 等工具。
这串产品名看着很热闹。真正让我在意的,反而不是它又会多少个动作。
当一个 Agent 能读需求、搜项目、看 PR、建任务、改状态、补评论时,团队的主流程就不再是「给它接个连接器」。主流程变成三件更难也更值钱的事,让它在需要时拿到恰好的上下文,只拿它该拿的权限,并且留下人能接手的确认点。
这篇不讲一键把 Jira 遥控起来。那种演示五分钟很爽,第二天谁来解释多建的任务、错挂的附件、被带偏的冲刺,才是后半集。
版本号背后,先看它少暴露了什么
MCP 最容易被误解成一根数据线。把 Jira 接给模型,模型就会聪明一点。实际接过工具的人都知道,事情没这么简单。
工具定义本身也要吃上下文。一个服务端把几十个 Jira、Confluence、Bitbucket 的能力全摊给模型,模型还没读需求,提示词里已经塞进一大块工具说明。它要在一堆相似名字里挑动作,调用参数也更长,出错时很难看出它到底是没理解任务,还是在工具清单里迷路了。
Rovo MCP v2 的一个设计很像生产环境会做的取舍。它没有把所有工具都塞进连接时的默认列表,而是让客户端先看一小组高频工具,再按需发现其它能力。官方支持文档 也明确写了,这样做是为了把上下文留给用户真正的工作,不是留给工具说明书。
它在预览阶段给过一个数字,默认工具暴露减少后,上下文窗口消耗可降低超过 50%。这个数字不能替你估算自己团队的实际 Token 账单,毕竟每家项目结构、提示词、客户端行为都不一样。但方向很对,工具不是越全越好,默认可见的工具越少,模型越有机会先把眼前的问题看明白。
好家伙,MCP 走到今天,优化的已经不只是「能不能调用」,而是「别让调用本身把模型挤出上下文」。
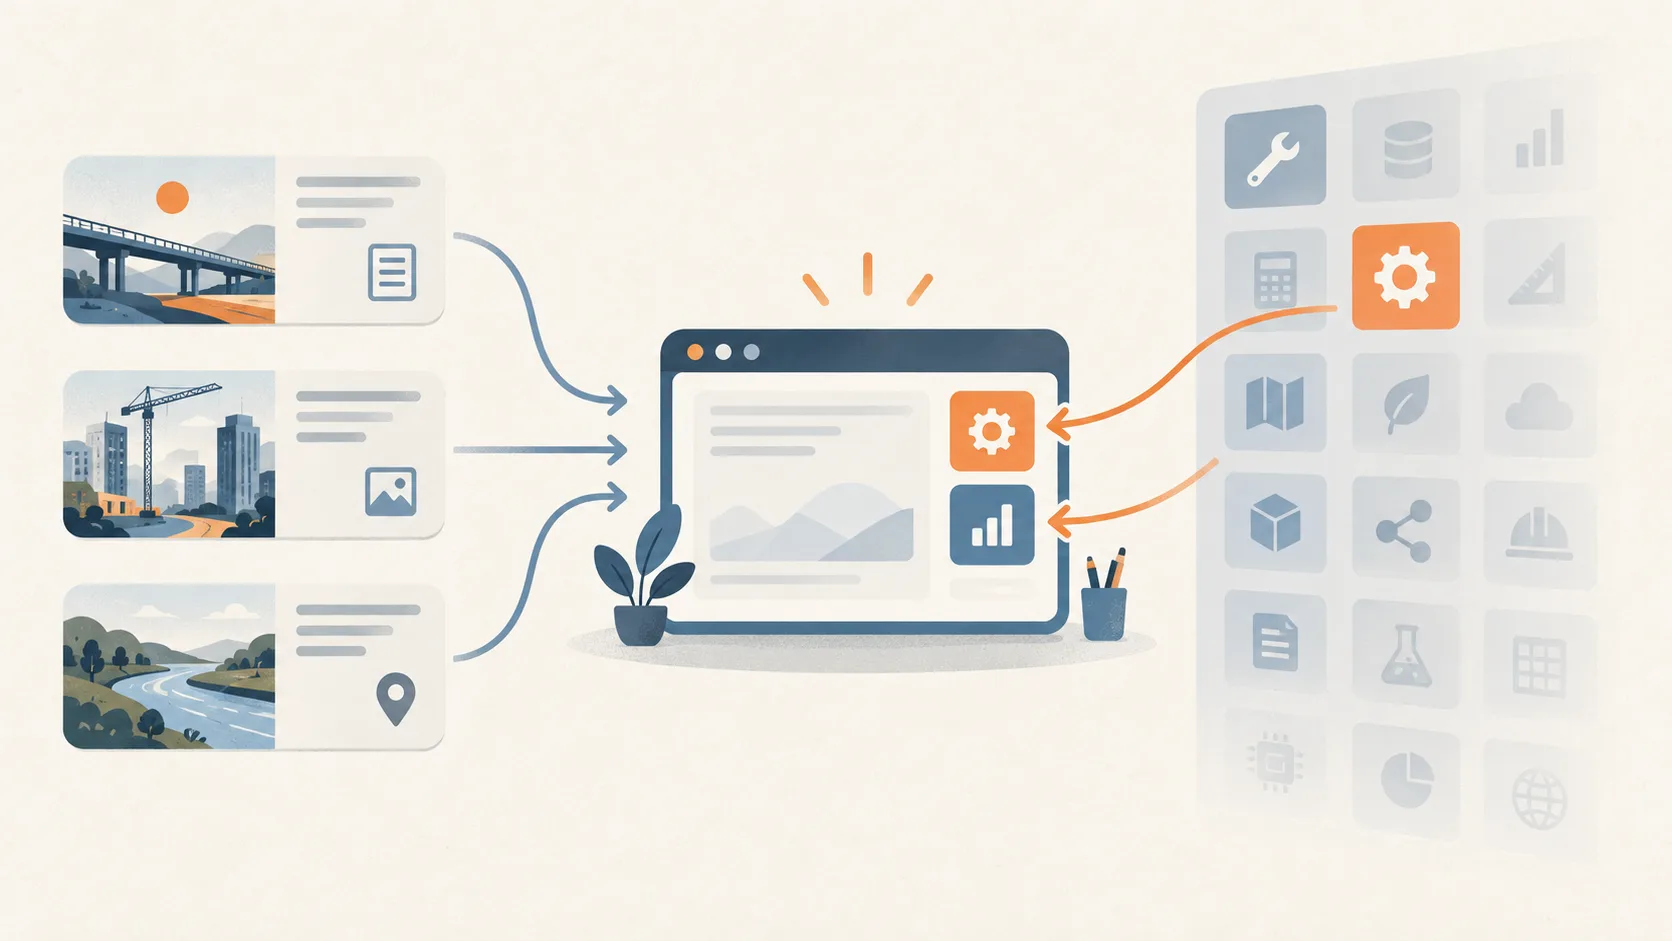
把高频能力留在前台,其余能力按任务发现。图为本文根据官方机制制作的示意图。
这也解释了一个看似反常识的建议。若你用的是 MCP Gateway,不要一上来就启用官方提供的全量工具清单入口。那个入口是给确实需要扁平工具列表的网关场景准备的,不是普通研发工作流的默认开关。工具越多,权限审计和失败排查的路径也越长。
你希望 Agent 帮你把需求拆成三张待办,它先需要的是当前规格、已有任务和团队约定。不是一百种修改入口。
能写 Jira,不等于应该自动写 Jira
Rovo MCP v2 的诱惑很直接。资料在 Confluence,进度在 Jira,代码和 PR 在 Bitbucket,录屏在 Loom。把这些放到一个对话里,确实少了很多来回切标签页的动作。
官方的接入说明列出了很像真实工作日的请求。
「这个 Sprint 卡在哪?」
「把 Q2 规划页总结一下。」
「根据这份会议记录创建五个 Jira 工作项。」
前两句是读取和归纳。第三句已经改变了团队的工作状态。
两种请求不该用同一套默认权限。前者最怕拿不到资料,后者最怕资料拿错了还真的写进去。Rovo 走 OAuth 2.1,并遵循用户现有的 Atlassian 权限,这是一个很好的底座。可底座不等于交付。现有权限本来就可能很宽,特别是项目管理员、Tech Lead 或长期没清理的服务账号。
所以我会把接入分成两条线。
一条线只读。让 Agent 搜索项目、汇总页面、归纳风险、找相似 Bug、把会议录屏里的决定列出来。它可以生成草稿,但不能改动任何工单。这个阶段要观察的不是「它回答得像不像人」,而是它引用的页面是否对、项目边界有没有串、结论有没有把旧信息当成新信息。
另一条线才是写入,而且写入一定要有可见的提交前页面。Agent 拟好任务标题、描述、负责人、优先级、关联 Epic,再让人确认一次。对批量创建、改 Sprint、上传附件、修改状态这类动作,确认页要把影响范围直接摊开。多少条、在哪个项目、哪些字段会变、能不能撤回。
这不是多加一道形式流程。它是在给 Agent 留一个刹车点。
很多自动化翻车都不是模型胡说八道,而是它拿到一个合理但过时的上下文,随后用一个过宽的写权限,把合理答案落实成了不合理的变更。人看到草稿时还能说「等等,这份 PRD 已经改版了」。写进去以后,团队通常只会在站会上发现哪里怪怪的。
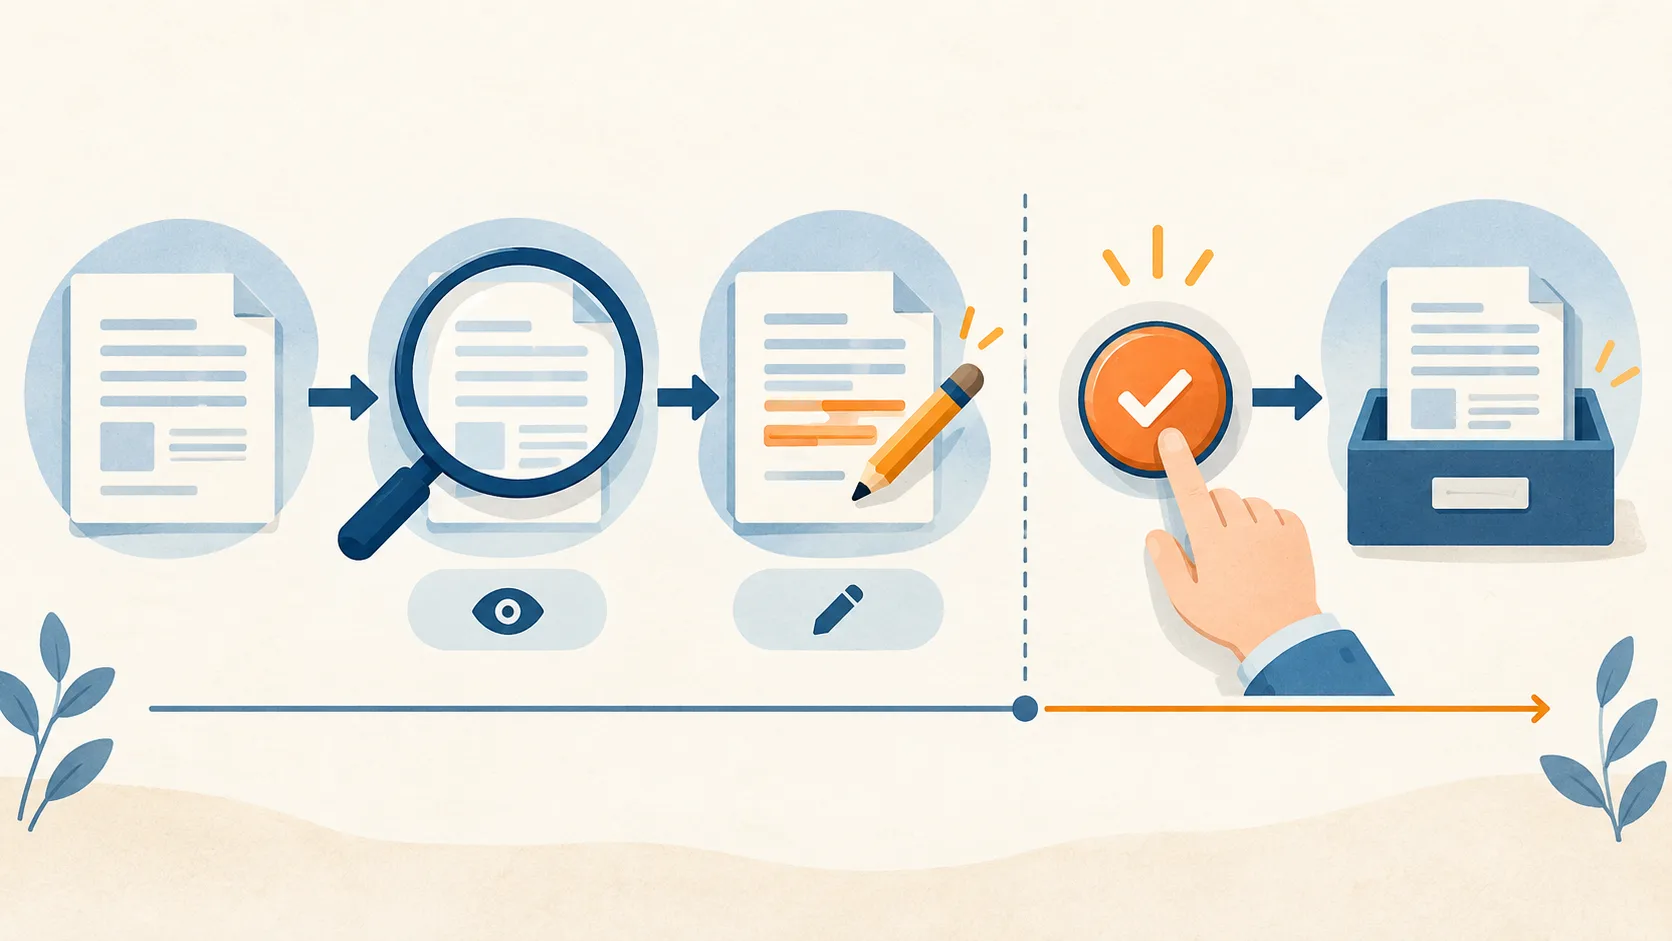
建议把读取、拟稿和写入拆开,越接近不可逆的动作,越应该让人确认。
Atlassian 自己在接入页的提醒也很朴素,MCP 客户端会在你已有权限内操作连接的产品,涉及高影响变更时应复核,并监控审计日志。这段安全提示 不花哨,但值得贴在每个 Agent 项目的开始位置。
上下文不免费,调用次数也不会自动消失
把项目资料交给 Agent,还有一笔很容易被忽略的账。
Rovo MCP 的资料检索和洞察会消耗 Rovo credits,这个池子和 Rovo Chat、Studio、Agents、Teamwork Graph 共用。官方说明里提到,拉取的上下文越大、请求的推理越复杂,消耗也会更高。用量规则在这里 能看到。
这不是说别用。恰恰相反,团队如果真把 Agent 当协作者,用量应该被设计,而不是等账单或限额提醒来了再猜。
一个实用的做法,是给每个工作流写一份极短的「上下文预算」。不必做成委员会文件,写清楚四句话就行。
「它为了回答这个问题,必须读哪几个空间和项目。」
「哪些资料只允许被搜索,不允许被下载、复制或写回。」
「单次任务先用多大的资料范围,不足时由谁允许扩大。」
「它写入前要展示什么,失败后由谁接手。」
看起来很土。可这四句话会逼你区分「我想让它知道所有事」和「它完成这件事实际需要知道什么」。前者会让工具调用膨胀,后者才有机会变成稳定流程。
举个不带滤镜的例子。产品经理问「把这周阻塞的需求整理出来」,Agent 没必要先把全公司的 Confluence 都喂进去。可以从当前项目、本 Sprint、状态为 blocked 的任务开始;信息不够,再让人点一下扩展范围。模型并不会因为少看了五百页历史会议纪要就委屈,它大概率还轻松一点。
现在接 v2,最该做的是一条窄流程
官方给出的 Codex 接入命令很短。
codex mcp add atlassian --url https://mcp.atlassian.com/v2/mcp短命令后面,仍然有 OAuth 登录、现有权限继承、客户端兼容性和团队规范。别把安装成功当成接入完成。
我更建议从一个窄到不能再窄的流程开始。比如只允许 Agent 读取一个项目的本 Sprint 和一组需求页,生成「风险摘要+待确认的 Jira 草稿」。连续跑几周,人工核对它漏了什么、拿错了什么、哪些字段总要人改,再决定要不要放开创建、评论或附件上传。
如果团队已在用 v1,这个检查也别拖。官方 changelog 写得很清楚,2027 年 3 月 1 日后,v1 会自动开始暴露和使用 v2 工具。某些不兼容客户端需要清掉缓存的 clientIds 或 .well-known 凭据才能重新认证,现有插件和连接器也可能需要重新添加。迁移说明 已经放在那里。
迁移最怕的不是端点改了,而是旧客户端在新工具集面前表现得「差不多能用」。这种问题不一定报错,却会把权限、工具选择和审计都拖进灰区。给它排一个小的回归清单,比等到业务高峰再修舒服得多。
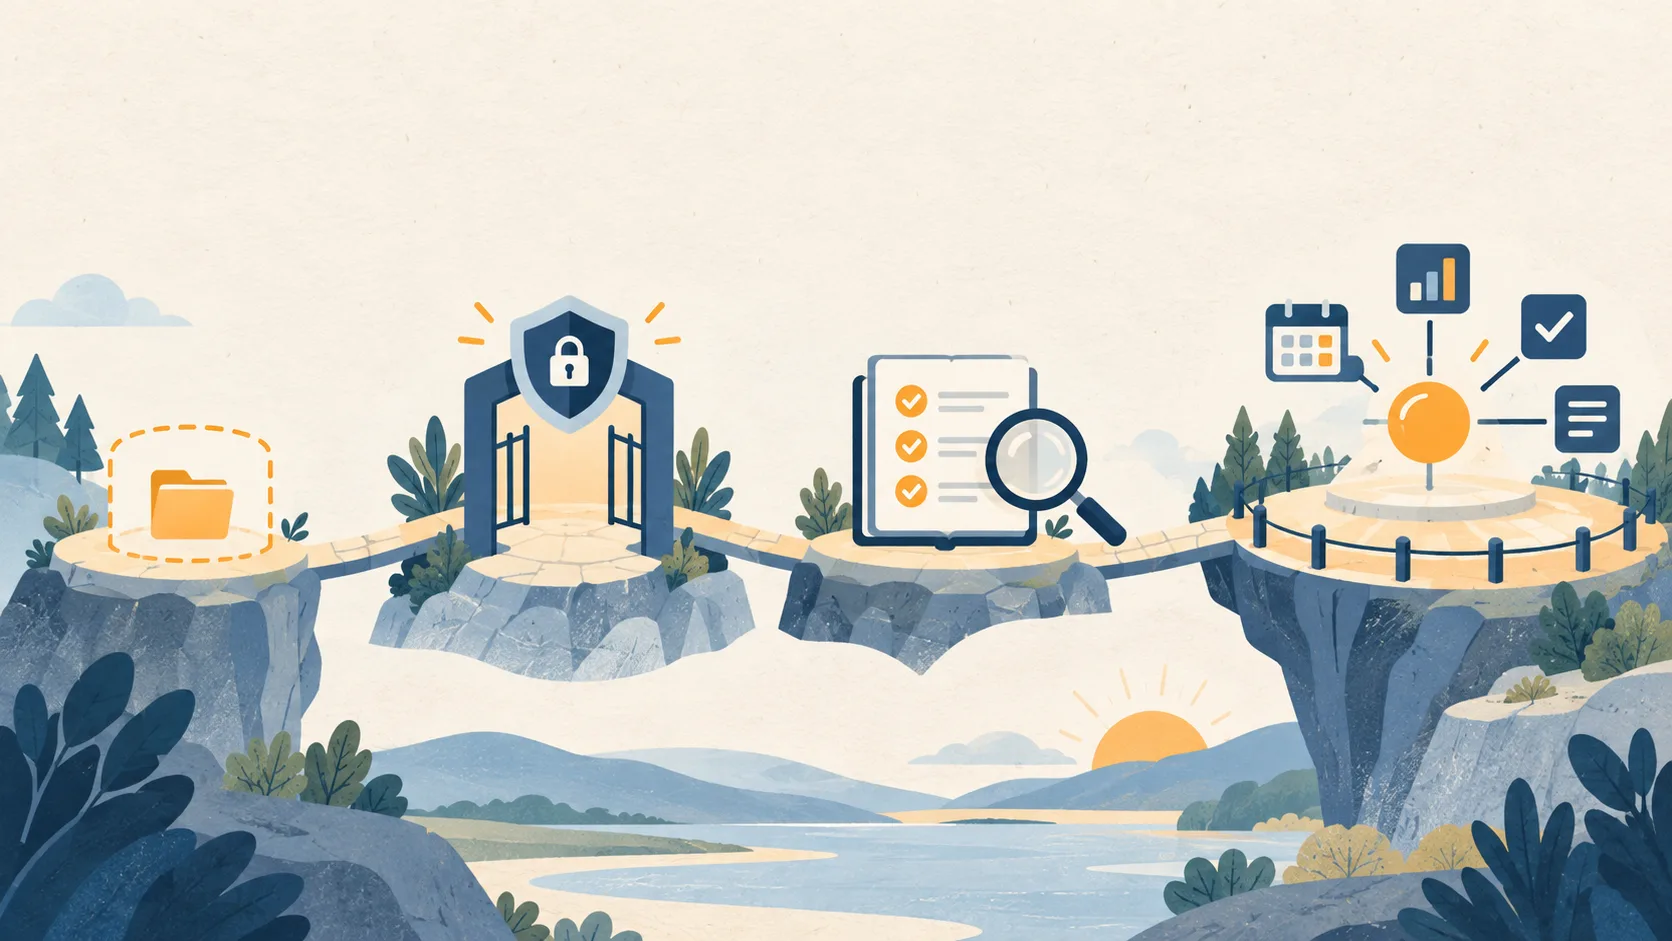
先限定数据范围和写权限,再观察工具选择与审计记录,确认稳定后才扩大自动化范围。
这份清单可以直接拿去开会。
□ 选定一个只读项目与一条具体任务
□ 明确允许读取的 Confluence 空间和 Jira 项目
□ 先关闭批量写入与高影响操作
□ 给创建和修改动作保留人工确认
□ 记录一次调用读了什么、做了什么、失败如何交接
□ 连续观察后再扩大范围
Rovo MCP v2 给团队的,不只是把更多 Atlassian 产品摆到 Agent 面前。它更像一次提醒,上下文、权限和确认点,本来就是 Agent 工作流的一部分。把它们当成接入后的补丁,往往会在真正开始自动化时付更高的返工成本。
把 Jira 接进 Agent,最有价值的第一步可能不是让它替你多建十张任务,而是让它先帮你少漏掉一件事。
如果你要在团队里先放开一条 Agent 工作流,你会选「只读风险摘要」,还是「生成待确认的 Jira 草稿」?