posts/seedrealtime-interrupt-control.md
SeedRealtime 最难的不是开口,是被打断
语音助手最尴尬的时刻,不是答错。
是你话还没说完,它先热情洋溢地讲了起来。
你打断它,它又像没听见一样继续输出。等它终于闭嘴,刚才那个问题已经换了上下文,屏幕上的画面也翻过去了。
人和人聊天时,这叫不会看气氛。
放进实时 AI 系统里,它是一整套控制问题。
字节 Seed 刚发布了原生音视频全双工模型 SeedRealtime。它把音频、视频与文本放进统一架构,持续接收多模态信息,同时判断该不该回应。官方说,在端到端人工评测里,相比级联模型,它的音视频对话节奏问题减少了一半,并已在豆包 App 全量上线。
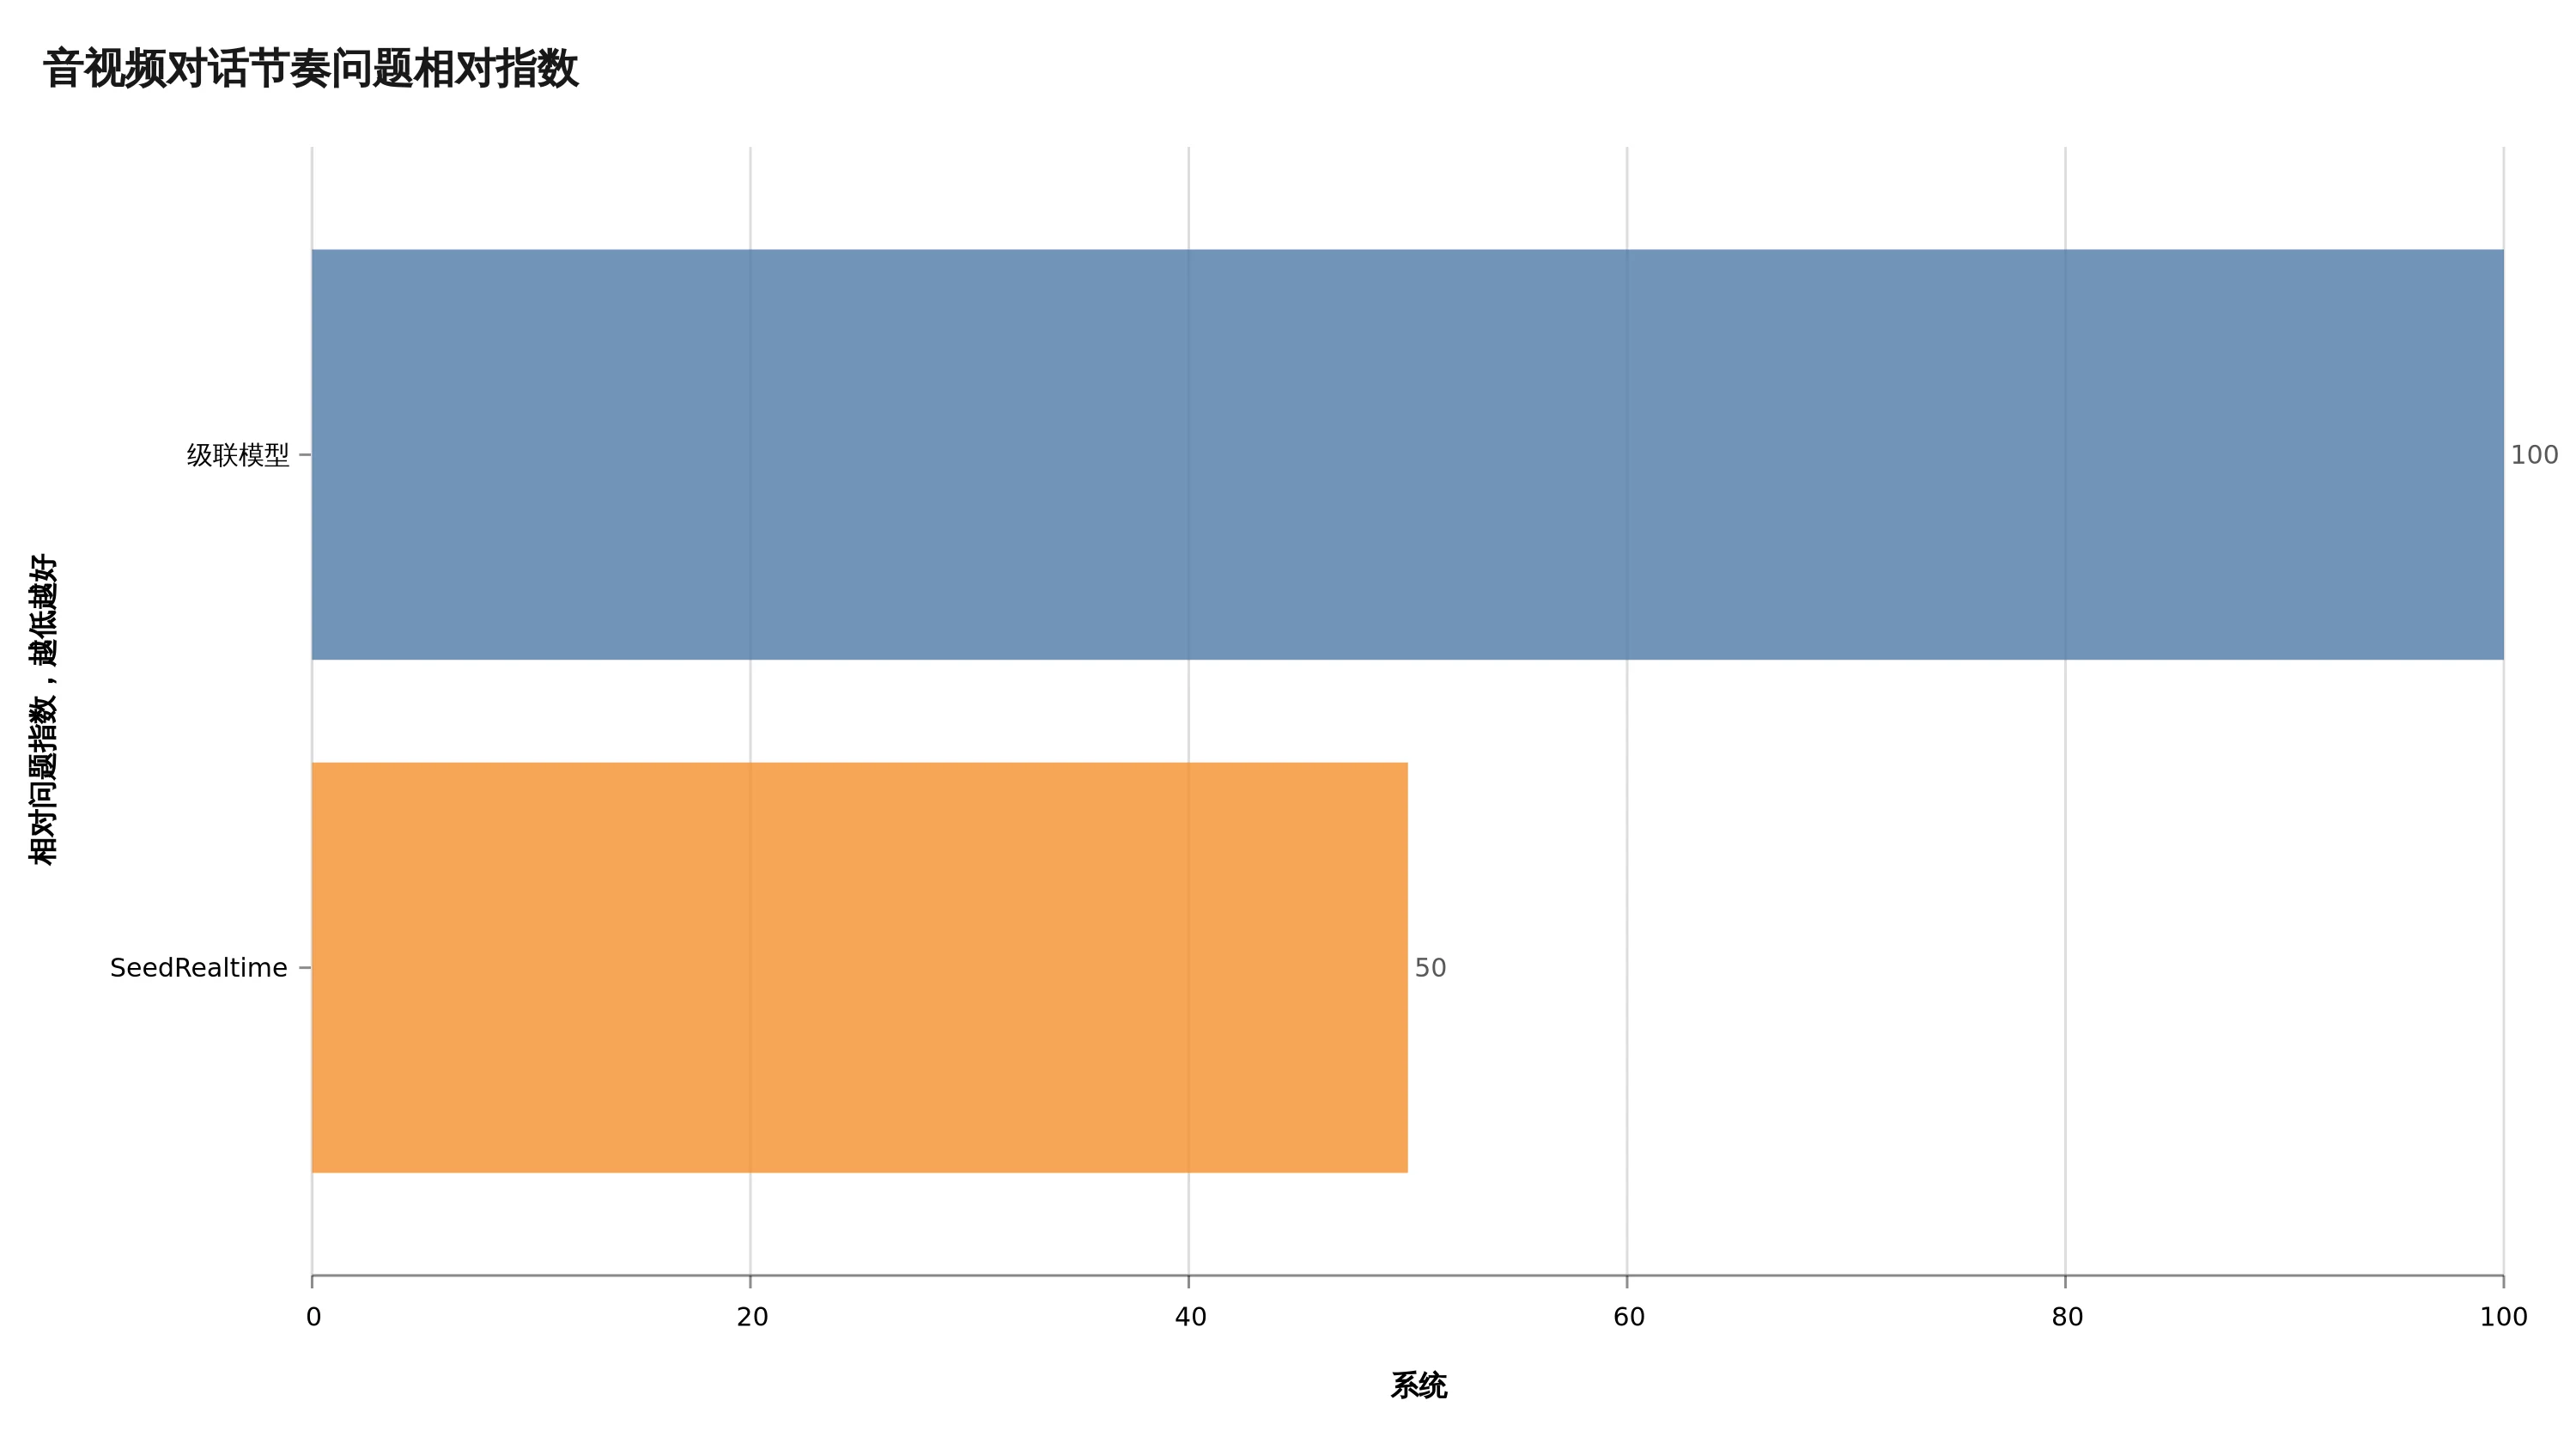
按官方「减少一半」换算成相对指数,级联模型设为 100,SeedRealtime 为 50。
好家伙,「边看、边听、边说」终于不只是实验室视频里的三件套了。
但我看完官方演示,最在意的不是它能开口。
是它能不能在正确的时刻停下来。
全双工不是同时说话,是两条流都不能停
很多人听到全双工,第一反应是模型可以一边听一边说。
这个理解没错,只是不够。
传统语音助手更像对讲机。用户说完一段,系统用 VAD,也就是语音活动检测,判断声音结束,再把音频交给 ASR 转文字。文本送进语言或视觉模型,答案出来以后,TTS 再把文字合成语音。
ASR、VLM、TTS 分别是语音识别、视觉语言模型和语音合成。它们每一段都能单独优化,也容易替换,工程上很清楚。代价是延迟会一层层叠,信息也会在转换中损耗。
更麻烦的是轮次。
外置 VAD 很擅长判断「现在有没有人在发声」,却不一定知道「这个人是不是还没说完」。停顿可能是思考,可能是换气,也可能是句子结束。旁边有人聊天,VAD 能看见声音,却不知道那句话是不是在叫模型。
半双工系统通常把世界切成一小块一小块。
你说。
它听。
它说。
你再说。
真实生活显然没这么配合。
人会补充,会抢话,会说到一半指向屏幕里的东西,会在模型回答时突然纠正前提。画面也不会因为双方在等轮次就暂停。机场大屏继续刷新,文档继续翻页,路边的人继续走动。
全双工系统面对的是两条不停流动的时间线。
输入持续进来,输出也可能正在发出。系统必须一边更新自己对场景的理解,一边决定已经开始的回答还要不要继续。SeedRealtime 把轮次判断放回模型,让它用声音、画面、历史动作和当前目标一起判断时机,这比只靠外部 VAD 多了一层语义。
也多了一大堆会翻车的状态。
真正难的,是取消已经发生一半的未来
假设用户举着手机,让 Agent 帮忙看一份论文。
模型已经开始解释当前页面。用户突然说「等一下,我问的是下面那张图」,同时手指往下滑。此刻系统不能只把新语音塞进下一轮队列。
它得立刻停止旧的音频输出,废弃还没说完的文本,取消可能正在执行的工具调用,把视觉上下文切到新页面,再根据用户的纠正重新规划。
这不是聊天界面里多放一个停止按钮那么简单。
从模型吐出 token,到语音合成,再到播放器缓冲区,旧答案可能已经排了好几段。工具调用也可能跨过了不可逆边界。查天气可以丢掉,提交订单不能因为用户插了一句话就假装没发生。
做生产 Agent 的人对这种感觉应该很熟。
请求超时了,后台任务还在跑。用户点了取消,消息已经发进队列。上游重试了一次,下游执行了两次。界面显示停止,数据库里那条任务却一路跑到终态。
语音 Agent 把同一个问题压缩到了几百毫秒里。
所以全双工系统需要的不是一个轮次变量,而是一套取消协议。
每段输入要带时间戳。每个模型输出要知道自己基于哪个视觉帧和哪段音频。每次工具调用要绑定当前任务版本。用户打断时,系统要能让旧版本失效,后续返回的结果即使成功,也不能直接污染新上下文。
这里可以借用分布式系统里的 fencing token,也就是栅栏令牌。每次用户纠正或场景切换,就让会话版本加一。旧版本的工具结果回来时,执行层发现令牌过期,只记录,不继续提交动作。
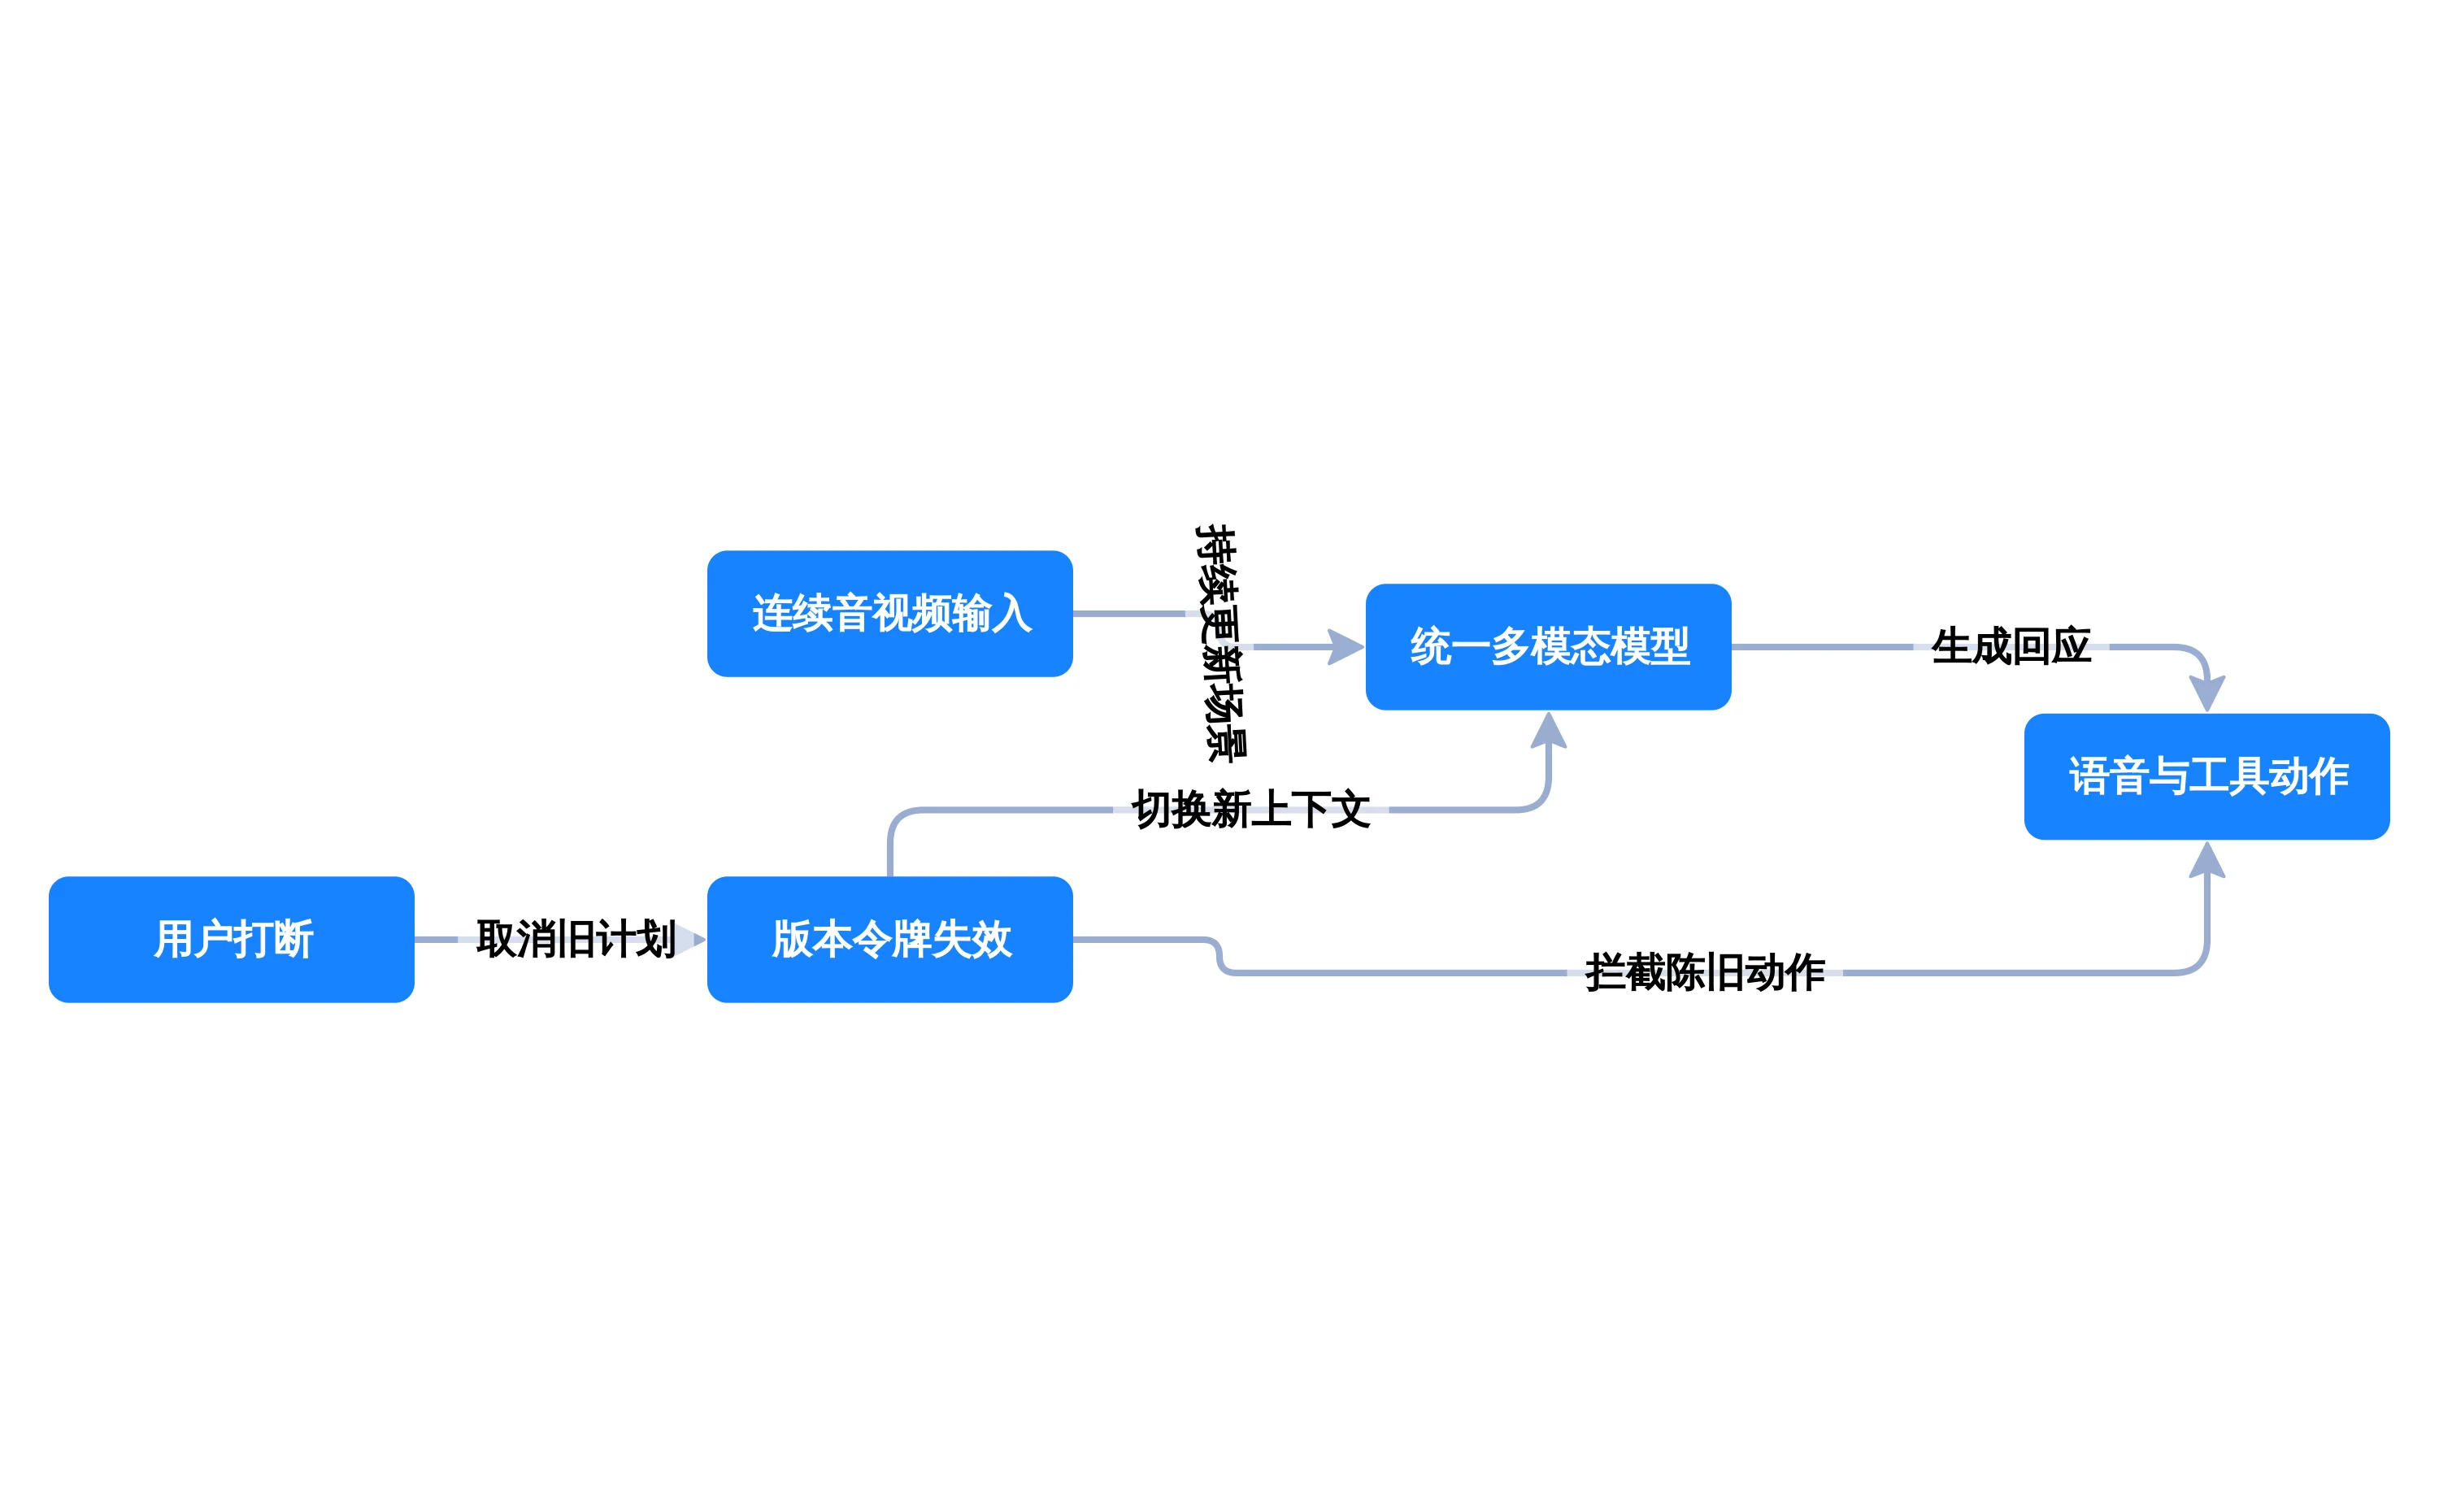
打断不只要停住声音,还要让旧上下文和陈旧工具动作一起失效。
棒棒的,一个原本听起来很像人机交互的问题,绕了一圈还是回到了并发控制。
而且仅仅取消还不够。
系统得分清哪些东西可以软取消,哪些必须补偿。语音播放可以立刻停。搜索请求可以忽略结果。已经写入日历的事件需要撤销或确认。已经发出去的消息没有撤回保证,就应该在执行前要求明确确认。
实时不是免确认的理由。
越快,越要知道哪一步之后不能回头。
模型何时沉默,比首字延迟更值得测
语音产品很爱比首字延迟,也就是用户说完后多久听见模型第一个字。
当然重要。
停两秒才回应,人会怀疑系统死了。可只盯这个指标,很容易训练出一个抢话冠军。
SeedRealtime 官方列出的节奏问题很具体。用户话没说完被抢断,话已经结束却迟迟不回应,背景杂音和旁人闲聊误触发。它们都不只是速度问题,而是时机判断问题。
官方演示里有几个场景很能说明这一点。
用户让模型盯住快速翻动的 ResNet 论文,看到「3.4 Implementation」再提醒。模型需要持续看,但在目标出现前保持沉默。
用户在机场和同伴聊天,画面扫过指示牌。模型要记住相关信息,也要分清闲聊不是每一句都在问它。
模型陪孩子学习时,旁边另一个人正在通话。系统要继续跟住孩子手指的方向,不能被背景人声抢走注意力。
这些都是官方展示,不是独立第三方实测,先别急着把宣传片当生产 SLA。不过它们给了一套很好的评测方向。
比首字延迟更该看的,是打断生效延迟。用户开口纠正后,旧音频多久真正停下。
还要看误唤醒率。旁人闲聊和环境声音里,有多少次让模型不该开口时开了口。
再看漏回应率。用户明确发问后,模型有多少次把它当背景忽略。
多人场景要测说话人归因。系统有没有把甲的偏好记到乙身上。
视觉场景要测过期帧依赖。模型回答时引用的,究竟是当前画面,还是半秒前已经翻走的页面。
工具层还要测陈旧动作率。用户打断以后,旧计划发起的动作有没有继续落地。
你想想看,一个首字延迟 300 毫秒、但每十次对话抢话两次的系统,和一个 500 毫秒、却知道什么时候闭嘴的系统,哪个更像可用产品。
答案没那么浪漫。
人类对话的自然感,很大一部分来自克制。
连续感知会把权限账重新摊开
SeedRealtime 还有一个比语音更大的变化。
它不只等用户问问题,还能持续观察,在目标出现时主动提醒。博物馆里看到指定展品就出声,翻到论文训练参数就叫停,画面出现路标时主动补充路线。
从被动回答走向主动协作,体验会突然变得很有用。
权限也会突然变得很宽。
传统助手收到一句问题,处理一段输入,返回一个答案。持续感知型 Agent 要长时间接收麦克风、摄像头和屏幕内容,还要把历史信息留在会话里,才能判断眼前变化是不是用户之前等待的目标。
它必须记住,才会显得聪明。
它记住得太多,又会让人不安。
这不是靠隐私政策里多写一段就能解决的。产品要把持续感知拆成用户能理解的权限状态。现在是否在听,是否在看,哪些内容只在本地处理,哪些片段会发往云端,保存多久,用户怎样一键清空,都应该在界面和技术实现里对得上。
主动提醒也要有预算。
系统不能因为模型觉得相关,就不断插入用户生活。可以给不同任务设置打扰等级。安全提醒立刻说,目标出现简短提示,普通建议等用户空闲,低价值信息保持沉默。
说真的,AI 行业过去太迷恋「主动」。
主动发现,主动建议,主动执行。听起来每个产品都像一位永远精力充沛的同事。
真正和这种同事工作一天,你大概只想把状态改成勿扰。
主动能力的上限由模型决定,主动频率的上限应该由用户决定。
高并发下,尾延迟会毁掉所有自然感
官方稿强调 SeedRealtime 已经在豆包 App 全量上线。规模化落地比一个精心录制的 demo 难很多。
单个会话里,音频和视频持续上传,模型持续推理,语音持续生成。成千上万会话同时运行时,系统要处理的不是一问一答请求,而是一批长连接、连续流和随时发生的打断。
平均延迟在这里很会骗人。
大部分会话 300 毫秒响应,少数会话因为排队卡到两秒,用户感受到的不是「平均很快」,而是对话对象偶尔走神。视频帧积压后,模型还可能认真回答一个已经过去的画面。
实时系统更该盯尾延迟,也就是最慢那部分请求。还要在过载时主动降级。
算力紧张时,可以降低视频采样频率,暂停非关键主动观察,缩短回答,或者把复杂工具调用切成明确的等待状态。最差的做法,是表面保持所有能力在线,实际让输入队列越积越长。
那会出现一种很荒诞的体验。
模型听见了你的每句话,只是活在三秒前。
有点子牛逼的实时 Agent,最终还是要靠很不性感的看门狗、队列上限、超时、取消传播和负载保护撑起来。模型负责理解对话,系统负责不让旧世界堵住新世界。
字节在几个月前发布的 Seed 全双工语音模型已经在处理边听边说和抗干扰,Seed 官方模型目录也一直把实时语音作为独立方向。SeedRealtime 再把视频与主动观察放进来,控制面一下从一条音频时间线扩成了多模态现场。
这条路很值得期待。
也会逼着工程团队承认,实时交互不是把模型响应做快一点。它是一套持续运行、随时可被用户改写、每个动作都可能过期的系统。
会说话,只是入场券。
知道什么时候沉默,知道被打断后怎样放下旧答案,知道哪一步必须停下来等用户确认,才像一个真正可以共事的 Agent。
海上的风一直在变。
好的舵手不是永远抢着下命令,而是听见那句「等等」时,手真的会松开。