posts/sentence-transformers-multivector.md
RAG 多向量检索,4874 段文本变成 60 万向量
4874 段文本,普通做法存 4874 个向量。
Sentence Transformers v6.0 换了一种玩法,一口气存了 608414 个。
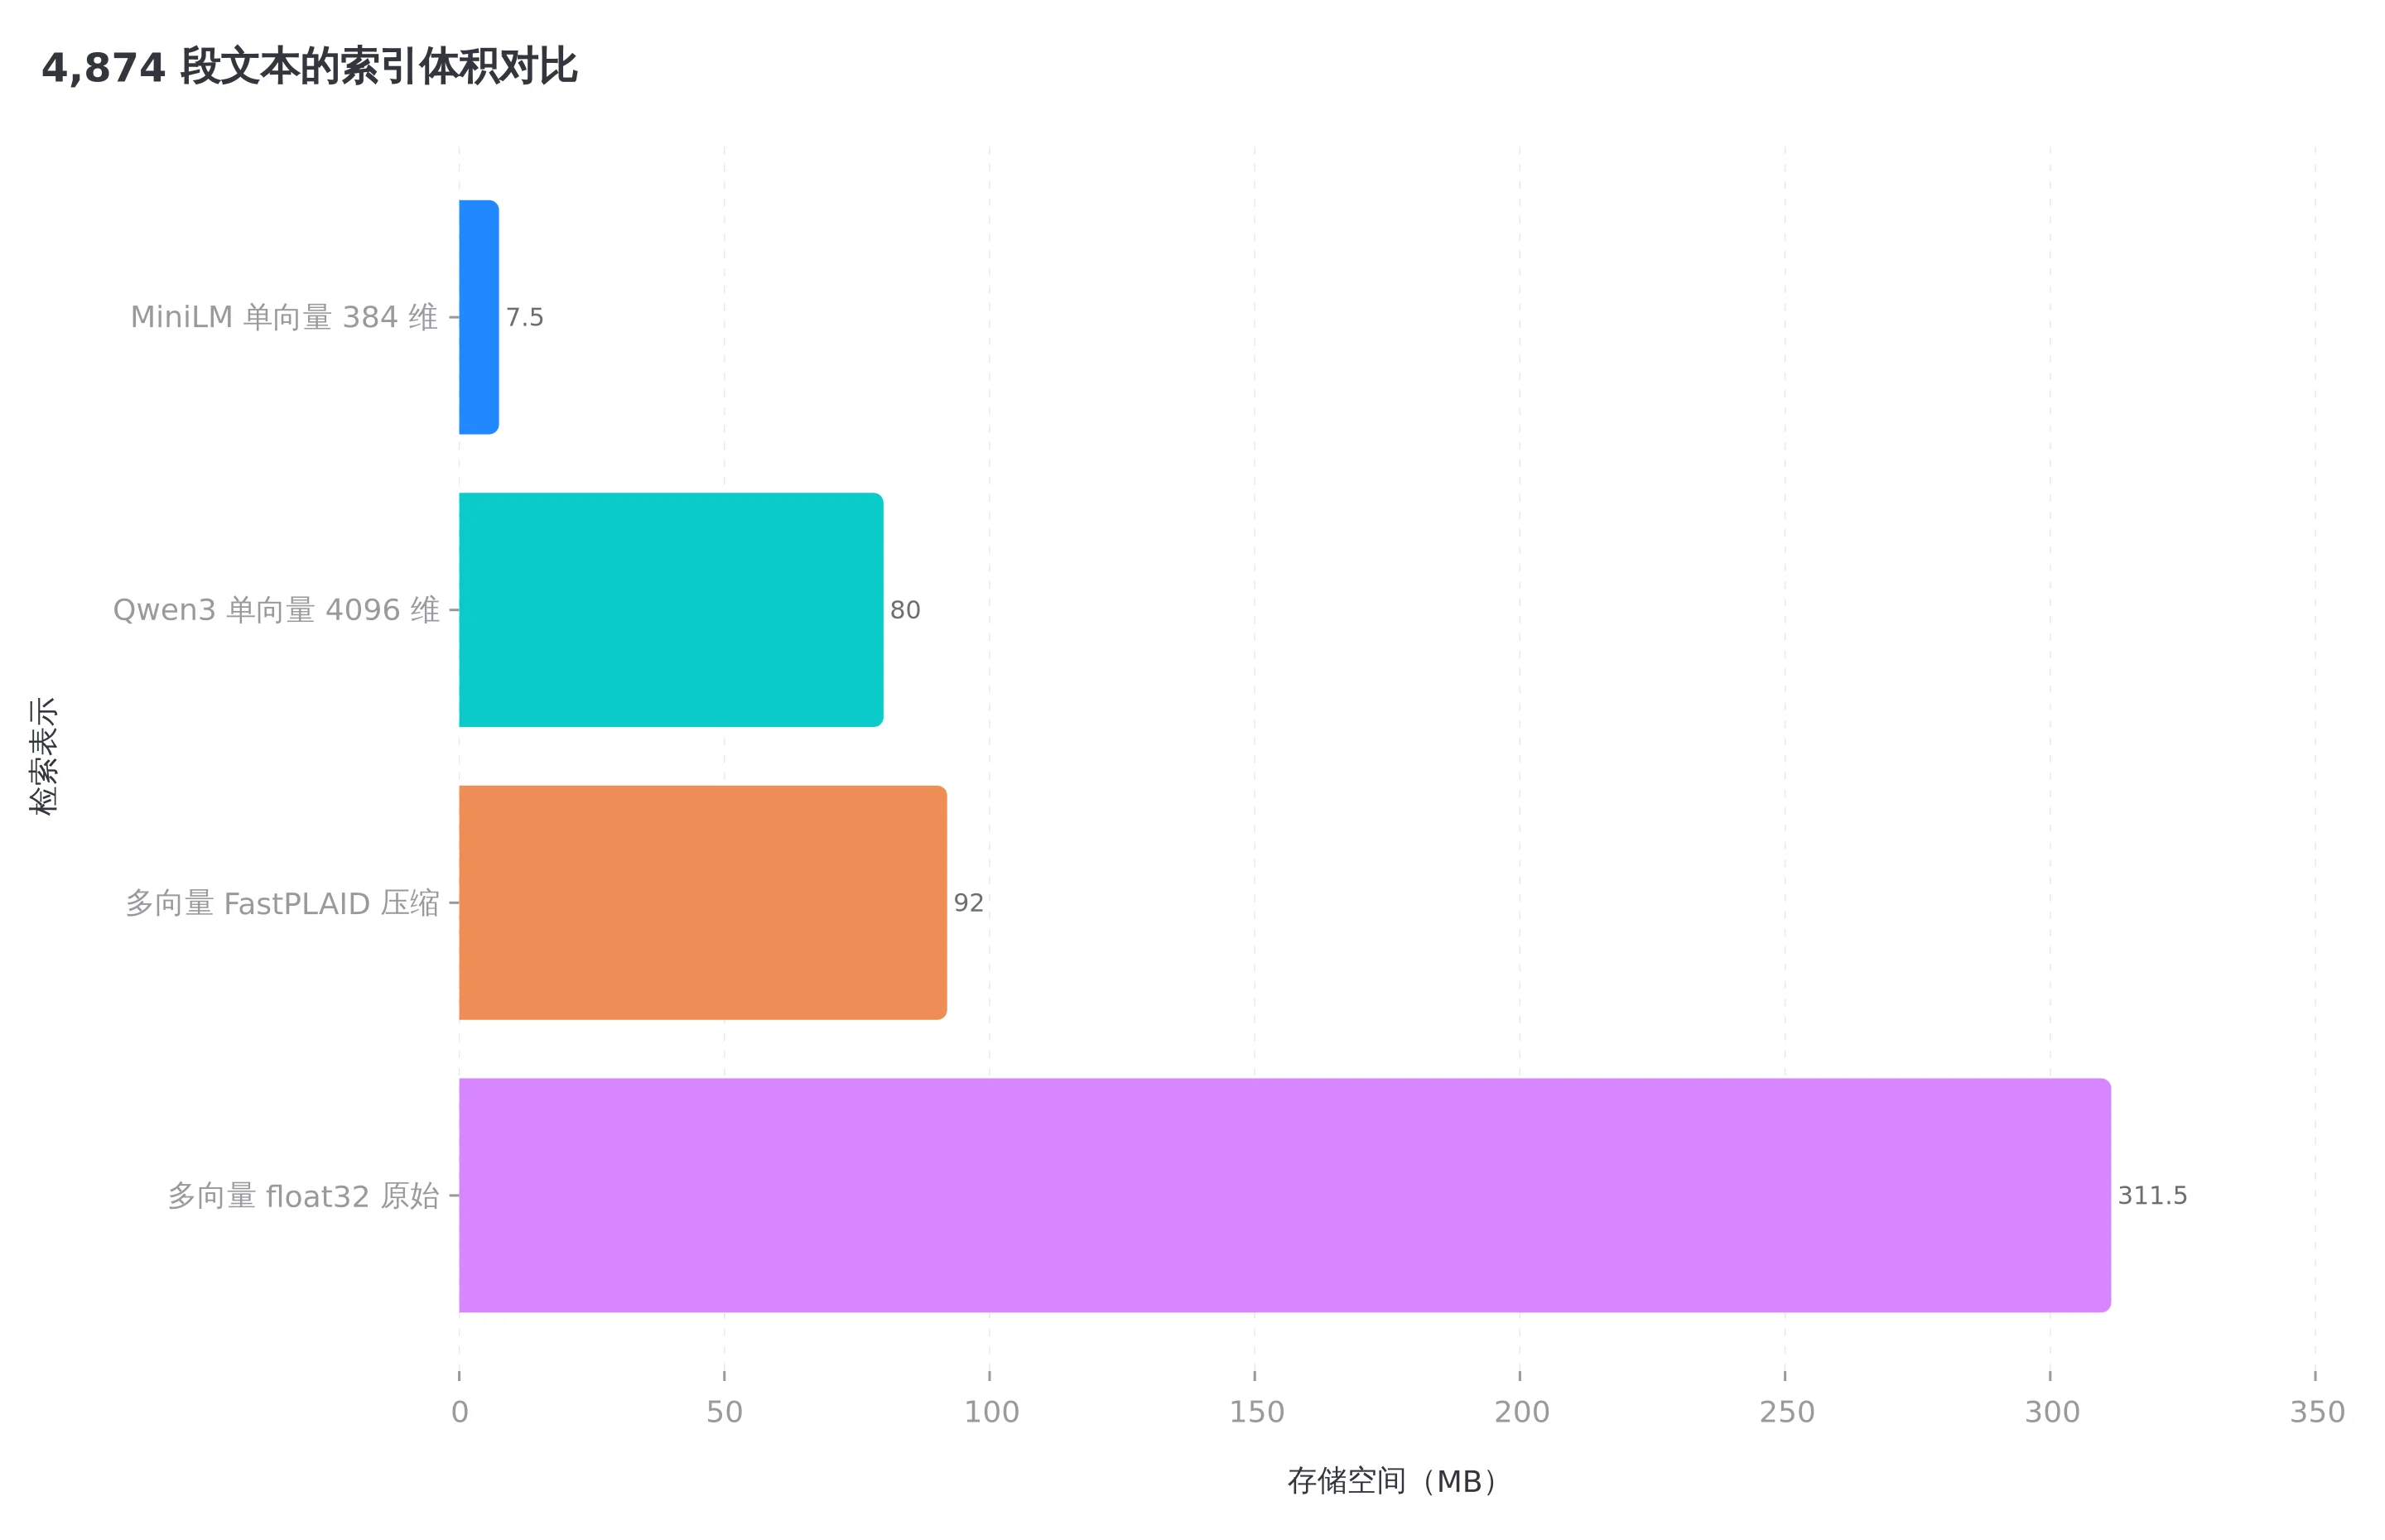
好家伙,段落没变多,向量先膨胀到 124 倍。按原始 float32 算,索引从 7.5 MB 涨到 311.5 MB,是 MiniLM 方案的 42 倍。
这次新增的 MultiVectorEncoder,做的是 ColBERT 风格的晚期交互检索。以前散落在 PyLate、Stanford ColBERT 和 ColPali 生态里的多向量模型,现在能用 Sentence Transformers 那套熟悉的接口加载、编码、训练和评测。
发布清单看着像又多了一个类。
真正值得聊的,是 RAG 那道老得掉漆的选择题,被硬塞进了第三个答案。
过去做检索,常见方案大致站在两头。一头是 dense embedding,把整段文字压成一个向量。文档离线编码一次,线上查得飞快,几百万条也能扛。另一头是 cross encoder,把查询和候选文档一起喂给模型,相关性通常更准,但每次搜索都要重新计算,只适合给少量候选做重排。
一个省,一个准。
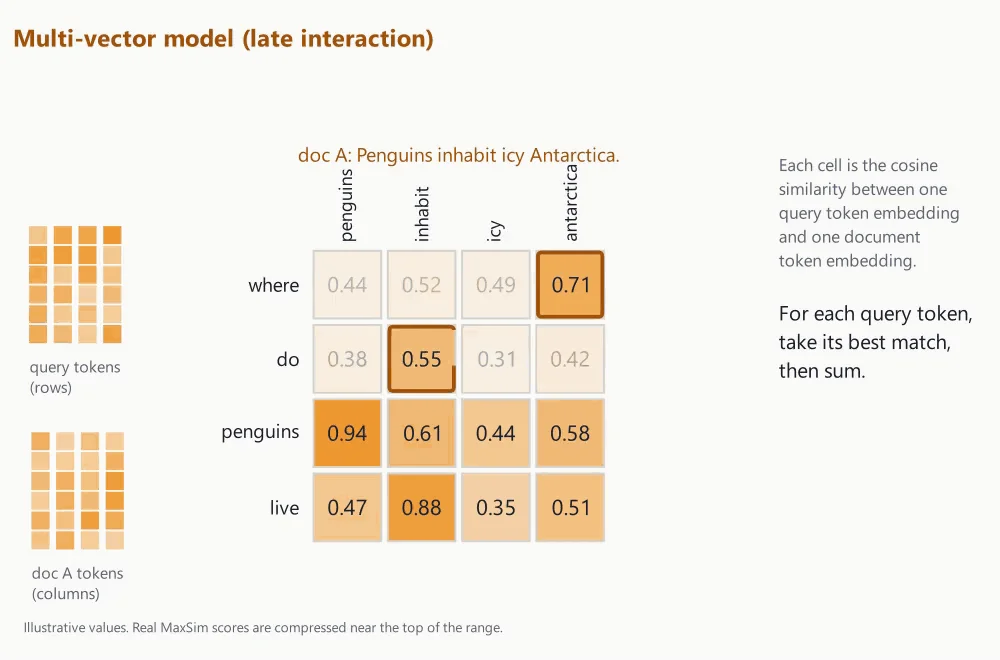
晚期交互卡在中间。文档仍然可以提前编码,但它不把整段压成一个点,而是给每个 token 留一个小向量。查询进来以后,每个查询 token 都去文档 token 里找最像自己的那个,再把这些最高分加起来。这套算法叫 MaxSim,可以把它理解成一群侦察兵各自找证据,再统一汇总,而不是全班先挤成一张模糊的合影。
这个差别对 RAG 很要命。
一段文档里可能同时有产品名、版本号、函数名、限制条件和一串例外。单向量要把它们压进 384、768 或 1024 个数字,长文越长,局部信息越容易被平均。用户搜「绿色沙发,木腿,圆靠垫」,四个条件被揉成一个点,绿色但金属腿的沙发可能也排得很靠前。
多向量不急着揉。绿色去找绿色,木腿去找木腿,圆靠垫也有自己的证据位置。官方示例里,查询 token live 和文档里的 inhabit 相似度达到 0.94,既能抓同义表达,又不会把产品代码、姓氏、函数名这种精确词彻底稀释。
这一手有点子牛逼。
但请先别把生产向量库推倒重建。多向量拿回来的信息,不是从空气里白嫖的。
官方那组 4874 段文本的测试很诚实。MiniLM 每段一个 384 维向量,占 7.5 MB。LateOn 每个 token 一个 128 维向量,一共得到 608414 个,占 311.5 MB。向量维度小了,数量却爆了。
用 fast-plaid 压缩以后,这批索引能降到 92 MB。这个数字没那么吓人了。同一批文本如果用 4096 维的 Qwen3-Embedding-8B,单向量索引大约也要 80 MB。
厉害了,42 倍的原始差距,经过专用索引压缩,收回到和大型稠密向量差不多的区间。
可工程账不能只看最终磁盘占用。你还多了一套 token 级索引格式、压缩参数、查询算子、更新流程、备份策略和冷启动时间。原来的向量库也许一个 HNSW 索引就能解决,现在可能要接 PLAID,或者把 token 矩阵交给另一个专用后端。
更麻烦的是增量更新。单向量文档改一段,重算一个向量。多向量文档改一段,token 数和矩阵形状都可能变化,压缩索引里的 posting 也要跟着动。上线文档里最安静的那行代码,往往会在半夜告警时突然开始唱歌。
所以我自己的判断挺明确,多向量检索不该成为 RAG 的新默认项。
它应该是一把专门处理「压缩损失」的刀。
怎么知道自己是不是这个问题?别靠看官方榜单,先翻失败样本。
如果检索错的内容,经常是长文里的一条局部条款、多个条件的组合、精确实体、函数名、型号或者表格附近的一小块证据,多向量值得试。要是错误主要来自切块粗暴、元数据过滤漏掉、权限条件没进查询、文档版本过期,换成 60 万个向量只会让错误更贵。
很多团队会跳过这一步。召回不准,先换 embedding。还不准,再加 reranker。仍然不准,就调 top-k。参数越来越多,问题还是那份脏文档和一条没进过滤器的租户 ID。
棒棒的,愣是得到一套更复杂的错误复现系统。
更稳的试法,是先别建全量多向量索引。保留现有 dense 或 sparse 召回,取前 20 到 100 个候选,再用 MultiVectorEncoder 对候选做 MaxSim 重排。官方就给了 retrieve and rerank 的示例,这条路会重复编码候选文档,候选多时延迟不便宜,但它能让你用很小的改动验证一件最关键的事。
token 级交互,到底能不能救回自己的失败查询。
别只跑通 demo。至少准备一批真实查询,给每条标出必须命中的文档与不能混进来的干扰项。然后同时记录 Recall@k、NDCG@10、端到端回答正确率、P95 延迟、每次查询成本和索引体积。
这里有个很容易被忽略的坑,document_length 会直接截断内容。
官方文章里,一段 662 token 的文本经过 LateOn 的 300 token 上限,只留下 273 个 token 向量。后面的内容不是分数低,而是压根没进索引。你可以把单次调用提到 512,但这会让模型跑出训练时的长度范围,索引也会近似跟着变大。
多向量号称更适合长文,如果长文先被配置项砍掉一半,场面会很幽默。
长文恰好也是它最有可能拉开差距的地方。在 MLDR 长文检索结果 里,mLateOn 得分 77.92,同骨干的 mDenseOn 是 51.59。这不是可以直接搬进自己周报的胜利数字,因为数据分布不同,但它给了一个很实用的检查方向。短 FAQ 上没差距,不代表合同、论文、故障手册和代码文档也没差距。
官方自己的 NanoBEIR 测试更能让人冷静。
LateOn 和 DenseOn 使用相同 ModernBERT 骨干、相同训练数据、相同 149M 参数,只差要不要把 token 池化成一个文档向量。13 个小型数据集上,LateOn 赢了 9 个,平均 NDCG@10 是 0.6868,DenseOn 是 0.6764。
大约一个 NDCG 点。
不是 20%,不是全面碾压。ArguAna、FiQA2018、SCIDOCS 和 SciFact 四个数据集上,单向量反而赢了。完整 15 数据集 BEIR 里,两者是 57.22 对 56.20。
这个结果我很喜欢。它没有给你一张「旧方案可以扔了」的营销海报,而是把收益和账单一起放桌上。某些查询会因为 token 级证据明显变准,某些不会。工程团队要做的不是追新,而是确认自己的错误分布属于哪一边。
如果重排实验确实有效,再看两条成本收缩路径。
一条是 token pooling,把相似 token 向量合并,减少索引数量。另一条是 PLAID 一类专用索引,用 centroid 加量化 residual 代替完整 float32。Sentence Transformers v6.0 也给了 token pooling 示例,但压缩率别单独看,要和召回损失放在同一张表里。
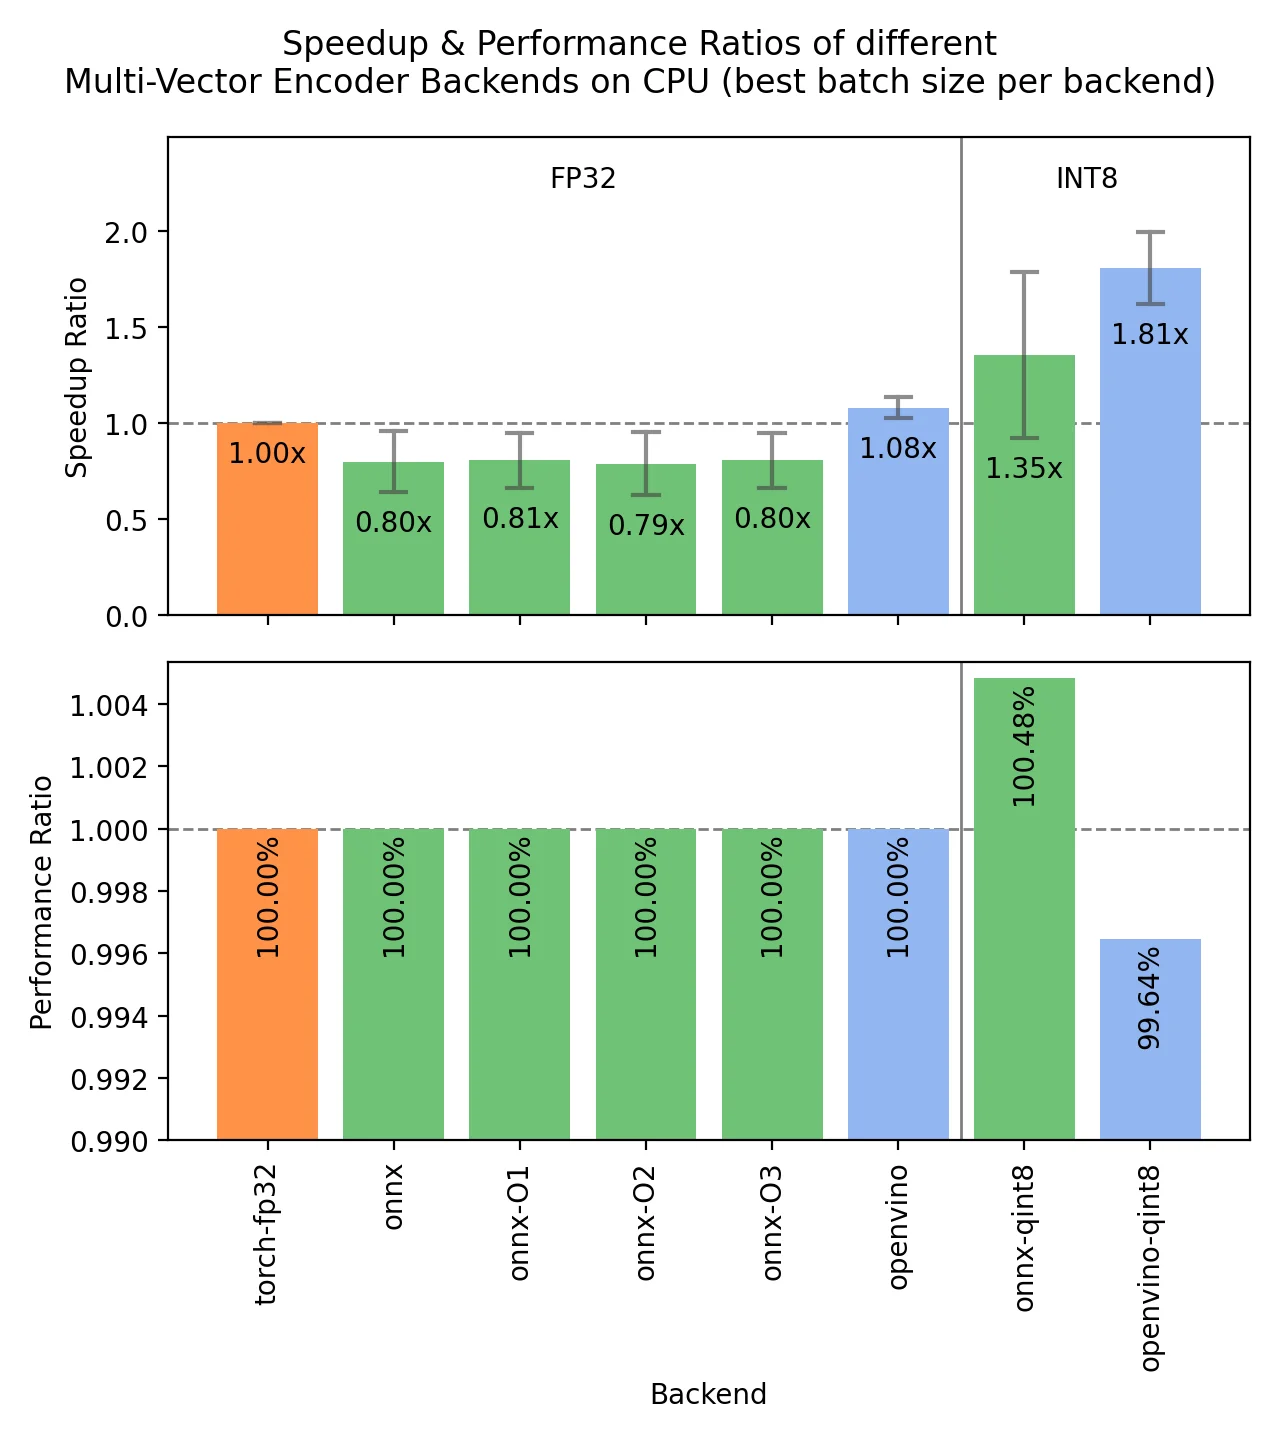
CPU 部署也不是只能认命。官方基准里 OpenVINO int8 最快达到 1.81 倍加速,性能比约 99.64%。另一组 ONNX int8 跑到 1.35 倍,性能比约 100.48%。这些数字来自固定测试环境,不该直接当生产承诺,但足够提醒我们,把后端和量化策略也放进同一轮验收。
还有一块挺有意思,多向量已经不只检索文字。
ColPali 风格模型把一整页 PDF 图片直接编码成 token 向量,查询文字可以对齐图表、表格和页面布局,不必先走 OCR。你问「水资源和电力花了多少钱」,热力图能落到预算页对应的柱子上。这个场景里,单向量把整页压成一个点的损失更明显,多向量的价值也更直观。
同一套接口还能处理音频和视频。听着很爽,不过页面图像产生的向量通常更多,存储账单也更快追上来。怎么说呢,信息保得越完整,基础设施就越难假装自己不存在。
迁移还有一个现实边界。MultiVectorEncoder 吸收了 PyLate 的建模、推理、训练和评测接口,但没有替你把生产索引也打包带走。迁移表里写得很明白,PyLate 的 PLAID 索引没有直接等价物,仍要保留,或者自己接 官方列出的索引方案。保存格式也是单向兼容,老检查点能加载进来,新格式保存后未必能回到原库。
这种细节才决定一个新接口是周五下午可以试,还是周五下午绝对不要碰。
我给这次更新的结论很简单。Sentence Transformers v6.0 把晚期交互从小圈子的定制零件,推进成了主流检索工具箱里的标准件。这很重要,因为试验门槛真的降了,你不必先拼三套库才能判断多向量是否适合自己。
但标准件不等于默认件。
先拿 50 条最疼的真实失败查询,保留旧召回,加一层多向量重排。它能稳定救回局部证据,再谈全量索引、token pooling 和 PLAID。救不回来,就关掉分支,别为一个漂亮的新类名养第二套基础设施。
开头那 60 万个向量不是坏消息。
它只是把一件事写得特别大,模型少压缩一点信息,工程就得多承担一点重量。海上的货没有消失,只是从船舱挪到了甲板。你得先确认,那批货真的值得带。