posts/sglang-weight-cache-daemon-fast-recovery.md
SGLang 重启快了 785 倍,真正的账在故障域
495 秒,压到 0.63 秒。
不是生成速度,不是又换了一块更贵的卡,而是一个大模型服务崩掉之后,重新把权重装进引擎的时间。
SGLang 团队刚发布了 Weight Cache Daemon,中文可以叫权重缓存守护进程。在 Ling-2.6-1T FP8 上,它把权重加载提速约 785 倍,端到端启动从 8.8 分钟降到 0.528 分钟,约 31.7 秒。
好家伙,重启终于不用等一首歌放完了。
很多报道大概会停在这里。785 倍,亚秒级,零拷贝,标题已经够用了。但我顺着官方文章和实现代码继续翻,越看越觉得,速度反而是这次改动里最容易理解的部分。
真正麻烦的是另一件事。
当权重不再跟着引擎进程一起生一起死,而是交给一个常驻进程保管,重启问题就从磁盘 I/O 变成了状态管理。谁能复用这份权重,版本不一致怎么办,守护进程挂了会发生什么,同卡主备究竟能防哪类故障,这些才是生产环境要付的账。
先看那 495 秒花在哪
大模型冷启动慢,常被一句「权重太大」带过。SGLang 这次把账拆得很细。
Ling-2.6-1T FP8 跑在 8 块 H20-3e 上,权重放在 3.5T NVMe SSD。一次完整启动约 527 秒,其中 tokenizer 初始化约 13 秒,分布式环境初始化约 5 秒,CUDA Graph 捕获约 7.7 秒,HTTP 服务与预热约 4 秒。
从磁盘加载权重用了约 495 秒,占 93.9%。
每个 TP rank 要读约 120GB safetensors,接着做反序列化、张量并行切分、FP8 量化和权重重排。进程崩一次,这套确定性工作就从头再来一遍。磁盘里那 161 个分片没有变,GPU 架构没有变,量化配置也没有变,系统还是老老实实再搬一遍。
这画面很像服务进程每次重启,都要把机房里的整套书架拆掉,搬出门,再一箱箱搬回来。书没换,房间没换,只因为管理员换班了。
Weight Cache Daemon 干的事很直接。让另一个进程一直待在 GPU 上,替引擎保管已经完成切分和量化的权重。新引擎启动时不去磁盘搬书,而是拿到这批显存的地址。
这里靠的是 CUDA IPC,也就是 CUDA 的跨进程通信能力。守护进程把 GPU 内存导出为 IPC handle,新引擎打开 handle,在自己的地址空间里拿到设备指针。两个进程看到的是不同指针,背后引用的却是同一份物理显存。
没有从 GPU 再复制一份,也没有重新量化。
新引擎甚至先在 meta device 上把模型骨架搭起来。meta device 只记张量形状和类型,不真的分配 CPU 或 GPU 内存。随后,IPC loader 把每个 param.data 指向映射进来的权重。像是先把书架标签贴好,再让每个格子直接指向仓库里已有的书。
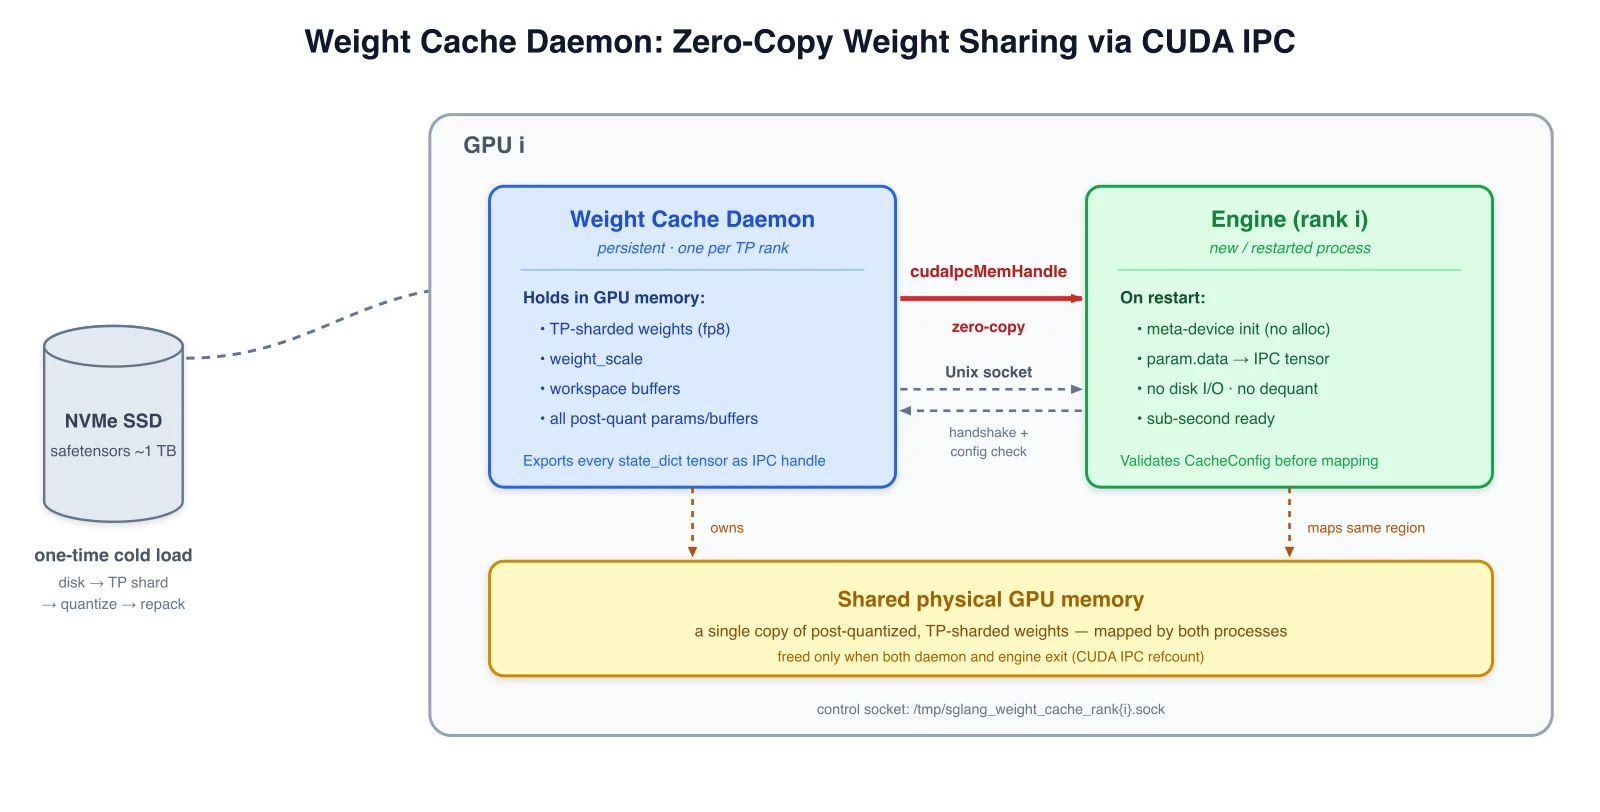
守护进程持有后量化权重,新引擎只做零拷贝映射。图源 SGLang 官方博客。
这一下确实有点子牛逼。
但缓存权重只解决了「能不能快」。生产系统还得回答「拿到的是不是那一份」。
快的前提,是敢在不一致时停下来
假设旧引擎跑的是某个模型 revision,新引擎改了 revision,却复用了旧权重。进程可以正常启动,tensor shape 甚至完全对得上,输出却已经不是你以为的那个版本。
这种错比直接崩溃更难处理。崩溃至少会报警,静悄悄返回错误数值才让人头疼。
所以 SGLang 没把缓存判断写成一个简单的文件名比较,而是做了一份 CacheConfig 配置指纹。实现放在 weight_cache/protocol.py。模型路径、架构、revision、TP 和 PP 的 rank、DP 与 EP 策略、量化方法、量化配置哈希、dtype,全都要对上。
它连 GPU compute capability 和 PyTorch 版本也盖进了环境戳。
这个细节很值钱。不同 GPU 架构或不同 PyTorch 版本,可能走进不同的 kernel 与后处理分支。IPC 映射本身仍能成功,权重也像模像样地待在显存里,可它跑出来的数值可能已经坏了。把环境写进指纹,相当于把「服务垃圾结果」提前改成「拒绝连接」。
我一直觉得,基础设施里最靠谱的功能不是永远成功,而是知道自己什么时候不该成功。
量化支持也用了同样的态度。CUDA IPC 能共享 raw tensor,却不懂 Python 侧元数据。如果一种量化方式会额外写 metadata,或者对权重做转置和特殊重排,只映射 tensor 可能得到一份外观正常、数值错误的模型。
当前官方确认的是未量化权重和 block-wise FP8。per-tensor FP8、Marlin、AWQ、GPTQ 这些还没进安全白名单,直接硬报错。没有一句「理论上应该也行」,更没有悄悄回退后假装功能正常。
棒棒的。
看着保守,实际是在替值班的人省命。
守护进程挂了,谁跟着倒
权重从引擎进程搬到 daemon 里之后,第一反应通常是,单点故障不是更大了吗?
答案有点绕,也很工程。
已经运行的引擎不会因为 daemon 退出就马上死掉。引擎已经持有 IPC 映射后的 tensor 引用,CUDA 引用计数会让那份显存继续存在,直到 daemon 和引擎都退出。daemon 恢复后,再从磁盘加载一次并导出新的 handle,后续引擎就能重新连接。
可新引擎能不能自动回退到磁盘加载,要看模式。
SGLang 现在有 daemon、client 和 off 三种路径。daemon 模式由引擎拉起守护进程,适合第一次启动和生命周期托管。client 模式连接已经存在的守护进程,是快速重启路径。off 就是原来的磁盘加载。
第一次启动不会被魔法缩短。daemon 仍得把权重从磁盘搬进显存。0.63 秒说的是守护进程已经就绪之后,新引擎映射权重的时间。
更关键的是,在 daemon 模式里,连接失败不能随便回退。因为 daemon 已经在同一块 GPU 上留了一份权重,引擎再从磁盘加载一份,很可能直接 OOM。于是这里选择报错。
client 模式也没有把所有失败都吞掉。按当前 loader 实现,只有 Unix socket 根本不存在时才允许磁盘回退。socket 在但连接被拒绝,配置指纹不一致,协议或传输报错,都会硬失败。
为什么这么绝?
因为「daemon 没部署」和「daemon 部署了但坏了」是两种完全不同的运维事实。前者可以走慢路,后者必须叫人来看。把后者也回退成磁盘加载,监控面板上只会出现一条启动变慢,真正的 IPC 故障反而被藏住了。
厉害了,这已经不是缓存策略,而是一份很明确的故障合同。
同卡主备很省,但别把它当跨卡容灾
官方给了三个生产场景,多实例共享、高低优先级任务共卡,以及 active-standby 主备切换。
多实例共享很好理解。一块 GPU 上只保留一份权重,几个独立引擎都映射它。低优先级批处理被驱逐后,也能很快重新拉起。以前为了省几分钟加载时间不敢动的实例,现在可以更灵活地让路。
主备切换最容易被标题带偏。
备用引擎和主引擎共享同一份物理显存,主进程挂掉时,备用进程确实可以在 1 秒内接管。你不必为一个闲置副本再准备完整权重,显存账轻了很多。
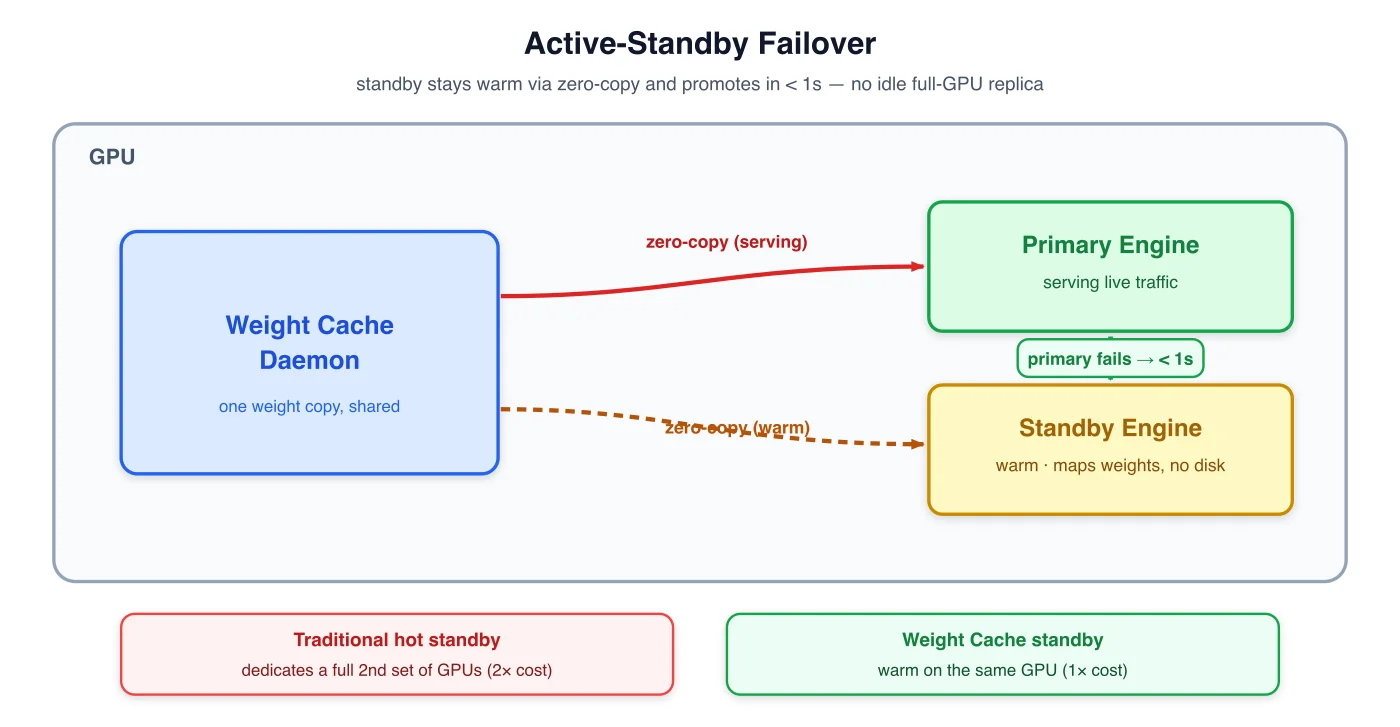
同卡主备省掉重复权重,却也共享同一个设备故障域。图源 SGLang 官方博客。
但它防的是进程级故障,不是 GPU 级故障。
同一块卡掉线,显存 ECC 出问题,驱动重置,整机失联,主备会一起消失。权重共享把恢复做快了,也把两个实例放进了更近的故障域。它很适合处理进程崩溃、滚动重启和服务切换,不能替代跨 GPU、跨节点甚至跨可用区的容灾。
这不是方案缺陷,是边界。怕的是团队只记住「不用多买一套 GPU」,没记住后半句。
如果真要上线,我会把故障分成两层。进程级故障走同卡热备,目标是秒级接管。设备和节点级故障仍保留跨卡或跨节点副本,目标是保住服务。两层恢复解决的是不同问题,别让一张 785 倍的图把它们揉成一件事。
还有一个容易漏的点,缓存配置的身份边界。
公开路线图 issue 已经有人指出,同一台 8 卡机器上跑两套 tp=4,当前 /tmp/sglang_weight_cache_rank{global_rank}.sock 命名可能发生碰撞。这个问题记录在 路线图 issue #33522。当 daemon 从单个服务的附属进程变成节点级公共资源,socket 命名、权限、租户隔离、观测指标和清理策略,全都会从小细节变成事故入口。
缓存共享得越广,身份校验就越不能含糊。
0.63 秒不是完整启动时间
另一个需要降温的数字,是亚秒级重启。
官方实测里,权重加载确实从约 495 秒降到约 0.63 秒。可端到端启动是从约 527 秒降到 31.7 秒,不是 0.63 秒。Tokenizer、分布式初始化、CUDA Graph 捕获、kernel 预热和服务就绪还在排队。
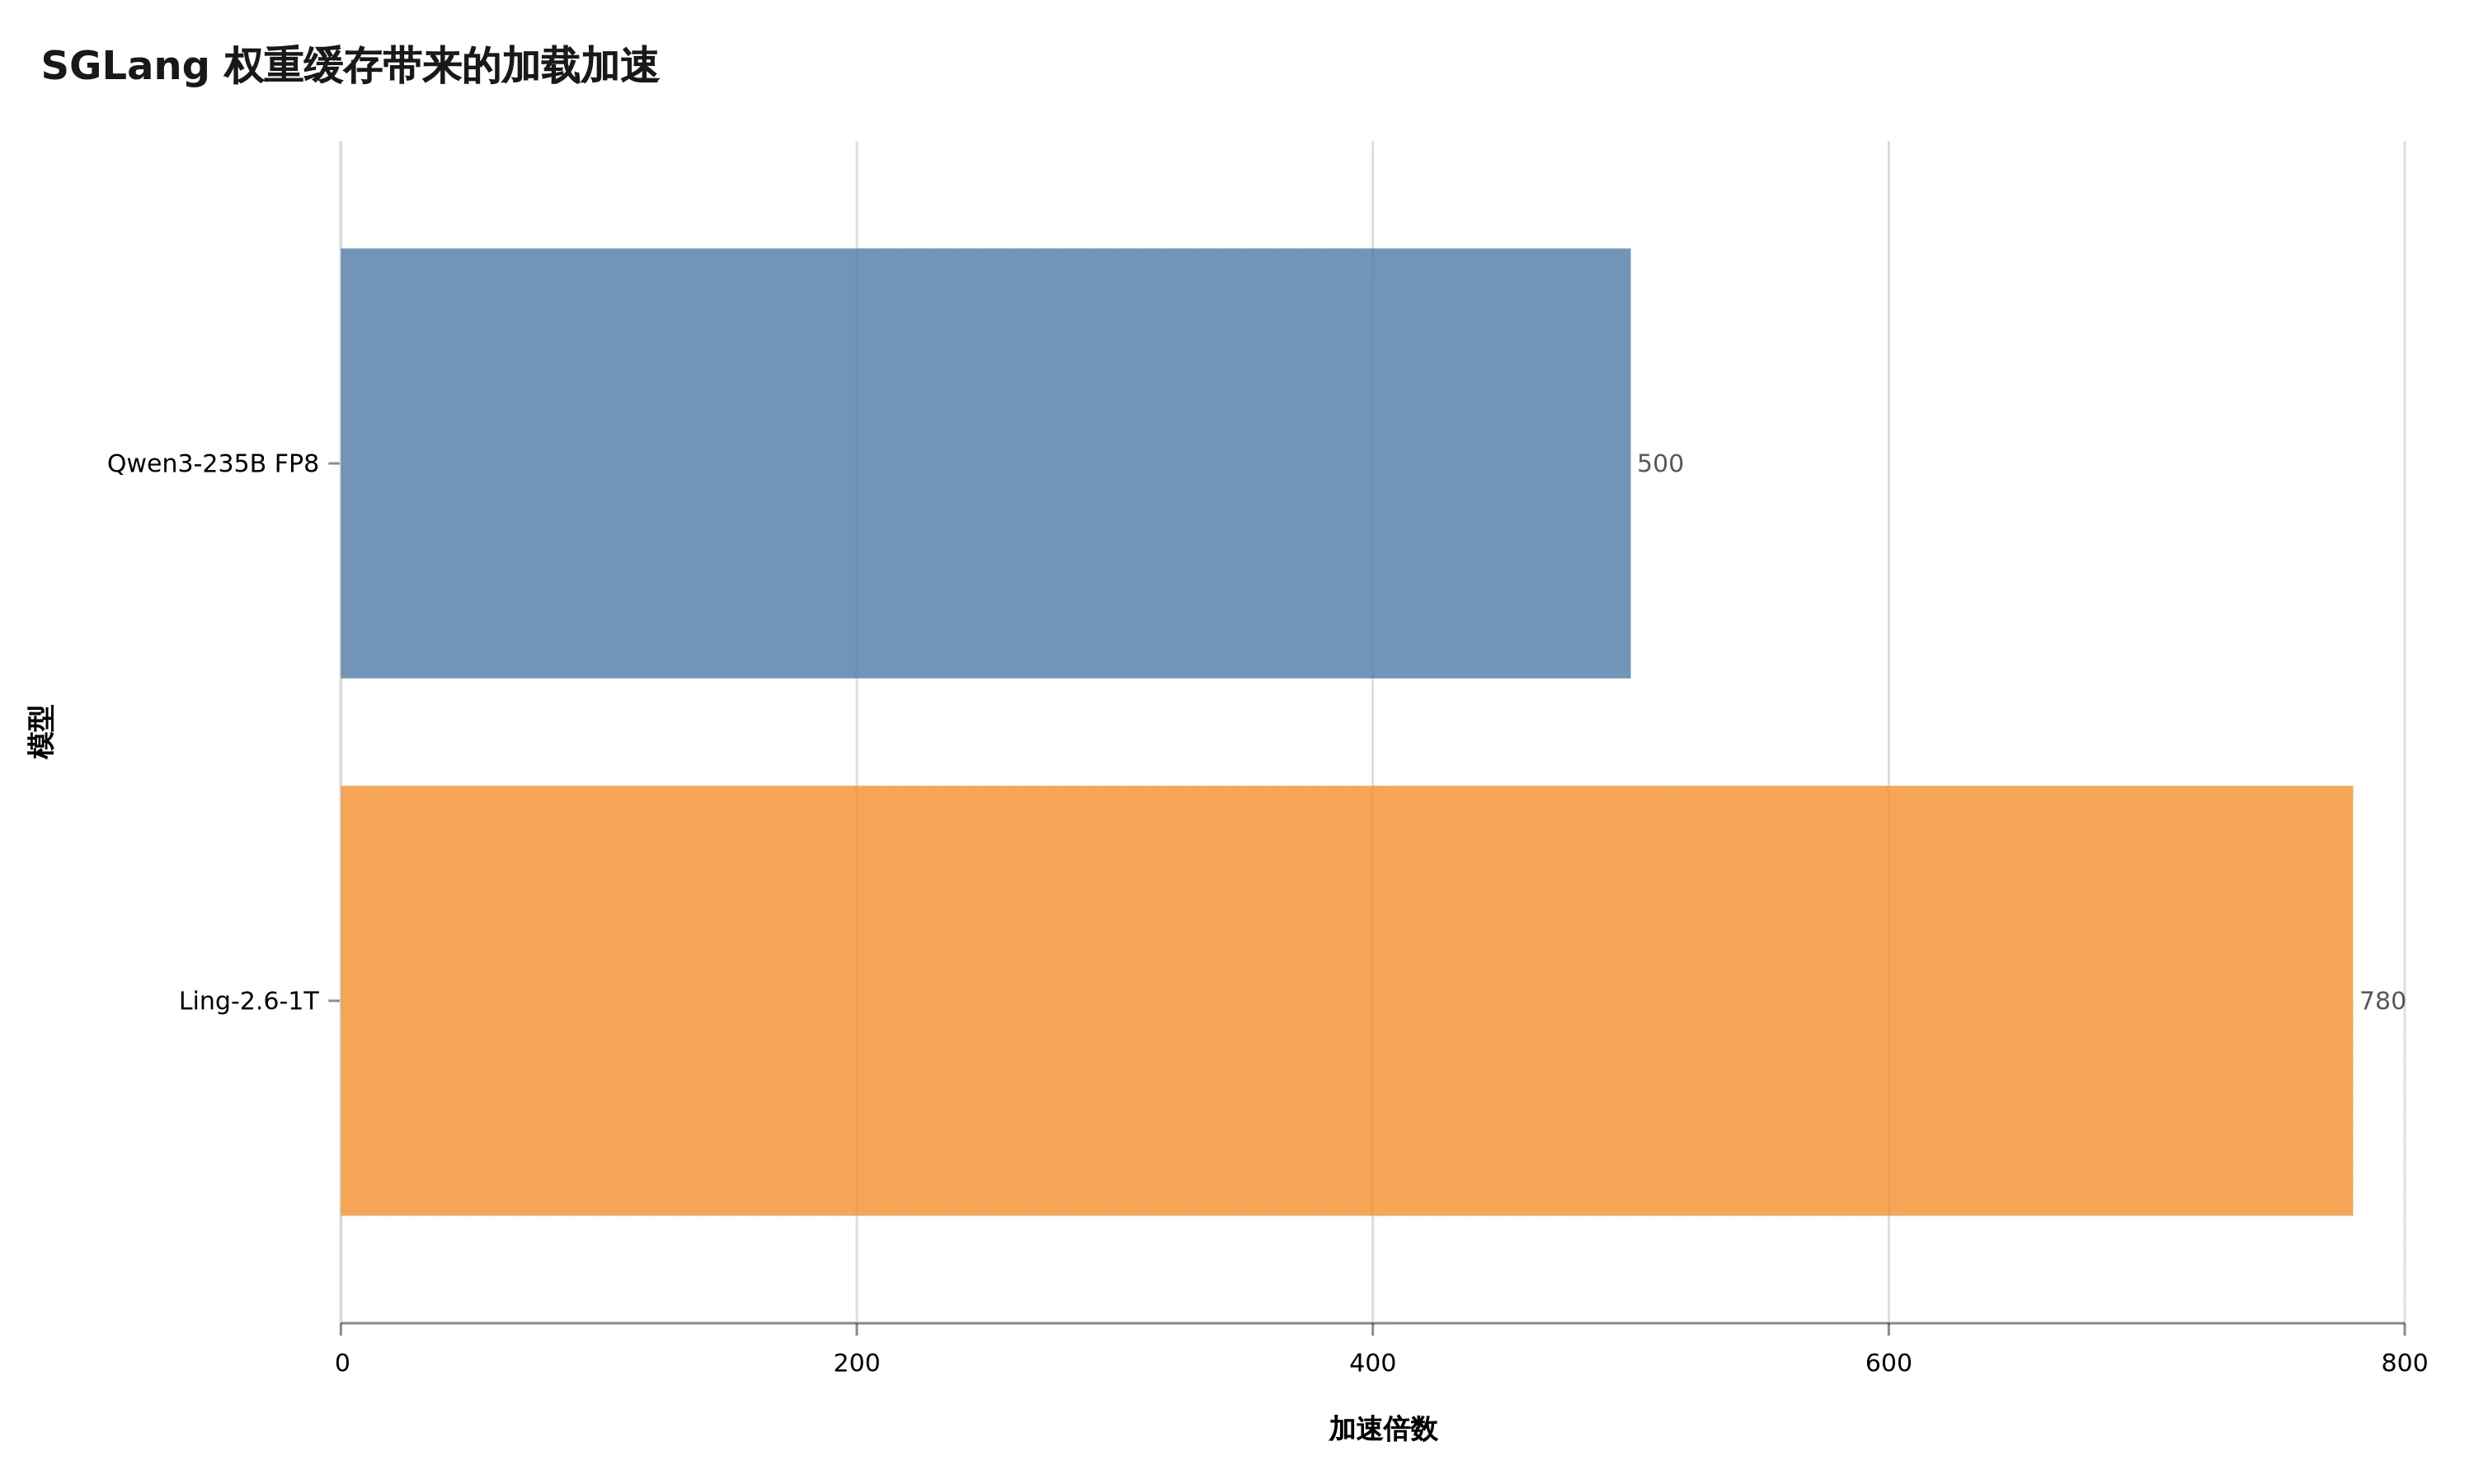
官方数据里的约 500 倍与约 780 倍,衡量的是权重加载阶段,不是完整服务启动。
SGLang 把它叫 Fast Engine Recovery Framework 的第一阶段,很诚实。后面的计划包括 CUDA Graph 序列化与回放、DeepGEMM kernel cache 持久化、延迟初始化 tokenizer、复用 NCCL 会话、KV Cache 恢复,以及跳过重启预热请求。单机冷重启的总目标是 10 秒以内,目前还没到。
甚至 KV Cache 也没有跟着权重一起活下来。正在生成的上下文仍可能需要重算。权重恢复和请求恢复,是两套问题。
所以验收这项能力时,别只跑一个 time 看 server 进程起来多快。至少要看四段时间,daemon 首次加载多久,client 映射多久,端口开始接请求多久,第一条真实请求完成多久。再加上错误 revision、错误量化配置、daemon 崩溃、socket 残留、GPU reset 这些故障注入,才看得出它是不是你的生产方案。
最小试跑命令倒不复杂。先启动 daemon。
python -m sglang.srt.weight_cache.daemon \
  --model-path /path/to/model \
  --tp-size 4 \
  --load-format auto \
  --dtype auto \
  --quantization fp8
确认各 rank 的 ready 文件出现。
ls /tmp/sglang_weight_cache_rank*.ready随后让重启实例走 client 模式。
python -m sglang.launch_server \
  --model-path /path/to/model \
  --tp-size 4 \
  --weight-cache-mode client
核心 daemon 已经在 SGLang 仓库 里。它不是一张只存在于博客里的架构图,可以直接读代码、做故障注入、提 issue。
我自己的判断可能有点保守。Weight Cache Daemon 最有价值的地方,并不是给模型加载做了一个更大的缓存,而是把「引擎进程」和「模型权重」原本绑死的生命周期拆开了。
进程可以频繁更新、回滚、被驱逐,权重继续留在显存。以前不敢做的滚动操作,开始有了更小的恢复窗口。
但拆开生命周期之后,系统也多了一个需要被认真管理的长期状态。版本、权限、拓扑、量化、环境戳、引用计数和故障域,一个都逃不掉。
495 秒降到 0.63 秒,很爽。
真正让人敢在凌晨按下重启按钮的,还是那套会在不一致时拒绝工作的合同。