posts/solaris-interface-world-model.md
Solaris 没有 DOM,界面再漂亮也难上线
一个网站没有 DOM,没有组件树,甚至没有一颗真实的按钮。
你在客厅图片里拖一下桌子,下一帧,桌子真的挪开了。你再点一幅画,后面的点击开始给物体刷上那幅画的风格。整个界面不是加载出来的,而是像视频一样,一帧一帧长出来。
这不是概念片。Runway 在 8 月 31 日发布了 Solaris,把它叫作第一个「界面世界模型」,英文是 Interface World Model。它能在 720p 下实时生成界面,根据点击、拖动和文字指令继续画下一帧。
有点子牛逼。
可我看到官方把「不再需要中间表示」写得那么轻松,脑子里冒出来的不是前端要失业了,而是一句更扫兴的话。
没有 DOM 以后,谁来证明这个界面是对的?
Solaris 官方演示图,整张场景既是画面,也是交互表面。
能生成,不等于能上线
传统界面确实麻烦。设计稿先变成 HTML、CSS、JavaScript 或原生组件,视觉细节在翻译过程中不断缩水。设计师画了一片会呼吸的光影,工程师拿到手里一看,工期三天,做个渐变算了。
Runway 抓住的就是这条裂缝。
Solaris 不把视觉先翻译成组件。它把点击和拖动当作下一帧的条件,语言模型负责理解用户想干什么,世界模型负责把变化画出来。一个决定行为,一个负责渲染。它建立在 Runway 的 Gen-4.5 和 GWM-1 之上,再把多步视频去噪蒸馏到少数几步,才把速度压进交互区间。
官方给出的门槛很具体,延迟接近半秒,交互感就会开始消失。普通视频模型等几秒还能当内容工具,按钮等半秒,用户已经开始怀疑网页卡死了。
好家伙,视频生成现在开始跟 pointerdown 抢延迟预算了。
不过速度只是第一道门。一个电商结算页要上线,测试不会只问「画面像不像」。它会问价格有没有算错,优惠券有没有重复使用,未登录用户能不能碰到地址,提交两次会不会下两单,订单失败后能不能恢复。
这些问题都不住在像素里。
Playwright 可以用截图断言检查视觉回归,也可以用选择器验证元素状态。Solaris 如果只留下连续帧,截图仍然能比,业务断言却失去了稳定落点。今天第 37 秒出现的确认按钮,明天同样输入可能换了位置、颜色,甚至换了一种表达。测试要是只能盯着画面找差异,调试体验会非常接近在监控录像里排查数据库事务。
厉害了,界面活了,测试先没了。
所以生产版生成式界面一定还得有一层看不见的确定性结构。输入要记账,哪次点击、拖动、语音和键盘事件触发了变化。状态要记账,商品、价格、权限和流程节点不能跟着像素一起自由发挥。渲染也要记账,模型版本、随机种子、提示、参考素材和帧序列都得能回放。涉及付款、授权、删除和提交时,还要让一个确定性策略层做最终裁决。
画面可以生成,责任链不能生成。
可观测性也得换一种写法。传统网页出问题,工程师还能顺着路由、组件、接口和日志往下查。生成式界面如果只保存最终视频,里面没有「为什么这颗按钮会出现」的答案。比较靠谱的做法不是把每一帧都塞进日志,那会先把存储账单打爆,而是给一次交互保留关键检查点,用户意图、结构化动作、业务状态、模型决策、渲染版本和异常帧彼此关联。
出了事故,系统应该能把第 37 秒前后的状态重新跑一遍,也能跳过世界模型,退回一套确定性界面。这个降级开关很土,却可能是生成式界面最值钱的按钮。模型延迟升高、连续几帧文字漂移、关键对象消失,或者成本越过会话预算时,产品不能只给用户一段越来越抽象的视频。
还有成本。静态页面发到 CDN 以后,用户多停一分钟几乎不会触发新的模型推理。Solaris 这种逐帧生成方式里,停留时间、分辨率、帧率和交互频率都会进入成本函数。官方只说它比标准视频扩散模型便宜了几个数量级,没有公布一小时会话要多少钱。没有这条数字,任何「操作系统层」的判断都得先留半步。
这话听着有点刺耳,但生成式界面真正的商业门槛,也许不是能不能画,而是能不能给每个会话设置稳定的延迟预算、质量预算和钱袋子。
评测很亮眼,证据仍得踩刹车
Runway 这次没有只放 demo,它做了两组评测。
第一组让 GPT-4o、Gemini 2.5 Pro 和 Claude Fable 5 从单张截图重建 30 个界面,内容从普通网页一路加码到幻灯片、图形设计和自然场景。评测看结构相似度 SSIM,也看 DINOv3 和 CLIP 的视觉特征相似度。
结果很整齐,画面越复杂,三种模型丢的信息越多。自然场景掉得最狠。Fable 5 比早期模型强不少,但锅上的文字、海报的人物、复杂排版,仍会在「截图转语言再转代码」的过程中变形。
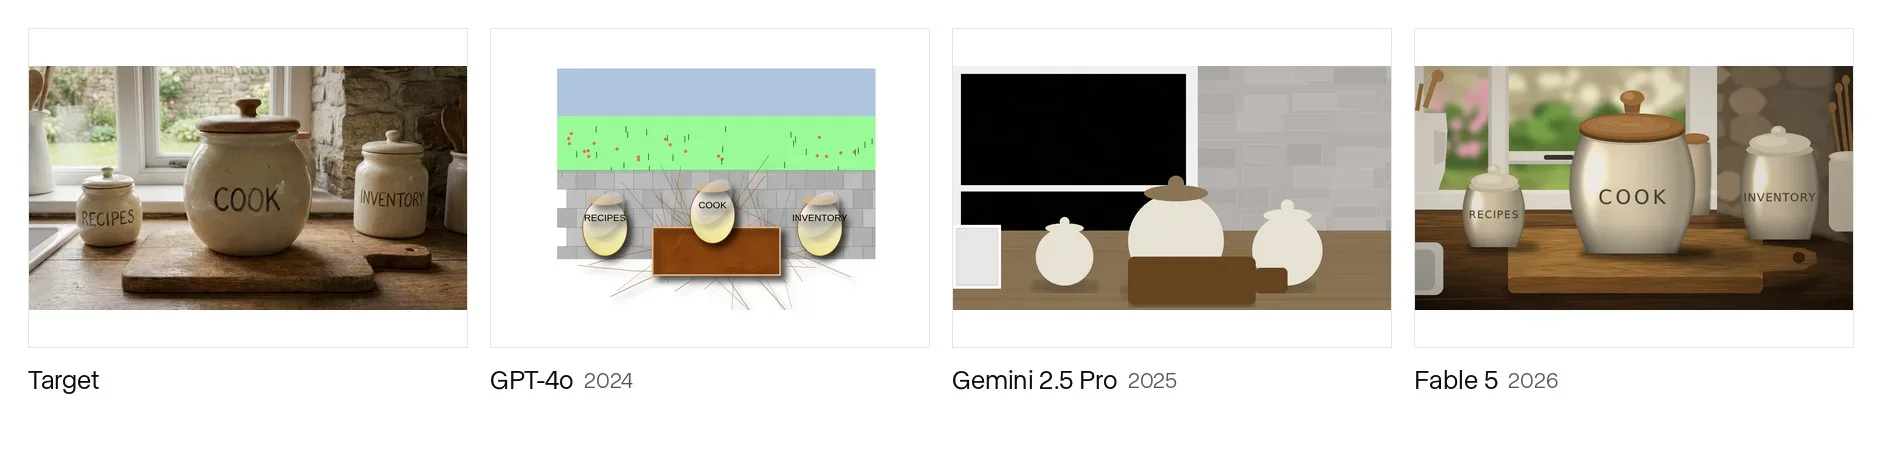
同一张自然场景经不同多模态模型重建,结构保住了,细节和空间关系仍在流失。
这组结果能证明代码重建截图有损,却不能直接证明 Solaris 更适合业务软件。截图复刻测的是视觉保真,结算页上线测的是功能正确、状态一致和异常恢复。两张考卷,不该混成一个总分。
第二组更接近交互。Solaris 和 Claude Opus 5 从同一张图出发,执行同样的操作。250 名参与者看了 30 组例子,给出接近 7500 次两两判断。官方图里,62% 的判断认为 Solaris 更听指令,25% 选代码方案,13% 没偏好。自然度一项是 72%、21% 和 7%。
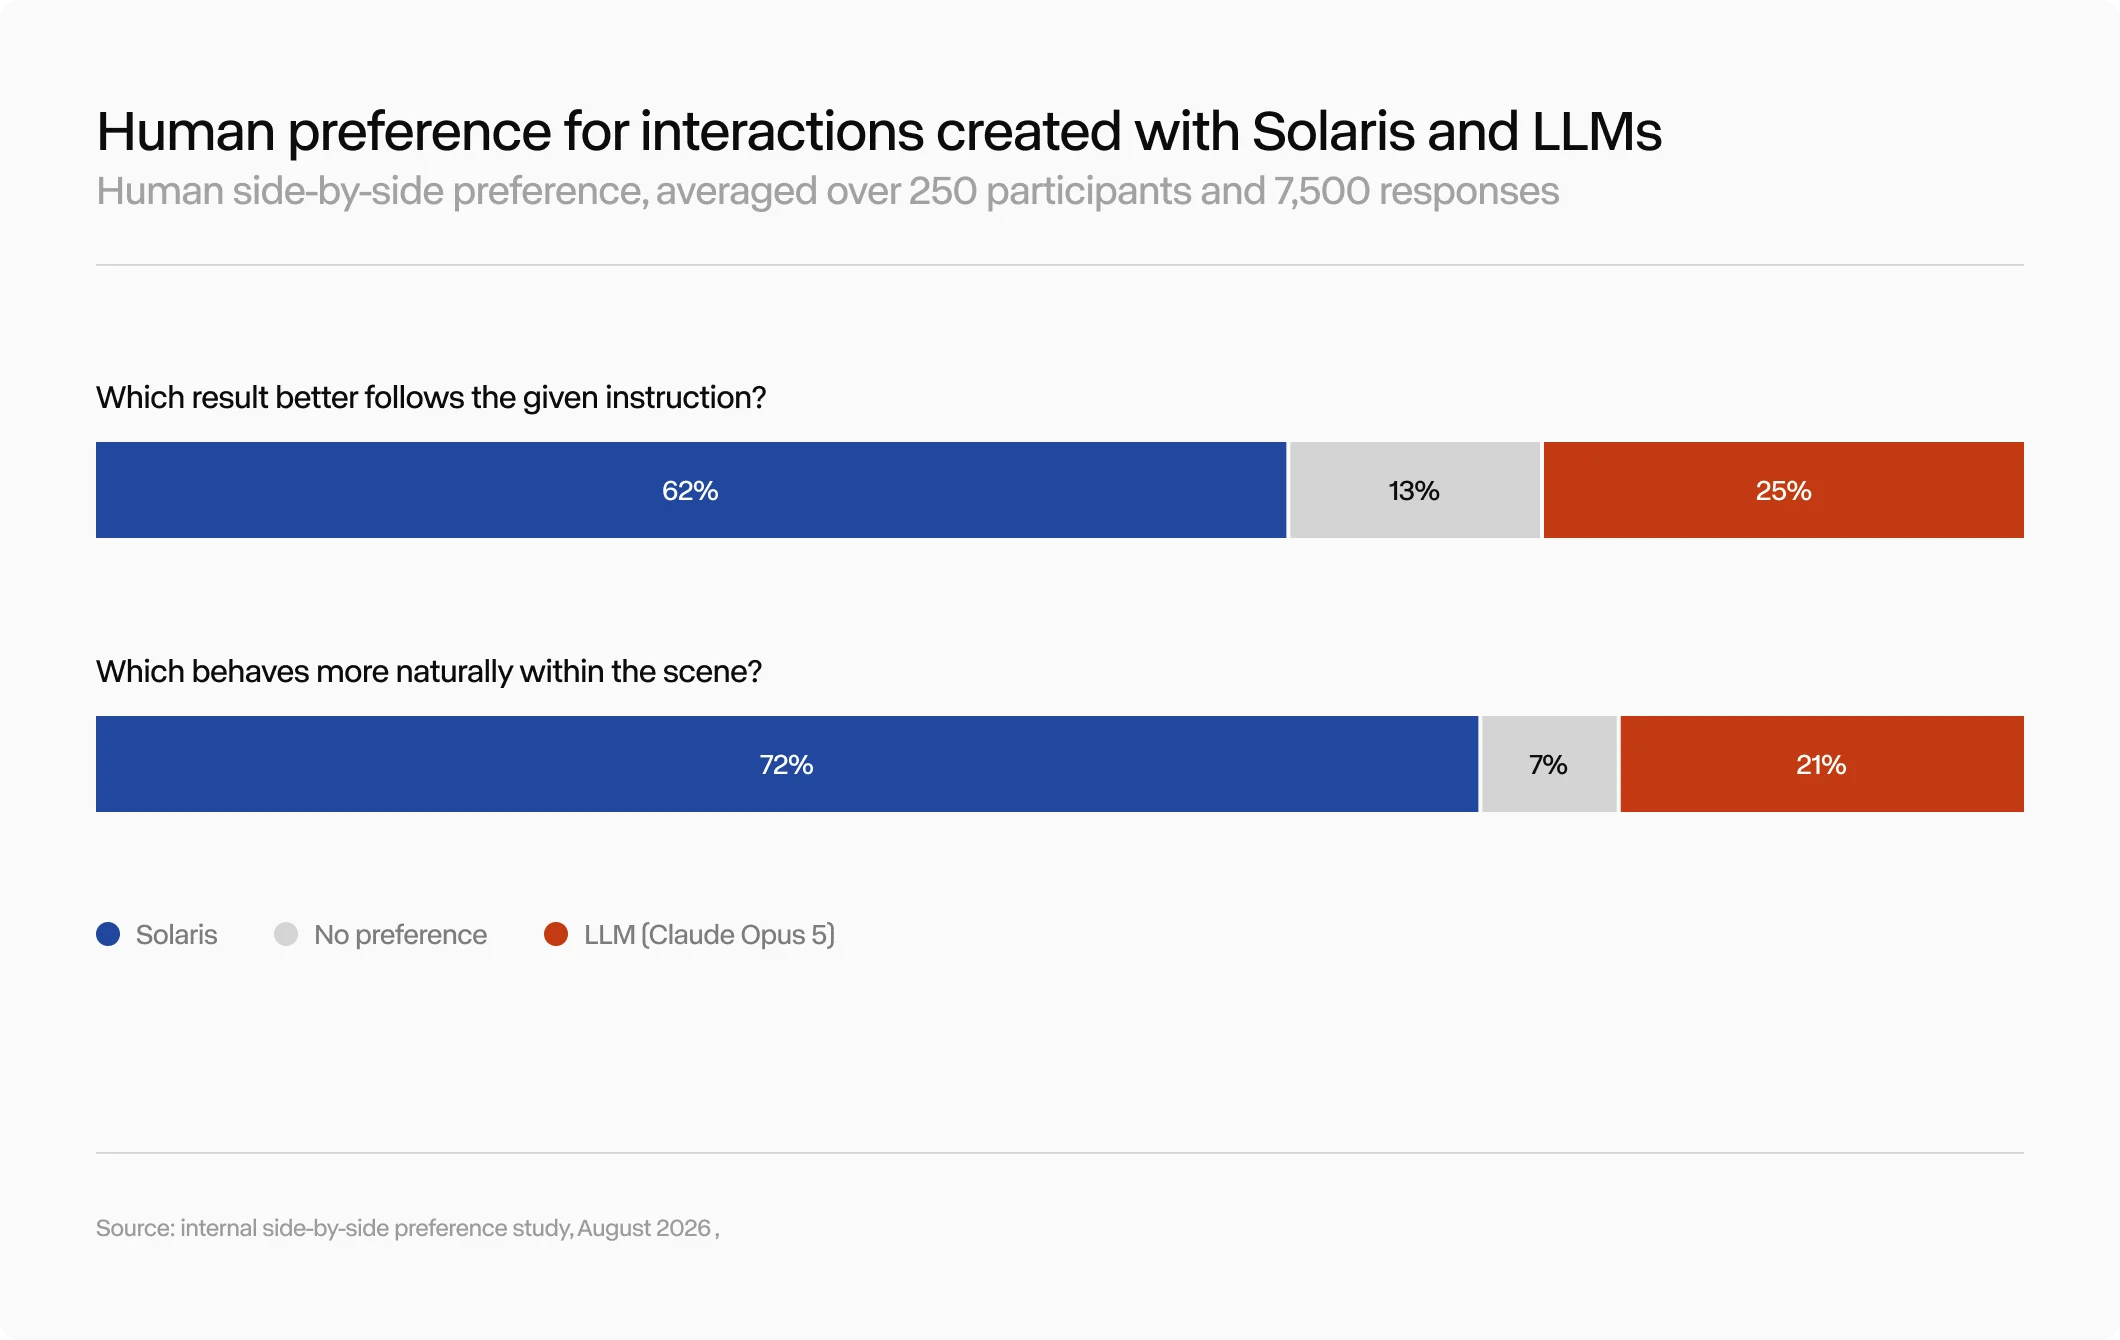
官方配图记录了 250 名参与者、近 7500 次判断的偏好结果。
我把图和正文对了一遍,还发现一个挺有意思的小缝。正文写的是 61%、24%、13% 和 71%、21%、6%,图里则是 62%、25%、13% 和 72%、21%、7%。可能是取整,也可能是图文用了不同版本的数据。差一两个百分点不改结论,但它提醒我们,这更适合当方向性证据,不适合当精确跑分背诵。
坦率讲,这个结果已经足够说明 Solaris 在开放场景里更自然。用户要把灯塔视角平滑移到海面,或者让桌上的物体浮起来,世界模型比临时生成一段前端代码更会处理材质、光影和连续运动。
可一旦场景里出现合同金额、药品剂量、验证码或删除确认,「更自然」反而不是最高优先级。一个非常自然地画错数字的界面,比一个丑但确定的表单危险得多。Runway 自己也承认,稳定文字、事实可信度、长会话一致性、成本和无障碍都还没解决,Solaris 目前也只开放合作伙伴和早期访问申请。
这份克制挺重要。
真正难的是给像素补回语义
屏幕阅读器读不了「看起来像按钮」的像素。它需要知道这是按钮,名字是什么,现在有没有焦点,按下去会发生什么。键盘用户需要稳定的焦点顺序,自动化工具需要可寻址的对象,搜索引擎需要文本,客服排障需要能复现的状态。
WAI-ARIA 这些规范存在,不是因为工程师迷恋标签,而是视觉之外还有一整套人和机器都依赖的语义通道。
Solaris 真要进入通用软件,很可能会长成混合架构。世界模型负责空间、材质、动效和开放式探索,背后仍有一棵「影子语义树」,记录可访问角色、业务对象、允许动作和当前状态。用户拖动一件衬衫时,像素层负责让布料自然移动,语义层负责确认用户选中了哪个 SKU、尺码是什么、库存还有多少。
你想想看,这已经不是「用视频替代前端」。它更像把前端拆成两半,一半负责可验证的事实,一半负责不再预先写死的体验。
对 Agent 训练也是一样。Runway 引用的电脑操作研究指出,视觉智能体在基本任务上仍会挣扎。不断变化的生成界面能减少模型背布局、记坐标的投机,让它真的学习「找到酒店、选择日期、确认价格」这类意图。
但训练环境越开放,评分器越难写。任务到底有没有完成,不能由生成出来的画面自己说了算。比较靠谱的做法,是让世界模型制造变化,让一个独立的任务引擎保存真实状态,再用真实状态判分。视觉负责出题,确定性系统负责改卷。
这事儿短期最适合空间布置、商品体验、互动教学、游戏化教程和 Agent 训练环境。它们允许探索,视觉自然度的收益很高,偶尔一次偏航也能恢复。
支付、医疗说明、权限管理、合同确认和数据录入会慢很多。那里每个字都要可复制,每次动作都要可审计,每个错误都要能回滚。不是 Solaris 不行,而是这些场景对「确定」的需求,暂时高过对「鲜活」的需求。
我自己的判断是,Solaris 不会先消灭前端工程师。
它会先消灭另一条更老的假设,所有交互,都必须由工程师在用户到来之前一页页画死。
至于 DOM,它大概也不会消失。
只是从舞台中央退到像素背后,继续替那些漂亮画面背锅。