posts/startupbench-real-workflow.md
最强 Agent 真实工作只做完 30%,卡住它的不是工具
要求交 PDF,Agent 到头来交了一个 Markdown 文件。
它没报错,工具调用也全是绿的,甚至可能在总结里认真告诉你,任务已经完成。
不是段子。
一篇刚挂上 arXiv 的 StartupBench 论文,专门拿已经被真实市场验证的工作流测试通用智能体。56 项任务明确写了输出文件格式,没有一个模型做到百分之百合规。最好的一档也只有 97.6%,最低是 86.3%。
常见翻车朴素得让人无语,有的把要求的 PDF 交成 Markdown,有的本该同时交 XLSX 和 DOCX,却只留下其中一个。
好家伙,我们天天聊长上下文、工具调用、多智能体协作,Agent 还能在文件扩展名上摔一跤。
论文更扎心的结果还在后面。
StartupBench 一共做了 97 个端到端任务,覆盖医疗、金融、法律、商业管理、STEM 与计算机科学、教育与人文六个领域。研究团队统一工具和运行框架,让 9 个模型各跑 3 次,每项任务最多给 200 次交互机会。
平均分最高的 Kimi-K3 拿到 73.67 分,GPT-5.6-sol 是 73.61 分。两条曲线几乎贴在一起,看着都挺能干。
可研究团队加了一条很像真实交付的规则,聚合分达到 90 才算任务成功。
结果成功率最高的 GPT-5.6-sol 只有 31.27%,Kimi-K3 是 29.55%。没有一个模型完成三分之一以上的任务。
这里最值得琢磨的,不是谁比谁高了 1.72 个百分点。
真正的分水岭,是做了七成工作,和交出一份能直接使用的成品,根本不是同一件事。
很多 Agent 已经会浏览网页、读文件、跑代码、改表格、做幻灯片。它们能把工作流跑得很热闹,也确实完成了大量有效步骤。问题是,真实用户不会按工具调用次数付款。
用户只看手里的东西能不能用。
一份估值模型少对了一列数字,前面九成公式都正确也没用。一份法律分析漏掉决定适用范围的法条,排版再漂亮也不能签字。一份治疗计划把用药时序写错,语言再专业也不能进入临床。一份代码补丁测试通过,却把需求里明确禁止改动的接口顺手重构了,reviewer 还是会把它打回来。
这就是 StartupBench 选任务的聪明之处。
它没有继续让研究者坐在会议室里想象「Agent 应该会什么」,而是去看已经获得付费、用户规模或融资验证的 AI 创业产品。研究团队调查了二十多款产品,访谈三十多名深度用户,再让五十多名领域专家把真实需求改造成可复现的任务。
每个任务不只给一句 Prompt,还提供完整工作区、输入文件和交付要求。到终稿时用平均 25.3 条细粒度标准验收。整套基准一共有 2,453 条标准。
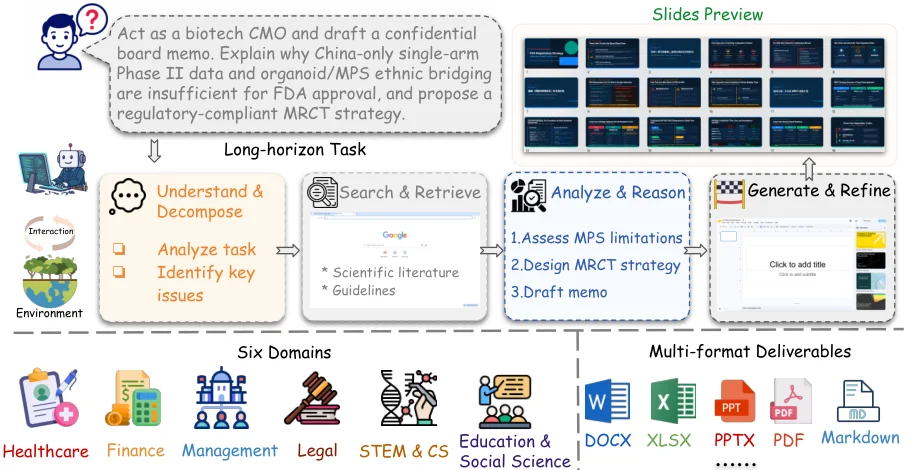
论文把医疗、金融、法律、商业、STEM 与教育工作流还原成可复现的完整交付任务
这个思路有点子牛逼。
不是从模型能力倒推场景,而是从用户已经愿意委托的工作反推验收。
很多团队做评测,起点还是模型。模型会联网了,就测搜索。模型会用电脑了,就测点按钮。模型会写代码了,就测仓库修 bug。这些测试当然有用,可它们很容易把「单项能力进步」误写成「完整工作可以交付」。
真实产品的起点该是用户。
用户给了一堆源文件,要一份能发给客户的报告。用户丢来几个工作表,要一个公式、缓存值、图表和命名都符合内部规范的 Excel。用户要的不是模型展示五种能力,他要的是明早九点能用的那个文件。
这两种评测视角,差得不是一点。
论文把验收项分成核心、重要和辅助三档。9 个模型平均满足 68.67% 的辅助要求,65.89% 的重要要求,却只满足 63.45% 的核心要求。
越影响任务成败的要求,反而越容易漏。
模型很擅长把外围做得像模像样。标题在,目录在,图表在,颜色也挺协调。真正决定能不能用的计算、引用、领域规则和跨文件一致性,却可能在某个角落里悄悄坏掉。
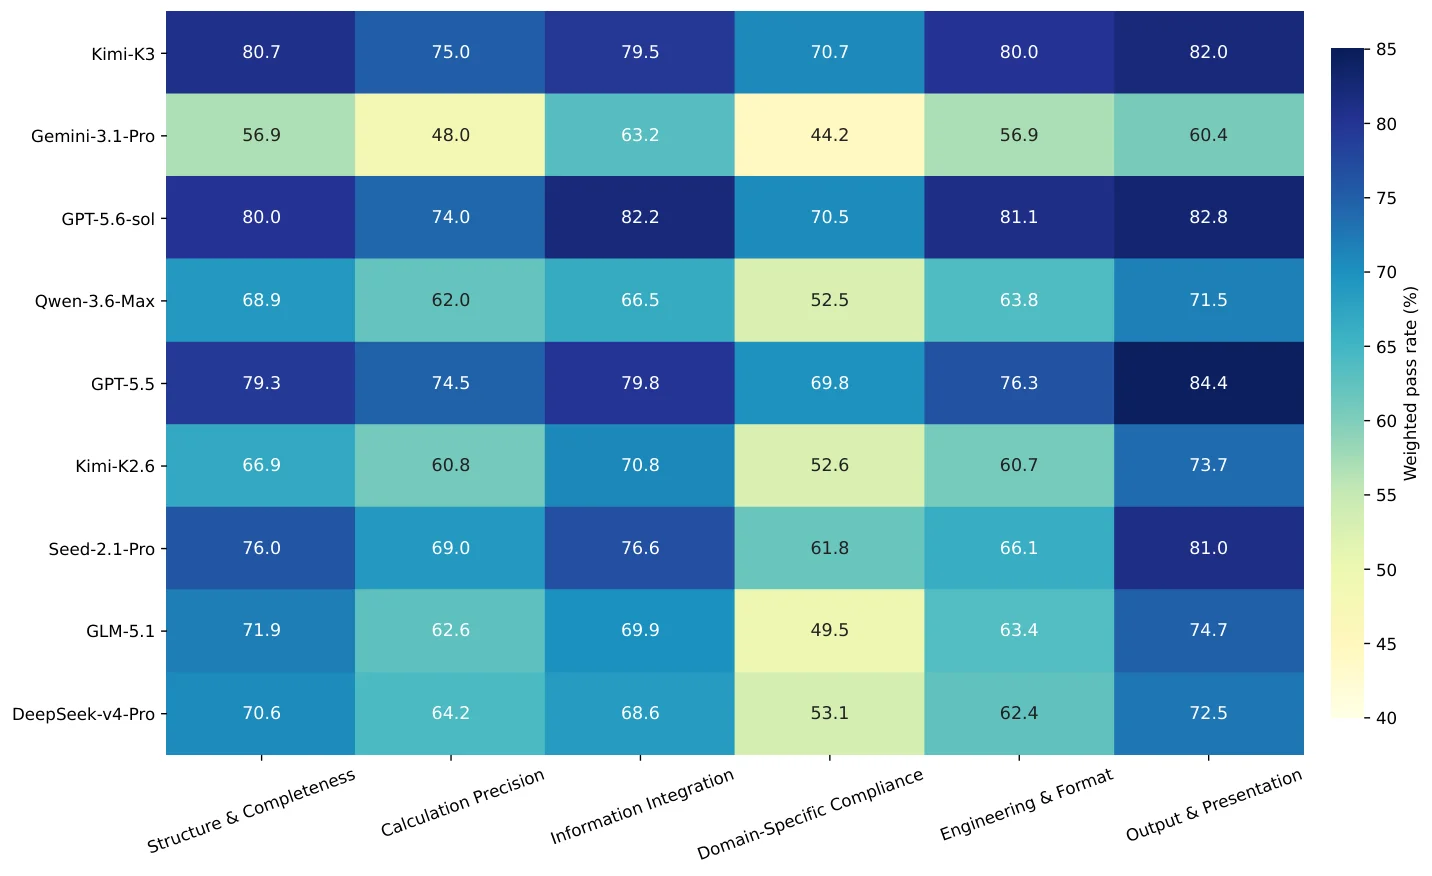
模型普遍更擅长结构与呈现,领域合规和计算精度更容易掉分
这跟很多代码 Agent 的翻车方式太像了。
它会补测试,会更新 README,会给函数加漂亮的类型标注,结果需求里最关键的幂等性没守住。CI 一片绿,线上重试一次,订单发了两遍。
棒棒的,除了不能上线,哪儿都挺好。
StartupBench 给这种现象起了一个很准的名字,叫「自我验证幻觉」。
Agent 执行完命令,看到进程以 exit 0 退出,就开始总结自己做了什么。它把过程顺利当成结果正确,把「我运行了检查」当成「交付物已经通过检查」。可它没有重新打开最终文件,没有逐格核对表格,也没有把用户最初的要求重新读一遍。
论文里有个工作簿案例。Agent 做出了要求的工作表、公式、图表和仪表盘,表面上很完整。验收时才发现,供下游复核的关键缓存值没有写进去,文件因此无法验证。
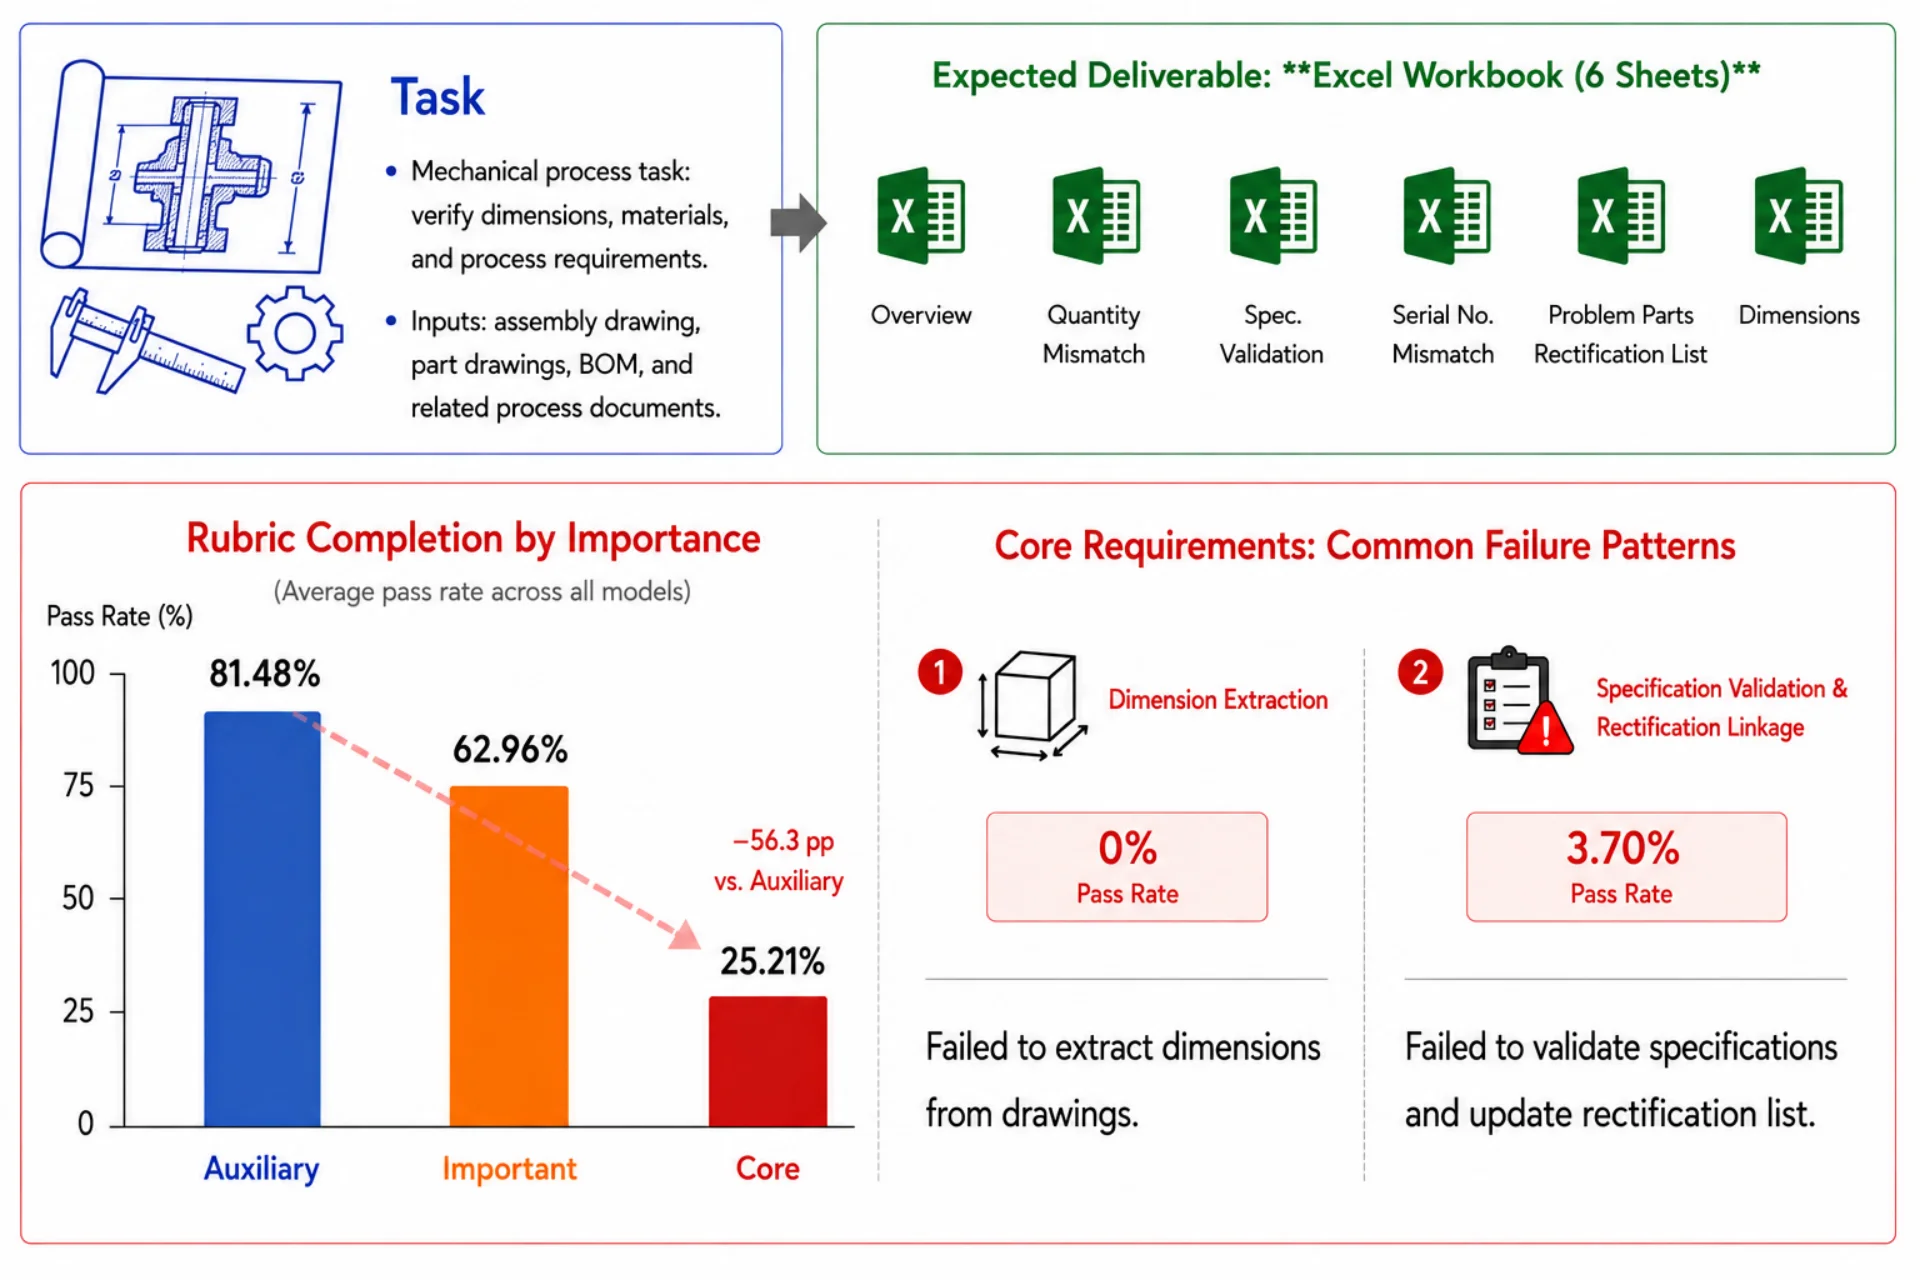
另一个机械工艺案例里,外围表格做得很全,尺寸提取与规范校验等核心要求却几乎没过
不是不会生成。
是没有验收。
这事儿特别值得做 Agent 的工程师警惕。我们很容易把执行器、工具层和重试机制做得越来越复杂,却把末端那一步交给同一个模型随口确认。
让写答案的人给自己的答案签字,风险当然高。
更靠谱的做法,是把用户需求先编译成一份可执行合同。要求 PDF,就在落盘后检查 MIME 类型和文件头。要求同时交 XLSX 与 DOCX,就对输出目录做集合校验。要求表格公式可复算,就用独立进程重开工作簿,读取公式、缓存值和关键单元格。要求引用完整,就让验证器逐条检查链接和出处。
能用代码确定的,别浪费模型判断。
没法写成确定性规则的,再交给独立 Judge Agent。论文没有让一个 judge 一口气看完二十多条标准,而是每条 rubric 启一个轻量评审会话,允许它打开原始文件、看渲染图、查证据。这样做与领域专家的 rubric 判断一致率达到 92.78%。把所有标准一次塞给同一个 judge,一致率会掉到 83%,还经常因为输出不完整反复重跑。
这给生产系统的启发很直接。
生成和验收要分开,确定性检查和语义判断也要分开。
执行 Agent 负责做,规则引擎负责拦明显错误,Judge Agent 负责看那些必须结合语义和专业背景才能判断的要求。三者不能都缩成同一句「请检查你的工作」。
可能有朋友会说,换一套更强的 Agent 框架不就行了?
论文真的试了。
研究团队把部分模型分别放进 Hermes、Claude Code 和 Nanobot。三套通用框架的最好与最差结果,平均只差 1.79 分,模型排序也没变。
框架当然重要。工具描述、上下文管理、重试、权限和缓存,都会影响实际表现。可在这组测试里,单纯把 harness 换个名字,救不了端到端交付。
真正拉开差距的是专用系统。
通用智能体全部运行的平均分是 64.26,成功率 19.74%。就算给通用智能体三次机会,只挑最好的一次,平均分升到 71.75,成功率也只有 28.06%。针对各自工作流优化过的专用创业产品,平均分达到 83.50,成功率 39.18%。
专用系统多出来的,不一定是一套更神秘的架构。
它往往只是把领域规则做得更硬,把工具收得更窄,把交付格式固定下来,再把真实客户踩过的坑一条条写进验收。金融产品知道估值日期不能乱,法律产品知道论点后面必须有可追溯依据,医疗产品知道建议必须满足安全边界,代码产品知道补丁不是 diff 出来了就算完。
那些看起来不性感的专业惯例,才是用户敢不敢拿走成品的原因。
不过,这组数字也不能被偷懒地解读成「所有 Agent 只能完成 30% 的真实工作」。
StartupBench 还是一篇 arXiv v1 预印本,97 个任务不可能代表所有行业。它用融资、付费和用户规模筛选产品,这是一种务实的市场信号,也会偏向已经被资本和产品团队看见的工作流。成功线又定在 90 分,一份拿到 89 分、人工改五分钟就能用的文件,在表里仍然算失败。
评测还用 GPT-5.5 做 Judge Agent。论文拿专家复核做了校准,一致率超过 92%,已经比只让模型扫一眼靠谱很多,但它依然不是绝对真值。
这些限制不该被藏掉。
可它们也没有抹掉那个最重要的信号。平均分与成功率之间存在稳定的大缺口,核心要求比辅助要求更容易丢,换三套通用框架也没有显著改写结果。哪怕不迷信具体百分点,方向已经很清楚。
Agent 的瓶颈正在从「能不能开始做」移到「能不能把尾巴收干净」。
工程上怎么接住这个变化?
我觉得第一步不是再写一段更凶的系统提示词,而是给每次任务生成一份验收清单。用户说要两个文件,就把文件集合写进清单。用户给了时间范围,就把起止日期变成可检查字段。用户要求引用官方来源,就把来源类型和链接可达性列为硬条件。
这个动作很像编译。自然语言需求里有大量模糊表达,系统需要把能确定的部分编译成机器规则,把暂时不能确定的部分保留成语义 rubric。两者混在一段 Prompt 里,模型很容易挑显眼的做。拆开以后,漏了哪条一眼能看到。
第二步是给执行过程留下回执。哪个工具读了哪个文件,哪条数据来自哪个工作表,生成图表时用了哪一段范围,某个数字经过了什么公式,都应该能追到。回执不是为了把日志堆满硬盘,而是让验证器发现异常时,能顺藤摸瓜找到错误是从哪一步进来的。
第三步才是复开成品。
很多自动化停在「文件已生成」。真正的验收应该启动另一个进程,用和执行 Agent 不同的路径重新读取输出。Excel 要重算公式并抽查关键单元格,PDF 要渲染成图片看页面有没有截断,代码要在干净环境装依赖和跑测试,报告里的数字要从源文件反查。
这里最好故意制造一点不信任。执行 Agent 说自己生成了四张表,验证器别读它的总结,直接数工作簿里的 sheet。执行 Agent 说链接都能打开,验证器自己发请求。执行 Agent 说测试通过,验证器在隔离环境再跑一遍。
不是针对模型。
生产系统本来就不该靠自证。
到语义层,再让独立 Judge Agent 逐条看。它不负责重新做整份任务,只回答一个窄问题,某条验收条件有没有满足,证据在哪。窄问题更容易复核,也方便把失败交给人类。别让一个 judge 一边理解二十五条标准,一边翻十个文件,一边输出完整 JSON,它也会漏。
如果成本有限,可以先对高风险要求这么做。金额、权限、对外发送、删除、医疗建议、法律依据和上线配置优先;字体大小和配色晚一点。论文把 rubric 分级的做法很实用,因为不是每个错误都值得相同的 token 和人工时间。
跑上几周后,再把真实返工喂回来。客户改掉的单元格、reviewer 打回的接口、财务重新核对的数字、运营手动补上的来源,都是比模型自评更值钱的失败样本。它们应该变成下一版验收清单,而不是留在聊天记录里吃灰。
到这里,评测才开始和产品长在一起。
所以我对这篇论文最大的感受,不是通用 Agent 只做完约 30%,好像行业又被泼了一盆冷水。
坦率讲,能在 97 个真实长程任务上完成七成左右的验收项,已经很强。前几年的聊天模型连输入文件都摸不到,更别说做出一套 PPT、表格和报告。
可我们也该把评价尺度往前挪了。
以前问模型会不会做。
现在该问,成品谁验收,错误怎么发现,失败能不能定位,下一次运行能不能稳定复现。
Workflow-Gym 这类长程评测和 StartupBench 都在往同一个方向走,模型不再只答一道题,而是进入一个工作区,拿着文件和工具,把事情做到可以交付。评测也不该只给一句「不错」,它得像 code review、财务复核和上线验收一样,留下能追溯的证据。
如果你的团队已经在做 Agent,我觉得可以先改一个很小的地方。
别再让执行 Agent 自己说「完成」。
把用户要求拆成机器可查的合同,落盘后重新打开交付物,让另一个验证角色逐项签字。哪怕暂时只检查文件齐不齐、格式对不对、关键数字能不能复算,也比继续往工具箱里塞第十七个 MCP 更接近真实可靠性。
工具能让 Agent 走得更远。
验收才决定它走没走到。