posts/stateless-mcp-production.md
MCP 砍掉 session,才像生产协议
一条 MCP 工具调用,以前得先握手、领一个 Mcp-Session-Id,再带着它去干活。
放在本机 demo 里没啥。服务一旦横向扩到十几台实例,问题就来了。负载均衡要么记住这个会话该回哪台机器,要么后端再加一层共享状态。某台实例重启,客户端还得猜旧 session 到底死没死。
工具接口看起来像 HTTP,骨子里却牵着一根看不见的线。
MCP 2026-07-28 规范把这根线剪了。强制的 initialize 握手没了,Mcp-Session-Id 也退场。每个请求自己带上协议版本、客户端身份和能力信息,理论上能落到负载均衡器后面的任意一台实例。
好家伙,更新清单里最朴素的一条,反而可能是 MCP 走向生产环境最关键的一步。
因为它处理的并不只是少发一次请求。它逼着开发者回答一个一直被 session 遮住的问题,你的状态到底属于谁。
删掉的不是上下文,是暗箱里的传输状态
先把一个很容易传歪的说法掰正。
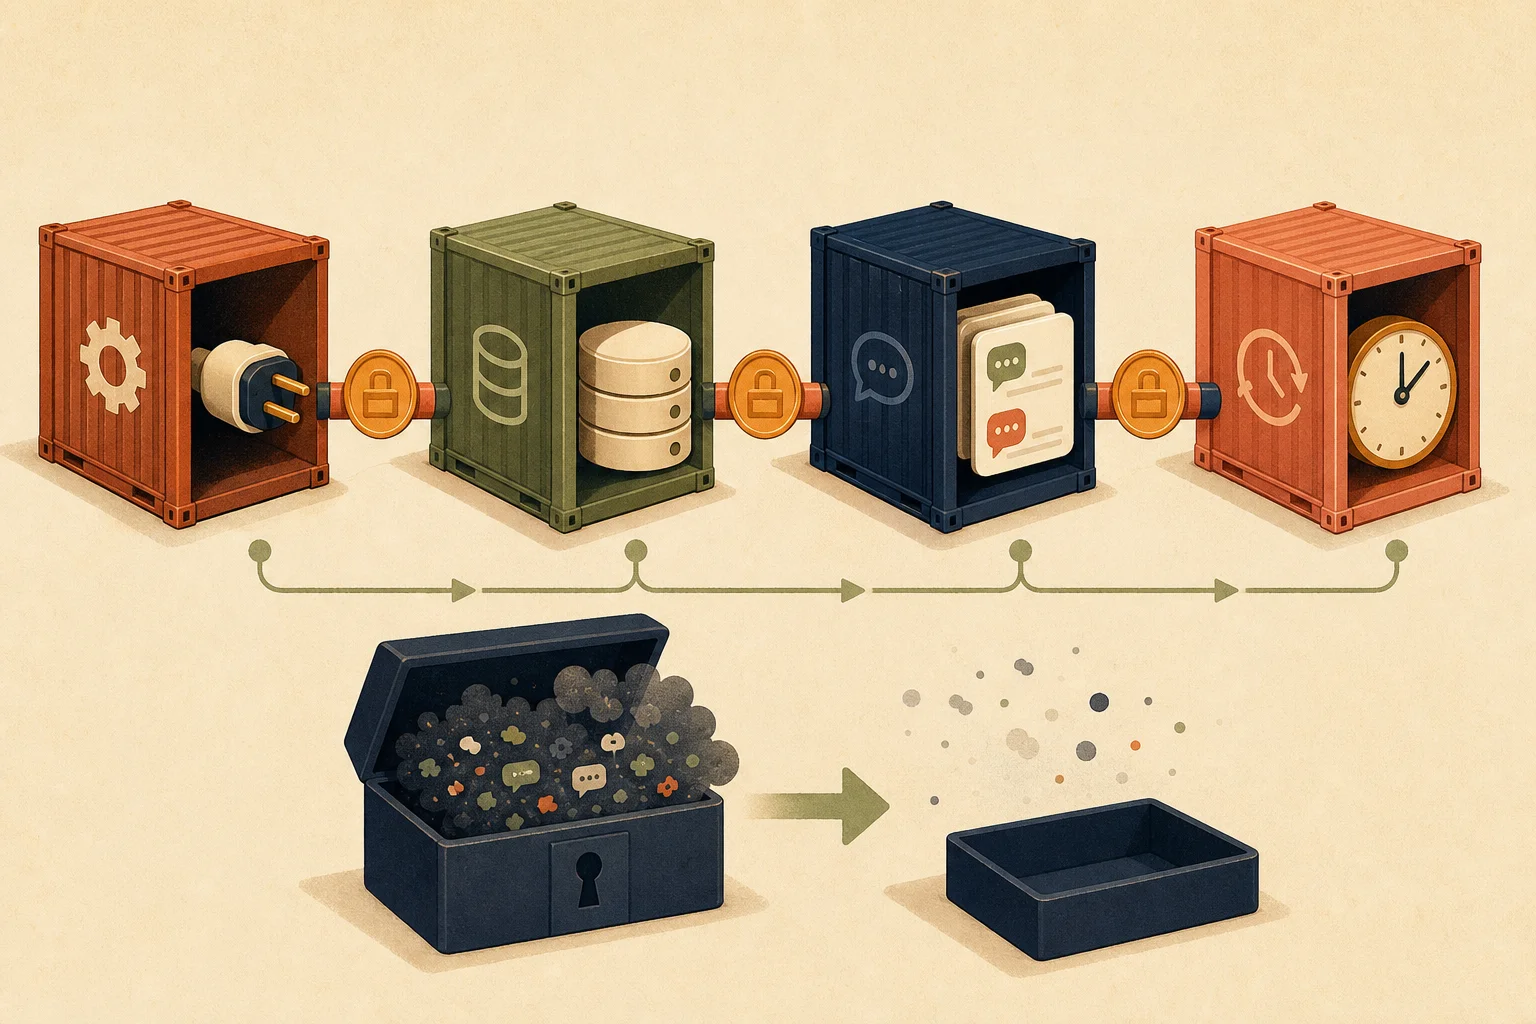
无状态 MCP 不是让 Agent 失忆,也不是让长任务每一步都从零开始。被取消的是协议传输层默认替你保管的 session。业务状态、对话上下文、任务进度,一个都没凭空消失。
官方给的做法很直接。工具如果需要跨调用保存状态,就创建一个显式 handle,让模型在后续工具参数里把它传回来。
假设一个代码分析工具要扫大型仓库。第一次调用返回 scan_handle,后续的查询、增量扫描和报告生成都显式携带这个值。模型能看见它,日志能记录它,权限系统也能判断当前调用者能不能使用它。
旧做法把状态塞在传输会话里,调用参数看着干净,代价却是很多关键关系藏起来了。你只看工具 schema,不知道它依赖哪段历史。请求被重试或转发到另一台机器,也很难判断缺了什么。
新做法更啰嗦一点,却诚实得多。
{
  "name": "continue_scan",
  "arguments": {
    "scan_handle": "scan_7f31",
    "path": "services/payment"
  }
}
这个 handle 不是随便造个字符串就完事。它要有过期时间、租户边界、权限校验和回收机制,最好还能支持幂等。否则 session 拆掉了,你只是亲手做出一套更难维护的 session。
这里有个挺有意思的工程变化。以前,状态由连接替你暗示。现在,状态变成工具合同的一部分。
模型更容易理解,测试更容易覆盖,事故也更容易追。
有点子牛逼的地方就在这儿。协议无状态,反而让应用状态变得更可见。
请求能自证身份,网关才终于看得懂
去掉协议会话之后,最先松一口气的可能不是 Agent 开发者,而是平台工程师。
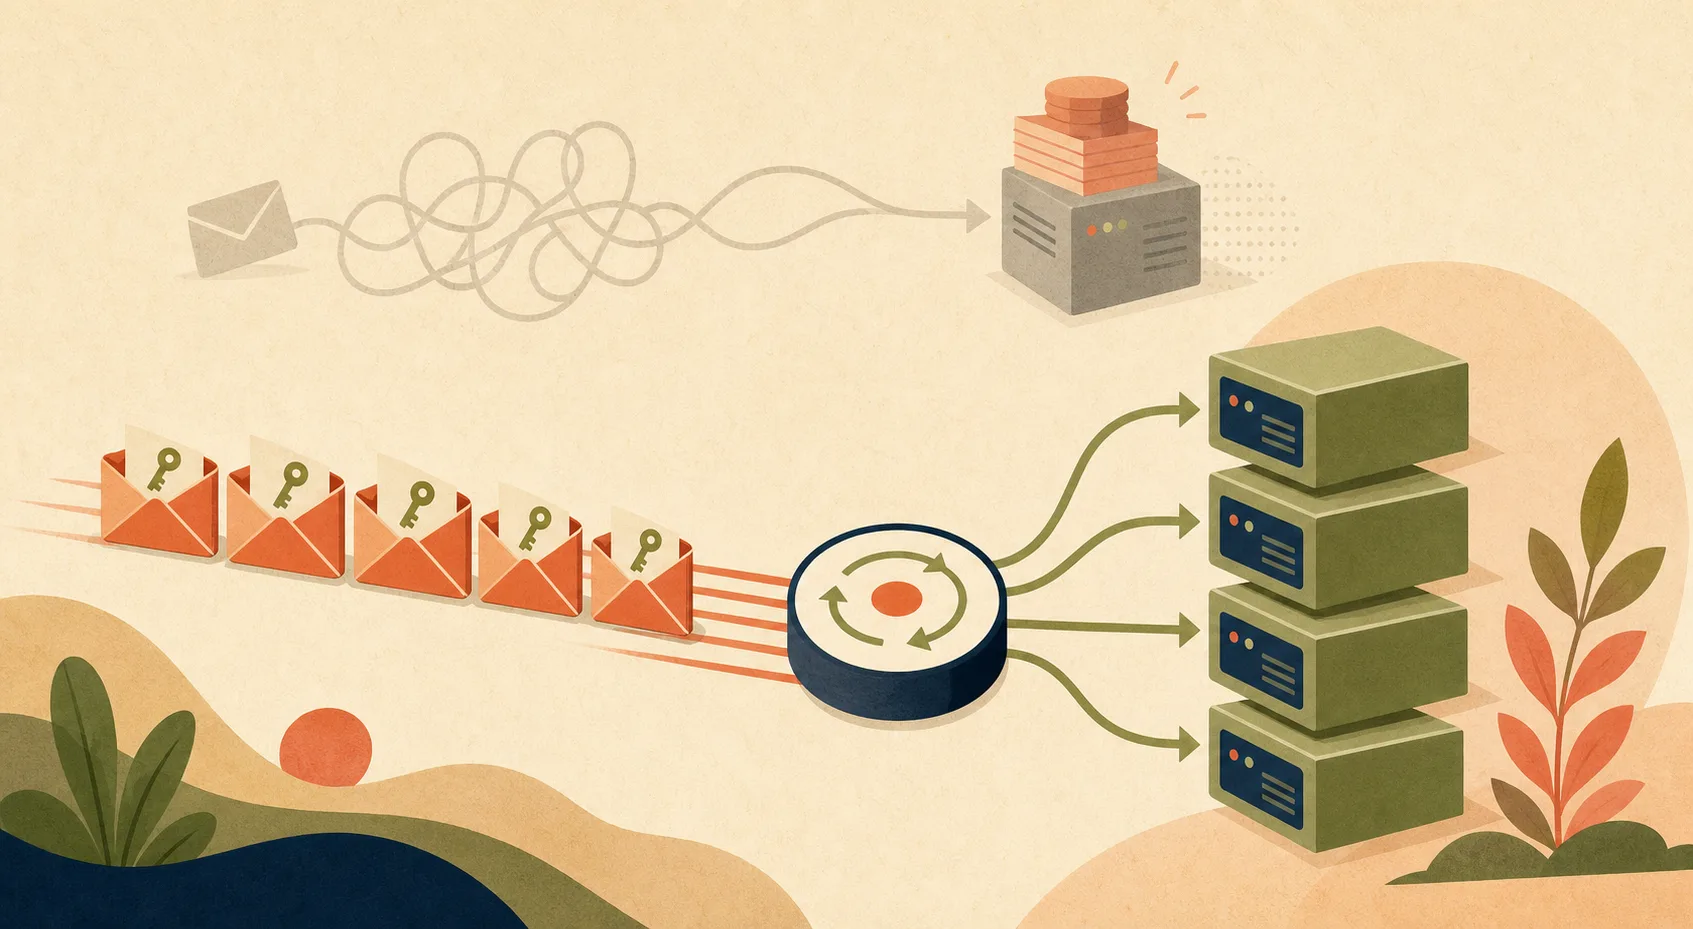
新规范要求 Streamable HTTP 请求带上 Mcp-Method 和 Mcp-Name。方法名和工具名进入标准 HTTP 头,网关、限流器和 WAF 不必先拆 JSON 请求体,就能知道这是 tools/call,调用的是 search 还是 delete_project。
这不是语法糖。
很多团队把 MCP 服务接进生产网关时,第一道墙就是流量不透明。普通 API 可以按路径、方法和身份做限流,MCP 却把不同工具调用塞进同一个端点。网关看到的都是 POST /mcp,至于里面要查天气还是删资源,它不知道。
现在方法和工具名能进入路由层,事情就顺了不少。高成本工具可以单独计费,敏感工具可以要求更强身份,读取类和写入类可以走不同审计策略。某个工具突发大量错误,也能在指标面板里直接看见,不必等应用日志慢慢拼。
坦率讲,这才像一套准备接受真实流量的协议。
请求自描述还有一个现实收益。任何请求都能落到任意实例,普通轮询负载均衡就能工作,不再强求 sticky session。扩容、实例滚动更新、故障摘除,都可以沿用成熟的 HTTP 基础设施。
别小看这点。Agent 工具真正上线后,流量往往不是平滑曲线。一个主任务拆出几十个子任务,工具调用会突然扇出。为了保 session 而把流量粘在一台机器上,很容易出现某台热得冒烟,旁边几台闲得发慌。
无状态核心把这个不均衡源头拿掉了。
当然,header 不是安全护身符。客户端自报 Mcp-Name,网关不能闭着眼就信。它还要结合已验证身份、实际请求体和服务端授权做一致性检查。否则攻击者改个头部,就可能绕过错误配置的策略。
新规范在授权上也补了硬约束,包括校验 RFC 9207 的发行者参数、把客户端凭据绑定到签发它的授权服务器,并逐步用 Client ID Metadata Documents 替代 Dynamic Client Registration。
这些名词听着有点干,但都指向同一个问题。谁签发、签给谁、能调用什么,不能再靠大家心照不宣。
需要人确认,别再抱着长连接不撒手
无状态协议最容易被追问的一刀是,如果工具执行到一半需要用户确认,怎么办?
旧模型很依赖服务端向客户端反向发请求,或者一直保持一条双向流。连接活着,服务端才能回来问一句,项目要花这笔钱,继续吗。
新规范用 Multi Round-Trip Requests 处理这件事。工具可以返回 input_required,说明它缺确认、缺参数或缺授权。客户端把问题展示给用户,收集答案后,再用 inputResponses 重试原调用。
看着绕了一圈,实际边界更清楚。
第一次请求停在什么状态,向用户展示了什么,用户给了什么答案,第二次请求带回了什么,这几步都能被单独记录。中途客户端断线,也不需要服务器傻等一条不知道什么时候恢复的连接。
你想想看,创建付费资源、发送对外消息、授权访问隐私数据,这些动作本来就不该靠一条隐形会话维持信任。它们应该有明确的暂停点和确认凭证。
MRTR 并没有消灭多次网络往返。名字里就写着 Multi Round-Trip。它改变的是每一次往返都能独立路由、独立鉴权、独立审计。
这块需要注意一下。客户端如果收到 input_required 就自动补默认值再重试,那只是把人工确认做成了摆设。涉及资金、隐私授权和外部写操作时,确认界面要展示真实影响,答案也要和原请求绑定,不能拿 A 操作的同意去放行 B 操作。
无状态让基础设施简单了,但产品责任一点没少。
缓存工具清单,省下的不只是几次请求
新规范还允许 tools/list、prompts/list、resources/list 和 resources/read 返回 ttlMs 与 cacheScope,并要求列表结果保持确定顺序。
很多人看到缓存,第一反应是少几次接口调用。这个收益当然有,但对 Agent 工作流更值钱的部分是 prompt cache 稳定性。
工具定义经常被塞进模型上下文。如果同一批工具每次返回顺序都漂,哪怕内容没变,拼出来的前缀也会变化。上游 prompt cache 命中率跟着掉,延迟和 token 成本就一起抬头。
稳定排序加明确缓存范围,等于告诉客户端,这份工具目录在什么边界内可以复用,多久需要刷新。
棒棒的,终于不用每一轮都重新背一遍工具说明书。
但缓存最怕误把动态权限当静态目录。不同用户、租户、套餐看到的工具可能不一样,cacheScope 必须把身份边界算进去。权限刚被撤销,旧目录也不能让客户端继续展示或调用失效工具。
做迁移测试时,别只测缓存命中。至少还要测权限变化后的失效、工具 schema 更新后的刷新、顺序稳定性和旧客户端拿到新缓存字段时的兼容。
这些测试没发布会参数那么吸睛,却决定了上线后会不会凌晨报警。
迁移别一把梭,先把四种状态画出来
新规范已经进入 TypeScript、Python、Go 和 C# 的一级 SDK,Rust SDK 也有 beta 支持。与此同时,Roots、Sampling、Logging 和旧 HTTP+SSE 都进入废弃期,官方给了至少十二个月窗口。
窗口不算短,也绝对不适合拖到最后一个月。
我自己更认可一条笨办法,先画状态地图。把现有 MCP 服务里的状态分成四类,传输状态、业务状态、对话上下文、长任务状态。每一类都写清楚现在存在哪、由谁创建、谁能读取、多久过期、重试时如何恢复。
如果团队画不出这张图,直接升级 SDK 大概率只是把旧问题换个位置藏。
传输状态通常可以跟着旧 session 一起删。业务状态要变成显式 handle,放到数据库、对象存储或任务系统。对话上下文应该由 Agent 运行时管理,不要偷偷塞进 MCP 服务。长任务则要评估新的 Tasks 扩展,明确轮询、更新、取消和结果保存策略。
然后做双栈。
新旧客户端不可能同一天全部升级。服务端先同时接受新规范和 legacy 模式,用 mcp-explorer doctor 这类探测工具做兼容检查,再从日志里观察旧流量比例。Simon Willison 的 mcp-explorer 能分别检查 stateless 与 legacy 路径,也能列出、检查和实际调用工具,拿来做迁移 smoke test 挺合适。
接着把观测补齐。每次调用至少记录协议版本、客户端身份、工具名、显式 handle、幂等键、授权结果、重试次数和 trace id。别把工具参数原样全塞日志,里面很可能有个人信息或公司数据。能哈希就哈希,能脱敏就脱敏。
最后才是压测。
压测不能只看每秒请求数。要专门制造实例滚动、请求跨实例、用户确认超时、授权服务器切换、缓存过期和同一调用重复提交。无状态设计最怕 demo 一路畅通,真正的失败分支一个没测。
说真的,这套迁移清单没有一项很酷。可生产系统往往就是这样,真正值钱的部分都长得不太像截图素材。
MCP 变轻了,能力边界反而要画得更重
Simon Willison 的实作复盘给这次规范补上了很好的落地样本。他一周里做了 mcp-explorer、datasette-mcp 和 llm-mcp-client 三个项目。前者探测工具,第二个给 Datasette 暴露只读数据库能力,第三个把他的 LLM 命令行工具接到 MCP 服务。
他重新对 MCP 感兴趣的一个原因是安全边界。
给通用 Agent 一套 shell,再放开任意网络访问,能力当然很强。问题也很朴素,审计人员很难快速说清它到底能碰什么。一个定义窄、参数明确、权限可查的 MCP 工具面,至少能让能力边界被看见。
注意,是更容易审计,不是自动安全。
工具照样可能有注入漏洞,授权照样可能配错,返回内容照样可能藏着恶意指令。MCP 只是把任意执行收窄成结构化能力,给网关、权限、限流、日志和人工确认提供下手的位置。
我始终觉得,Agent 工程最怕的不是能力不够,而是能力说不清。模型能做十件事,系统文档写了八件,权限策略只管六件,出事时日志还缺两件。最后大家围着一条调用链猜谜。
无状态 MCP 没替我们解完这道题,但它把最碍眼的一块黑布掀开了。
那根藏在连接里的线被剪掉,状态被迫走到台前。能放进参数的放进参数,该进任务系统的进任务系统,需要人点头的就老老实实停下来等。
协议变轻,边界变重。
这才像生产系统该有的样子。