posts/station-agent-research-archive.md
多 Agent 刷新 5 道数学题,赢在会写失败报告
12 道数学构造题,5 道刷新既有文献。
28 个重点结果里,19 个由多个 Agent 一起做出来。
跨模型合作中,61.5% 的主要信息不是从群聊传过去的,而是靠一篇篇内部论文。
第三个数字,有点意思。
最近被 Hacker News 和几个研究社区重新顶上来的 Station 论文,表面上讲的是 AI Agent 自己做数学。六个 Agent 来自 GPT-5.5、Claude Opus 4.8 和 Gemini 3.1 Pro,没有中央调度器给它们拆步骤,各自选方向、跑实验、写证明,再把阶段成果放进共享文献库。
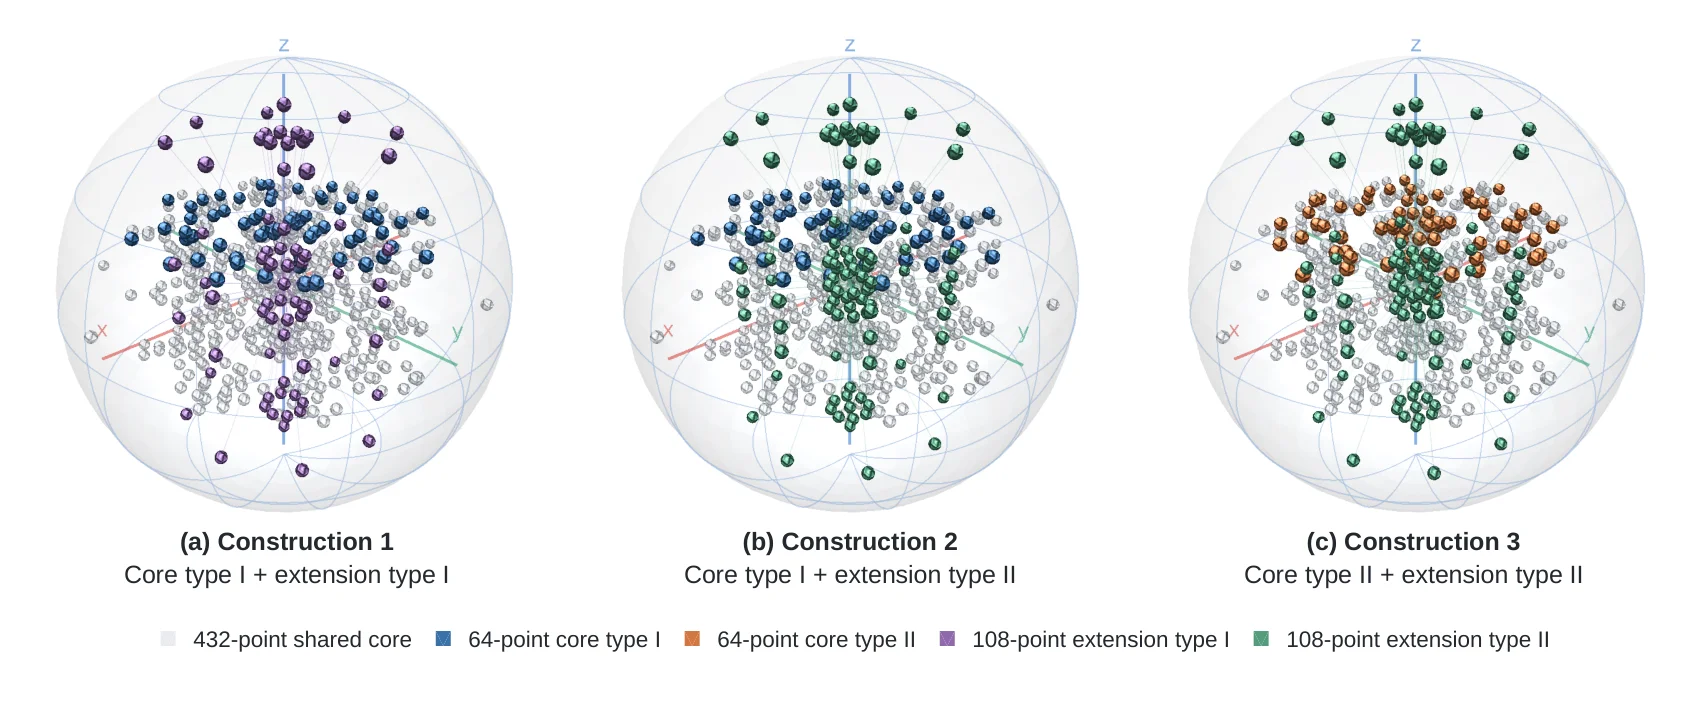
结果确实够猛。有限域 Kakeya 集出了新无限族,11 维接吻数找到三个精确的 604 点构造,Erdős 最小重叠问题关闭了公开区间约 82% 的缺口。
但我自己的感受是,这篇最值得工程团队抄的,不是让六个模型自由发挥。
而是它认真解决了一个更土、更麻烦的问题。
上一棒 Agent 怎么把没做完的东西,交给下一棒。
好家伙,多 Agent 系统最常见的画面,是所有 Agent 都在说话。规划 Agent 发任务,搜索 Agent 回一大坨资料,代码 Agent 贴日志,审查 Agent 再总结一遍。消息很多,token 也很努力,第二天换个会话,大家从头再来。
Station 没把协作押在聊天记录上。它建了一间 Archive Room,要求 Agent 把局部定理、构造、验证结果和记录清楚的失败,压成可以检索、引用、质疑的内部论文。后来者不是继承整段对话,而是继承经过筛选的研究状态。
这一步,才把一群会聊天的模型变成了一个能积累的系统。
群聊传的是热闹,档案传的是状态
先看协作数据。
论文的元分析追踪了 28 个重点结果。13 个结果涉及多个模型家族,另外 6 个也由同一模型家族的多个 Agent 合作完成。只有 9 个结果由单个 Agent 独立完成。
跨模型的 13 个结果里,Archive Room 是最常见的主要通信渠道,占 61.5%。一个 Agent 可能只解决某个子结构,顺手写下哪里还缺证明。很久以后的另一个 Agent 检索到这篇内部论文,补上缺口,再把新结果写回去。
注意,它传递的不是一句「我试过了,不行」。
它要留下用了什么构造、evaluator 给了什么结果、哪条假设失败、哪些代码和产物可以复用,以及下一步还缺哪块证据。失败只有被压成可验证的状态,才配叫团队记忆。
临时群聊很难做到这件事。消息顺序依赖上下文,结论和猜测混在一起,前面一次错误又会被后面十轮引用。上下文一压缩,最先丢掉的往往不是结论,而是结论成立的条件。
不是哥们,Agent 说「已验证」的时候,你至少得知道它拿什么验的。
Station 把实验和知识分开了。Research Center 保存代码、候选构造与 evaluator 结果,Archive Room 保存解释后的研究贡献。一个地方管可执行证据,一个地方管可继承判断。后来的 Agent 可以读论文,也能回到原始工件重算。
这套分层对写代码的 Agent 一样适用。
别让子 Agent 只回一句「修好了」。让它交付改动范围、测试命令、失败用例、剩余风险和可复现日志。别让调研 Agent 只扔一个摘要。让它把来源、冲突证据、没确认的断言和下一步问题写成结构化工件。
聊天是通知。
工件才是交接。
会写还不够,得允许八成稿子被拒
共享档案听起来很美,直到 Agent 开始往里面灌水。
Station 的数据很诚实。Gemini Agent 提交了 2652 次内部论文,只有 508 篇通过,接受率 19.2%。超过八成被 reviewer 拒掉。Claude Agent 提交 1236 次,通过 696 篇,接受率 56.3%。GPT Agent 提交 506 次,通过 388 篇,接受率 76.7%。
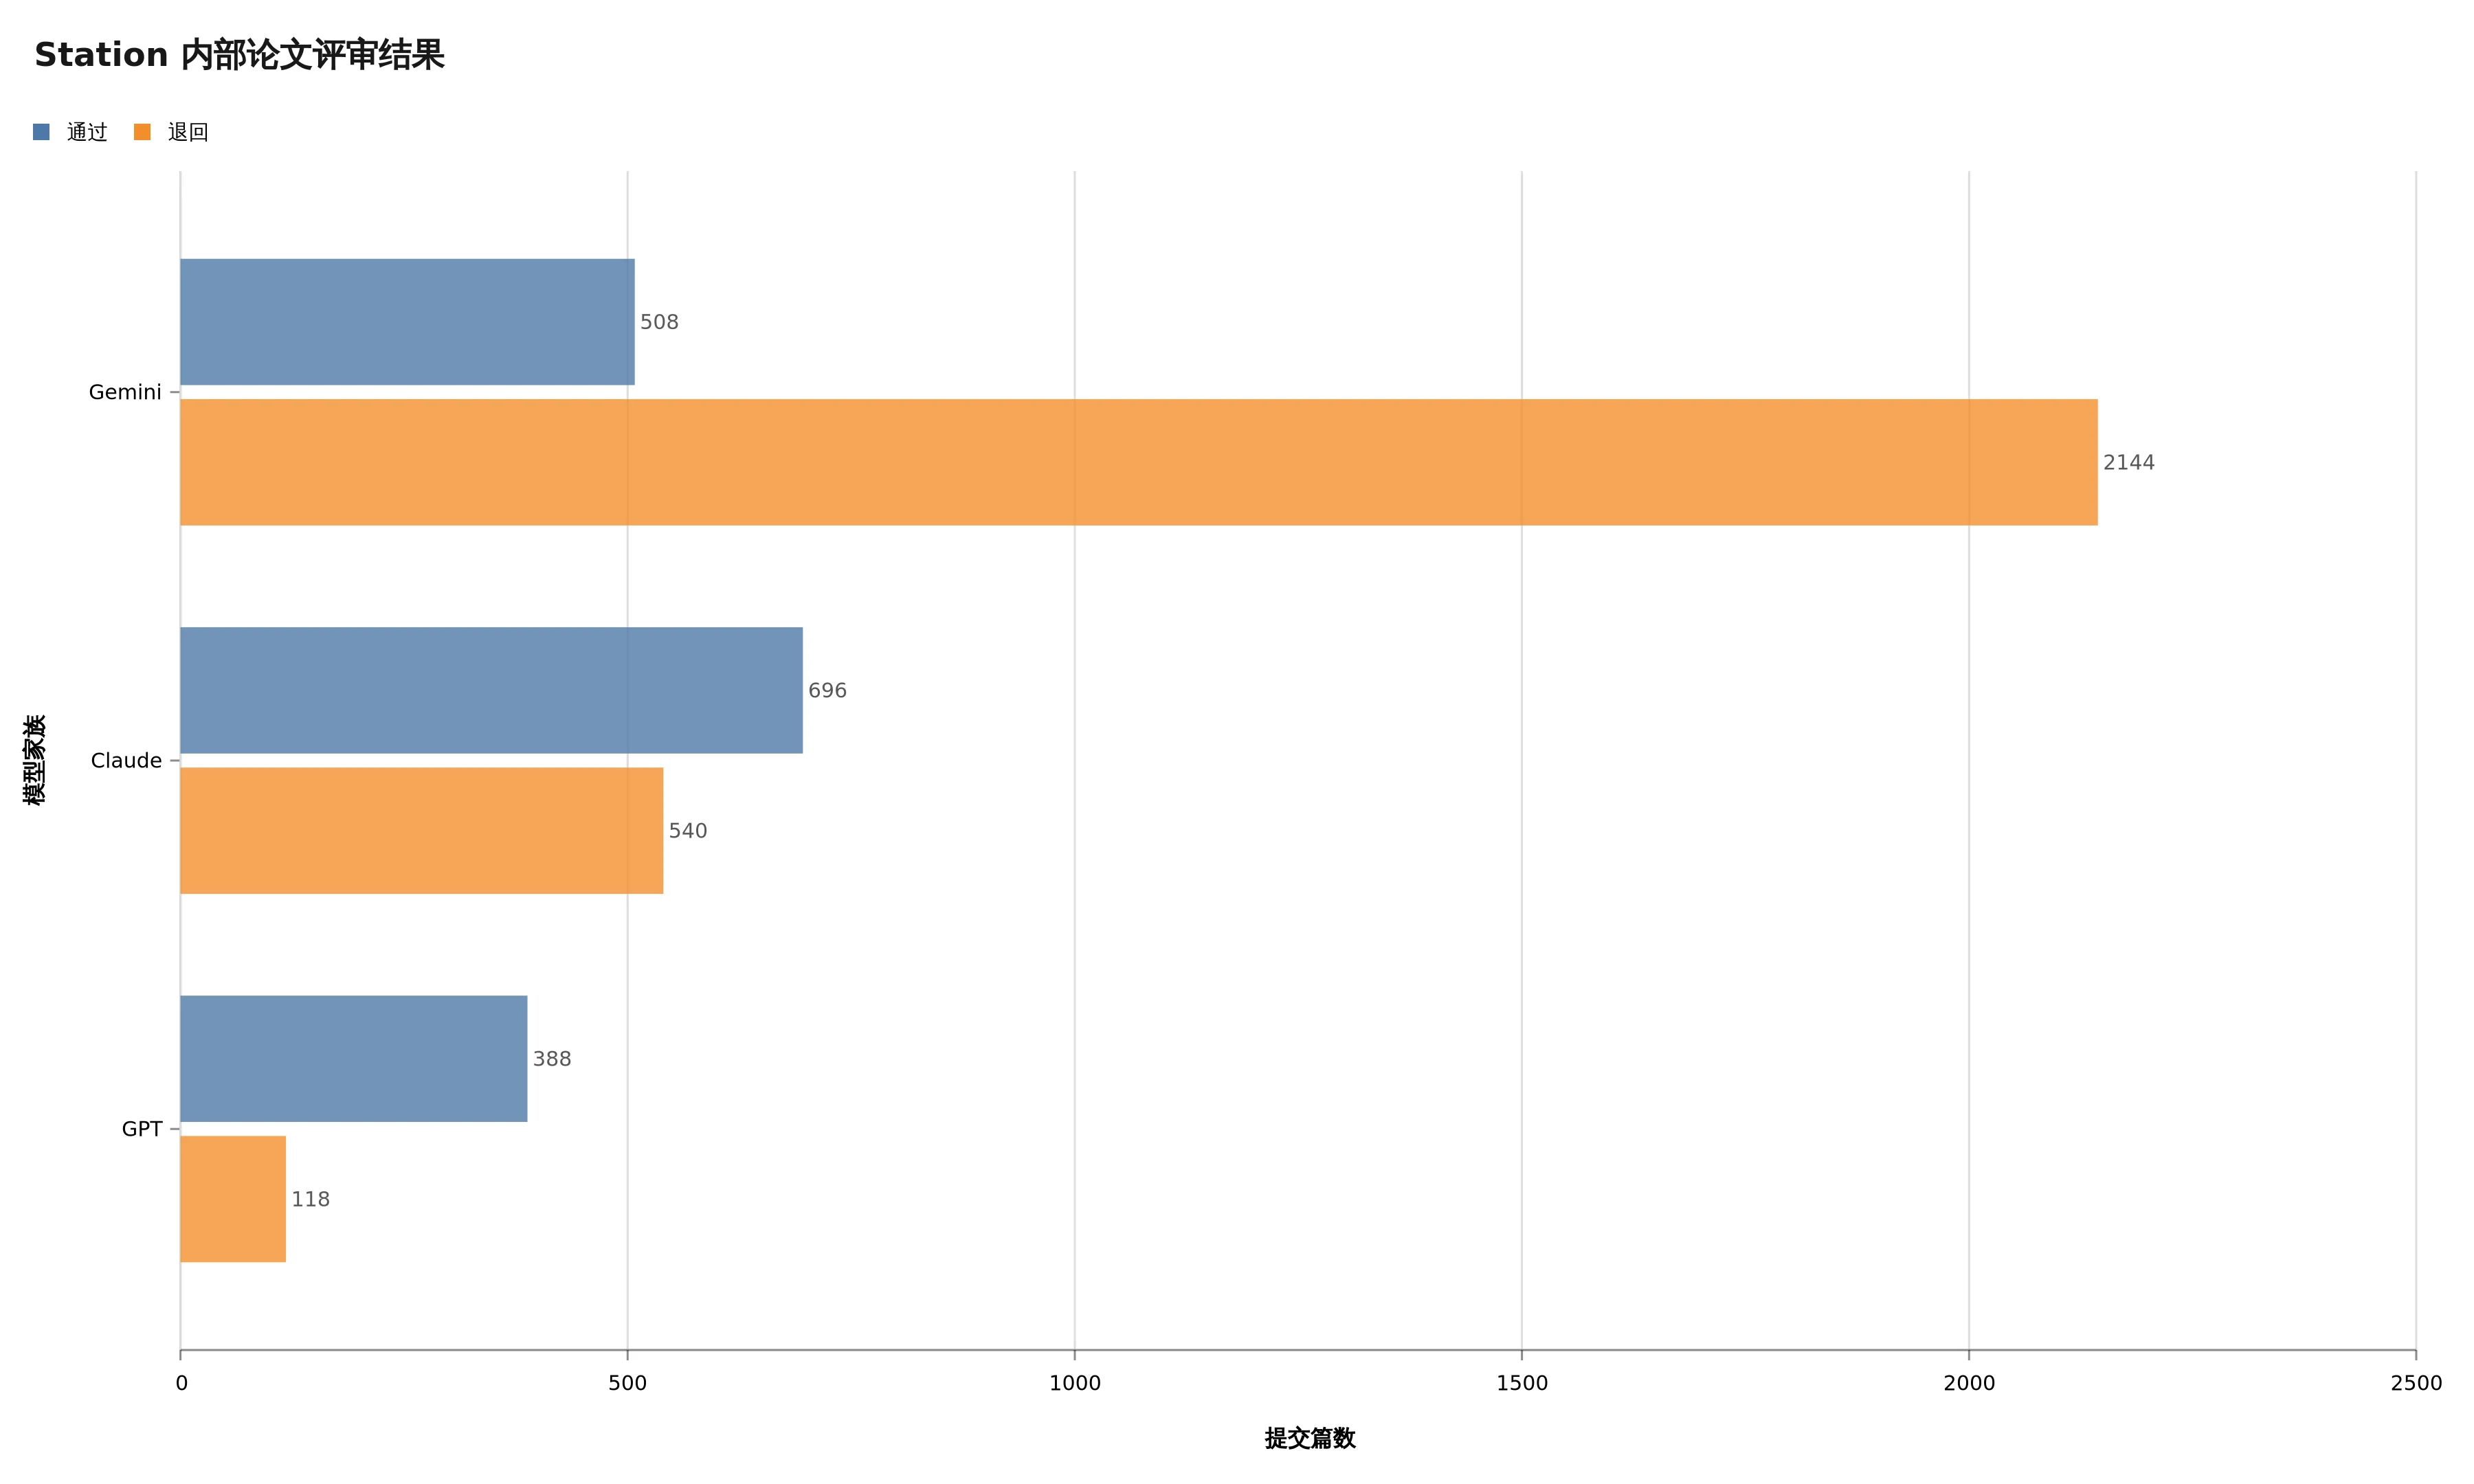
厉害了,最大的论文生产者,同时也是最大的退稿制造者。
作者的观察是,Gemini 更爱提出新启发式,也更容易用有限证据宣布某条路线不可能。GPT 更谨慎,常等材料比较扎实时才提交。Claude 更持久、自我批判,长文被后续引用得更多,但一样会写出错误结论,再由其他 Agent 纠正。
这些数字不能拿来做永久模型排名。模型版本会换,题型也有偏差。它们真正说明的是另一件事。
只要允许 Agent 自主发表,就必须同时允许系统大规模退稿。
Station 的源码里,Archive Room 不只是一个向量库。每次提交都要过独立 reviewer,检查严谨性、相对已有档案的新颖性、对当前目标有没有用,以及证据和引用是否完整。拒稿会带着意见退回,作者可以修,也可以换方向。
这跟常见的多 Agent 投票不太一样。
三个模型都说对,不代表对。三个模型也可能共享同一个误解。更稳的做法,是让 reviewer 面对明确的验收合同,检查证明、测试、引用和可复现产物,而不是数赞成票。
如果把它搬到软件团队,档案门禁可以很朴素。修 bug 的报告必须带最小复现和回归测试,架构建议必须指出改动面与失败模式,调研结论必须能点回一手来源。没有证据就不进长期记忆,只留在临时工作区。
反正我觉得,Agent 记忆最怕的不是忘。
是把错的东西记得太牢。
真正的自治,不是把调度器删掉
论文说 Station 没有中央协调器,很容易被读成一句营销口号。
顺着 官方项目页 和附录往下看,会发现它的自治并不松散。环境没有为每个 Agent 指定固定角色和下一步任务,但四周布满了护栏。
每个问题都有可执行 evaluator。Agent 提交构造,先拿机器可核验的分数。前 40 个 tick 隔离探索,避免所有 Agent 一开场就互相抄。内部论文要过 reviewer。长时间不进步会触发 stagnation protocol,把 Agent 分到探索、利用、复活、理解、策略等不同车道。每 10 个 tick 还有两次强制 holiday,暂停跑代码和交论文,只做反思与跨领域联想。
更有点子牛逼的是 multistart。
它会从同一个状态并行跑 8 个 40-tick 分支,再让管理员选科学价值最高的一支继续。发现路径方差最大的地方,不把希望压在一条单线上,直接用多个起点对冲。
所以没有中央调度器,不等于没有治理。
它只是把调度从「你下一步必须做什么」,改成了「你可以自己选,但提交格式、证据门槛、停滞处理和资源边界都写清楚」。Agent 拥有路线自由,环境保留验收权。
这个区别很关键。
不少 Agent 团队为了追求自治,把 planner 删了,把几个模型丢进群聊,常常得到一锅并发噪声。Station 提供的是另一条路。少管研究方向,多管状态迁移;少写角色台词,多写 evaluator;少保存完整对话,多保存经过评审的工件。
自治不是没人管。
自治是把该管的东西换了位置。
5 道新结果,也没有抹掉失败账
如果只看「12 道题里 5 道刷新文献」,这篇很容易被写成 AI 数学家接管研究的预告片。
论文自己踩了刹车。
剩下 7 道题里,Station 只在 3 道超过 AlphaEvolve,2 道持平,2 道更差。峰值自卷积和平坦自卷积更奖励长期、大规模、没有漂亮结构的数值搜索,这类问题上 AlphaEvolve 更强。Station 偏爱理论引导的构造,能把数值结果继续整理成定理和可解释结构,但这种偏好并非处处占优。
11 维接吻数任务独立跑了三次,三次最终都到 604 点,可路径和耗时差异很大。一个实例从格点核心周围的离散直线打包进去,一个从根系结构拼出来,另一个从 601 点构造变形过去。
同一个答案,三条路。
这既是好消息,也是成本警告。结果可复现,不等于单次轨迹稳定。论文直接建议,计算预算允许时,同一个问题最好跑多个独立实例。
另外,作者列出的四个边界也挺扎眼。Agent 缺少专家直觉,会因为薄弱理由放弃好路线;同一家模型的研究品味容易趋同;档案变大后,上下文未必吸收得动;高度自治还会掉进 attractor trap,反复换随机种子、研究局部最优,把忙碌误当进展。
看到这里,那个 5 比 12 的数字反而更可信了。
它没有假装每道题都赢,也没有把独立重发现涂成全新突破。公开验证仓库保留了原始对话、证明和 notebook,外部研究者可以沿着证据往回走。人类专家仍负责检查证明有效性和新颖性,论文也明确说轻量指导很可能有益。
能把失败账一起公开,才有资格谈成功率。
普通 Agent 团队,先抄这四层
屏幕前如果也在做多 Agent,不需要先搭一座科研小镇。
先把任务改成一份 evaluator 能读的合同。代码任务写清测试、静态检查、性能或回归边界;调研任务写清一手来源比例、可证伪条件和禁止下结论的证据缺口。Agent 可以自由找路,验收别靠语气。
再把临时消息和长期知识分开。群聊、工具响应和原始日志放工作区,通过门禁的结论、失败路线和复现步骤才进档案。档案里的每条判断都要能指回代码、数据或来源。
然后给停滞一个确定动作。连续几轮没有改善,不要只把同一句 prompt 再发一遍。换目标分解、换模型家族、回看失败档案,或者并行开几个不同起点。Station 在 320 个 tick 没有前沿改善时触发分车道重启,这个数字不能照抄,触发机制可以。
还有一层,把人工放在高杠杆位置。人不必盯每一步工具调用,但要守住 evaluator、档案准入、新颖性核验和资源预算。让 Agent 自己探索,让人决定什么能进入组织记忆。
这四层不浪漫。
甚至有点像资料管理员、测试工程师和成本会计一起开会。可多 Agent 真想从 demo 走到长期运行,缺的恰好就是这些脏活。
Station 最漂亮的地方,不是六个模型在一间虚拟研究所里互相启发。
是第一个 Agent 离开很久以后,它留下的半个证明、一次失败和一份可复现记录,还能被后来者接着用。
海上不缺一起喊口号的船。
缺的是能让下一班人看懂的航海日志。