posts/suno-v6-music-brief.md
一首 BGM 改一句歌词,Suno v6 不用再整首重抽
给视频改 BGM,最烦的不是没有灵感。
是你已经有一首八成对的歌了。鼓点能用,氛围也对,偏偏副歌的人声太满,或者一句歌词跟画面撞车。以前的解法很朴素,重新抽一首,祈祷这次别把已经对的部分一起抽没。
Suno v6 这次值得看的地方,就卡在这个返工动作上。它把「只改一段」「只换一句歌词」「从几首歌里各拿一点元素」放进了同一套工作流。对做短视频、播客片头、产品 Demo 配乐的人来说,这比又多一个版本号实在得多。
好家伙,终于不用每次都把一首歌送回抽奖箱。
Suno 在 v6 的官方公告 里,把新一代模型拆成了三个方向。旗舰 v6 负责稳定和完成度,v6-wild 负责故意跑远一点找意外,v6-mini 则给所有套餐开放,负责快速把一个念头变成可听的草稿。官方帮助中心还写得更直白,三者单次都可生成最长八分钟,mini 就是给高频试方向用的。
配 BGM 这件事,终于有点像剪视频了。
不是上来就点一次生成,然后盯着进度条等命运发牌。更像先剪粗片,再找节奏,再去收细节。模型的分工不该按「哪个最强」来理解,而该按你现在到底缺什么来分。
先把方向跑出来
如果你还在找配乐方向,别急着把最贵、最稳定的模型叫过来。
这一步的目标不是成品,是尽快回答几个小问题。这个视频该更轻快还是更压抑。人声进来会不会抢旁白。爵士鼓和合成器谁更贴那段转场。你需要的是速度和样本量,不是一次就把每个小节都打磨平整。
Suno 对 v6-mini 的官方定位正好落在这里,轻量、快速,面向频繁生成和探索概念。一个实用做法是,先固定画面和情绪,再只改一个变量。比如第一轮只试节奏,第二轮只试人声是否出现,第三轮才试乐器。这样每次听到的变化才有归因,不会变成一堆文件名里全是 final、final2、final 真的最后版。
可以从这种提示词开始,重点不是文采,而是把画面、速度和禁区交代干净。
90 秒产品演示配乐
前 20 秒克制的电子氛围
中段加入轻快的断拍鼓点
不要人声,不要突兀的高潮
结尾留出两秒收束给旁白
这只是一个方向稿,不承诺会直接生成可用成品。它的价值是让你很快听见「这条路不对」还是「这个鼓点可以继续聊」。很多返工并不是模型不够好,而是我们太早把探索和交付混成了一个任务。
想要意外,就让 v6-wild 去跑偏
做内容的人有时需要的不是准确,而是一个本来想不到的拐弯。
Suno 把 v6-wild 描述成更不可预测、更有变化的模型。这听起来像营销词,放在 BGM 工作流里反而挺好理解。你已经知道主题大概是什么,却还没找到那个让片子突然活过来的音色、节奏或结构,这时让它多跑几次,比让旗舰模型立刻收敛更合适。
不过要把它当草图本,不要当交付机器。
一段 wild 生成里,可能只有八秒值得留下。那八秒也够了。它可能是一种鼓组进场方式,一段你原先没考虑的人声质感,或一个刚好能把转场拉起来的停顿。把这个发现带回后续提示词里,才是 v6-wild 的正确打开方式。
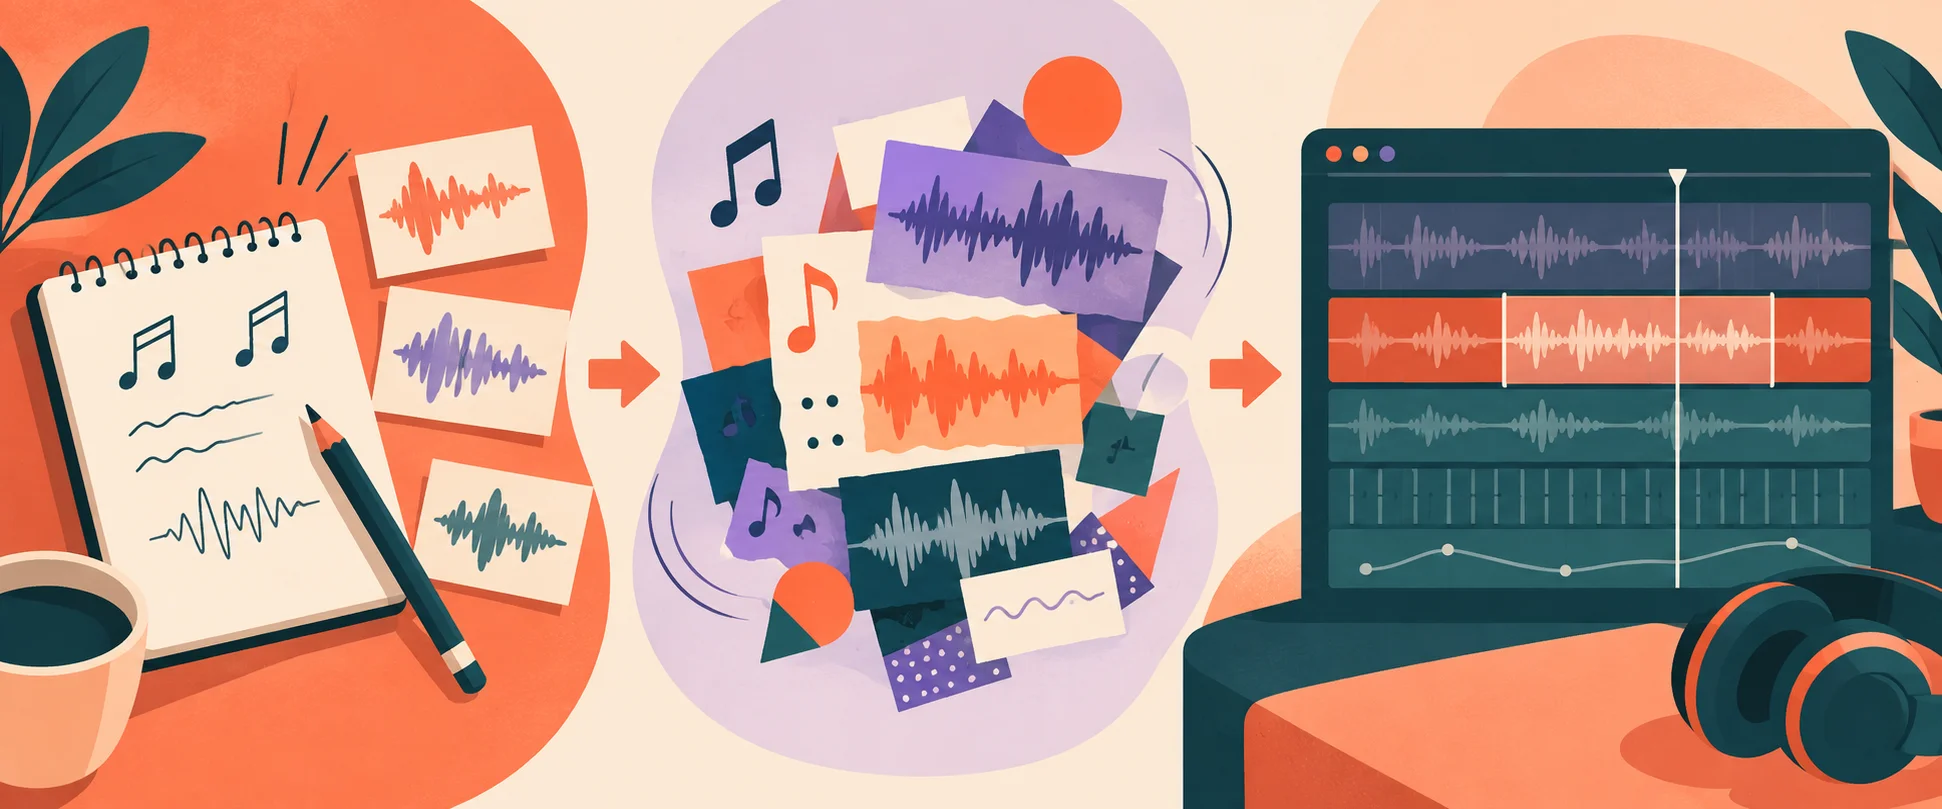
这里有个很小但很管用的习惯,听草稿时别只写「好听」或「不行」。记下具体位置和具体原因,比如「00 分 18 秒的低频能接片头」「00 分 42 秒人声遮住了旁白」「结尾太满,没有留给字幕」。后面无论继续提示还是进编辑,都会少很多鸡同鸭讲。
到了收成品,再叫旗舰 v6
当你已经知道要什么,v6 才该上场。
官方把它定位为更稳定、更精准的旗舰模型,面向 Pro 和 Premier 用户。这个阶段的任务也换了,不是再问「能不能给我点惊喜」,而是把已选的方向收紧。鼓点别抢旁白。副歌在转场后再出现。结尾别盖住口播。一个视频真正上线前,往往就是这些不显眼的地方最磨人。
v6 提供的局部编辑,正好切开了以前最笨重的环节。官方举的例子包括保留其余内容只改一个段落,或只改一句歌词。它也支持从多份素材里组合元素,以及围绕指定采样片段做新的节拍。对于已有一首接近可用的配乐,这不是锦上添花,是把返工范围从整首歌缩到一个明确片段。
但别把「可局部改」理解成「不用听」。模型能保留什么、改坏什么,依旧要人耳朵来判。尤其是有旁白的片子,至少要过三遍。戴耳机听一次结构和爆音。用手机外放听一次人声是否挤在一起。把旁白叠进去再听一次,确认音乐没有把信息吞掉。
有些边界,别假装不存在
Suno 这次还有另一层变化。官方说 v6 与 Warner Music Group、BMG、Believe 等行业伙伴共同开发,并在上传音频和歌词上增加筛查,同时探索由艺术家自愿参与、可获得报酬的体验。
这不等于你可以拿任何歌去复刻,更不等于每种使用场景都自动安全。平台规则、素材授权、商用渠道和地区限制,仍然得在项目上线前自己确认。这里没有什么神奇通行证,棒棒的工具也替不了最后那一步判断。
还有一件事也得讲清。本篇没有亲自跑 v6 的对照测试,模型的实际听感、中文咬字和不同套餐的可用性,都应该以你账户里当下能看到的功能和官方说明为准。它的价值在于给你一条更省返工的试法,不是替你宣布哪一代音质稳赢。
如果你的素材库里已经躺着一堆「差一点就能用」的配乐,下一次别急着整首重抽。先用 mini 把方向摊开,用 wild 捡意外,再让 v6 收细节。配乐不是一次抽卡,终于可以有一点编辑的秩序了。
你做视频或产品 Demo 时,最想先交给 AI 改掉的是哪一步,找方向、局部返工,还是最后那一遍和旁白的对齐?