posts/terminal-bench-science-agent-eval.md
科研 Agent 最强只做对 30%,别只怪模型
70 道题,当前最强的科研 Agent,只完整做对了 30%。
不是拿冷门知识刁难模型,也不是让它背论文作者和发表年份。这 70 道题来自科研人员真正会做的工作,包括统计推断、科学仿真、定理证明、图像重建、信号处理、传感器校准、模型拟合,还有一堆跑起来会让终端风扇开始认真上班的计算任务。
好家伙,模型在普通聊天里已经能把量子力学讲出三种版本,进了科研工作流,七成任务还是交不了卷。
这套新 benchmark 叫 Terminal-Bench-Science 0.1,由斯坦福研究者牵头,Terminal-Bench 和 Harbor 团队联合全球多个学科的专家做出来。它在 8 月 28 日进入公开讨论后,我觉得最值得看的并不是谁排第一。
真正扎心的是,它把我们平时聊 Agent 时经常混在一起的几件事,硬生生拆开了。
模型会不会推理,是一件事。
Agent 能不能在终端里把活干完,是另一件事。
后者难多了。
30% 不是知识分,是交付分
官方榜单里,Claude Opus 5 配 Claude Code 的解决率是 30.0%,GPT-5.6 Sol 配 Codex 是 22.4%,Claude Fable 5 配 Claude Code 是 21.4%。再往下,Claude Opus 4.8 是 10.5%,GPT-5.6 Terra 是 8.6%,GLM 5.3 是 8.1%,Kimi K3 和 Grok 4.6 都是 7.1%,GPT-5.6 Luna 只有 3.3%。
这里有个很容易被忽略的细节。
榜单写的不是孤零零的模型名,而是模型加运行外壳。Opus 5 后面跟着 Claude Code,GPT-5.6 后面跟着 Codex,Grok 4.6 后面跟着 Grok Build。
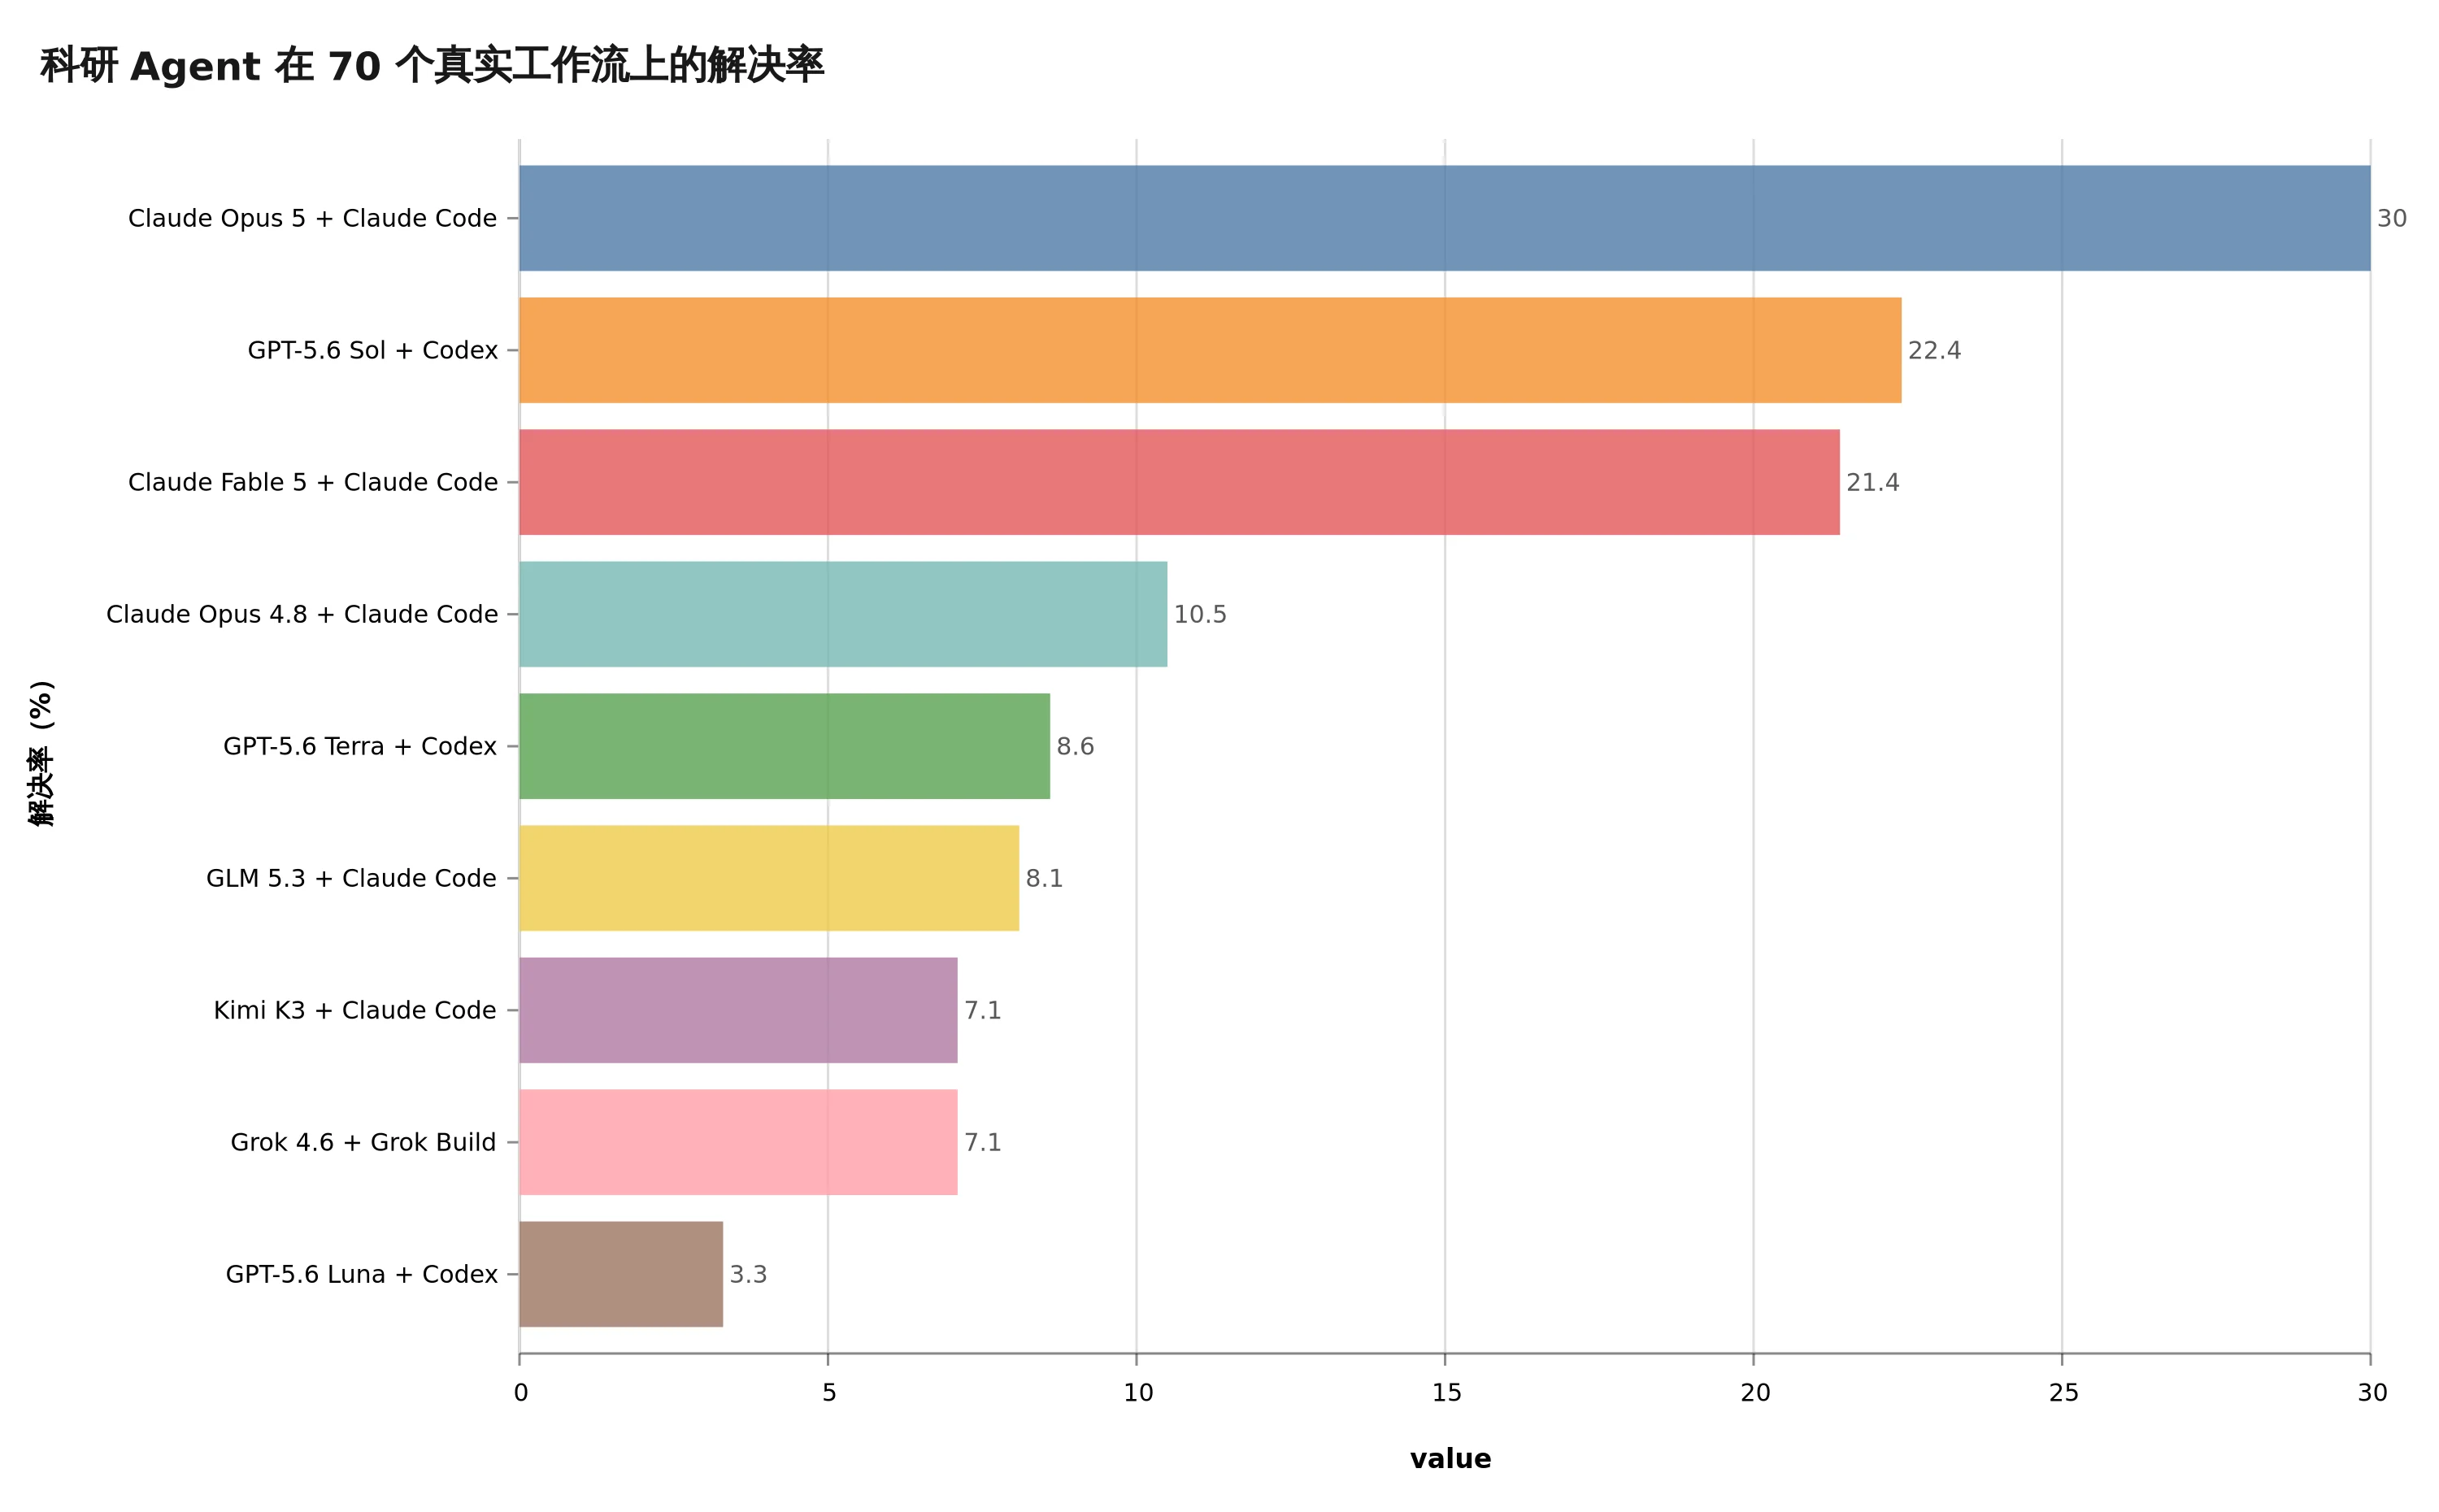
同一场考试,真正被评的是模型与运行外壳组成的完整系统。
这才是 Agent 的真实样子。模型只是发动机,harness 是让模型真正干活的那层脚手架,包括工具描述、终端权限、文件系统、上下文管理、重试策略、停止条件和产物回收。你换一层脚手架,同一个模型可能就不是同一个系统了。
很多产品评测喜欢给模型一段题目,等它吐出一段文字,再用另一个模型判断回答像不像。省事,便宜,几十分钟能画出一张漂亮的柱状图。
科研工作不是这么交付的。
一个 Agent 说「仿真已经完成」,不算完成。它得真的把代码跑起来,生成目标文件,参数和单位得对,输出要能被检验。它说「证明成立」也不算,证明对象、推导过程和可验证产物都得留下。它做数据分析,不是写一段看起来很专业的结论,而是要交出分析、代码和数据产品,让任务专属测试去检查。
这一下,语言模型最擅长的那层表面流畅就不太管用了。
空口交作业,零分。
我一直觉得,Agent 评测最危险的假阳性不是它报错,而是它用非常笃定的语气宣布成功,实际上文件没生成、命令半路退出、单位换错了,或者测试只跑了最简单的那个 case。终端里那句 exit 0 有时候比五百字解释更诚实,可惜模型并不天然尊重它。
Terminal-Bench-Science 做对的一件事,就是把评分对象从「回答」换成「产物」。官方明确写了,任务会检查分析、仿真、证明、代码和数据产品,并用可复现的任务级测试来打分。
别小看这个改动。
当评测盯住产物,模型就不能只学会像专家说话,它还得学会像一个靠谱同事那样收尾。
70 道题背后,淘汰了 850 个好想法
这套 benchmark 的另一个数字更有意思。
项目一共收到 920 个任务提案,464 个获准实现,后来形成 386 个 pull request,最终进入 0.1 版的只有 70 个。接受率 7.6%。整个过程有来自 22 个国家的 376 名贡献者参与提案、评审或代码提交,进度还放在公开 dashboard上。
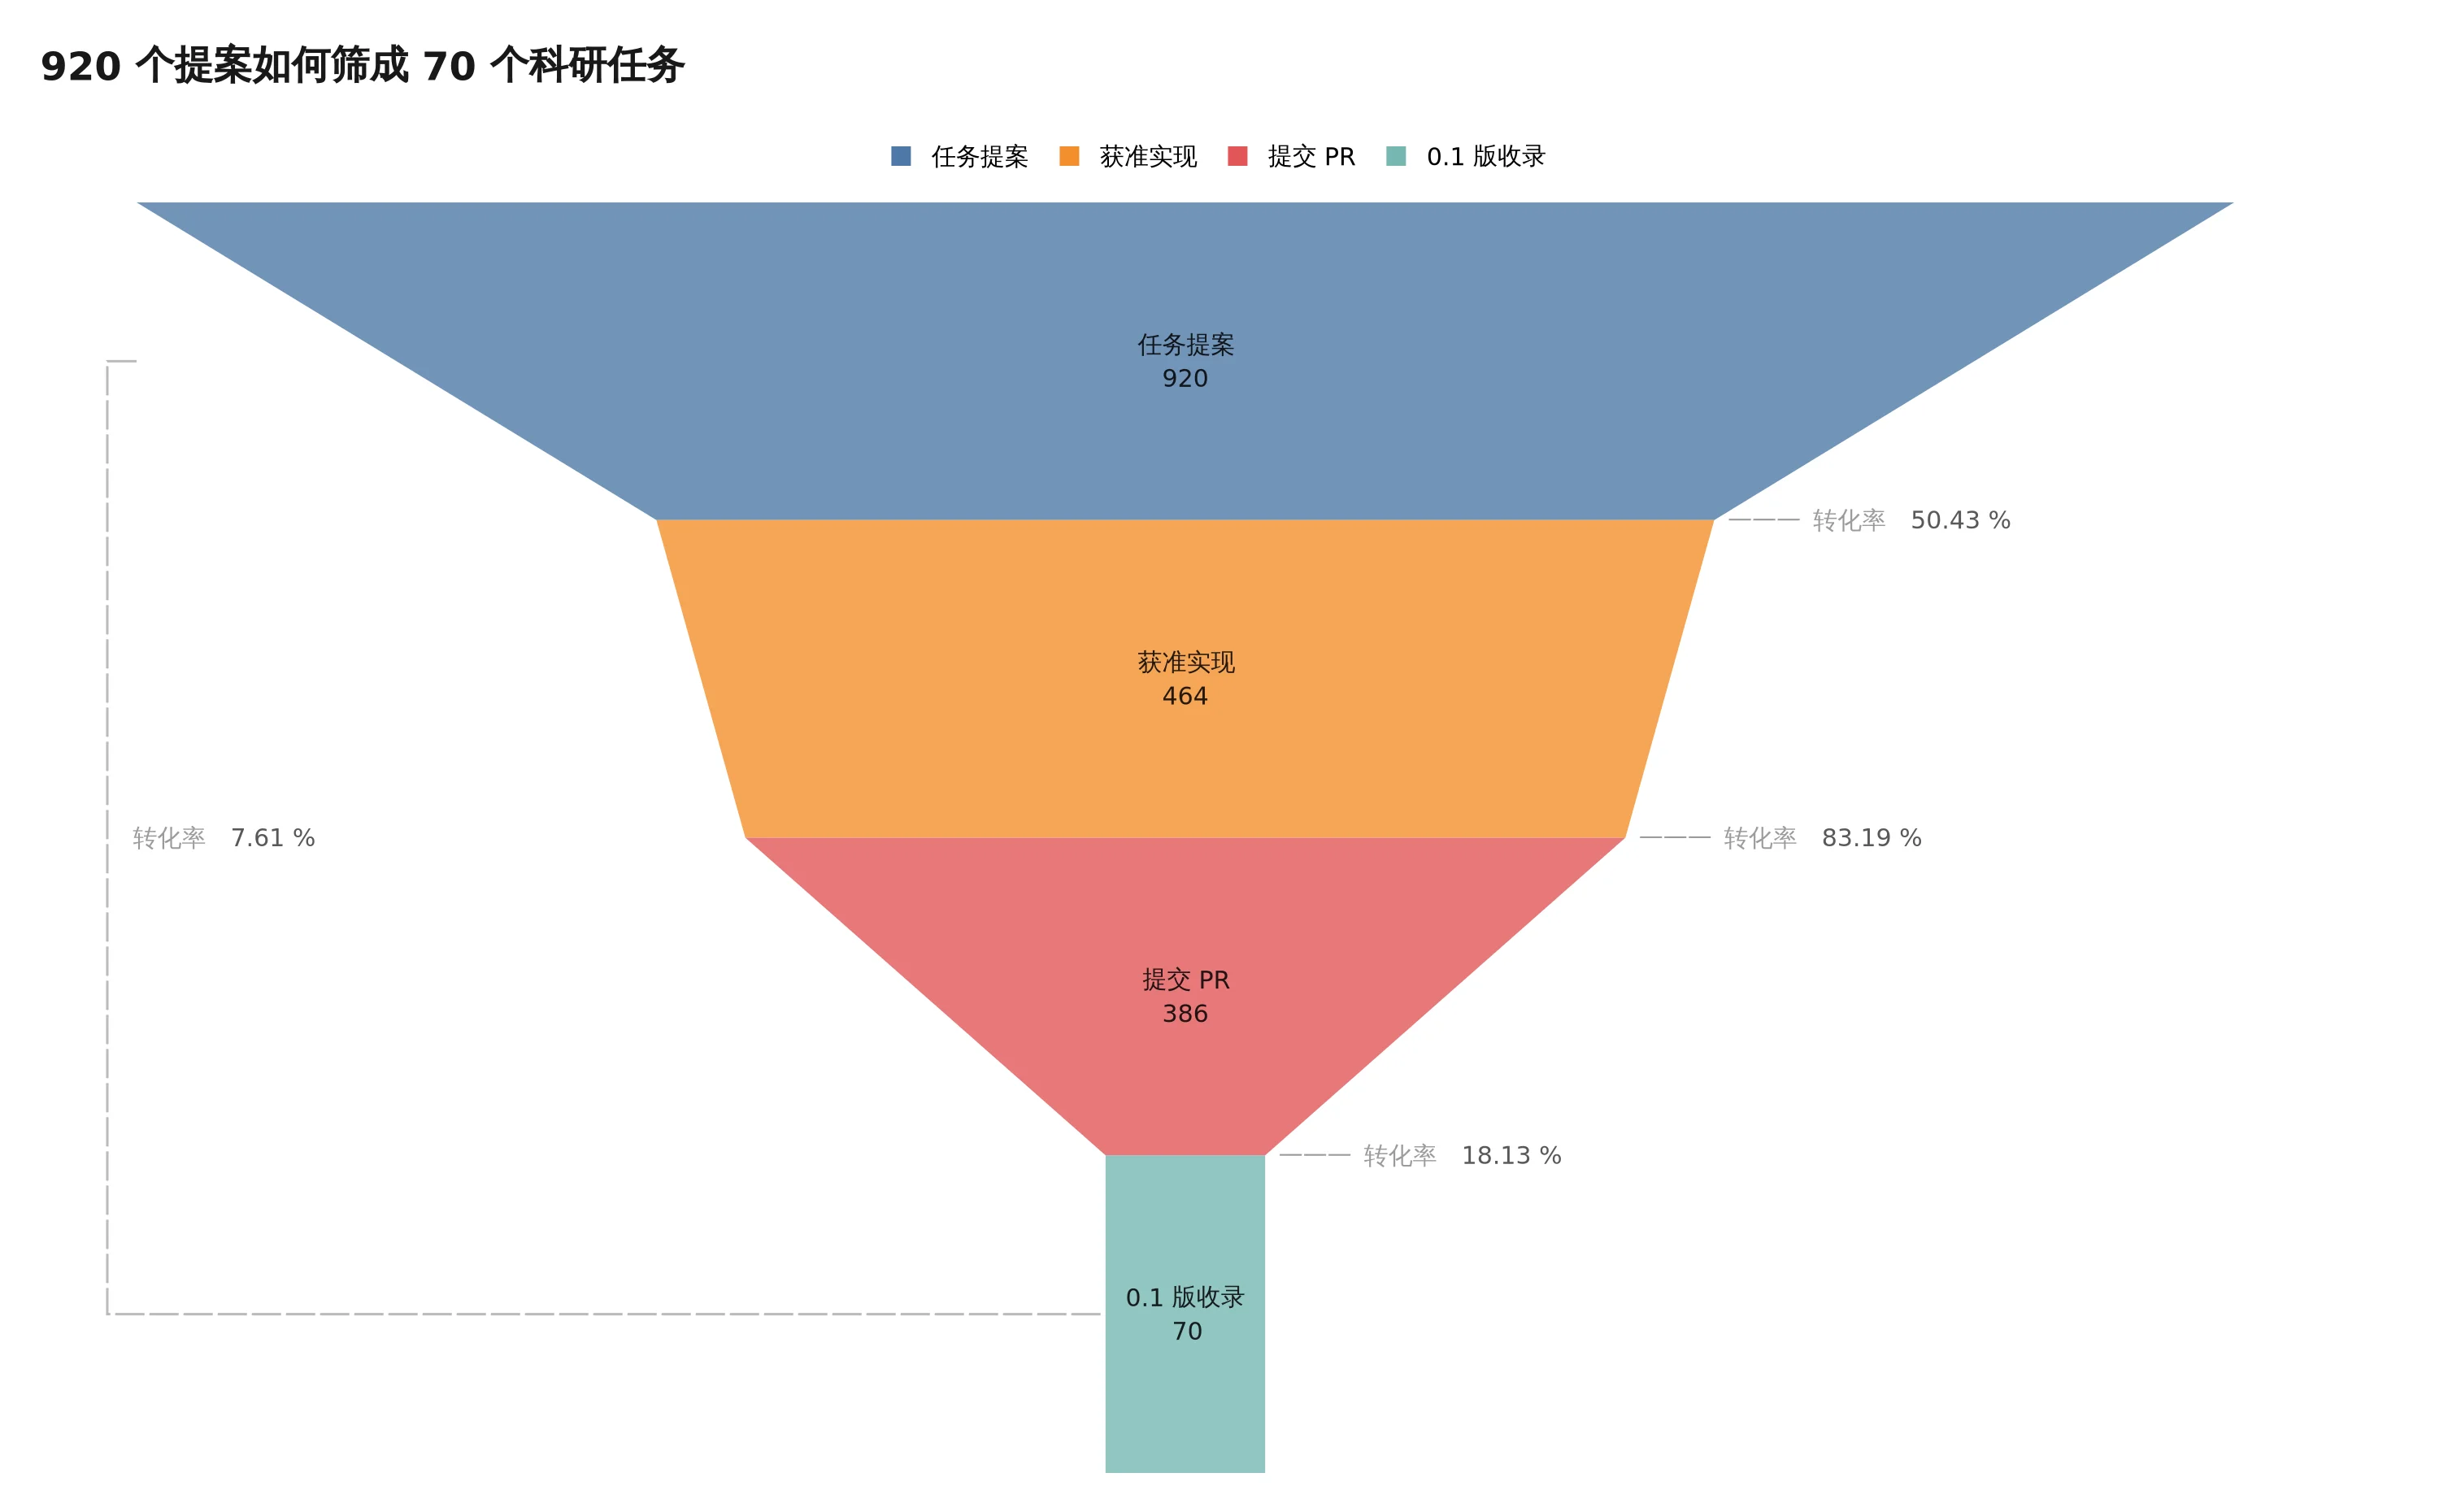
能自动验收、够真实、还得难住前沿系统,最后只留下 7.6%。
厉害了,做 benchmark 的任务筛选,比不少会议收论文还狠。
为什么要砍掉这么多?
因为一道「看起来很难」的题,离一道能评 Agent 的题还差很远。
任务得来自真实科研工作,不能只是把考试题换个皮。验收条件得客观,不能依赖评委看完后凭感觉点头。当前最强系统还不能轻松刷满,不然刚发布就失去区分度。环境还得可复现,依赖、数据、脚本和 grader 都要经得住别人重新跑。
这几个条件放在一起,很多漂亮想法会原地段错误。
有些题科学上很重要,却很难自动验收。有些题能自动验收,却只是在测模型会不会猜固定格式。还有些题本来不错,环境里一个没锁版本的依赖,就能让排行榜从能力评测变成运气抽奖。
做过 Agent 评测的人大概会心一笑。写任务说明不难,真正难的是把「做完」定义到没有歧义。
一个常见的内部评测,会先写 prompt,再拿若干输出人工挑好坏。顺序听着合理,坑也埋得很稳。因为当你看过输出后,验收规则很容易不知不觉向现有模型靠拢。模型做出来的就叫合理,没做出来的就被解释成题目太刁钻。
更稳的顺序应该反过来。
先定义交付物和 grader,再给 Agent 任务。先写清文件名、格式、允许误差、必跑测试、禁止访问的资源和失败状态,再讨论 prompt 怎么写。模型换了,工具链换了,验收合同不动。
这不只适用于科研。
让 Agent 修 bug,别只看它回复「已修复」,要跑测试并检查 diff。让 Agent 做数据报表,别只看最终数字,要校验查询、时间窗和来源。让 Agent 改配置,别只看 YAML 能解析,要检查服务能否启动、回滚是否可用、敏感字段有没有被带进日志。
听着没什么魔法,对吧?
棒棒的,真正可靠的系统往往就是这些不性感的合同堆起来的。
同样的分数,可能烧掉三倍的钱
排行榜如果只看解决率,还会漏掉一半故事。
官方把 70 个任务全部跑完后,Claude Opus 5 的总评测成本约为 7000 美元。GPT-5.6 Sol 和 Claude Fable 5 的解决率接近,一个是 22.4%,一个是 21.4%,但成本约为 4200 美元和 14200 美元。Sol 不到 Fable 5 的三分之一。
然后事情又拐了一下。
看 Token,Fable 5 大约用了 64 亿,Sol 大约用了 84 亿。Fable 5 少用约四分之一 Token,总费用却高得多。
就这组数据,已经够把「少用 Token 就更省钱」这句经验打出一个大洞。模型单价、缓存命中、工具调用方式、上下文重复、失败后的重跑,都会改变最终账单。Token 是资源计量,不是财务结论。
有点子牛逼的是,官方没有硬凑一个总分,而是分别画了解决率与成本、解决率与 Token 的 Pareto 前沿。所谓 Pareto 前沿,用人话讲就是,站在这条线上的系统,想再提高解决率,通常就得多花钱或多吃 Token,没有一个别的系统能在两边同时碾压它。
只有 Kimi K3 和 Opus 5 同时出现在两条前沿上。一个守住低 Token 端,一个守住高解决率端。中间那些模型,各自都在用不同方式换结果。
这对生产系统很重要。你真正要问的不是「哪个模型第一」,而是「在我的预算和时延里,哪个系统能交付最多合格产物」。
假如任务价值只有几十元,用一百多元的重型路径跑出 5% 的成功率提升,商业上可能是负分。反过来,一次失败会浪费研究人员半天的任务,多花几十元买更稳的模型和更好的失败恢复,反而便宜。
单价表回答不了这个问题。
你得把模型费、工具费、重试次数、人工复核时间和失败代价放进同一张表。然后盯的指标也别只剩平均分,至少要看有效交付率、每个成功任务成本、P95 完成时间和不可恢复失败比例。
平均值会把惨案熨平,P95 才会把凌晨告警还给你。
学科换了,赢家也会换
Terminal-Bench-Science 覆盖生命、物理、地球、数学和工程五类科学任务。总榜第一的 Opus 5,并没有在每个领域都第一。
数学科学里,Fable 5 的解决率是 33.3%,GPT-5.6 Sol 是 31.4%,都压过了 Opus 5。工程科学里,Grok 4.6 用更低的成本和 Token,做到 14.8%,与 Sol 并列第二。
这个结果很像真实的 Agent 路由问题。
一个模型擅长形式推理,不代表它在长时间仿真和文件操作上同样稳。一个模型总榜靠前,不代表它适合每一种工具链。模型和任务之间的适配,常常比排行榜上那几个百分点更有价值。
所以生产里的模型路由,不该只按「简单任务用便宜模型,难题用最贵模型」这么粗地切。更有用的做法,是按任务家族积累证据。
代码修复看测试通过率和回归风险,资料检索看引用覆盖与事实核验,数据分析看查询正确率和产物可复现性,浏览器任务看状态恢复和错误点击成本。跑上几十次,你会得到自己的领域榜单。
公开 leaderboard 是海图,不是自动驾驶。
屏幕前如果正在搭 Agent,可以顺手检查一件小事。你的 eval 到底是在评模型说了什么,还是在评系统留下了什么?前者很容易做得热闹,后者才接近用户付钱买的结果。
科研只是把生产事故提前演了一遍
我喜欢这套 benchmark,不是因为它又多了一张模型榜单,而是它把 Agent 的工程现实写得很直白。
最强系统只有 30%,不等于模型突然变笨了。任务从问答变成真实工作流以后,所有平时被 demo 藏起来的东西都开始收费。环境会坏,工具会误用,上下文会丢,命令会超时,文件会生成到错误目录,结果会缺证据,重试还会把账单再抄一遍。
科研任务只是把这些问题放大了。普通公司的 Agent 一样逃不掉。
一个能写出正确答案的模型,离一个能稳定交付的系统,中间隔着任务定义、运行环境、验证器、观测、预算、重试和人工接管。每一层都不新鲜,叠在一起却足以让 90 分的模型交出 30 分的作业。
这话听着有点刺耳,但它也是好消息。
因为剩下的 70%,并不全要等下一代模型来救。把输出改成可验证产物,把环境锁住,把失败状态暴露出来,把重试设上限,把成本和 Token 一起记账,把不同任务路由给真正擅长的系统,今天就能拿回一部分成功率。
Terminal-Bench-Science 的 GitHub 仓库把任务和贡献流程都公开了,Harbor Hub保留排行榜和 trial。团队还准备持续加入新任务,淘汰已经被刷满或描述不够严谨的旧任务。
这也是我觉得它比一次性跑分更靠谱的地方。真正有用的评测,不是一块刻完数字就立起来的碑,而是一套跟着系统一起变的故障手册。
海图不会替你开船,但它至少会把暗礁画出来。
30% 不是终点。
它是第一张终于肯承认海上有风的成绩单。