posts/thomson-domain-model-economics.md
Thomson 最贵的东西,不在 GPU 里
4000 万美元。
在大模型发布稿里,这个数字甚至显得有点克制。训练前沿模型的故事,早就被讲成了几十亿美元的算力、成片的数据中心和一眼望不到头的 GPU 机架。结果 Thomson Reuters 在 8 月 24 日发布 Thomson,说自己从一个开源权重底座出发,花 4000 万美元,把模型做到了法律专业任务的前沿水平。
好家伙,像是别人还在讨论怎么买更多铲子,它已经把矿山、地质师和验矿标准一起装进了系统。
但这篇如果只写成「小成本挑战大厂」,就把最值钱的部分写没了。4000 万美元只是能被新闻标题抓住的明面账单。真正难抄的是另外三样东西,175 年积累的专业内容,知道什么叫正确的领域专家,以及一套能把专家分歧变成训练信号的评测系统。
Thomson 买的不是一个更会背法条的模型,而是一份可以被生产环境验收的责任合同。
这个角度对做企业 AI 的人挺重要。不是因为每家公司都该去训练模型,恰恰相反,大多数公司看到这里应该先把训练集群的采购单收起来。先看看自己手里到底有没有那几样更稀缺的东西。
内容很多,不等于有训练数据
Thomson Reuters 手里有什么,Westlaw、Practical Law、Checkpoint、Reuters News,还有横跨法律、税务、会计和新闻的 175 年内容资产。
听起来像把这些文档塞进对象存储,再跑一次继续预训练就完事了,对吧。
真这么干,大概率会得到一个昂贵的文本搅拌机。
研究团队在构建复盘里写得很直接。内容要先被发现,要核对使用权,要判断哪一部分真的能改变模型表现,然后还要清洗、结构化、去重,放进合适的数据混合比例。到目前为止,他们用于持续预训练的内容还不到全部资产的 10%。
这个「不到 10%」很有意思。
它不是一句「我们还有九成弹药」那么简单。它也在提醒我们,数据价值从来不按 TB 计价。一个目录里放着十万份合同,不代表你知道哪一条条款决定了真实风险,更不代表模型能从中学会什么时候该提醒、什么时候不该浪费律师的注意力。
官方举了一个很细的例子。赔偿条款在多数商业协议里很重要,谈判也激烈,可放在保密协议里,它往往不是最该优先处理的风险。只读过法律教材的模型可能识别出了条款,却把注意力排错了。法律上没看错,工作上还是添乱。
这和写 Agent 很像。工具调用成功返回 200,不代表任务做对了。模型找到了文件,不代表找到了该改的文件。单测全绿,也可能只是测了一个没人会走的 happy path。
所以,专有内容真正的价值,不是让模型知道更多,而是让它学会在具体工作里怎样分配注意力。
这一步没法靠「多灌一点数据」糊过去。你得先拥有一群能说清楚为什么的人。
专家不是来写答案的
很多企业模型都爱说自己有专家参与。
这四个字听着稳,落到工程里却很容易变成一张合影,或者让业务同事随手给几百条回答点个赞踩。
Thomson 团队把这件事做得更笨,也更扎实。合伙人级从业者全职工作数月,给最难的法律研究任务写评分规则。一份真正合格的答案可能必须覆盖 15 个必要要素,一份看着像模像样的答案只覆盖了 9 个。规则不是写一句「准确、完整、有帮助」,而是把缺哪一项就不能过写清楚。
他们还投入了数千小时的合格律师时间,在具体客户立场、管辖区和事项阶段下比较模型输出。问题不是哪一份文笔更顺,而是哪一份真的能交给当前客户。
厉害的地方还在后面。
Thomson Reuters 约有 1500 名律师编辑。成稿当然能拿来训练,可团队认为更有价值的是成稿之前被删掉的东西。一个论点为什么收窄,一条依据为什么被放弃,哪种说法虽然成立却容易误导。这些判断通常不会留在最终文档里,却是专业能力最浓的部分。
做过代码评审的人应该能立刻懂。仓库里最值钱的不只是一批已经合并的 PR,还包括 reviewer 在评论里留下的拒绝理由。为什么这个缓存不能加,为什么这个重试会放大故障,为什么看着更优雅的抽象反而会让排障变慢。
成品告诉模型「最终长什么样」,拒绝记录才告诉模型「哪些路不能走」。
还有个更麻烦的问题,专家会互相不同意。
经验越丰富,判断往往越细。两个好律师对同一份回答打分不同,不一定有人错了,可能是他们各自带着一套精炼但没有说出口的标准。粗暴地把分数取平均,模型学到的就会是一种谁都不真正认可的模糊正确。
Thomson 的处理方式是校准标注者,持续测量一致性,把一致性下降当成任务定义不清的报警。分歧如果一直存在,就把它当成问题本身的一部分。这个做法有点子牛逼,因为它没有假装现实世界只有一个干净标签。
专家的价值不是替模型多写几份答案,而是把「什么叫做对」变成一套能反复执行的标准。
如果一家公司的业务专家只能说「这个答案感觉不太对」,却没法把不对拆成可检查的条件,那还没到训练自有模型的时候。先把 rubric,也就是逐项评分规则写出来,收益往往比买 GPU 更早出现。
跑分能看,签字线更要看
Thomson 产品页公开了一组很抢眼的数字。
它在 PrBench Legal Hard 上得到 0.352,页面列出的对比模型里最高。指令遵循综合项是 0.914,长上下文综合项是 0.753,也排在表格前面。在 Stanford LegalBench 上,它没有赢 Gemini 3.1 Pro。在编码综合项上只有 0.399,明显落后于 Claude Opus 4.8 的 0.598。
这组输赢反而比一张全绿表格可信一点。一个面向法律任务专门化的模型,编码没打过最强通用模型,很正常。要是法律、编程、数学、写作样样第一,我反而会先找评测脚本是不是把答案文件读进去了。
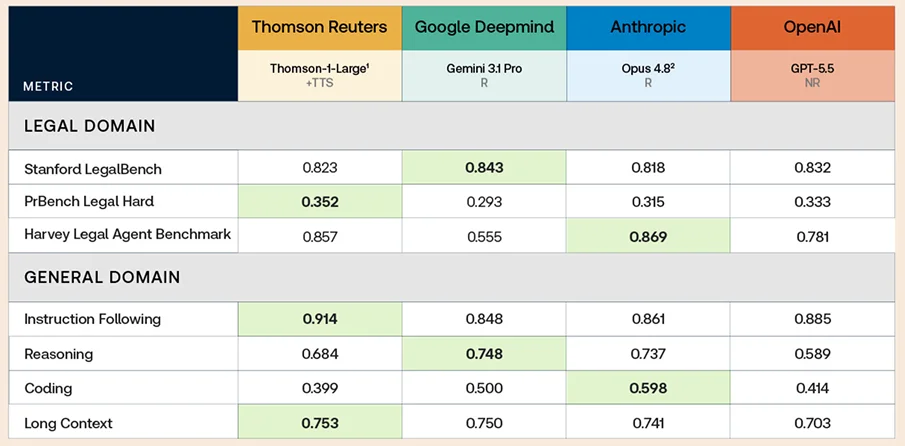
图表来自 Thomson Reuters 产品页,绿色标记每行最高分,属于厂商公布结果。
但这些依然是厂商自己公布的结果。部分长上下文分数包含内部基准,独立学术评测还在进行。该踩的刹车得踩,新闻稿里的「前沿水平」不能直接当采购验收报告。
真正让我觉得值得琢磨的,是他们把事实性和完整性拆开了。
在官方的深度研究评测里,Thomson 搭配 Westlaw 和 Practical Law 得到 0.83 的事实性分数,两款使用开放网页的领先通用模型分别是 0.65 和 0.68。完整性差距并不大,差别落在另一件更难的事上,每一条陈述,能不能被它自己给出的引用撑住。
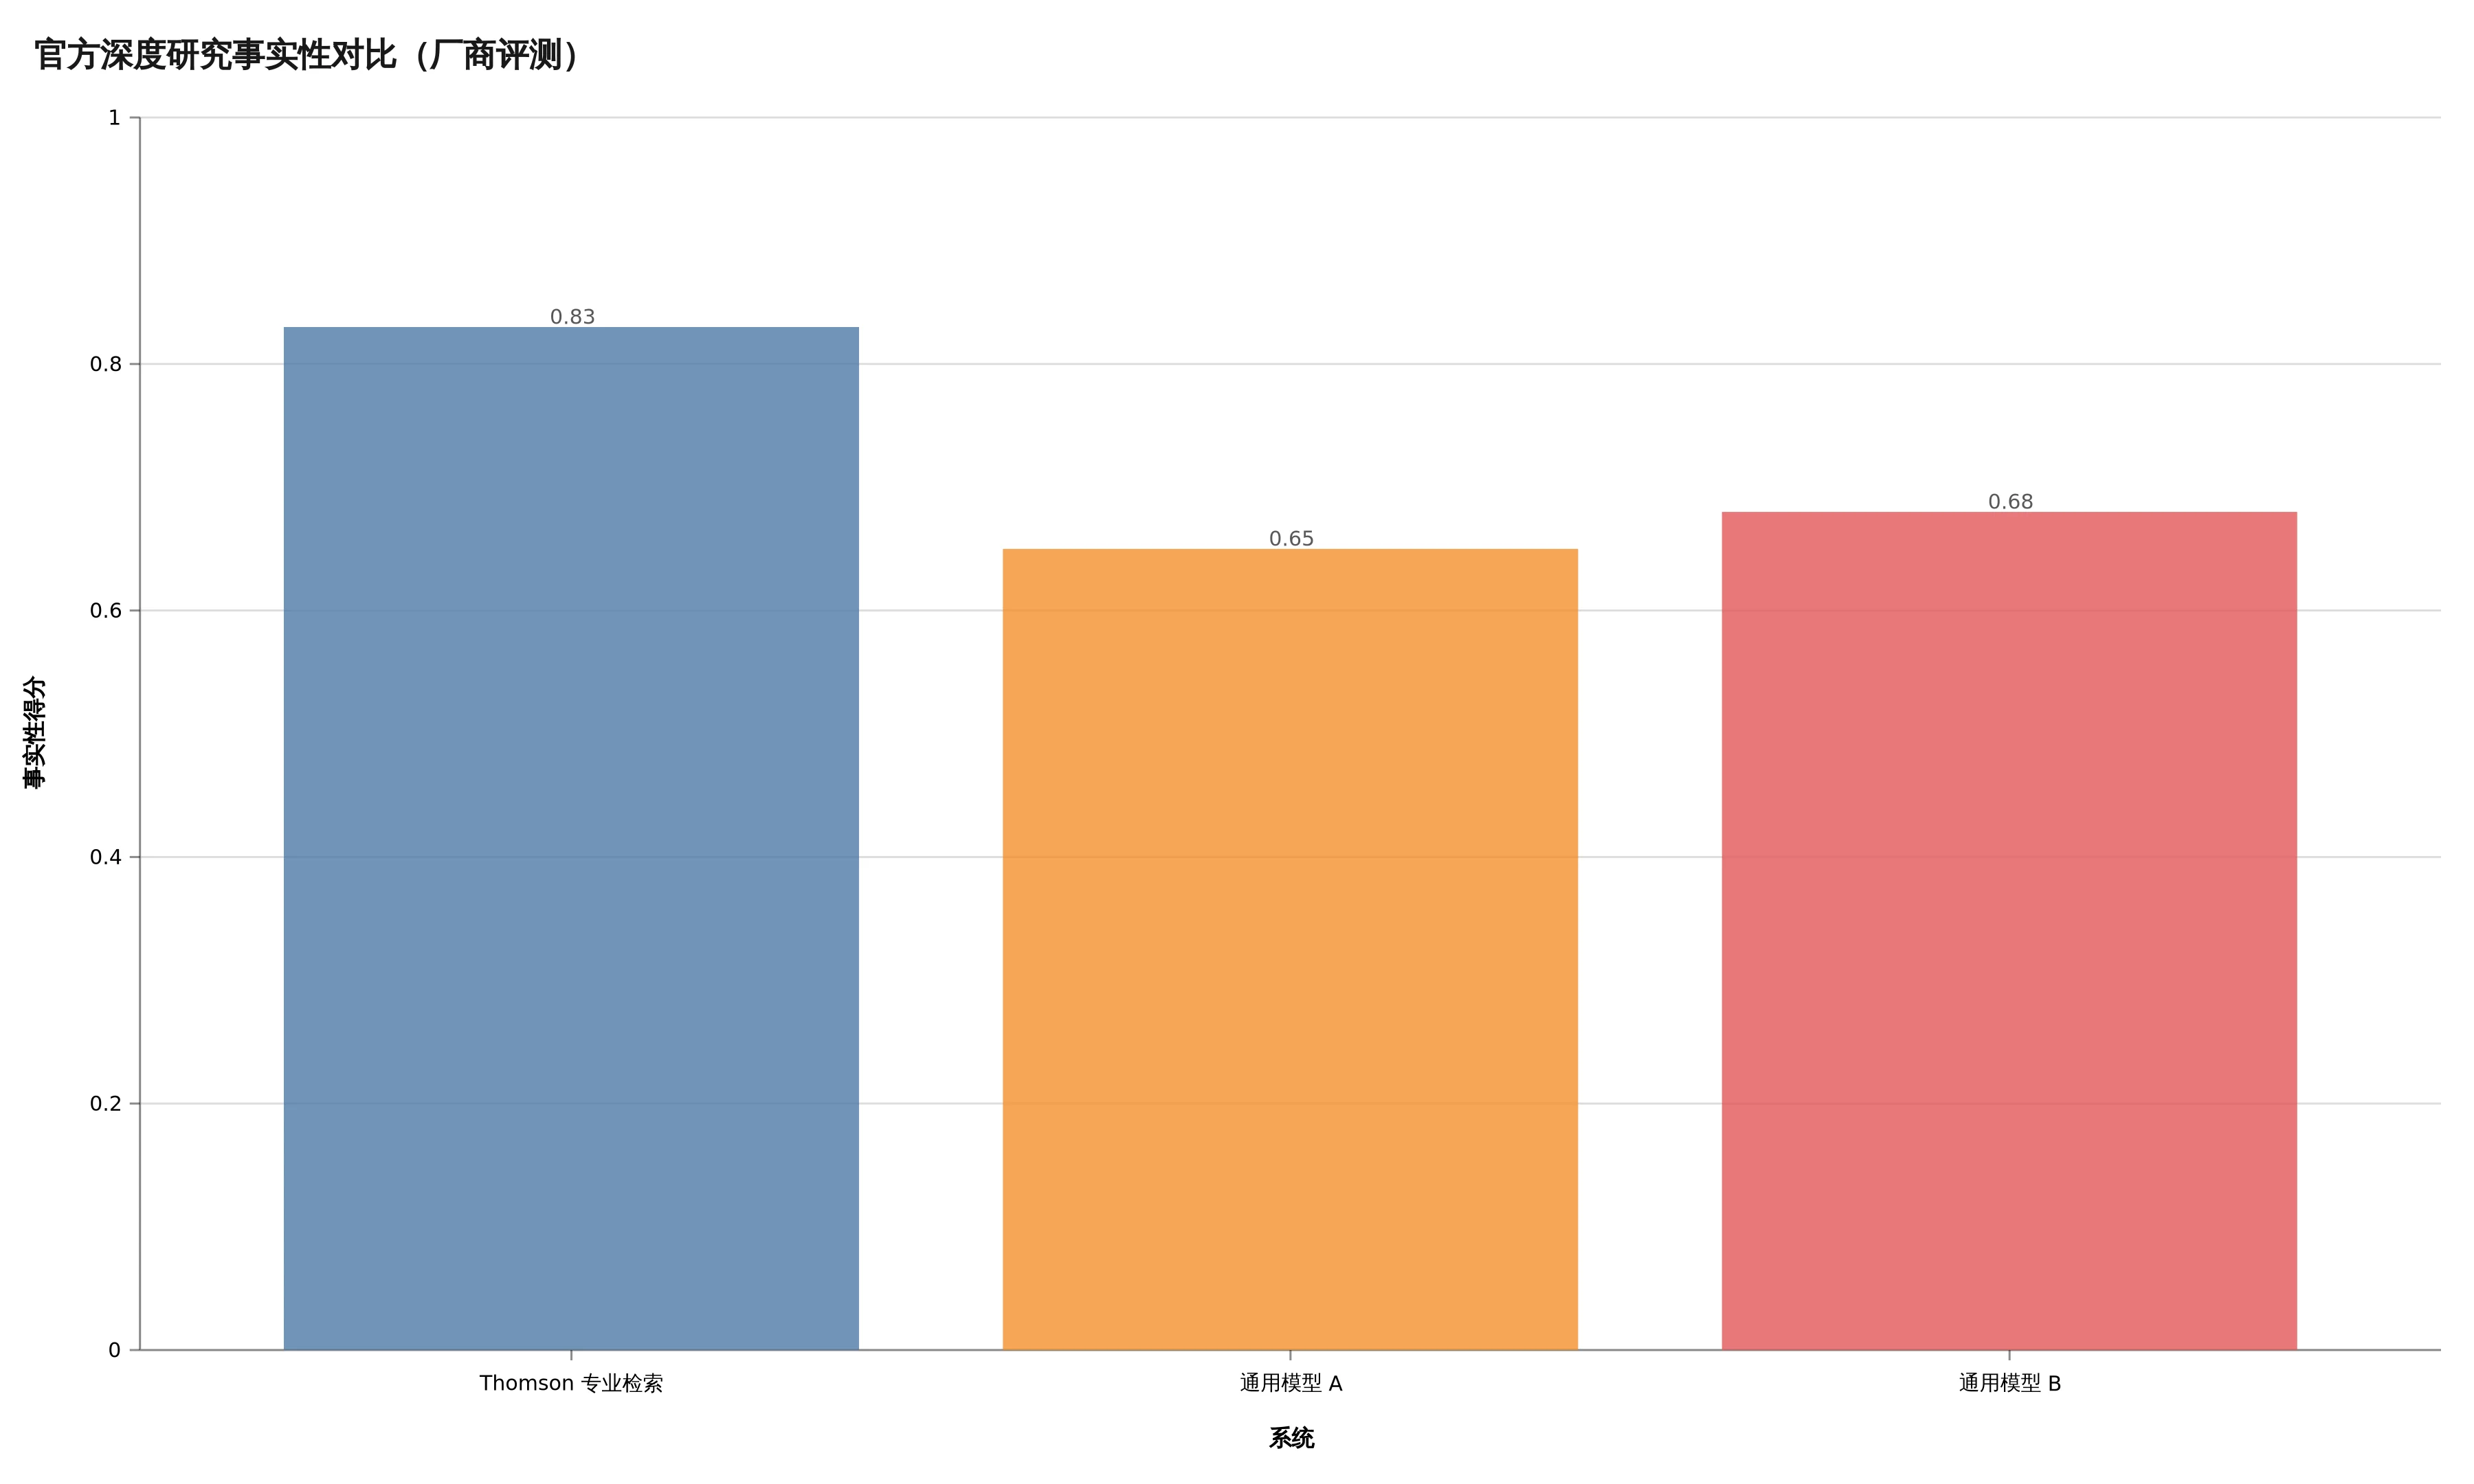
数据来自 Thomson Reuters 构建复盘,通用模型名称未在原文披露,图中沿用匿名标记。
他们不是让另一个模型看完全文打个「很可靠」的总分,而是抽取回答里的主张,再逐条检查来源能否证明这句话。
从 Agent 工程的角度看,这个口径很实用。完整性像代码覆盖率,跑到过不代表跑对了。事实性更像 assertion,输出里的每个关键结论都得回到证据。前者让报告看起来很满,后者才决定有没有人敢签字。
类似的逻辑也出现在 Thomson Reuters 以前的长上下文评测方法里。他们先用自动化基准筛模型,再把候选放进真实技能流程,用律师写的最低合格答案和评分规则去测。上下文窗口标着 100 万 token,不代表复杂任务在 100 万 token 时还记得住所有约束。窗口大小是产品参数,有效窗口才是生产指标。
这一下就从模型榜单走到了验收现场。
企业真正要问的不是「这个模型懂不懂我们的业务」,而是「它错的时候,我们能不能定位错在哪一条证据、哪一个约束、哪一次路由」。前一个问题适合做发布会,后一个问题才适合做系统。
模型主权不是关起门来造模型
Thomson 的另一个关键词是模型主权。
这个词很容易被写成「以后再也不用外部模型」。但 Thomson Reuters CTO 的公开文章说得恰好相反。
他们会继续使用领先的通用模型。CoCounsel 也是多模型架构,Thomson 只负责自己更擅长的任务。它的第一处生产落点是 Tabular Analysis,一次审查最多 1 万份文档、回答最多 100 个问题,每个答案都要能回到来源。这种高频、结构化、判断密集、验收标准明确的工作,才适合让专用模型上场。
更开放的问题,仍然可以交给通用前沿模型。
其实 Thomson Reuters 早在 2024 年就公开过 CoCounsel 的多模型策略。他们会在产品里测试不同提供商和不同组合,不只问谁更强,还问哪种组合最适合具体任务。现在有了 Thomson,只是多了一层自己能控制的能力,不是把外面的模型全拔掉。
这才是我更认同的模型主权。
不是所有东西都自己造,而是关键差异不能全部租来,非关键能力也没必要重复造。
你可以继续租最强的通用推理,把搜索、开放式分析和陌生任务交给它。同时把自己最懂、调用最频繁、错误代价最高的那一小块做成可控能力,再用路由把两边接起来。
模型路由在这里不只是省钱策略,它变成了组织边界。哪些能力跟着供应商版本走,哪些能力必须按自己的节奏更新,哪些数据不能离开指定环境,哪些答案必须过内部证据链。路由表背后其实是一张责任表。
再回头看 4000 万美元,这个数字也不能直接拿去套预算。
官方说它覆盖人才和算力,却没有公开模型参数规模、完整训练 token、长期推理成本、专家工时如何计价,也没有放出可复算的总拥有成本。完整技术报告仍在后续计划里,Thomson 目前也不作为独立模型出售。把 4000 万美元理解成「企业模型起步价」,和拿云厂商首月优惠估三年账单差不多,多少有点勇。
真正该看的成本单位不是一次训练花了多少,而是一个合格任务花了多少。
如果专用模型便宜一半,却让律师多花二十分钟核引用,省下的推理费没有意义。如果模型本身贵一点,但能把一万份文档的每个结论稳稳指回证据,它节省的是返工、复核和责任风险。成本应该跟成功任务和人工接管次数绑在一起,不能只跟 token 绑在一起。
这也决定了自有模型不能脱离可观测性。每次路由为什么选 Thomson,哪类问题转给通用模型,人工在哪一步接管,某个版本上线后事实性掉了多少,这些都要有日志和回放。没有这层系统,自有模型只是一个更难升级、更难甩锅的内部 API。
比较骚的是,Thomson Reuters 已经把答案写在产品形态里了。它没有让 Thomson 接管整个 CoCounsel,而是先放进边界清楚的 Tabular Analysis。任务、数据、验收和回溯方式都相对固定,出了问题也能定位。先在一个窄工作流里证明 cost per successful task,再扩大路由范围,这比发布当天宣布「全面接入」靠谱多了。
你的公司该不该自建
看到这里,先别急着把「自研大模型」写进下一季度 OKR。
Thomson 这条路能成立,是因为它同时拥有几个很难凑齐的条件。
它有竞争对手买不到的内容,有 1500 名律师编辑和更多领域专家,有高频且能明确验收的窄任务,有把专家判断写成规则的能力,还有一套多模型产品愿意接住这个新模型。4000 万美元是在这些条件之上的放大器,不是替代品。
很多公司的真实情况正好相反。所谓专有数据是一堆权限不清、重复冲突、半年没人维护的文档。专家忙到没时间标注,只能在验收会上说「差点意思」。目标任务从写周报一路扩到经营分析,既没有稳定输入,也没有谁愿意为输出签字。
这种时候自建模型,不是在建立护城河,是在给数据债和组织分歧找一个更贵的运行时。
坦率讲,我会先问四个问题,但不需要做成 PPT。
你的专有内容里,有没有竞争对手通过同一个 API 买不到的东西。你的专家能不能把「正确」拆成十几条可复核条件。这个任务是否高频到足以摊薄训练与维护成本。模型答错以后,系统能不能把错误定位到证据、规则和版本。
四个问题只要有两个答不上来,先用通用模型加检索、工具和严格评测。把真实失败攒下来,把专家修改留下来,把每次「感觉不对」翻译成具体规则。等这些东西开始形成稳定的数据飞轮,再讨论模型层所有权。
等等,「数据飞轮」这个词也挺烦的。
还是说人话吧。先把你为什么比别人更懂这件事,变成机器能够学习、团队能够验收的记录。
Thomson 最有价值的示范,不是 4000 万美元也能做前沿模型。它真正给企业 AI 上了一课,算力越来越容易租,通用能力越来越容易买,最难买到的依然是你自己的内容、判断和责任。
GPU 会折旧,模型会换代,榜单下个月就可能重排。
但知道什么叫做对,并且敢把它写成可检查的标准,这才是家底。