posts/token-500-trillion-task-cost.md
500 万亿 Token 一天,跑出来的未必是产出
500 万亿。
不是融资额,不是参数量,是中国大模型一天处理的词元总量。
今天公开的报道里,这个数字对应的是 2026 年 6 月。再往前翻,国家数据局 4 月披露的口径还是日均 140 万亿。短短三个月,调用量变成了约 3.6 倍。
把时间再拉长一点更夸张。北京日报刊发的研究文章给出的序列是,2024 年初约 1000 亿,2026 年 6 月超过 500 万亿,两年多涨了 5000 倍。报道里还有一个很有画面感的数据,混元 3 正式版上线第一周,Token 调用量比上一代增长 68 倍。
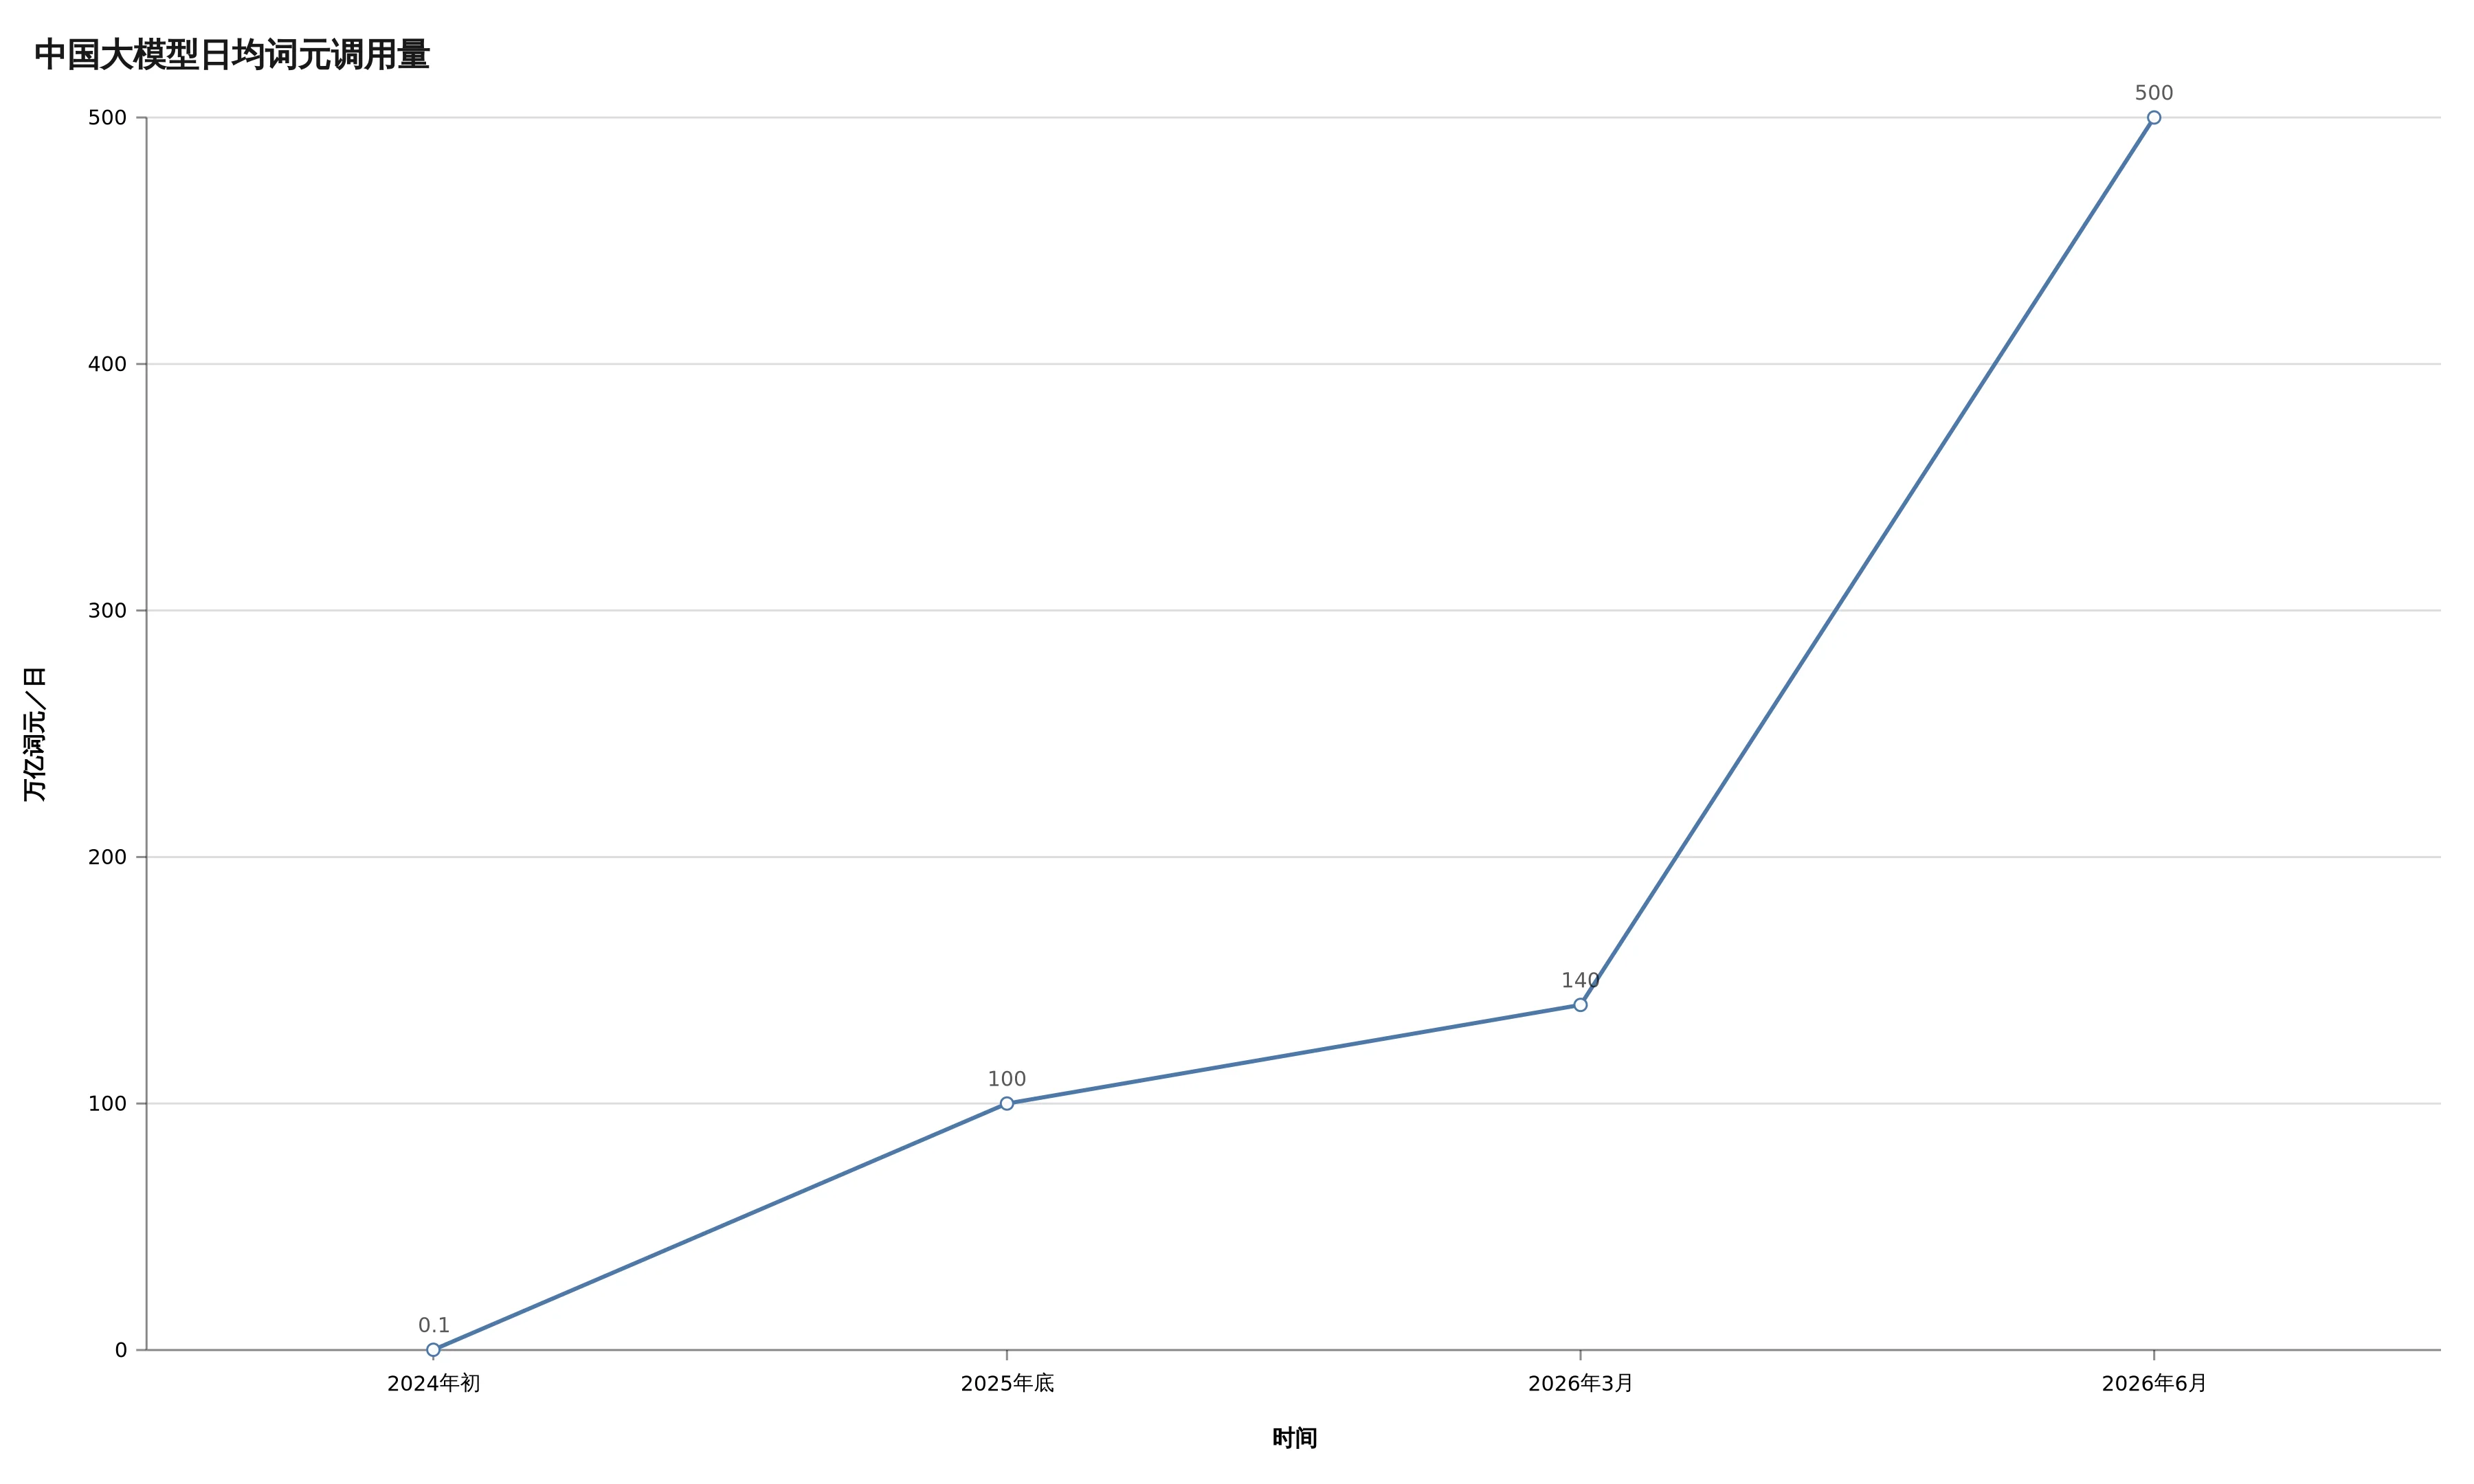
从 2024 年初的 0.1 万亿升到 2026 年 6 月的 500 万亿,数据来自公开报道与国家数据局。
好家伙,计量单位都快不够用了。
但我盯着 500 万亿看了一会儿,脑子里冒出来的不是「谁赢了」,而是另一张更朴素的工程账。
这些 Token 到底完成了多少任务?
这是两个完全不同的问题。
Token 在涨,任务不一定跟着涨
聊天机器人时代,一次请求大致对应一次回答。输入一段文字,模型吐一段文字,账单虽然不算简单,至少还能顺着 request 数量往回查。
Agent 不是这么跑的。
用户只点了一次「帮我处理」,后台可能先读系统指令,再检索知识库,再调用数据库,再把工具结果塞回上下文,再让模型判断下一步。中间某个接口超时,整段历史重放一遍。结构化输出少了一个括号,再来一遍。浏览器点错位置,截图、识别、规划全都再来一遍。
表面上是一个任务,底下已经滚过十几次甚至几十次模型调用。
网信办转载的公开调研也提到,简单任务可能只消耗几千词元,需要几十轮工具调用的任务则会升到几万词元乃至更多。这个增长很合理,模型从「会聊」走向「能干活」,本来就要付出更多推理和工具交互成本。
问题出在另一头。
如果监控面板只显示总 Token、总请求数和平均单价,团队很容易把「系统在忙」误判成「系统有效」。队列堆积也很忙,死循环也很忙,失败后无限重试甚至比正常完成更忙。
流量是原料消耗,不是业务产出。
这话听着有点刺耳,但 Agent 上线后,最该补的不是一张更大的 Token 总量图,而是一条从用户任务到最终结果的完整 trace,也就是能把一次任务从入口一路串到模型、工具、重试和结局的追踪记录。
账要从 request_id 升到 task_id
很多模型网关已经会记录 request_id,这只能告诉你某次模型请求花了多少。真正有用的主键应该再往上一层,叫 task_id。
假设一个常见场景,用户提交了一张报销单,希望 Agent 识别票据、核对制度、写入系统。模型识别一次,查制度两次,调用报销接口一次,后来因为字段校验失败又重跑一轮。六个 request_id 看起来彼此独立,业务上却只是一张还没报成功的票。
日志至少要能还原成下面这个样子。
{
  "task_id": "expense_8f2a",
  "attempt": 2,
  "model_calls": 6,
  "tool_calls": 4,
  "input_tokens": 48210,
  "cached_input_tokens": 31100,
  "output_tokens": 3840,
  "latency_ms": 28740,
  "outcome": "failed_validation",
  "stop_reason": "retry_budget_exhausted"
}
代码块里最值钱的字段不是 input_tokens,而是 outcome。
没有结局,前面的消耗就无法解释。五万 Token 解决一份需要人工两小时的复杂合同,可能很划算。五万 Token 只为了反复生成一个过不了 schema 的 JSON,那就是在烧钱取暖。
所以面板上至少要同时算两笔账。
每个成功任务的词元成本 = 全部任务词元 / 成功任务数

重试放大倍数 = 全部模型调用次数 / 成功任务数

每个成功任务的推理费用 = 全部模型与工具费用 / 成功任务数
注意,原始 Token 和真实费用不要混成一个数。缓存读取、缓存写入、普通输入和输出的价格通常不同,同样是一万 Token,账单权重并不一样。Token 看工程效率,货币看商业成本,两张图都要留。
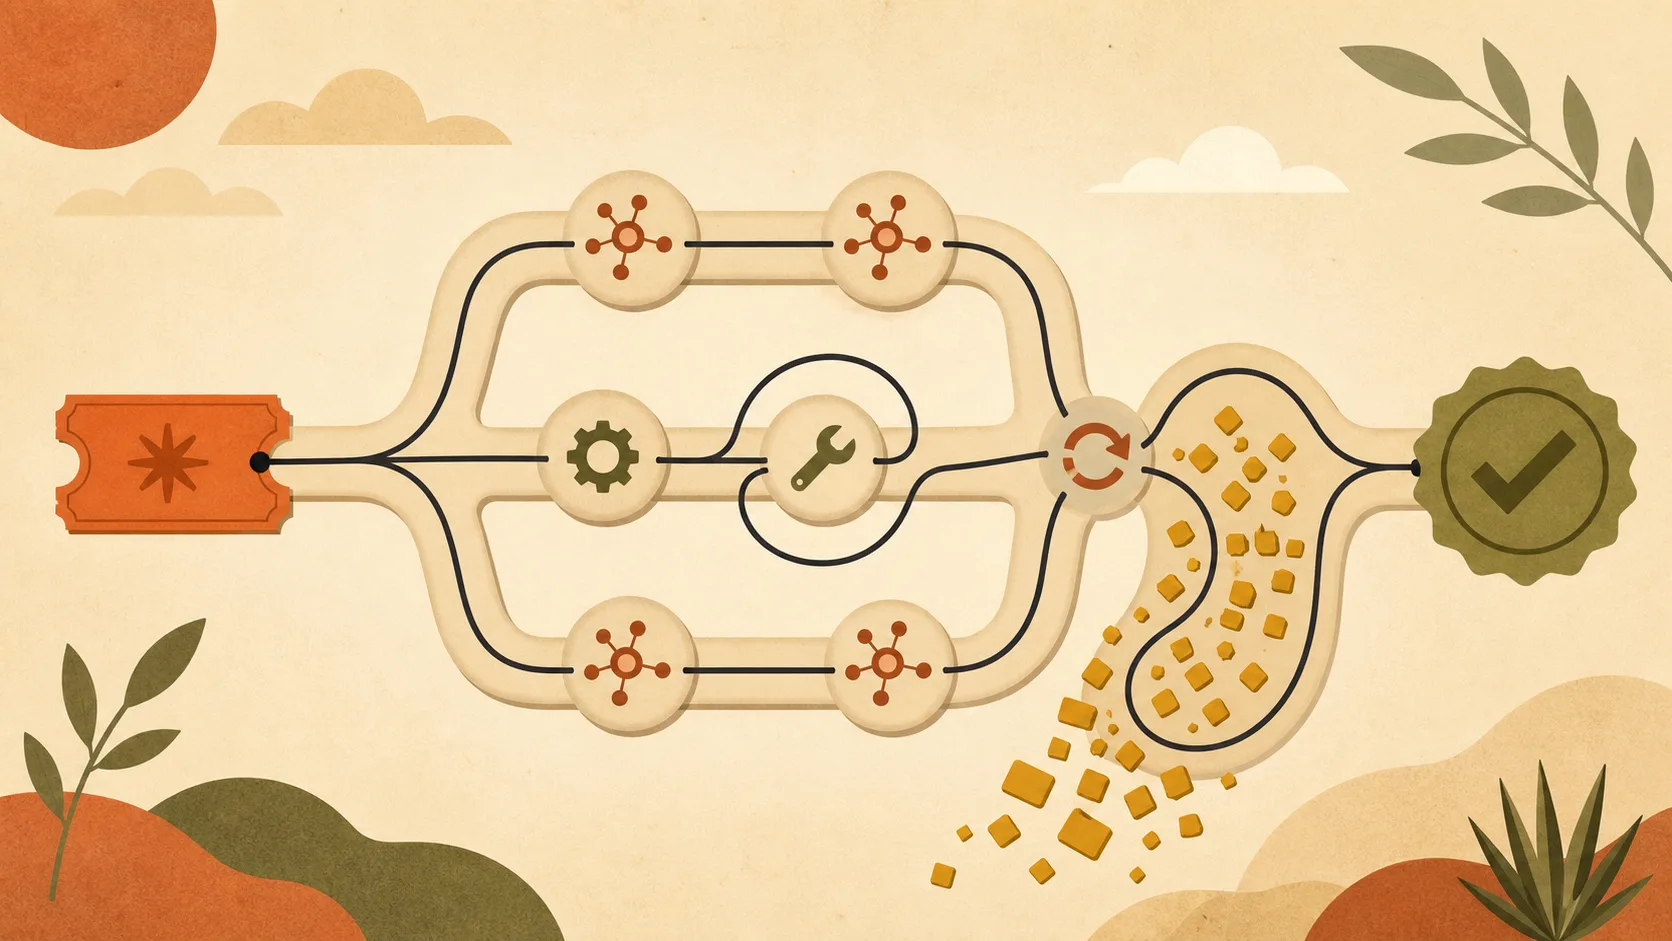
一条用户任务会分叉成多次模型与工具调用,重试环路可能把 Token 留在半路。
最贵的 Token 往往没出现在产品功能里
线上最容易冒出幽灵账单的地方,是重试。
模型返回格式错误,工具报 429,浏览器操作超时,队列消费者被重启,这些故障都可能触发重跑。如果重试器只是把完整上下文原样扔回去,那么一次短暂的网络抖动就会重新支付系统指令、工具定义、检索材料和历史对话的全部输入成本。
更麻烦的是,有些重试根本不会提高成功率。权限不足、参数语义错误、目标资源不存在,这些属于确定性失败。再跑十次,只会得到十份更贵的失败。
这里需要的不是一个更猛的重试按钮,而是错误分类、幂等键和失败出口。可恢复错误按退避策略重试,不可恢复错误立即停止;每个任务有总调用次数、总 Token、总时长三道预算,任意一道触顶就进入人工队列。
厉害了,一个安全停止条件,省下来的可能比换便宜模型还多。
另一笔幽灵账来自上下文。
Agent 每一轮都可能重新携带系统提示词、几十个工具定义、项目规范和前面所有工具结果。轮次一长,成本不是匀速上涨,而是不断重复搬运同一批旧内容。Anthropic 的成本优化文档直接提醒,40 轮任务会多次重发早期上下文,任务成本会随轮次快速放大。
缓存能救一部分。OpenAI和 Anthropic都提供了提示词缓存机制,适合复用稳定的系统指令、工具定义和大段背景材料。但开了缓存不等于结束,真正该看的字段是缓存命中率。
一个时间戳放在稳定前缀最前面,一次工具定义的顺序变化,甚至并发请求启动得太早,都可能让本该复用的前缀重新计算。控制台显示「已启用缓存」,账单仍然一路向上,这种事一点都不玄学,只是缓存键被悄悄改了。
把稳定内容放前面,把每次变化的任务数据放后面,再把大文档从「整份塞入」改成「先检索再取片段」。做完后别靠感觉庆祝,直接看 cached_input_tokens / input_tokens,按场景、模型版本和提示词版本拆开。
多 Agent 还会再加一层放大器。
一个编排器同时派出五个子 Agent,如果它们各自从头读取同一份仓库、同一套规范和同一个问题,主界面看起来只是五个小圆点在并行,后台却是五份上下文同时计费。并行降低了墙上时钟的等待时间,却不保证降低总成本。
这块要把父子任务树记下来。父任务分了多少预算,每个子任务用了多少,哪些结果被主任务真正采用,哪些分支跑完后直接丢弃。没有这棵树,团队只会看到模型供应商的一张总账单,看不到是哪次 fan-out,也就是并行分叉,把成本撑爆了。
500 万亿之后,比赛才刚换了计分板
我不想把 500 万亿说成坏消息。恰恰相反,这个数字证明大模型已经离开演示厅,开始进入软件开发、客服、研究、办公和生产系统。国务院发展研究中心的公开研究也在讨论,词元正从技术单位变成可计量、可定价、可交易的经济单位。
只是对做产品的人来说,产业看总量,团队得看转化。
今晚就能做的动作,是给模型调用、工具调用、队列任务和最终业务结果统一加上 task_id。等链路串起来,再按场景画出每个成功任务的 Token、费用、重试倍数、缓存命中率和 p95 完成时长,也就是 95% 的任务能在多久内结束。
让这张表跑一周,最浪费的路径通常会自己浮出来。可能不是贵模型,而是失败后重放的长上下文;可能不是输出太长,而是工具 schema 每轮都在变;也可能不是 Agent 能力差,而是成功条件写得太模糊,模型永远不知道什么时候可以停。
我自己的判断是,接下来真正有竞争力的 Agent 团队,不会把「我们一个月用了多少 Token」当成绩单。他们会回答另一个更难的问题。
这一百万个 Token,交付了多少个可验收的结果?
模型按 Token 收费,业务只能靠结果活着。
500 万亿是一片很大的海。船多了、浪大了,当然值得兴奋。但工程师最终要看的,还是每一趟航行有没有到岸。