posts/uber-agent-cost-equation.md
Uber 70% PR 归 Agent,AI 账单却没跟着涨
70% 以上的 PR 归因于 Agent。
3,600 多个 Agent Skill,每天执行超过 3 万次。
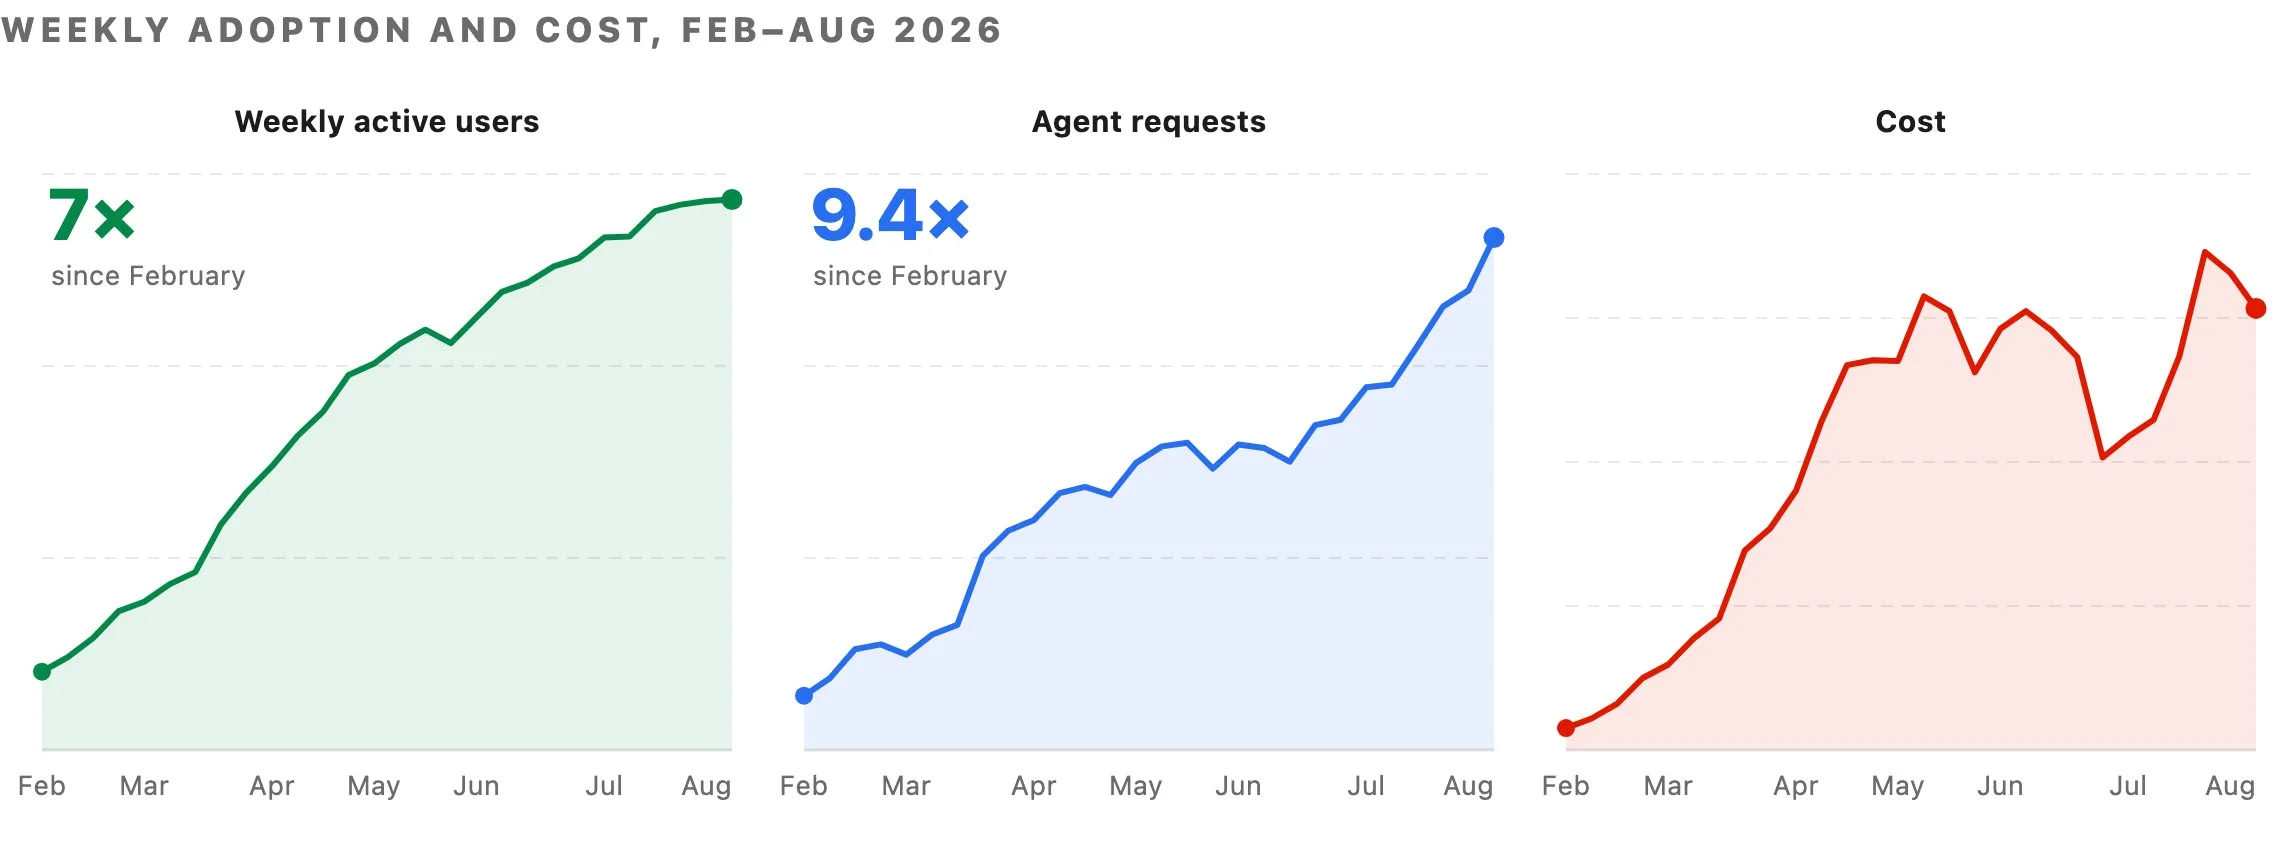
从 2 月到 8 月中旬,周活跃用户涨了 7 倍,周 Agent 请求量涨了 9.4 倍。
然后最离谱的一行来了,Uber 的 AI 总支出从 4 月起基本稳定。
好家伙,这四组数字放在一起,像把如今 AI 编程最拧巴的两件事焊死在了一张图上。一边是 Agent 真的开始接生产任务,另一边是账单没有跟着请求量原地起飞。
数字来自 Uber Engineering 刚公开的软件工厂成本长文。它不只是宣布公司用了多少 AI,而是把总账拆开,逐项解释钱到底烧在哪儿,又是怎么被压下去的。
我自己的感受是,这篇最值得抄的并不是 Uber 用了哪个模型。
模型两周一变,价格表一个月一换。真正有用的是那套算账顺序。别从 token 单价开始,先从一次成功交付开始。
当然,70% 这个数得先踩一脚刹车。
Uber 原文写的是 PR attributed to local or cloud agents,归因于 Agent,不是 70% 的代码在没有人看的情况下自己合并。文中列出的代码审查、CI 自愈、端到端 PR、告警分流和 bug 调试,都保留人工审查与升级。Agent 是主要执行者,人还守在责任边界上。
这区别挺大。
使用量涨了,不等于生产率涨了 9.4 倍。Agent 归因的 PR 多了,也不等于每个 PR 都创造了同样的价值。Uber 自己没有偷换这个概念,我们写标题的人更不该替它偷换。
但把营销泡沫挤掉以后,剩下的工程账依然有点子牛逼。
总账不是一个数,是六个数相乘
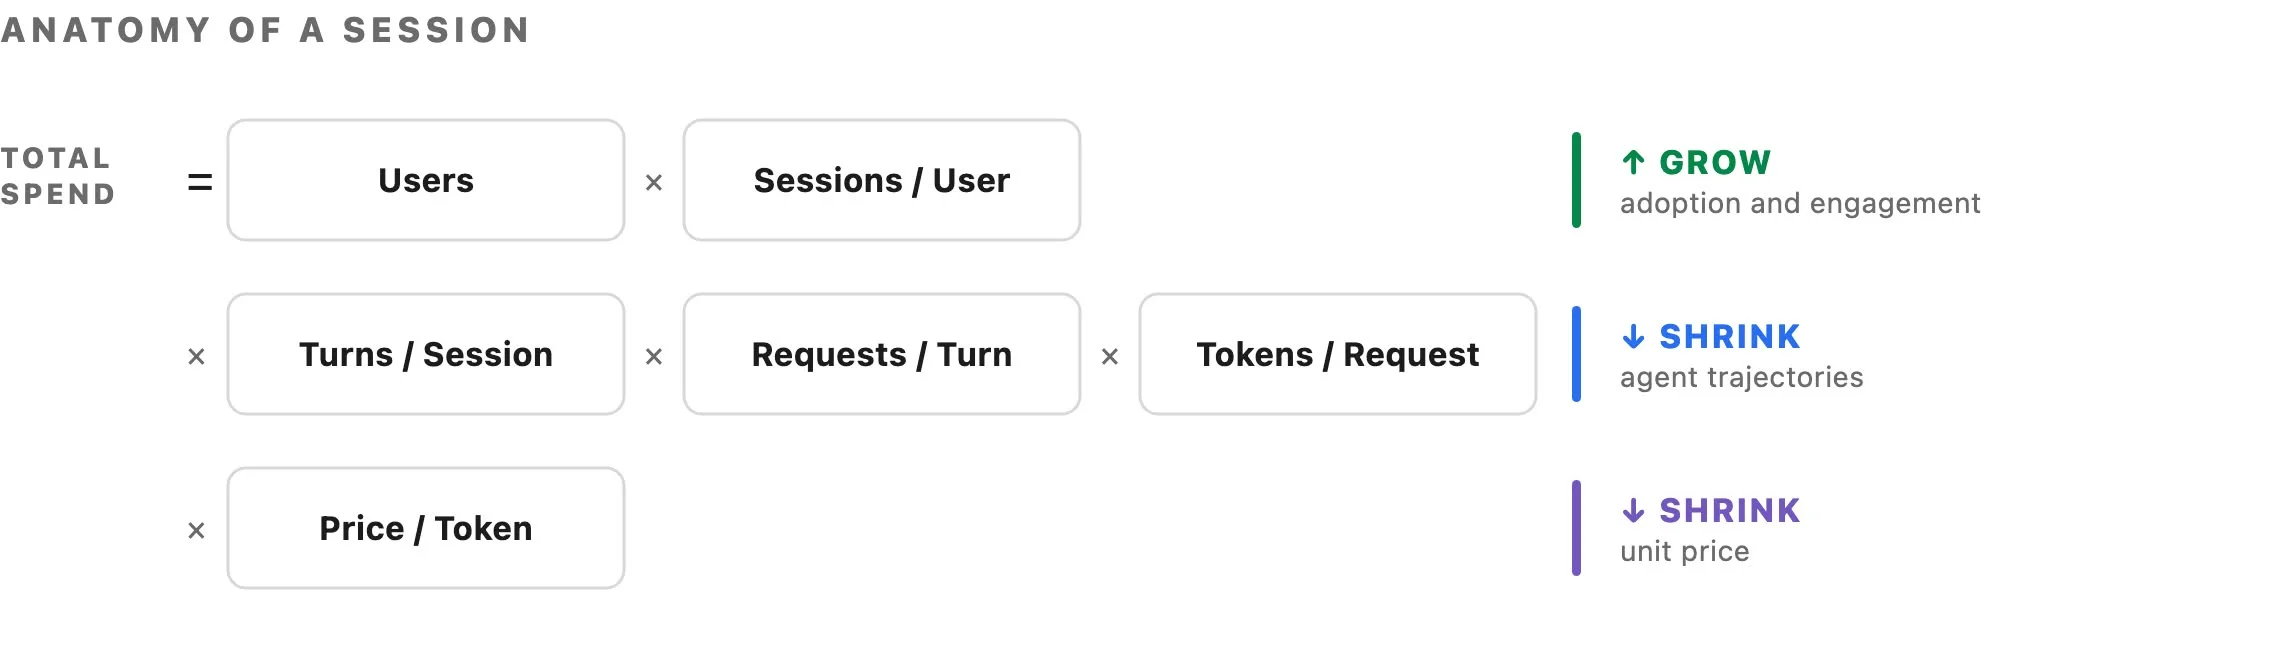
Uber 把 AI 总支出写成了一个乘法公式。
用户数 × 每用户会话数 × 每会话轮数 × 每轮请求数 × 每请求 token 数 × 每 token 价格
很多团队看到月底账单,第一反应是模型太贵,于是开始四处找便宜模型。这个动作不能说错,只是太靠后了。
六个数相乘,任何一项失控都会把总账放大。更麻烦的是,它们还会互相喂大。
上下文里塞了几十个用不到的工具 schema,每次请求的输入 token 先胖一圈。Agent 找不到代码和数据,又多搜十轮。每一轮都把那坨历史上下文重新带上。中间一次工具调用超时,再拉两个子 Agent 重试。任务没做完,账单倒是完成得很漂亮。
厉害了,钱不是花在答案上,是花在寻找答案的姿势上。
Uber 把前两项看成希望继续增长的采用率。用户更多、会话更多,不该被当作问题。它真正盯的是中间几项,Agent 为完成用户请求额外绕了多少路、发了多少次请求、重复携带了多少上下文。
这里有一个很实用的判断。
增长项别乱砍,浪费项要单独量。
如果把整个团队的 AI 预算一刀切,最勤快、最有价值的工作流会和无效重试一起被砍掉。Uber 没这么干。它继续让采用率增长,同时把每个成本驱动因素拆出来,看这次变化究竟来自更多用户、更多请求、更长输入,还是更多输出。
没有一项可以躲进「模型升级了」这种万能解释里。
把分母换成合并的 PR
Uber 的成本表里,真正改变玩法的是 managed agent outcomes,也就是托管 Agent 的结果账。
代码审查 Agent 不只报花了多少 token,而是报每次审查成本、F1、延迟、超时和噪声。处理告警的 Agent 看每个告警的成本、平均修复时间和质量。写代码的 Agent 看每个合并 PR 的成本、回滚率和实际落地量。
请注意这里的分母。
不是请求,不是会话,也不是生成了多少行代码,而是合并的 PR、完成的审查、处理的告警。
这个区别,做过 Agent 的朋友大概一眼就懂。
一次请求便宜 30%,如果它更爱走错目录、更容易把测试写成永远通过,结果要重跑三次,那就没有省钱。反过来,一个单价更高的模型若能一次完成,少拉两个子 Agent,少塞一轮日志,整项任务反而更便宜。
所以 Uber 选模型时,不拿公开榜单直接盖章。它用真实 PR 和已知 bug 做内部基准,按难度分级,同时测 precision、recall、F1、成本、延迟、超时和噪声,然后找质量、可靠性与完成任务成本的帕累托前沿。
这套逻辑跟供应商是谁没关系。OpenAI 的 API 价格、Anthropic 的模型价格 和 GitHub Copilot 的计费单位 都会变。你自己的真实任务集才是相对稳定的尺子。
Uber 还提到一个很具体的杠杆,子 Agent 默认模型。
主模型负责拆任务和验收,输入清楚、边界明确的子任务默认交给更便宜的模型。需要时可以覆盖,但不让每个搜文件、查日志、跑格式化的子任务都自动吃最高档模型。
坦率讲,这比做一个玄学智能路由器靠谱多了。先按任务角色设默认值,再让评测决定哪些任务值得升级。路由规则不需要猜,失败记录自己会把边界画出来。
最贵的 token,常常在答案出现以前
把模型选好,只解决了公式末尾一项。Uber 后面几招更值得看,因为它们处理的是请求发生前就背上的成本。
先看上下文窗口。
就算模型支持 100 万 token,Uber 的交互式 Harness 也会在 40 万 token 触发自动压缩。推理强度默认设为 Medium,不让每个任务一上来就开最高档。
不是哥们,窗口能装下 100 万,不代表每轮都该扛着 100 万出门。
每次对话会重发历史上下文,长窗口不是一次性仓储费,更像按轮收费的搬家车。你往里塞的每份文档、每段工具响应、每个错误栈,后面都可能被重复搬运。
再看缓存。
Uber 发现工程师经常暂停会话超过 5 分钟,默认的短缓存刚好在回来前过期,整段前缀只能重新按全价计算。于是主线程改用更长的缓存时间,短命子 Agent 仍保留短缓存。缓存寿命不再跟着供应商默认值走,而是跟着人真实离开键盘的时间走。
这块很容易被忽略。缓存不是开了就省,它有写入溢价,也有过期重建。最合适的时间取决于会话停顿分布。官方的 OpenAI Prompt Caching 文档 和 Anthropic Prompt Caching 文档 会告诉你规则,自己的 trace 才会告诉你该选哪档。
然后轮到 MCP。
Uber 的统一网关后面有 1,000 多个 MCP 服务。传统接法会把工具 schema 预载进每个会话。装了 100 多个工具,初始上下文能平白多出 5 万到 7 万 token,后面每轮继续带着。
一个办公套件可能暴露 49 个工具,占约 2.2 万 token。再加消息和项目管理服务,Agent 还没看到用户的第一个问题,工具说明书已经比要改的文件长。
很荒诞,但非常常见。
Uber 的做法是把工具放在统一网关后面,通过 CLI 动态解析,或者先搜索工具目录,只加载当前任务需要的能力。MCP 仍负责统一协议,schema 不必全部住进模型脑子里。
这不是少装几个工具,而是改变工具被发现和调用的方式。
代码模式省掉的,是模型参与轮询的次数
工具调用还有一层更隐蔽的浪费。
假设一条 SQL 要先提交,再轮询两到五次状态,等任务完成后取结果。传统 Agent 会让模型参与每一步。模型发请求,看到原始响应,再决定下一步。每次响应都进入上下文,每次决定都新增一轮。
Uber 把这类流程包进脚本。轮询在子进程里自己跑,只把最终结果或失败摘要交给模型。
同一个 Claude Code 会话里,五条 SQL 的对照很有意思。SELECT 1 从 903 token 降到 402,COUNT(*) 从 954 降到 403,带 20 行结果的分组查询从 1,600 降到 457。连最小的结果集,也能省掉 55% 到 71%。
最夸张的是一条返回 50 行宽表的查询,逐步工具调用吃掉 1,431,594 token,代码模式只给模型留下约 900 token。
???
这不是模型突然学会节俭了。脚本只是没让它坐在轮询窗口前,看每一次「任务还在运行」。
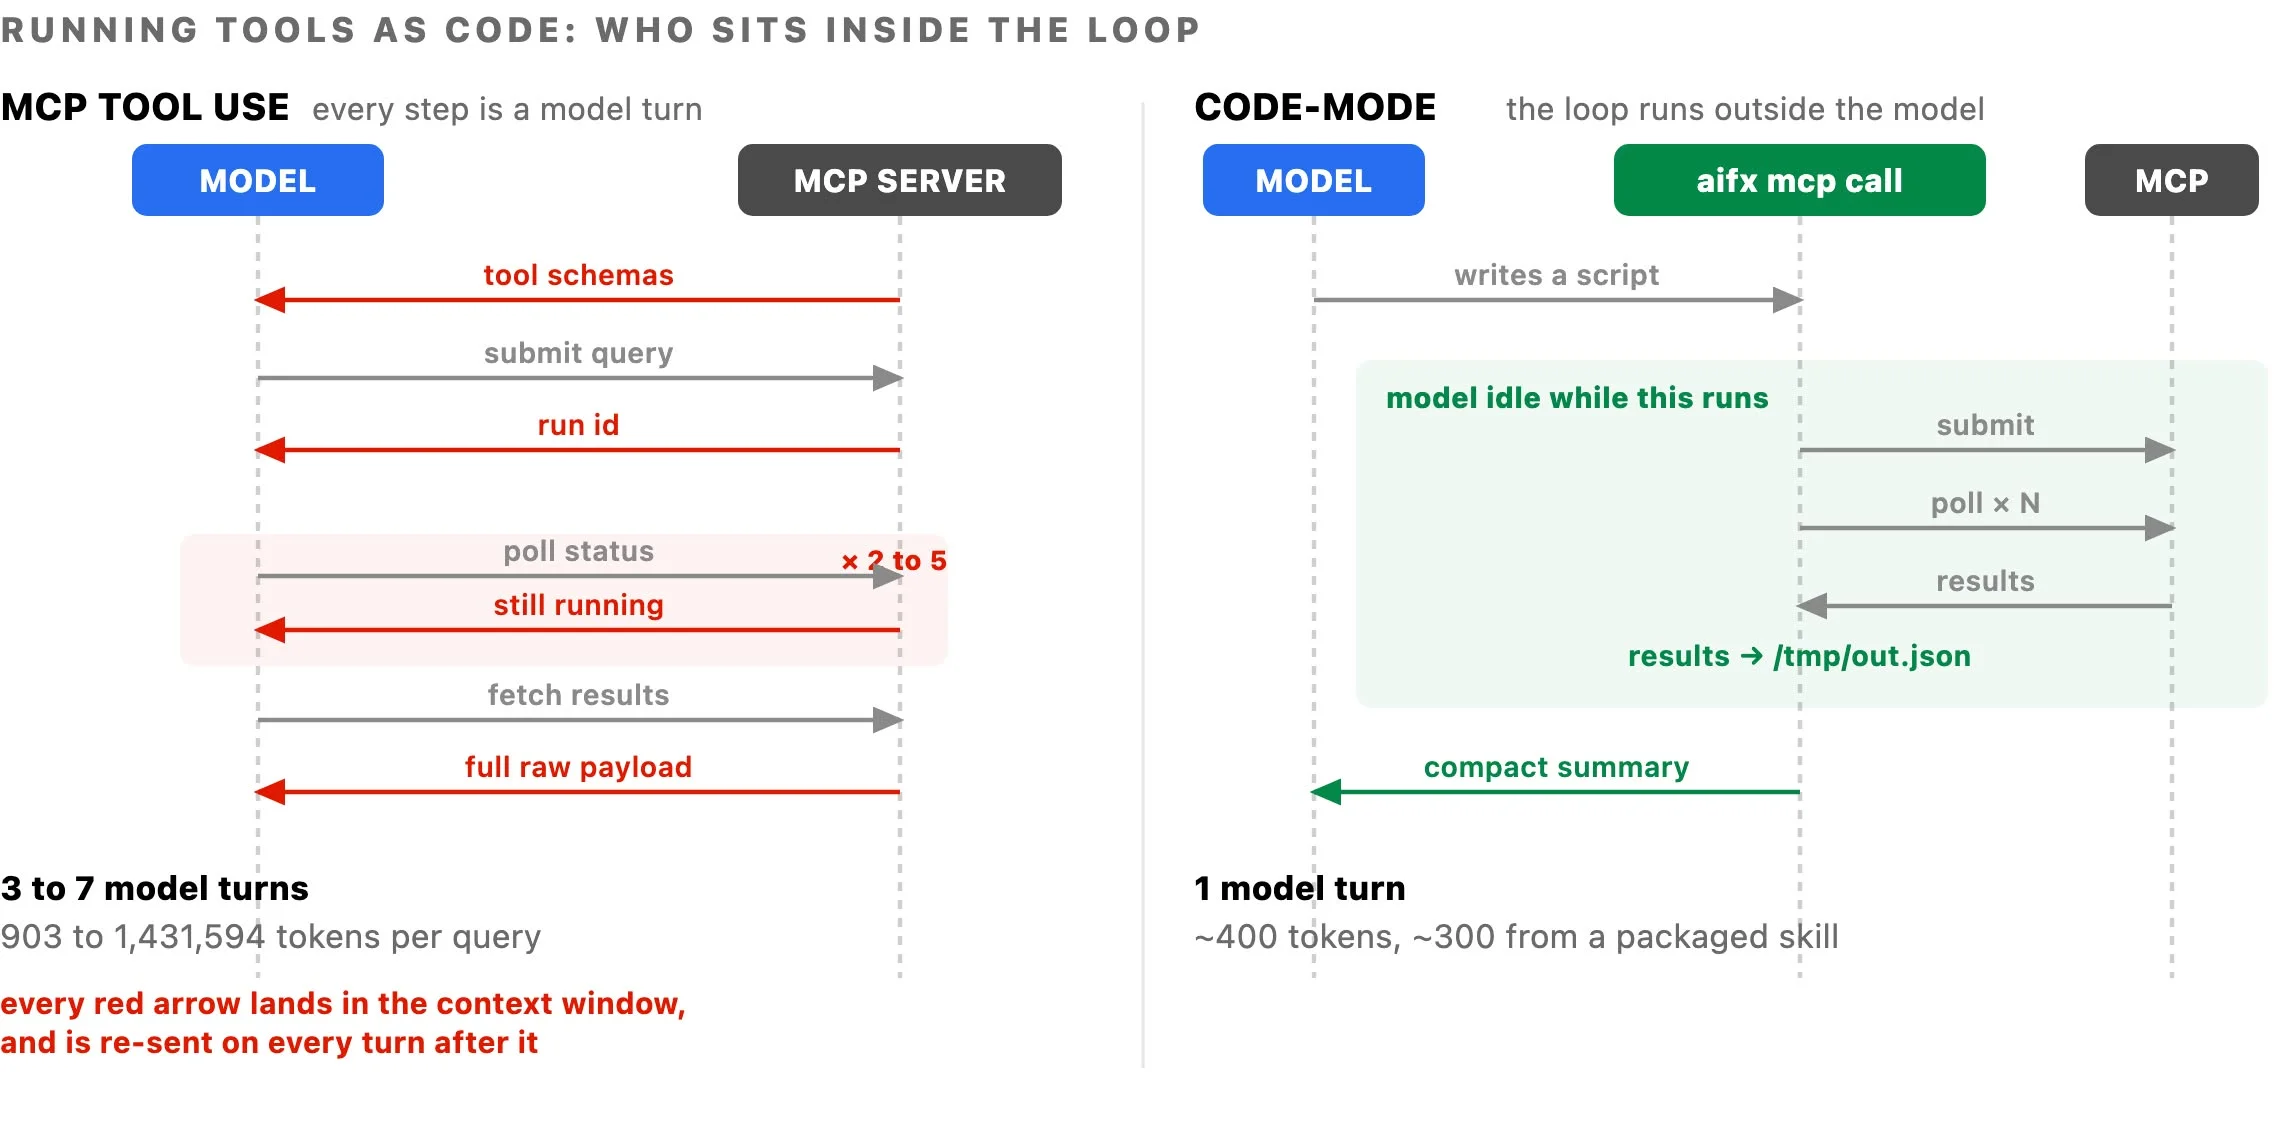
批量任务更明显。原本 N 次模型回合变成一个循环,Uber 测到整体节省可以超过 90%,并为常用 MCP 服务做了 25 个以上的代码模式 Skill。
很多团队喜欢把工具调用过程完整回灌给模型,觉得看得越多越聪明。其实吧,状态轮询、分页游标、完整表格和重复 schema 并不是知识,只是运输过程。模型需要判断依据,不需要观看每辆卡车过收费站。
上下文不是越多越好,找对才有用
到这里,Uber 还没解决 Agent 最烧钱的一件事,找不到东西。
数亿行代码、数千张表、几十套内部系统里,Agent 很多时间不是在生成代码,而是在猜入口。猜错一次,后面会自然长出更多搜索、更多子 Agent、更多错误和更大的上下文。
Uber 为此建了 AI Context Graph,包含 2,400 万节点、8,000 万条边、86 种节点和 117 种边,接入 30 多个内部系统。代码、团队、事故、PR、架构文档、部署、数据集和历史查询被放进同一张可查询的关系网。
同一个模型、同一个问题,有图支撑的 Agent 用 38 秒找到目标表并给出正确答案。没有图的 Agent 花了 20 分 09 秒,检查服务代码,拉起两个子 Agent,遇到三个错误,结果还答错了。
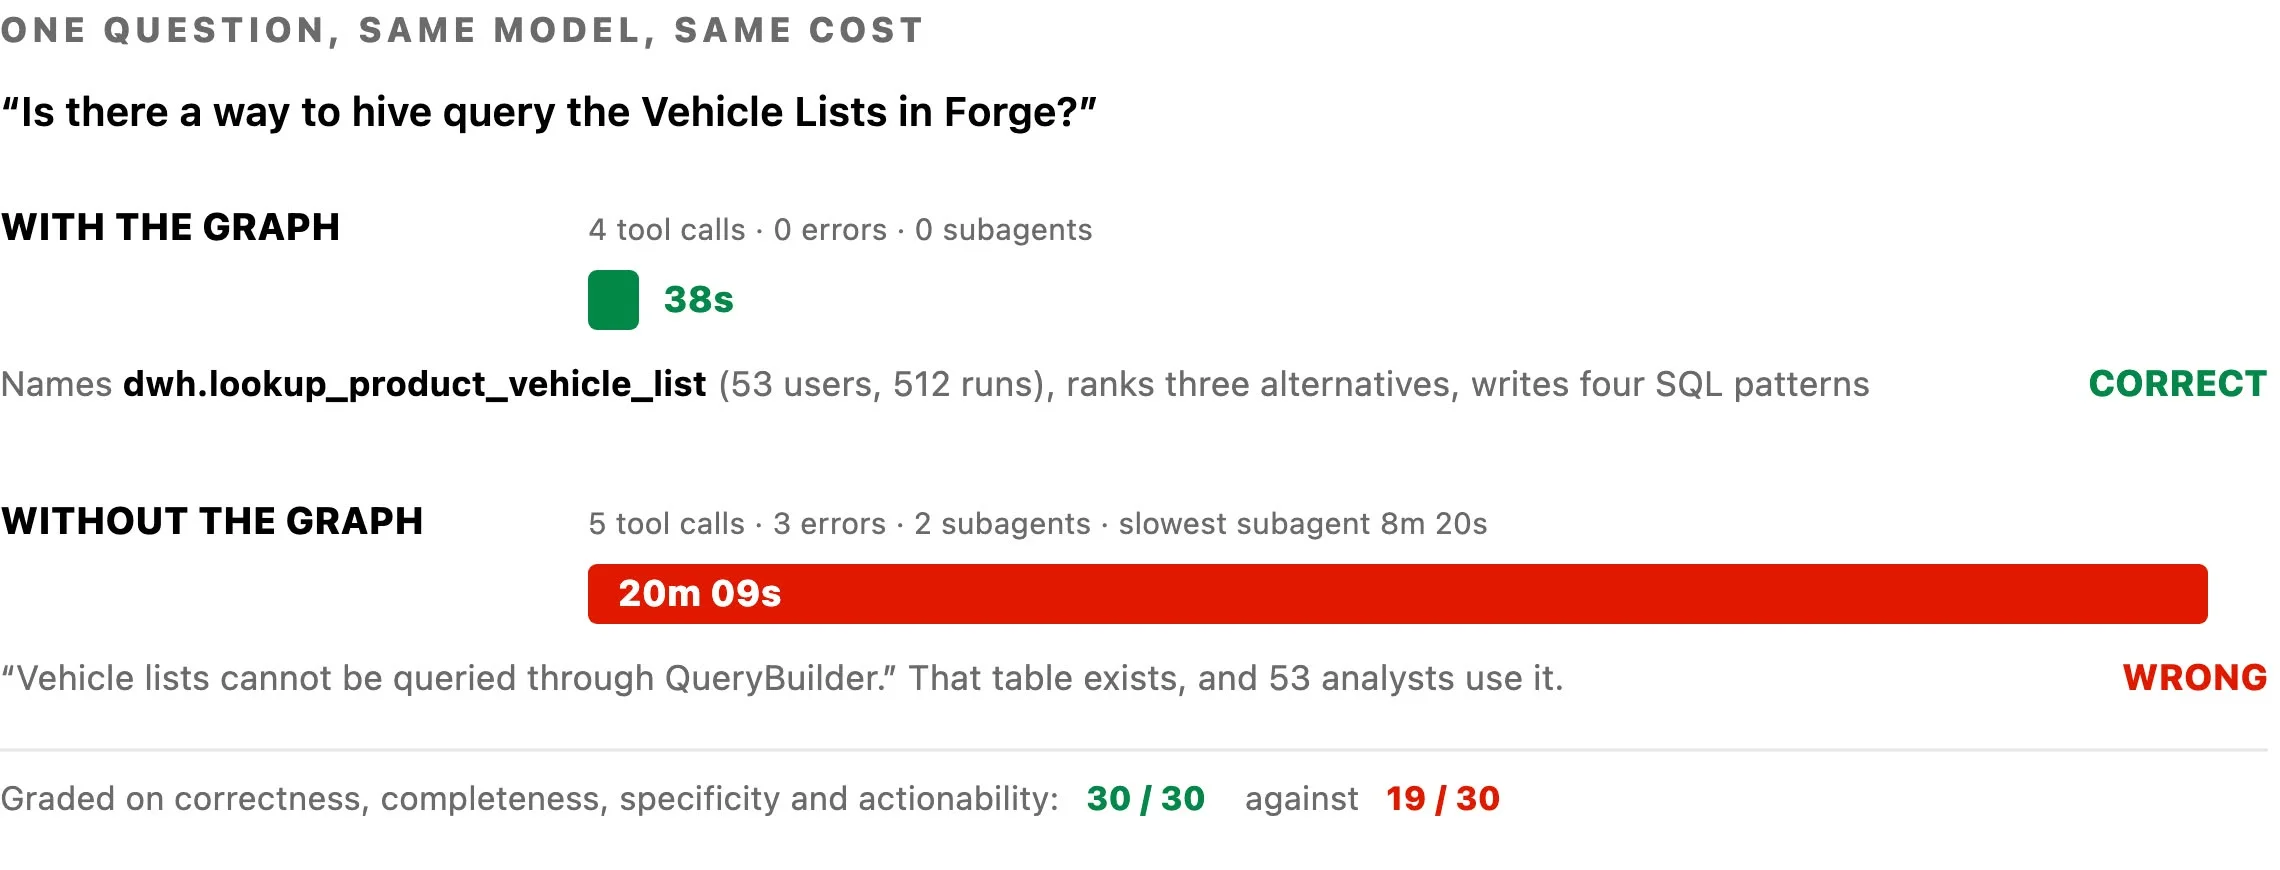
这组对照最扎心的不是 38 秒对 20 分钟。
是错误答案更贵。
它占用更多时间,生成更多 token,制造更多看似勤奋的轨迹,还要人回来返工。没有正确上下文时,Agent 往往不是快速失败,而是缓慢、昂贵地失败。
小团队当然不需要照着做一张 2,400 万节点的图。先把仓库入口、服务负责人、常用数据表、架构决策和事故记录做成能被检索的最小地图,价值已经很大。Uber 另一篇 Agent 身份与责任边界的公开文章 也提醒了同一件事,Agent 不只要知道去哪儿找,还得知道以谁的身份做、出了问题谁负责。
小团队真正能抄的顺序
读到这里,很容易把 Uber 的 3,600 个 Skill、1,000 多个 MCP 服务和 2,400 万节点当成大公司特供,然后默默关掉网页。
先别急。
那些规模数字不能抄,顺序可以。
先选一个高频任务。代码审查、CI 修复、告警分流都行,但别选「提升研发效率」这种没法验收的大词。给它定义一个结果分母,比如每个合并 PR、每次有效审查、每个正确关闭的告警。
再拿十几到几十条真实历史任务做小基准,保留已知答案和失败类型。模型路由、推理强度、缓存时间、工具组合都在这套任务上比较。别拿公开排行榜替自己的仓库做决定。
然后打开 trace,按成本公式找最大的乘数。是输入太长,轮次太多,工具 schema 太胖,还是子 Agent 全在跑最高档模型。一次只改最肥的那项,否则月底只知道钱少了,不知道为什么少。
再把成本放到执行现场。Uber 把实时费用放进状态栏,还会在达到支出档位的 50%、80% 和 100% 时提醒。工程师在会话还活着的时候看见钱,比财务在下个月发一张总表有用得多。
这条路线听着不性感。
没有万能路由,没有神秘提示词,也没有一键把所有模型换成开源权重。它更像普通的性能工程,先测量,找热点,改一处,再回归。
可软件系统偏偏就吃这一套。
Uber 这篇长文把 Agent 成本从采购问题拉回了工程问题。模型价格当然重要,但它只是乘法公式的一项。真正拖垮账单的,往往是没人衡量的重试、一直随身携带的 schema、过期的缓存、错误的上下文,以及一个从没定义过何为成功的 Agent。
70% 的 PR 很吸睛。
每个合并 PR 到底花了多少钱,才是该留在工程台上的那行数。