posts/unified-radix-cache-hybrid-models.md
Agent 越跑越慢,锅可能在缓存
145.5K 对 9.4K。
这是 LMSYS 刚发布的 Unified Radix Cache 里,DeepSeek-V4-Flash 在两种缓存配置下跑出来的有效输入吞吐差距。前者用了 GPU、主机内存和外部存储三层缓存,后者只有 GPU 缓存。
看起来像模型突然快了十五倍。
先别急,模型没有突然开悟,GPU 也没多长出几张。这个数字把已经命中的前缀 token 算进了处理进度,量的是 serving 系统能多快推进一批长对话,不是原始 prefill 算力。
但也正因为这样,它戳中了长任务 Agent 一个很少被放到台面上聊的问题。
Agent 跑到第 30 轮、第 60 轮时,模型能力没变,工具也没变,为什么首字越来越慢,显存越来越紧,同一段系统提示词和历史记录还在被反复搬运?
很多人第一反应是上下文太长,换个更快的模型。
我对这次更新的判断有点不一样。长任务 Agent 的性能问题,正在从模型问题变成缓存身份问题。 你得知道哪段历史属于哪个会话,哪些状态还能安全复用,放在哪一层内存,什么时候该让位,关掉会话后又该清掉什么。
好家伙,聊天框背后那棵树,开始像一套真正的运行时了。
模型没变,重算越来越贵
先把 prefix cache 讲人话。
假设一个 Agent 每轮都带着同一段系统提示词、仓库说明和前 20 轮对话。模型生成第 21 轮答案之前,要先把这些输入做一遍 prefill,也就是把输入 token 转成后续生成会用到的中间状态。
其中最常见的是 KV cache,注意力层保存下来的 key 和 value。只要两个请求拥有相同前缀,前一份请求已经算过的 KV 就可以给后一份复用,没必要从第一个 token 重新来。
SGLang 很早就在用 radix tree 管这个映射。Radix tree 可以理解成按 token 序列展开的压缩前缀树。两个请求开头一样,就共享一段树枝。调度器沿着树往下找,找到最长可复用前缀,再从分叉的位置继续算。
在纯全注意力模型里,这套规则很干净。前缀匹配到哪里,KV 大体就能复用到哪里。树上的路径既是 token 身份,也是有效缓存边界。
麻烦出在新模型不再只用一种计算结构。
DeepSeek-V4 混合了全注意力和滑动窗口注意力,Kimi-K3 又把全注意力与 KDA 循环状态放在一起,Inkling 更直接,FULL、SWA、Mamba 三种状态全上了。
同一串 token,背后已经不是同一种缓存。
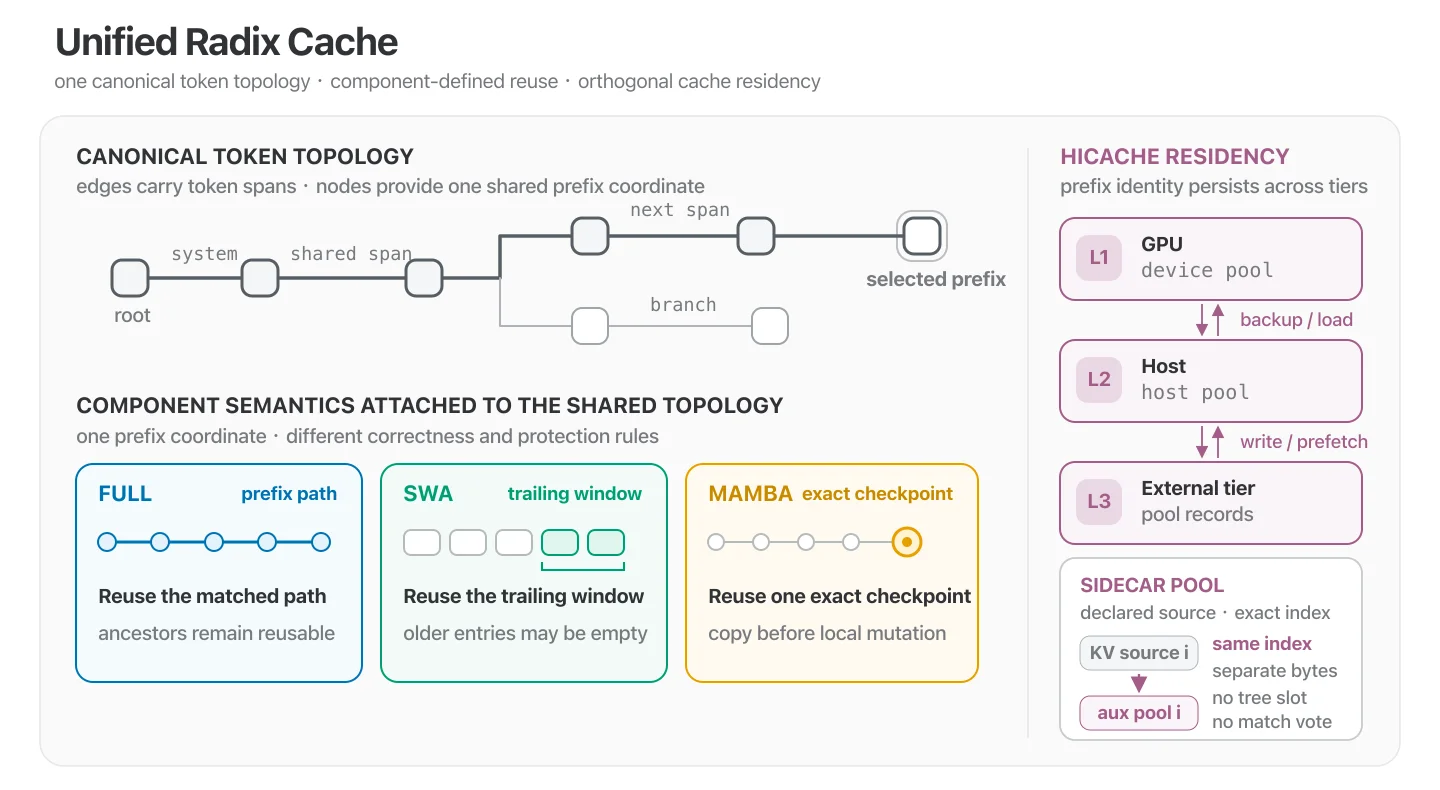
同一个前缀坐标,FULL、SWA 与 Mamba 各自判断有效边界,HiCache 再决定负载住在哪一层。
如果 serving 层还拿一条通用规则硬套,结果只有两个。保守一点,明明能复用的缓存被丢掉,性能白给。激进一点,已经失效的状态被当成有效数据塞回请求,正确性开始抽奖。
不是哥们,缓存快一点挺好,答案别跟着串台啊。
三种状态,三个有效边界
FULL 最容易理解。全注意力需要看到此前全部 token,只要前缀一致,整条已匹配路径的 KV 都有价值。
SWA 是 sliding window attention,也就是滑动窗口注意力。它只保留最近一段 token 的注意力状态。树上较早的节点还在,帮助别的组件认出同一段前缀,但对应的 SWA 槽位可能已经被窗口滑走,成了 tombstone。
Mamba 更不一样。它不是给每个历史 token 都留一份 KV,而是把此前信息压进循环状态。这个状态只有在精确检查点上才成立,复用时还要先从共享 checkpoint 复制到请求私有槽位,后续生成才能安全修改。
三者共享同一段文本,却在回答三个不同问题。
FULL 问这条前缀路径还在不在。SWA 问末尾连续窗口还齐不齐。Mamba 问这个精确检查点能不能接着跑。
Unified Radix Cache 的实现 没有给每种组合再造一棵树。它让一棵 token 树提供规范坐标,再把 FULL、SWA、MAMBA 变成独立 TreeComponent。
匹配时,树会沿着 FULL 路径继续遍历,但每个组件都有一张否决票。只有当前节点被所有组件接受,安全复用边界才会前进。某个组件在 n3 拒绝,也不会让遍历马上停下,因为它可能在更后的 checkpoint 恢复有效。系统最终取的不是走到最深的节点,而是所有组件共同接受的最深节点。
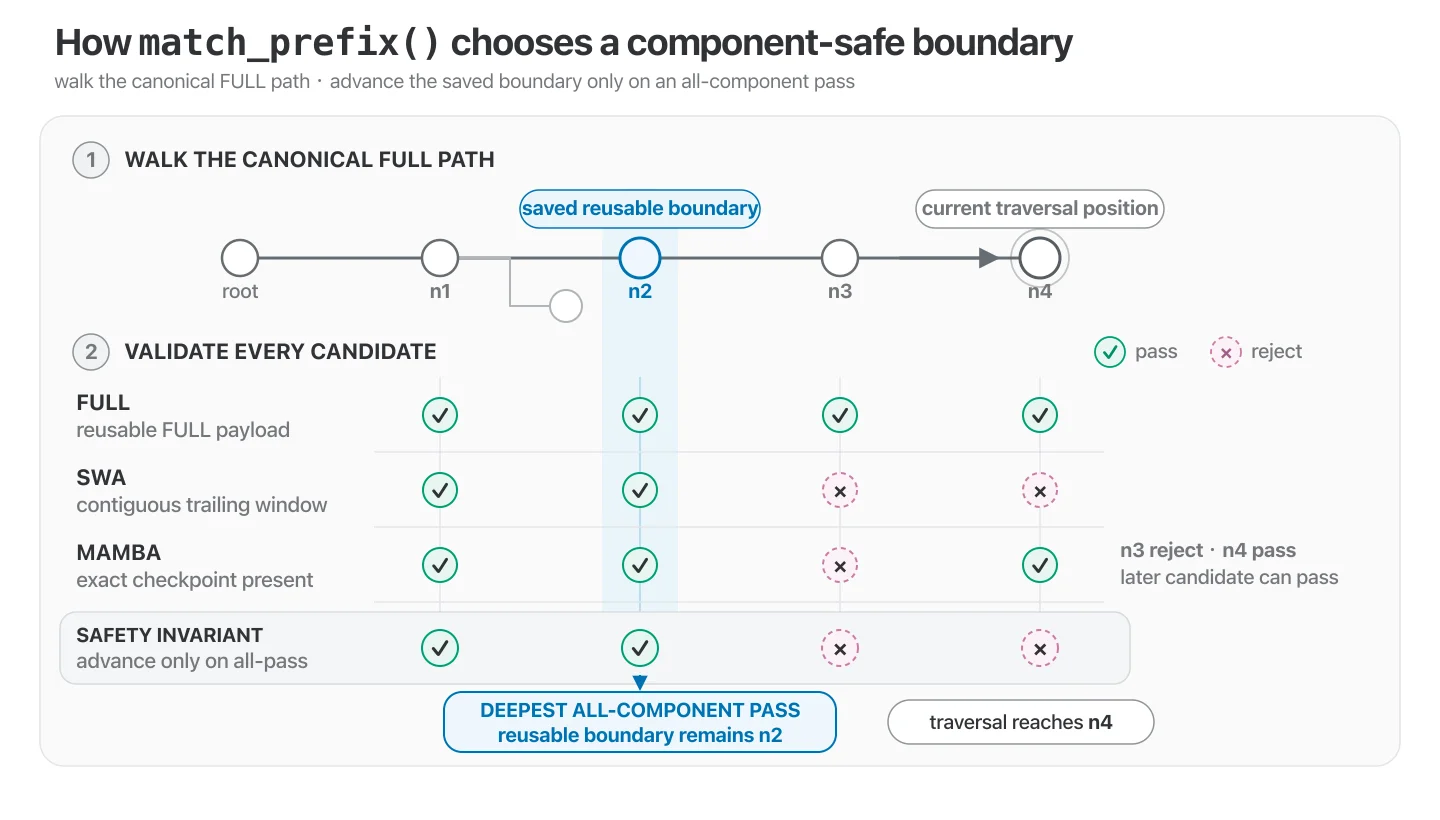
遍历可以走到 n4,真正保存的复用边界仍是所有组件都接受的 n2。
这一手有点子牛逼的地方,不是用了 radix tree。前缀树早就有了。真正值钱的是把前缀是谁和这个组件还能不能用分开。
身份只有一份,语义各管各的。
这比为 FULL 加 SWA 写一个类、FULL 加 Mamba 再写一个类、三种混合又写一个类稳得多。以后多一层 HiCache、多一个压缩 KV 池,组合不会立刻变成缓存类俄罗斯方块。
当然,代价也很真实。组件接口得覆盖 match、split、insert、lock、evict 整个生命周期。任何一个 hook 对边界理解错了,性能和正确性会一起翻车。统一拓扑没有消灭复杂度,只是把复杂度从类的排列组合搬进了可组合合同。
我是真的觉得,这个搬家方向是对的。
一棵树统一的是身份,不是内存
缓存可复用,不等于它必须一直躺在 GPU 里。
GPU 显存最快,也最贵。Host L2 慢一点,容量大一些。外部 L3 可以继续把容量拉高,但传输、预取和故障处理都会变复杂。Unified Radix Cache 把同一个组件的前缀身份带过 GPU L1、Host L2 和外部 L3,HiCache 负责数据住在哪里,组件负责这份数据有没有资格被复用。
这里还有个挺实用的设计,anchor 和 sidecar。
真正决定复用边界、或者提供页索引的池是 anchor。像压缩 KV、indexer buffer、compressor state 这类附属负载,不需要为了证明自己存在就去树上抢一个新槽位。它们作为 sidecar 跟随来源组件的索引一起移动,不参与边界校验。
这跟 Agent 工程里的状态管理很像。会话历史是主身份,工具摘要、检索结果索引、压缩记忆可能只是跟随它的附属状态。每种状态都自己发明一个会话键,迟早会出现一个已经关闭的 session,三个 sidecar 还在后台诈尸。
官方的多轮测试把这个价值放大得很明显。
DeepSeek-V4-Flash 用 4 张 H200、48 个 client 跑 60 轮,每轮输入 4096 token、输出 16 token。只有 L1 时,容量先被吃完,命中率掉下去,TTFT 开始往上爬。TTFT 是 time to first token,用户提交请求到看到第一个 token 的时间。
加上 500 GiB Mooncake Store 外部 L3 后,后期命中率仍接近 98%,平均 TTFT 保持在 9 秒以内。Inkling-Small 的另一组测试最终命中率为 96.8%,TTFT 为 1.23 秒。
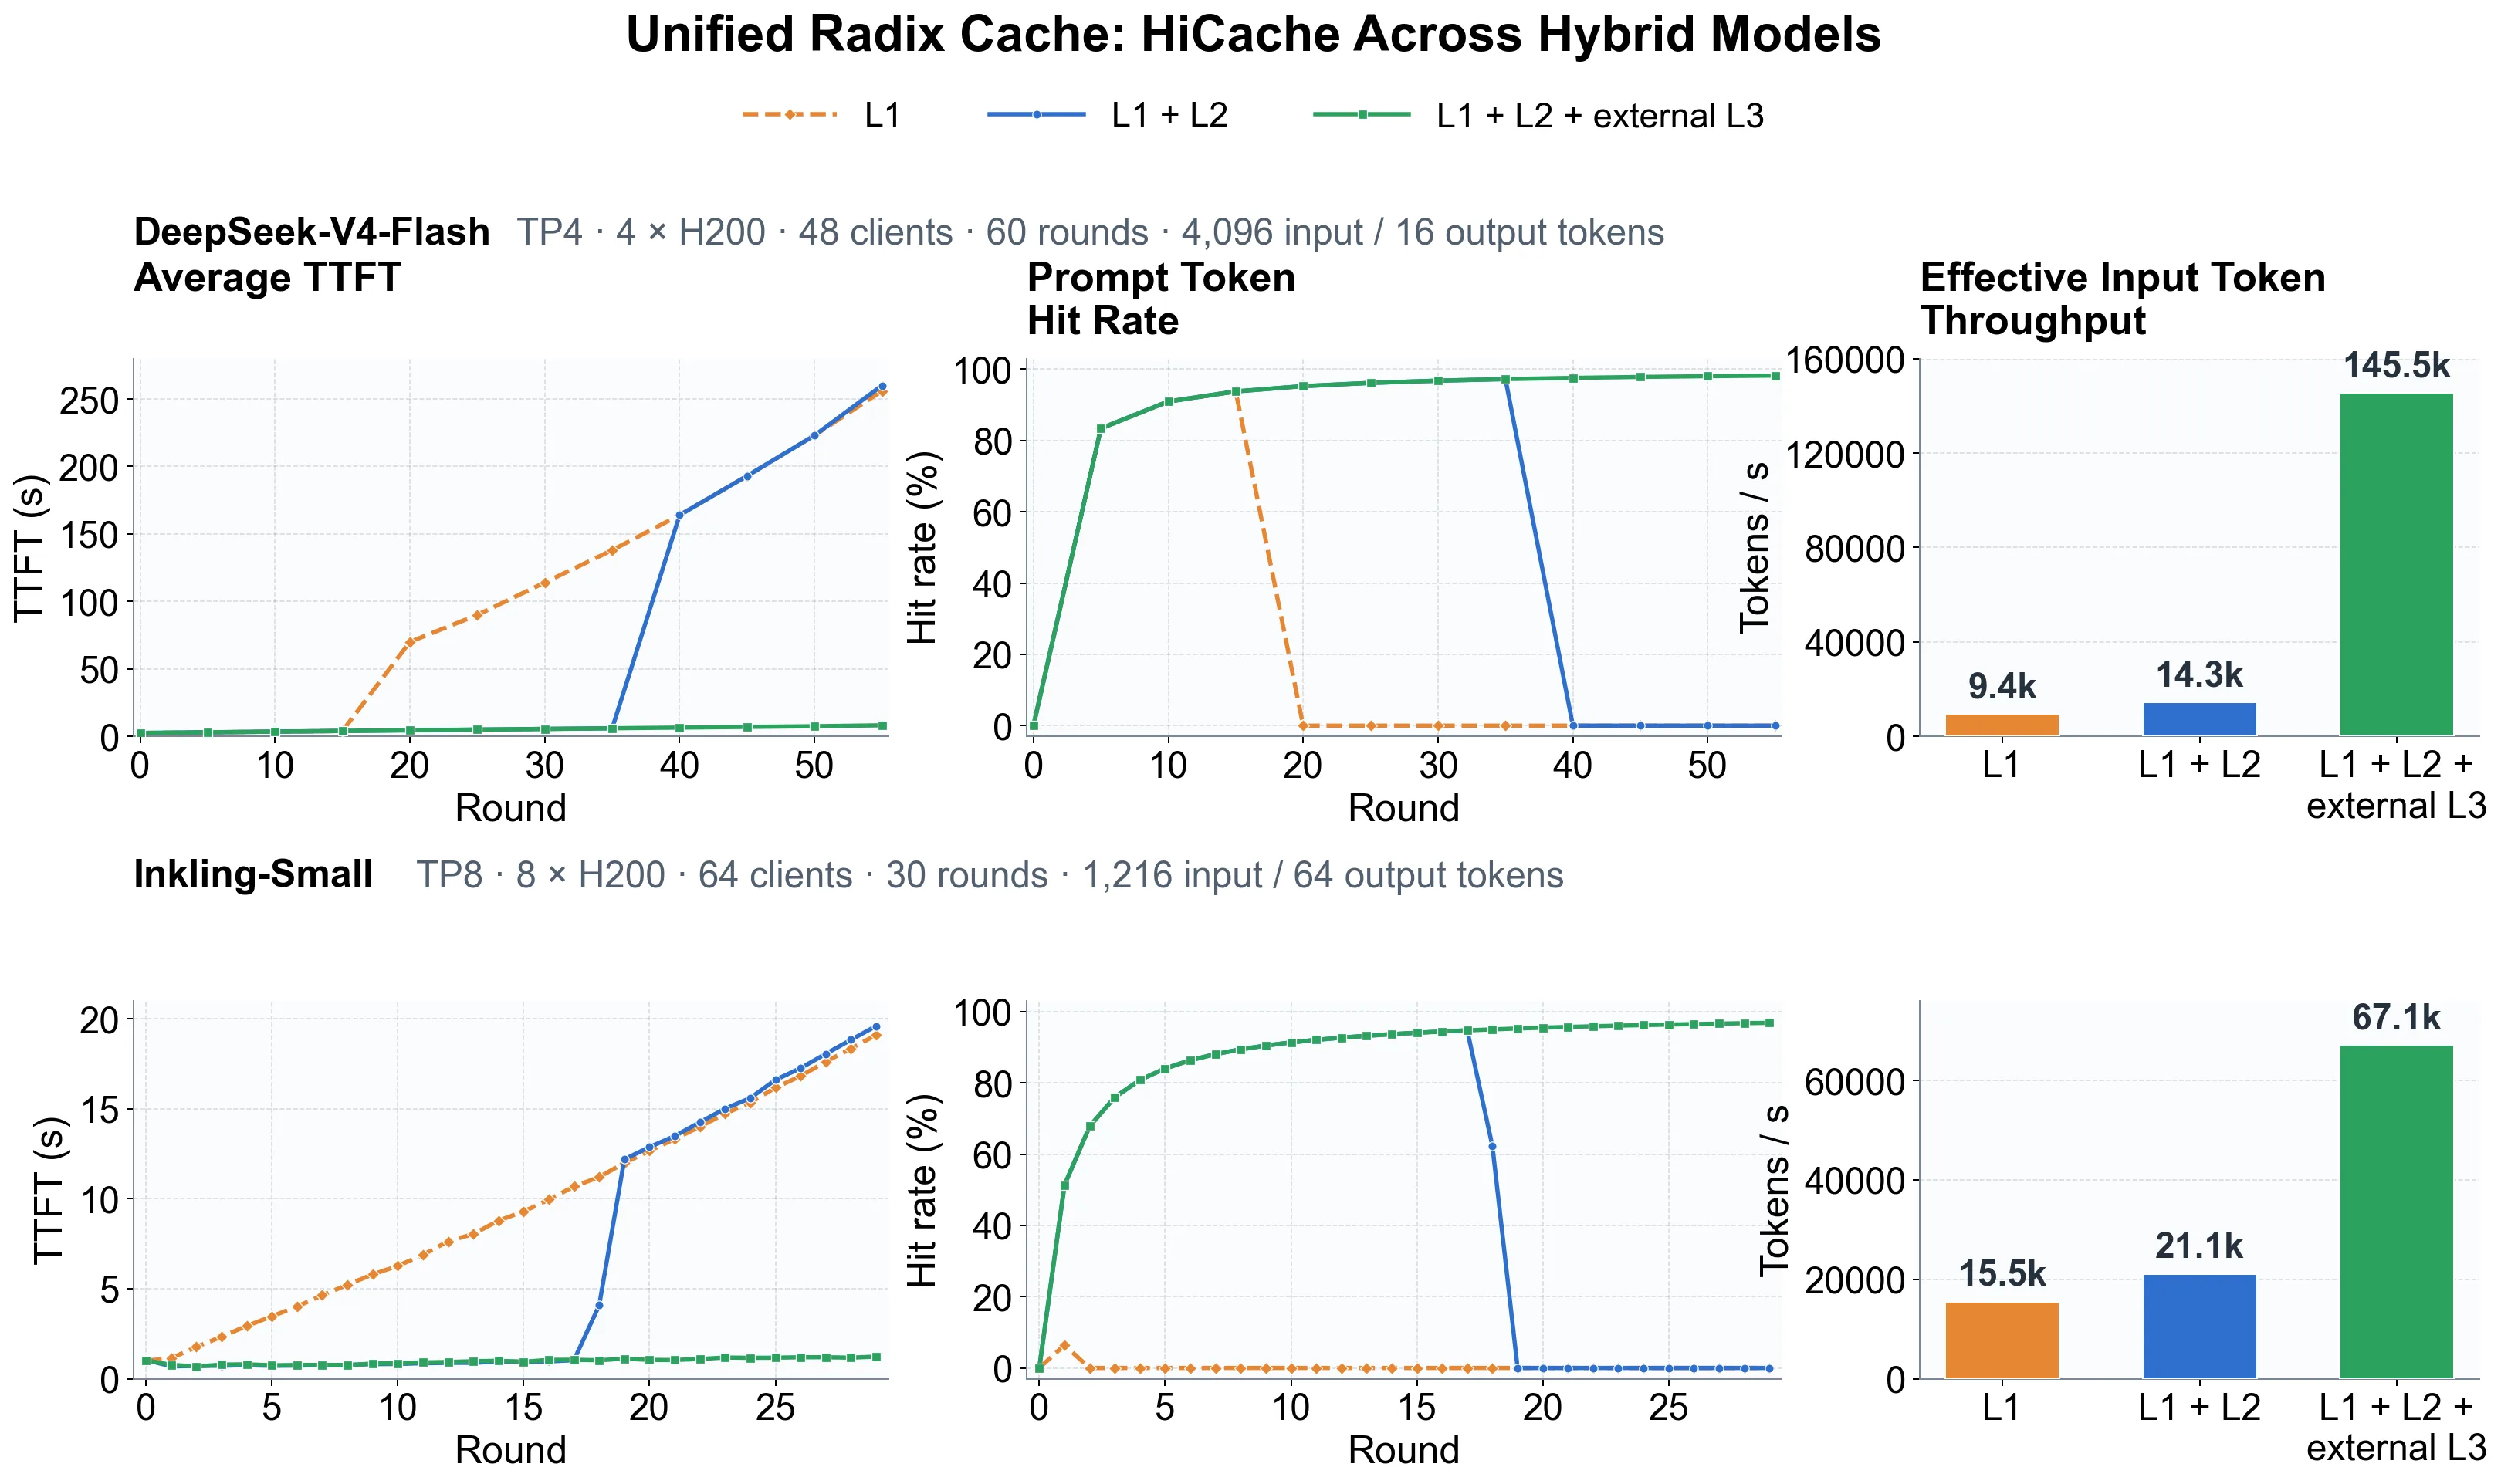
L1 与 L2 容量耗尽后命中率下跌,外部 L3 继续保留增长中的会话前缀。两行数据只能各自纵向比较。
厉害了,但这两组数字不能横着比较。模型、GPU 数量、请求形状和量纲都不同,只能在各自那一行比较 L1、L2、L3。145.5K 也不是模型凭空多算了那么多 token,而是系统没有把已经算过的长前缀再烧一遍。
对 Agent 产品来说,这个区别非常要命。用户看到的都是更快,账单背后的工程含义完全不同。一个靠更贵的 GPU 硬顶,一个靠少做重复劳动,扩容曲线不会是同一个脾气。
LRU 不知道谁还会回来
跨层存放解决了容量问题的一半,另一半是该留谁。
普通 LRU 只认最近使用时间。刚被访问过的排后面,很久没碰的先淘汰。这个规则简单、便宜,问题是它不懂会话。
一个代码 Agent 刚完成第 17 轮工具调用,正在等用户看 diff。另一个一次性摘要任务刚吞过一大段文档,已经结束。内存压力上来时,LRU 可能因为后者访问得更近,把前者下一轮必用的 KV 先扔了。
从时间看没错,从业务看挺冤。
Session-aware eviction 给每个请求附上稳定 session_id。成功完成一轮后,FULL 记录这次会话引用的前缀路径,SWA 记录末尾窗口,Mamba 记录可复用 frontier。淘汰时,系统优先动没有活跃会话引用的条目。
注意,它不是把活跃会话永久焊死在显存里。真缺内存时,被引用的条目照样能回收。session 信号只改变顺序,不取消容量纪律。
调用 /close_session 也不会粗暴删除全部缓存,而是移除会话引用。generation 和有界 tombstone 用来挡住迟到请求,免得一个旧请求在会话关掉后才返回,又把已经释放的引用复活。
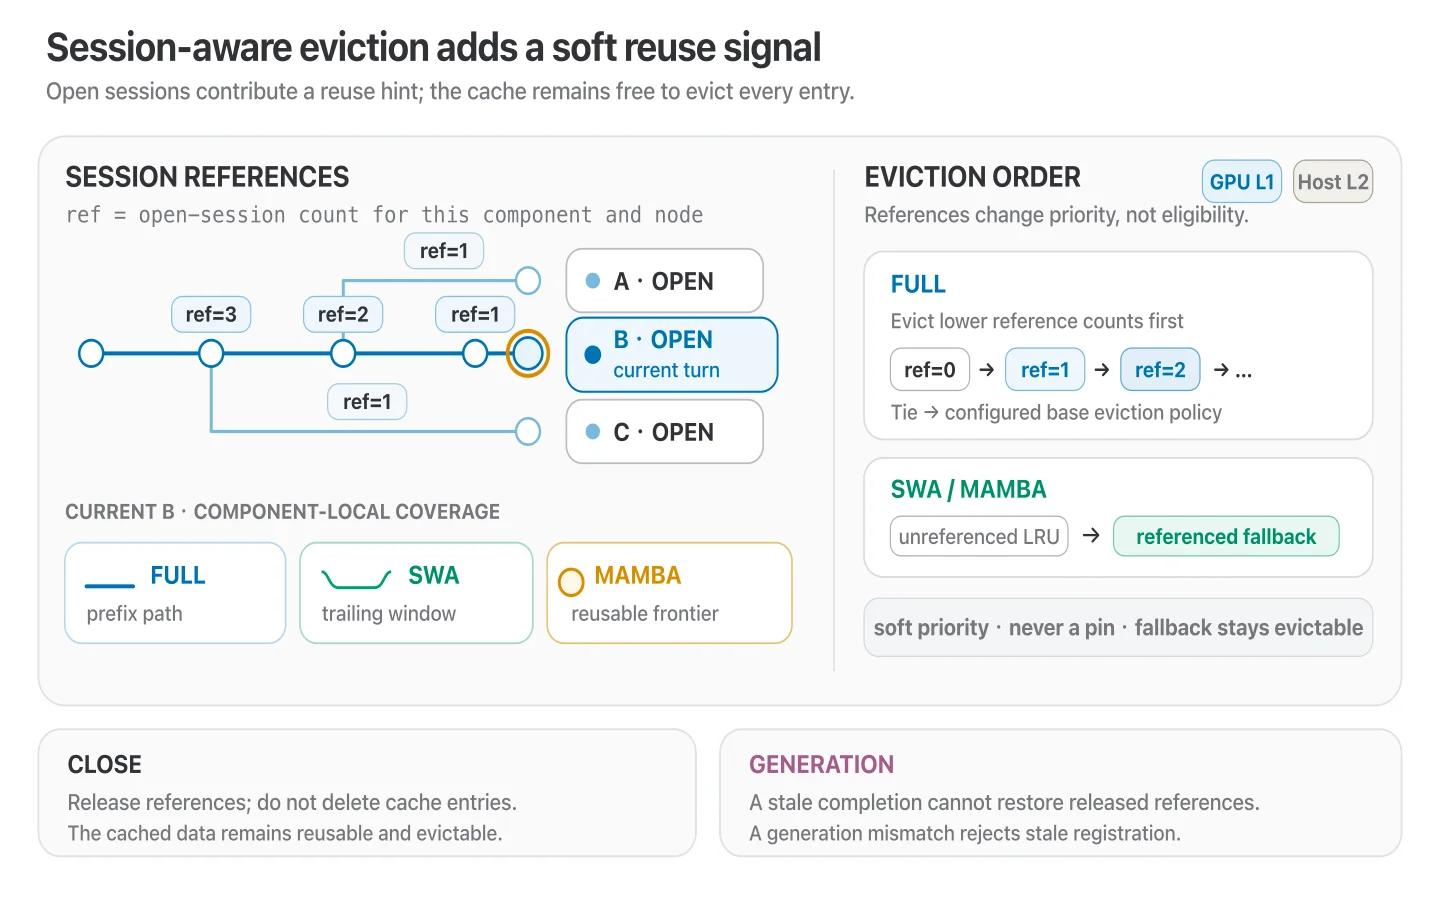
活跃会话提供软优先级,关闭会话释放引用,generation 拦住迟到请求恢复旧状态。
这块对做多 Agent 编排的人很有启发。启动 subagent 时给稳定 session,任务完成后明确 close,失败重试沿用还是新建 generation,要在运行时合同里写清楚。只把几十轮消息拼成一个大 prompt,却不给缓存层任何生命周期信号,等于一边喊着要长期记忆,一边每轮都让基础设施猜这段记忆还有没有主人。
官方在 SWE-bench agent trajectory 上报告了 2.9% 到 16.6% 的 TTFT 降幅。这个结果可以当方向信号,不能当纯 session-aware 消融,因为对照组还换了缓存实现。怎么说呢,结论还没干净到能印在采购单上,但足够让做长任务系统的人把 session_id 从可选字段挪进设计评审。
Rust 很香,原型还是原型
前缀越长,树遍历、锁计数、LRU 更新和淘汰扫描越容易挤进调度器关键路径。模型正在 GPU 上狂奔,Python 调度器还在一棵大树里翻节点,画面多少有点荒诞。
实验性的 Rust Unified Radix Cache 把 radix 拓扑、组件锁、侵入式 LRU 和淘汰遍历交给 Rust。Python 继续掌握请求到 token 的映射和物理 KV 分配。Rust 修改完树,只把待执行动作交回 Python。
200 轮合成对话里,SWA 工作负载的总体 TTFT 下降 38%,末尾 25 轮下降 42%。全注意力总体下降 10%,混合 SSM 下降 5%。
数字很好看,边界也得一起看。
这个原型目前只支持 L1,不支持 HiCache。图里拿总 TTFT 减掉 GPU prefill 区间得到的 residual,还混着调度、同步、采样、detokenization 和传输,不能直接叫 CPU 时间,更不能把全部差异都记到 radix tree 头上。后续 可替换 tree core 的 RFC 目前只支持 FULL,也没有公布性能结果。
所以别看到 42% 就马上写进 SLA。先把它当成一张路牌,树状态机值得原生化,pool 分配和编排仍留在 Python,两边靠清晰动作合同衔接。
做长任务 Agent,先验收这份合同
如果你的 Agent 只有两轮问答,这套东西可能比问题本身还重。要是它会跑半小时、开多个 subagent、反复调工具、在同一仓库里回来几十轮,缓存就不该继续当 serving 框架里的黑盒。
我会先盯四个字段,它们比一张漂亮的首 token 延迟截图更有用。
prefix_identity  哪些请求真的共享同一段前缀
reuse_boundary   每类状态最深能安全复用到哪里
session_signal   活跃、关闭、重试与迟到请求怎样区分
storage_tier     L1、L2、L3 何时晋升、降级、预取与淘汰
然后再问失败路径。L3 暂时不可用时,是回到 L2 还是整段重算。subagent 合并后,谁拥有共享前缀。工具返回把中间历史改写了,旧 checkpoint 是否还能复用。会话关闭之后,sidecar 会不会留下一份没有主人的状态。
这些问题很烦,也没有模型发布会上的跑分好看。
可 Agent 真正跑起来,成本往往就藏在这些不性感的地方。
SGLang 的 agentic KV caching 路线图 已经把目标放到了整个 serving stack。未来不只本地 allocator 知道缓存是谁的,router、prefill worker、decode worker 和 HiCache 都要围绕 session、subagent、tool call 协同预取、保留与降级。
回到开头那组 145.5K 对 9.4K。
它最值得看的不是十几倍的视觉冲击,而是一个朴素事实。长上下文不该每一轮都被当成模型的新负担,它应该成为运行时里有身份、能迁移、会过期的资产。
模型负责往前生成,缓存负责记住哪些路已经走过。
一条航线跑到第 60 轮还要从港口重新出发,那就不是船慢,是海图根本没留下来。