posts/vera-rubin-work-per-watt.md
Vera Rubin 的 30 倍,不是一块 GPU 赢的
30 倍。
这个数字放在新 GPU 的发布稿里,很容易被读成一次暴力的代际碾压。晶体管更多,显存更快,机柜更贵,然后旧机器集体去角落吃灰。
可 NVIDIA 在 8 月 24 日公布的 Vera Rubin NVL72 Agent 工作负载数据,讲的不是一块 Rubin GPU 比上一代快 30 倍。
它讲的是一整套系统,在同样一兆瓦电力里,最多能完成 30 倍的 Agent 工作量。这里面有 GPU,有 HBM4,有 NVLink,有功耗调度,有 NVFP4 量化,有分离式推理,有 KV cache 路由,还有一串让模型少等数据、少做重复计算的软件优化。
好家伙,芯片发布稿写到这里,主角已经不是芯片了。
我自己的判断是,30 倍当然值得兴奋,但更值得 Agent 团队抄走的不是某张采购清单,而是 NVIDIA 悄悄换掉了性能问题的问法。
过去我们爱问每秒能吐多少 token。现在该问的是,在固定的电力、成本和延迟预算里,系统到底完成了多少有质量的工作。
Agent 的性能单位,不该只是 tok/s,而该是每一度电、每一块钱能完成多少合格任务。
聊天只走一程,Agent 会反复折返
OpenRouter 的公开数据显示,Agent 型工作负载消耗的 token 约是简单聊天请求的 15 倍。
这个差距并不神秘。一次聊天大多是输入一段,输出一段。一个能干活的 Agent 却要读仓库、搜文档、调用工具、检查结果,发现不对再回去改。它还可能拉起子 Agent,把几个分支的结果合回来。前一步积累的上下文,会成为后一步继续推理的输入。
聊天像从站点 A 坐到站点 B。Agent 更像一个维修工,先去仓库拿工具,再到现场排查,少了零件又折返回去,修完还要通电验收。
路程长了,性能瓶颈也变了。
短对话里,模型首 token 出得快、解码速度高,体验就不错。长任务里,prefill,也就是处理已有上下文的阶段,会不断吞进更长的历史。decode,也就是逐 token 生成的阶段,又要频繁读模型权重和 KV cache。中间还夹着工具调用、网络等待、子任务汇合和失败重试。
你如果只盯着 tok/s,会看到模型输出时跑得飞快,却看不到它在两个工具调用之间空转了多久,也看不到相同上下文被多少台机器重复算了一遍。
这类系统最会制造一种假繁荣。
GPU 利用率漂亮,token 曲线也漂亮,任务就是没交付。
NVIDIA 这次采用的 SemiAnalysis AgentX 工作负载,价值就在这里。它不是拿一段固定 prompt 连续压测,而是重放真实 Agent 编码会话的轨迹,保留上下文增长、工具调用和子 Agent 创建。测量对象从一次推理,变成了一段会长大、会分叉、会等待的工作过程。
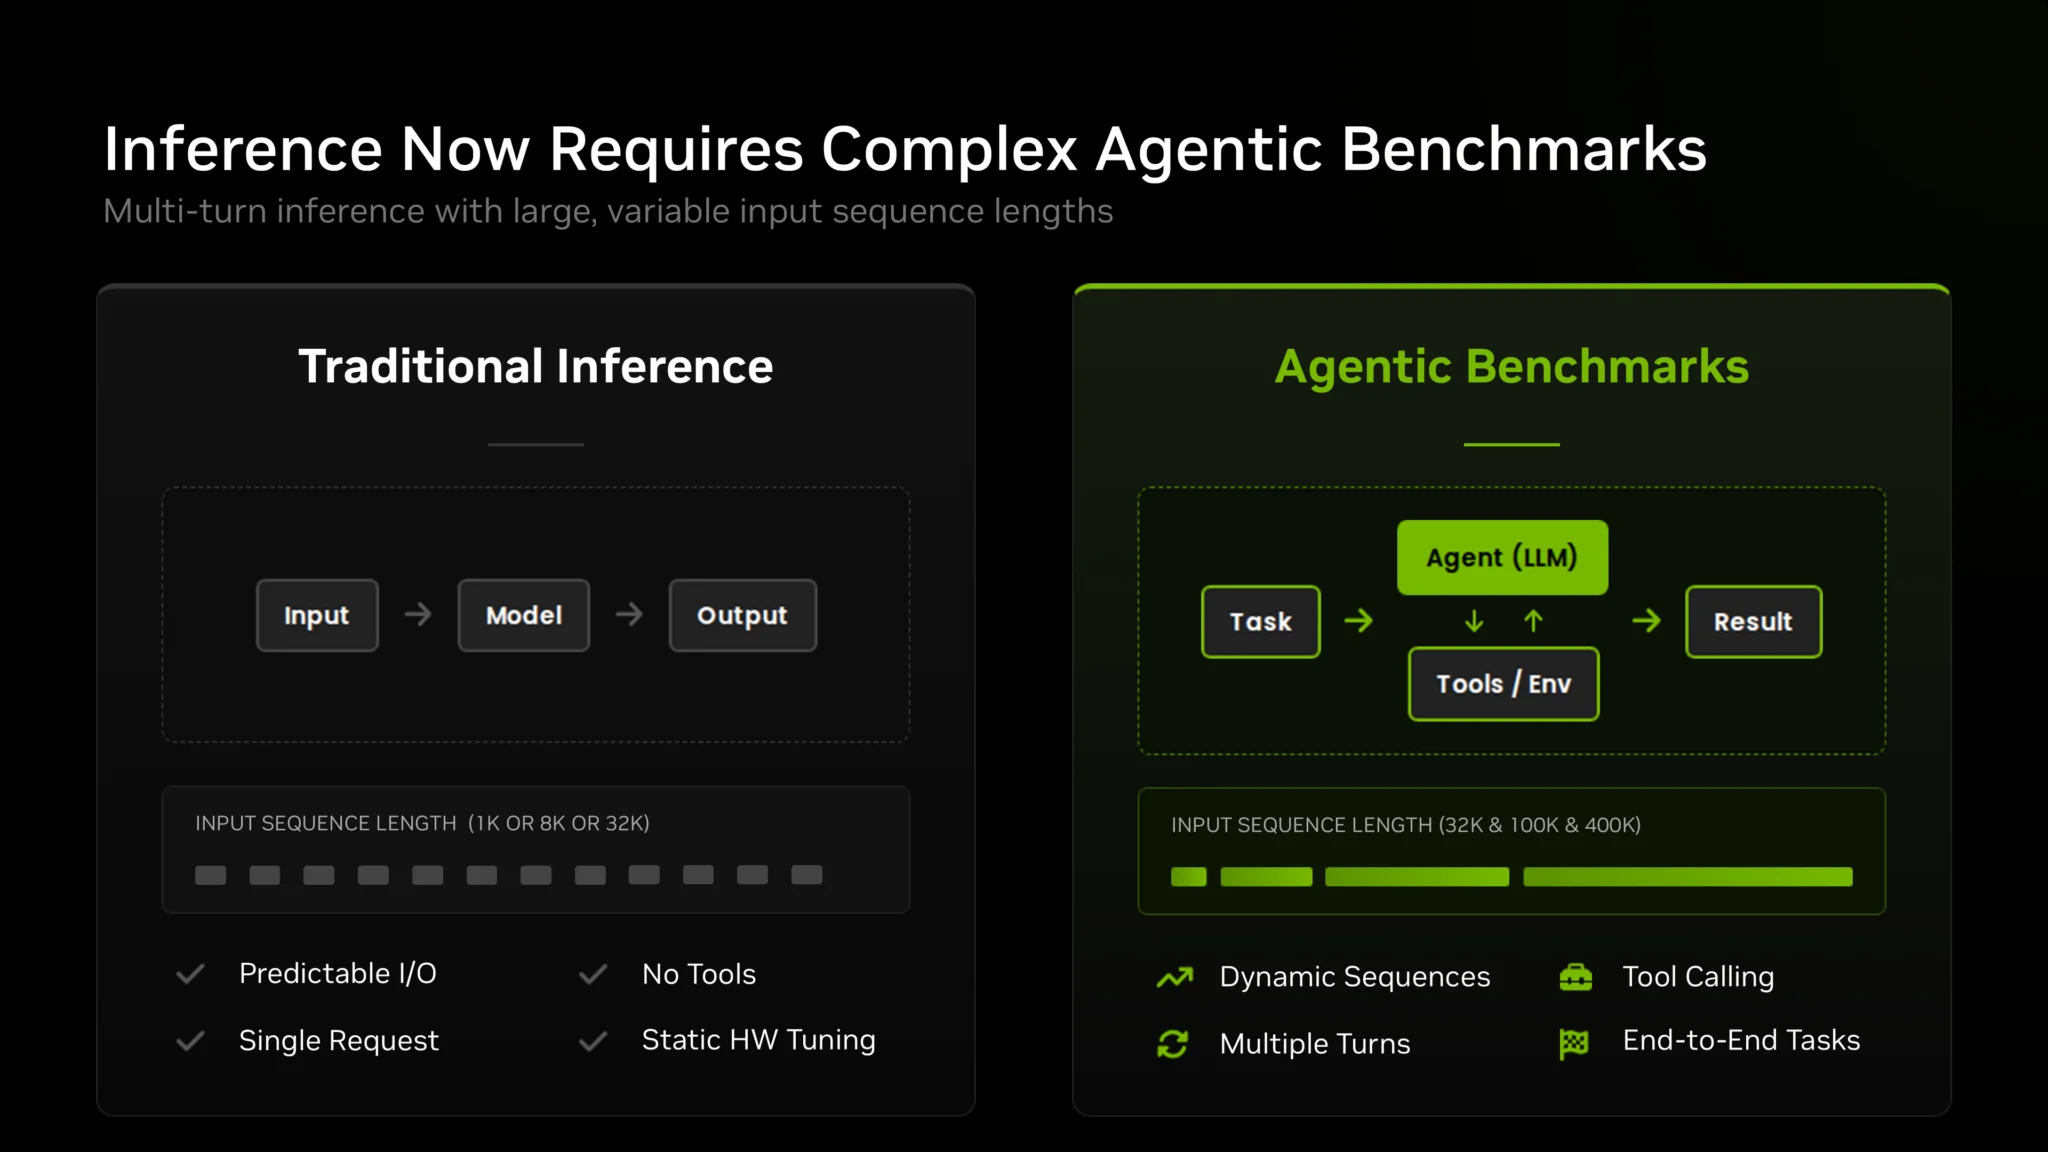
NVIDIA 官方图,Agent 基准会保留动态上下文、多轮交互、工具调用和端到端任务。
这个改法有点子牛逼。
因为生产环境里的 Agent 从来不是一台只负责吐字的打字机。它是一条流水线,任何一段排队、搬运、重算和等待,都会让昂贵的计算资源站着发呆。
AgentX 还有一个容易被标题遮住的细节,它比较的是一条帕累托曲线。
横轴可以理解为每个 Agent 获得的交互速度,纵轴是整个系统同时承载的吞吐量。你可以给单个用户更低延迟,也可以用更大批次换取总吞吐,但两者不能假装互不影响。真正好的系统,不是在某一个极端点跑得漂亮,而是在不同服务目标下都能把这条边界往外推。
这和很多线上压测的翻车方式正好相反。
有人把 batch size 开到很大,tokens per second 一路起飞,随后宣布吞吐提升。用户那边却要等更久才能看到下一步动作。也有人把并发压得很低,拿到极漂亮的延迟,再回避同一套机器能服务多少任务。
两个数字都没撒谎,放到一起才接近事实。
所以 NVIDIA 写「整条帕累托曲线提升」比单独报一个峰值更有信息量。可复现时也必须保留同一条规矩,在相同的任务质量和交互速度下比吞吐,或者在相同吞吐下比延迟。别让一套系统跑短跑,另一套系统背着行李爬山。
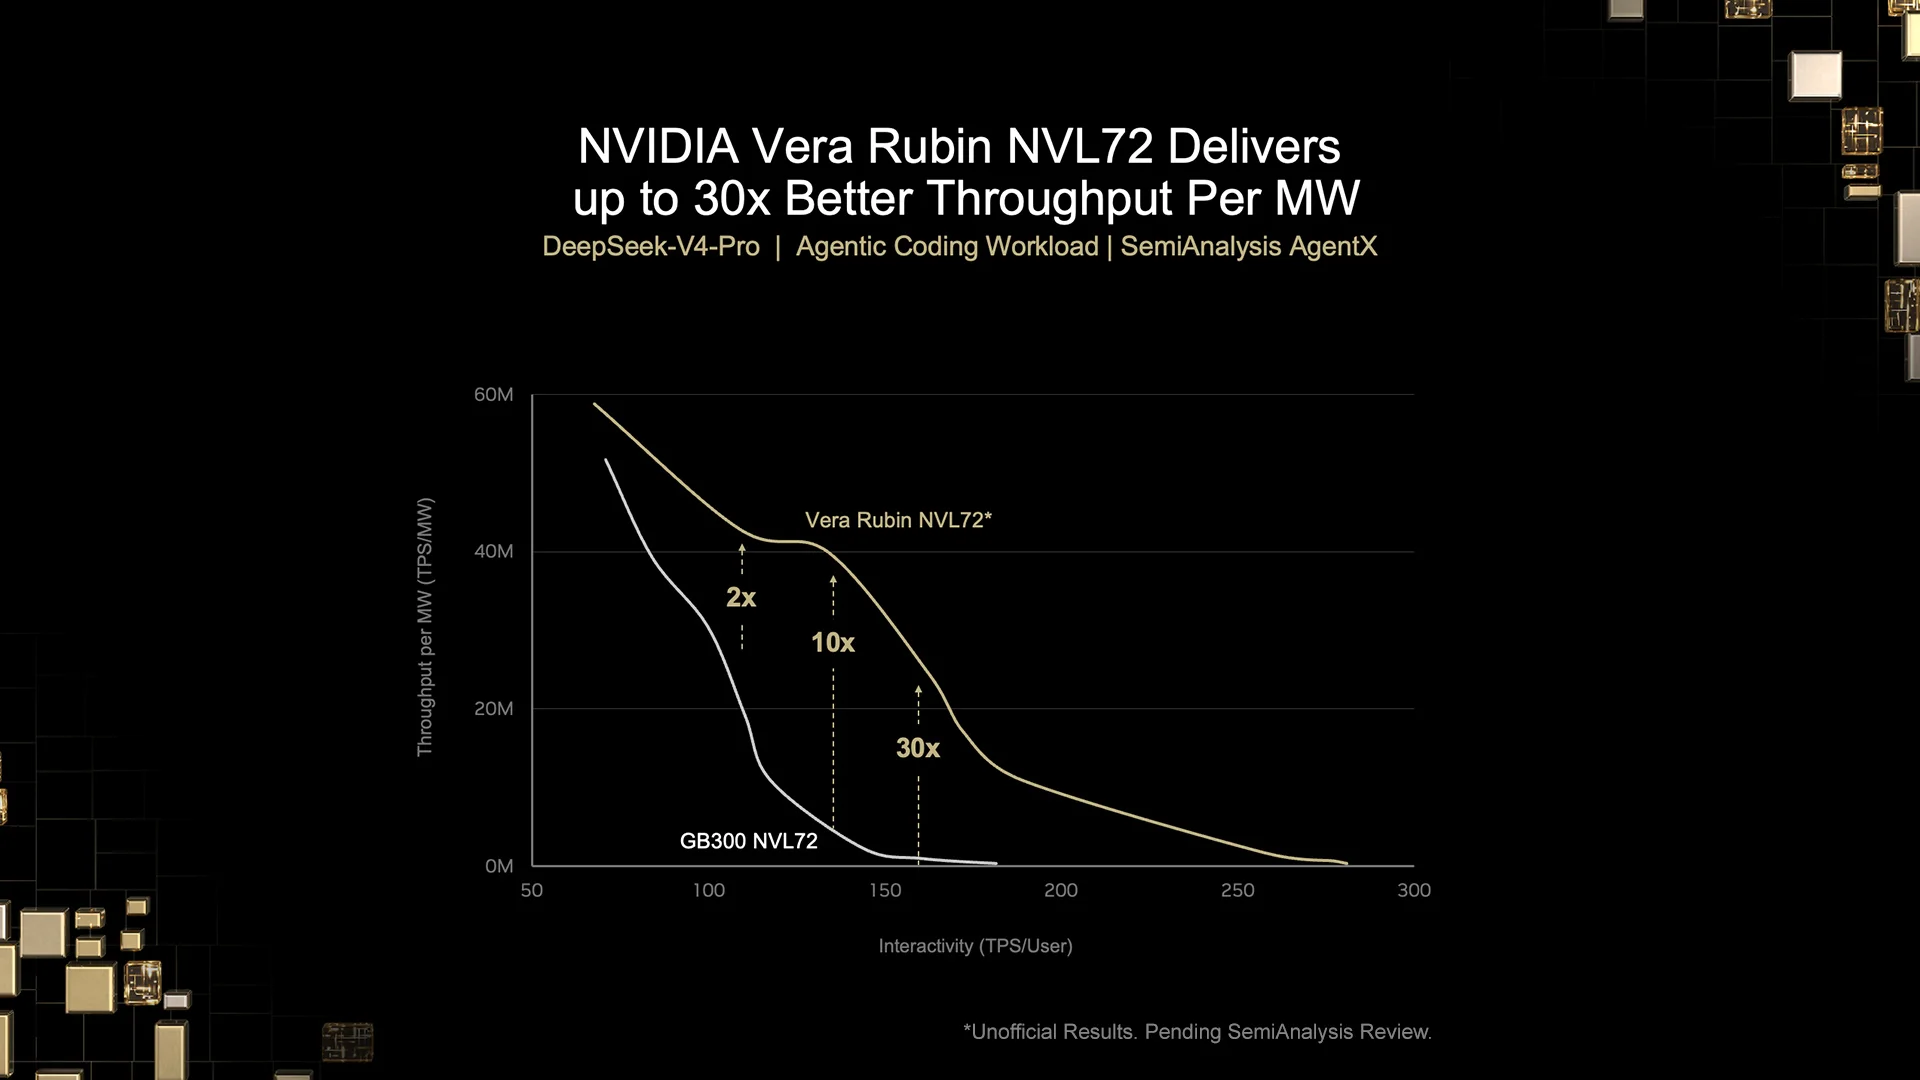
NVIDIA 官方早期结果,DeepSeek V4 Pro 在不同交互速度下的 AgentX 每兆瓦吞吐量,数据仍待 SemiAnalysis 审核。
30 倍藏在一整条栈里
先把数字边界钉牢。
NVIDIA 的结果针对 DeepSeek V4 Pro,在 AgentX 真实编码轨迹上比较 Vera Rubin NVL72 与 GB300 NVL72。官方写的是整条帕累托曲线都有提升,峰值达到每兆瓦吞吐量 30 倍,每百万 token 成本最多降低 35 倍。
它同时写明,这批数据由 NVIDIA 测量,仍在等待 SemiAnalysis 审核,而且还没有计入 Vera CPU 在工具调用环节的性能。
所以,别急着把 30 倍贴到所有模型、所有任务、所有延迟目标上。更不能把它缩写成 Rubin GPU 单芯片性能提升 30 倍。厂商口径里的「最高」二字,永远应该和测试模型、精度、服务目标、系统规模一起保存。
官方还给了另一个「最高」,GB300 NVL72 在同一类 Agent 场景里,每兆瓦吞吐量可达 Hopper 的 15 倍。这里最容易发生的误读,是顺手把 15 和 30 乘起来,得到一个更适合做海报的数字。
先忍住。
每一个「最高」都对应曲线上的特定点。模型、量化精度、并发、延迟目标和软件版本只要有一项不同,两个倍率就未必能直接连乘。保留原始曲线和测试配置,比记住一个巨大倍数更重要。跑分不是不能看,跑分需要带行李牌。
边界讲清楚以后,再看这 30 倍从哪来。
硬件当然贡献很大。Rubin 架构技术文章披露,单颗 Rubin GPU 有 288GB HBM4,峰值内存带宽达到 22TB/s,是 Blackwell 的 2.8 倍。Agent 的长上下文和大 KV cache 很吃内存容量,逐 token 生成又很吃内存带宽。这个提升正好顶在最难受的地方。
Rubin 的 Tensor Core 每个时钟周期能处理两倍的 K 维数据,长上下文 attention 也加入激活稀疏、压缩和更快的 softmax。第六代 NVLink 则给 GPU 间通信提供每颗 GPU 3.6TB/s 的纵向扩展带宽。
但硬件只是第一层。
在机架层,Vera Rubin NVL72 把 72 颗 Rubin GPU、36 颗 Vera CPU、NVLink Switch、网络、液冷和功耗控制放进同一个执行域。NVIDIA 的系统级技术说明提到,DSX MaxLPS 会在 GPU、机架和工作负载之间平滑功耗波动。在固定电力预算下,它最多能多部署 40% 的 GPU。
注意,这 40% 已经不是晶体管跑得更快,而是过去被峰值功耗卡住的容量重新被利用起来。
再往上是推理软件。
分离式服务把 prefill 和 decode 放到不同资源池,让长上下文处理与逐 token 生成各自扩缩。速率匹配避免一边堆满队列、另一边等米下锅。分布式 KV cache 把历史上下文留在更合适的层级,感知缓存的路由把请求送回已经持有相关状态的 GPU。MegaMoE 之类的融合 kernel 又把计算和通信压进一次执行,少一次交接,就少一段气泡。
这部分不是发布稿里的空气。NVIDIA 的 TensorRT-LLM 和 Dynamo 都已经把不少能力放到公开仓库里。前者负责把模型推理压到 GPU 上高效执行,后者更靠近分布式服务和调度层。硬件卖的是机架,软件处理的是请求怎样进来、上下文放哪、下一步去哪块 GPU。
如果路由不知道缓存在哪,再快的 HBM 也会被重复 prefill 浪费。如果 prefill 和 decode 的供给不匹配,某一池 GPU 会排长队,另一池却吃不饱。Agent 上下文越长,这些调度错误越贵,因为重算的不是几百 token,而可能是几十万 token 的历史。
还有 NVFP4。
4 位量化会减少权重体积和数据搬运,让同一套内存系统承载更多工作。它很有效,但也进一步说明,30 倍不是拿两块芯片在完全相同条件下跑出来的孤立数字,而是硬件、精度、模型、调度和服务软件一起交出的系统成绩。
不是哥们,这哪是一块 GPU 赢了。
这是整条栈终于少让 GPU 等了一会儿。
真正该抄的是效率合同
多数团队短期内不会买一整套 NVL72,更不会自己建一座按兆瓦算账的 AI 工厂。那这件事和普通 Agent 工程师有什么关系?
关系其实很直接。
同样的浪费,只是发生在更小的机器上。
一个 Agent 任务跑了十分钟,其中两分钟在模型推理,三分钟等搜索接口,两分钟因为上下文路由错误重复 prefill,还有三分钟在失败重试。你把模型 tok/s 提高 50%,整条任务也不会快 50%。更尴尬的是,它可能因为跑得更快,多生成了一堆没通过验收的内容。
所以测效率时,需要先给「完成工作」下定义。
对编码 Agent,它可以是测试通过、静态检查通过、修改范围没有越界的任务。对客服 Agent,它可以是问题解决、引用正确、没有触发人工回退。对研究 Agent,它可以是证据链接可访问、结论能被原文支持、关键反例没有遗漏。
质量门槛不固定,吞吐量就没有意义。垃圾答案一天产十万份,电费再低也只是更高效地制造返工。
接着要固定真实轨迹。
从生产日志里抽取有代表性的长任务,保留上下文增长、工具等待、重试和子 Agent 分叉。不要把工具返回删掉以后,只留一个干净 prompt 去测模型。那样测到的是实验室里的短跑,不是上线后的越野。
任务集还得分层。短问答、长上下文检索、多工具编码、并行子任务不要混成一个平均数。平均数特别擅长藏问题,一个两秒完成的简单任务,可以把另一个卡了四分钟的长任务遮得干干净净。把任务类型、上下文长度和工具次数作为标签留下,才能看出优化到底救了谁,又伤了谁。
然后把几本账放到一起看。
每小时完成多少合格任务,p95 端到端延迟是多少,每个成功任务用了多少输入和输出 token,prefill 与 decode 各花多少时间,KV cache 命中率多少,工具等待占比多少,失败重试烧掉多少成本。如果能拿到功耗数据,再算每千瓦时完成任务数。如果拿不到,至少算每元成本完成任务数。
p95 不能省。Agent 工作流有一串串依赖,任何一个工具抖一下,尾延迟就会往后传。只看平均延迟,很可能所有人平均都挺快,偏偏最重要的那批长任务天天超时。用户不会感受到你的平均数,他只会记住那次等了八分钟还没交付的任务。
成本要除以成功任务,不能只除以 token。
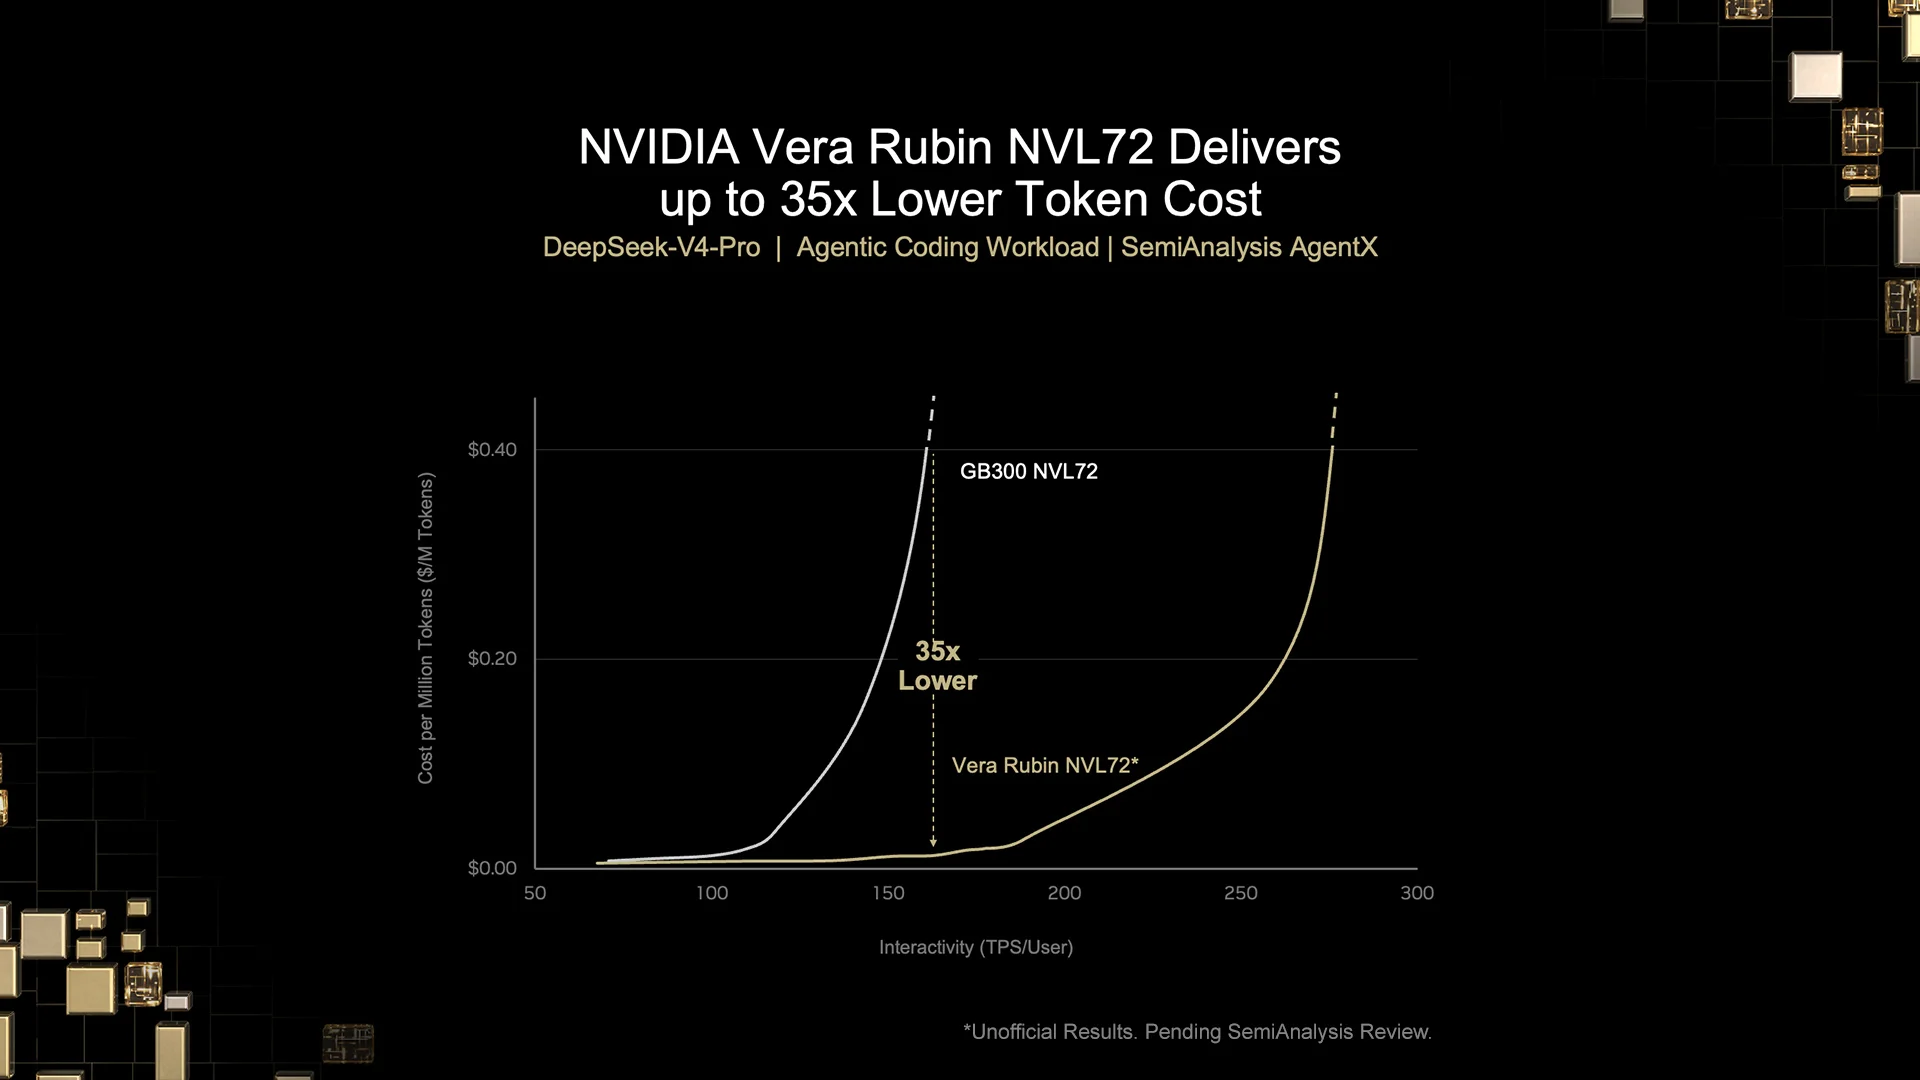
NVIDIA 官方早期结果,同一 AgentX 负载下每百万 token 成本最高降低 35 倍,不能直接外推到所有模型与服务目标。
这一步特别重要。两套系统都生成一百万 token,A 完成了 800 个任务,B 完成了 500 个。B 的 token 单价便宜 20%,也可能是更贵的方案。因为它把钱省在输出上,又从重试和人工接管里花了回去。
改动时也别一锅炖。
先换 KV cache 路由,再测一次。再拆 prefill 与 decode,再测一次。再调整量化精度和批处理策略,重新跑质量门槛。一次只改一个主要变量,保留模型版本、任务集和服务目标。否则数字涨了,你却不知道是哪一层立了功。
每次结果至少要能回到一份运行记录。里面写清模型与权重版本、量化格式、硬件拓扑、服务软件提交号、并发、上下文长度分布、工具等待是否计入、质量判定器版本和失败重试规则。少一项,后面就多一次「怎么今天复现不出来」的望天。
等这套记录稳定以后,团队才有资格讨论哪一层值得花钱。缓存命中率低,就先修路由。大量时间耗在工具上,就给 API 做并发、超时和熔断。decode 被内存带宽卡住,再评估量化和新硬件。没有诊断就买卡,通常只是把等待搬到更贵的机器上。
坦率讲,这套验收会比跑一个 tokens per second 麻烦很多。可生产环境从来不会因为指标简单,就配合你变简单。
每瓦特工作量,才是 Agent 的新跑分
NVIDIA 把每兆瓦吞吐量写进标题,当然有卖整套基础设施的商业动机。30 倍和 35 倍也都来自厂商早期测量,第三方复核、更多模型、更多服务目标还得继续看。
该踩的刹车,一脚都不能少。
但它提出的问题是对的。
Agent 时代的计算,不再是模型连续吐字那么简单。上下文会长大,任务会分叉,工具会等待,缓存会漂移,失败会重试。真正昂贵的地方,常常不是 GPU 算得慢,而是整套系统让 GPU 在错误的时间处理错误的数据,或者干脆等着什么都不做。
芯片参数仍然重要,模型跑分也仍然重要。只是它们不再是终点。
终点是一项工作有没有完成,质量有没有过线,用户等了多久,系统为它付了多少电和多少钱。
回到开头那个 30 倍。
它最有价值的读法,不是 Rubin 突然比上一代聪明了 30 倍,而是当硬件、内存、网络、功耗和软件围着真实 Agent 轨迹重新排队,昂贵的硅终于少等了一会儿。
厉害了。
这次真正赢的,是系统。