posts/verification-before-completion-skill.md
代码验收 Skill 19.5 万次安装,先跑证据再说完成
一个代码 Agent 改完 Bug,回你一句「修好了」。
你问它跑测试了吗。
它说,改动很小,逻辑看起来没问题,应该能过。
好家伙,三个词凑齐了,看起来、应该、能过。这不是交付报告,这是程序员版本的天气预报。
最近在 skills.sh 上,一个名字很直白的代码验收 Skill 冲到了 194,693 次安装。它叫 verification-before-completion,来自 obra/superpowers 仓库。写稿时仓库有 279,734 个 GitHub Star,最近八周每周安装量仍在七千到九千之间。
安装也不绕弯。完整的 Superpowers 还提供各类 Agent 的官方安装说明,这里只装这一道验收门。
npx skills add https://github.com/obra/superpowers --skill verification-before-completion它不帮你写函数,不帮你改 UI,也不给 prompt 涂金边。它只在 Agent 准备说「完成」的时候挡一下,要求把新鲜的命令、完整输出、退出码和失败数拿出来。
我们经常拿容易获得的证据,替代真正需要的证据。
页面公开数据为 19.47 万次安装,仓库约 27.97 万 Star。热度只能证明注意力,不能代替效果验证。
它解决的不是测试,而是证据错配
这个 Skill 的核心规则只有一句。
NO COMPLETION CLAIMS WITHOUT FRESH VERIFICATION EVIDENCE没有当前任务里的新验证证据,就不能声称完成。
它在公开源码里给了一个五步闸门。先问什么命令能证明当前声明,再完整执行命令,读完输出和退出码,核对证据是否真的支持声明,证据对上之后才允许开口。
顺序不能反。
很多假完成并不是完全没跑命令,而是跑错了命令。Lint 没报错,就顺手说构建成功。单元测试过了,就顺手说需求已经满足。子 Agent 回了 success,就顺手把任务状态改成 done。
我做了一个小得不能再小的 Python demo。add(2, 3) 里面故意写成减法。先执行 Python 官方文档里的 py_compile 语法检查,退出码是 0。
python3 -m py_compile calculator.py如果声明只是「这个文件没有 Python 语法错误」,证据够了。
但如果声明是「加法 Bug 已修」,这条命令一个字都证明不了。继续运行复现原始症状的单测,结果马上露馅。
test_adds_two_positive_numbers ... FAIL
AssertionError: -1 != 5
FAILED (failures=1)
exit=1
修复为 return left + right 后,再跑 Python 自带的 unittest 完整单测,才得到 OK 和 exit=0。
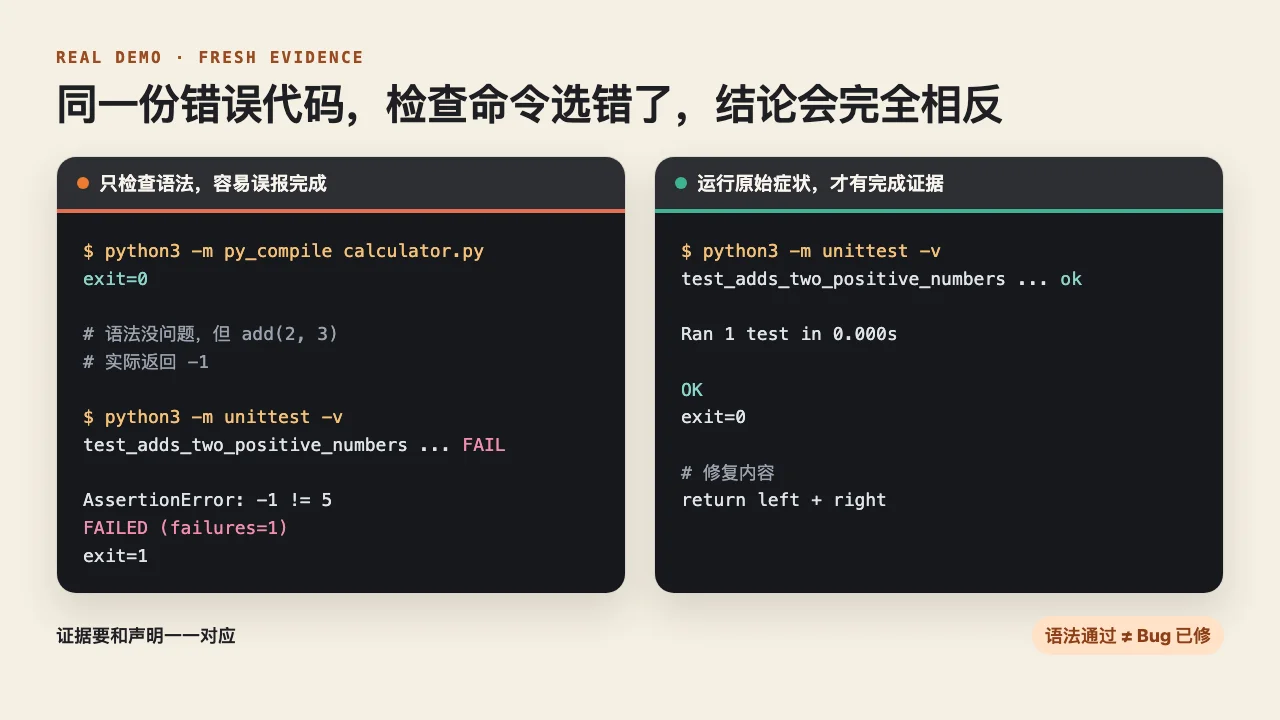
这是本文本地运行的真实输出。语法检查通过,只能证明语法通过,不能证明 Bug 已修。
这就是这个 Skill 最值钱的地方。证据要和声明一一对应。
测试通过,需要测试命令显示零失败。构建成功,需要构建命令退出码为 0。Bug 已修,需要原始症状被真正复现并通过。回归测试有效,最好还要走一遍红绿循环,撤回修复时它确实会失败,恢复修复后它才通过。
装上之后,别让它只会多跑一遍测试
真正接进工作流时,我更建议把它理解成声明到证据的映射表,而不是「结束前运行 tests」的固定咒语。
修 Bug 时,完成证据至少要碰到原始症状。改前端交互时,类型检查和单测不一定能证明弹窗能打开、键盘焦点能回来,可能还要跑 Playwright。改构建配置时,Lint 再干净也得执行生产构建。改文档链接时,编译成功不代表链接没死,得跑链接检查。往外部系统写草稿时,本地文件存在也不算交付,外部系统返回的资源 ID 才是单一事实来源。
我自己的感受是,验收命令最好在任务开始时就写下来。
不要等 Agent 写完再临时猜。开工时直接告诉它,这个任务完成需要什么证据。可以是一条命令,也可以是一组分层命令。
声明 代码可合并
证据 目标回归测试通过,全量测试零失败,生产构建退出 0

声明 页面交互已修
证据 原始 Playwright 用例通过,控制台无新增错误

声明 外部草稿已保存
证据 接口返回非空资源 ID,并回写本地状态文件
Agent 中途如果只能拿到部分证据,也该报告「实现完成,端到端验证因环境变量缺失未执行」,别把半成品包装成完成品。
坦率讲,这比让 Agent 多写两段漂亮总结有用多了。
多 Agent 协作时还要再加一层。执行 Agent 报成功,协调 Agent 不能直接转述。至少看一眼 diff,再独立运行验收命令。因为「Agent 已完成」本身也只是一个声明,发送消息的那个 Agent 不是证据。
厉害了,这套逻辑绕一圈,又落回软件工程最老的一句话上。
信任可以有,验收不能省。
哪些场景别把它当万能药
多跑命令不能消灭幻觉。没这么爽。
它管不住错误的验收标准。如果测试本来就没覆盖真实需求,跑一百次绿灯也只是稳定地漏 Bug。它也管不住被挑选过的输出。Agent 只贴末尾两行,不给退出码和失败数,形式上像证据,实际上仍可能藏着 warning 或跳过项。
它还会增加成本。大型仓库的全量测试可能跑半小时。更合理的做法是分层,开发中跑目标测试,准备声称完成时再跑约定好的完整验证。
再往高风险场景走,光靠文字规则也不够。支付、权限、数据迁移、安全边界这些任务,应该把关键验收放进 CI、pre-merge check 或部署门禁。Skill 负责提醒 Agent 别嘴快,确定性系统负责让它想嘴快也过不了门。
这两层别混。
还有一个挺现实的限制。这个 Skill 的规则非常硬,连「看起来不错」「完美」「搞定」这种满意表达都要求先验证。日常聊天里会显得较真,甚至有点烦。可放到长时间自主运行的代码 Agent 里,我宁可它烦一点,也不想在两小时后收到一份语气很笃定、测试一个没跑的交付报告。
我会把它放在哪里
如果只装一个 Skill,我不会因为 19.47 万次安装就直接选它。Superpowers 是一整套开发方法,单拿完成前验证出来,前面的需求澄清、计划、测试设计和代码审查都不会自动补齐。
但作为收尾的验收门,它很合适。
它没有承诺让 Agent 写得更聪明,只是要求 Agent 在说话前对证据负责。这个收益很窄,也很清楚。今天就能加,效果也容易观察,看无证据的完成声明有没有减少,看验收失败是否被如实报告,看 CI 返工有没有提前暴露。
如果你准备试,我建议别一上来给整个组织讲方法论。挑一个经常被 Agent 提前宣布完成的仓库,写下三类声明和各自的证明命令,跑一周。记录失败被提前抓住几次,验证时间增加多少,再决定要不要扩大。
棒棒的,连采用这个 Skill 本身,也该拿证据说话。
毕竟工具是用来减少幻觉的,不是用来制造新的信仰。