posts/vero-formal-proof-code-agents.md
AI 写代码过了 87.3%,完整仓库只过 27/43
87.3% 和 27/43,来自同一组 AI 编程评测。
把这两个数字单独看,都挺能打。放在一起,味道就不一样了。
前一个数字说,最强 Agent 通过了 87.3% 的形式化规范。后一个数字说,43 个仓库级任务里,它只完整交出了 27 个。剩下那些仓库,不是大部分对了就算对,而是只要还有一条证明没关掉,整题就没过。
好家伙,AI 写代码终于被拉进了一场不认「差不多」的考试。
这套考试叫 Vero,来自 UC Berkeley 的研究团队。它问的不是 Agent 能不能修一个 issue,也不是测试套件能不能跑绿,而是更狠的一句,你写的实现,能不能为自己交出机器可检查的证明。
我自己的判断是,这篇研究最值得看的并不是 GPT-5.5 又赢了一张榜。真正有用的部分,是它把 Agent 代码里一直被一句「all tests pass」遮住的交付缺口,直接量了出来。
测试全绿,和代码被证明正确,中间隔着一片不小的海。
测试只看见你想得到的输入
普通测试像抽查。
你给排序函数准备空数组、重复值、负数和一组随机数据,它都过了。很棒,但测试只说明这些样本没撞出问题。那个会在第 10001 个元素、特定边界值或者某种调用顺序下冒出来的 bug,仍可能安静地躺着。
形式化验证走的是另一条路。开发者先把软件应该满足的性质写成严格规范,再让定理证明器检查,实现是否对规范覆盖的所有输入都成立。Lean 4 既是编程语言也是证明器,最终点头的不是另一个会聊天的模型,而是一个很小的可信内核。
Vero 把这件事从单个函数推到了完整仓库。它收了 43 个多模块 Lean 4 项目,来源覆盖 Python、Dafny、Verus 和 Coq 的真实项目,一共摆进去 743 个 API、2705 条形式化规范。题材从数据结构一路走到分布式系统、智能合约和安全关键基础设施。
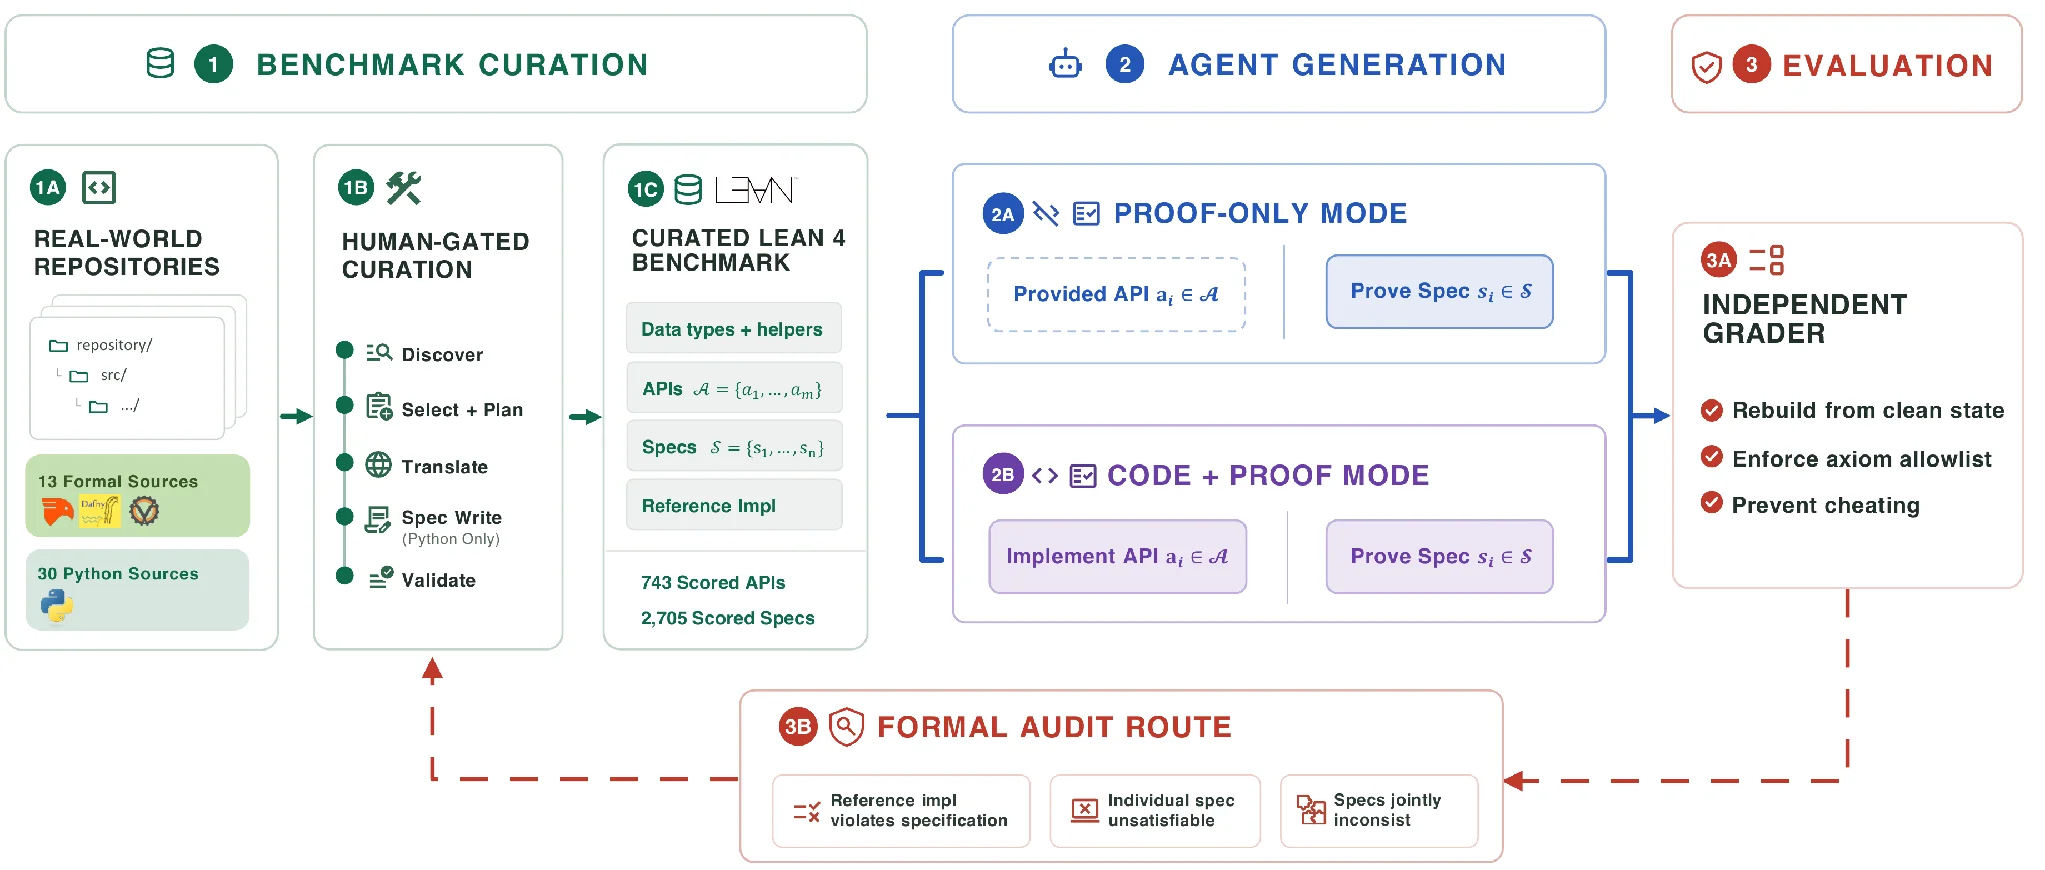
图 1,Agent 只能编辑指定区域,评分器会把结果塞回干净项目重新构建,再检查证明依赖。
它有两种考试方式。
一种只让 Agent 写证明,参考实现已经给好。另一种更接近真实开发,函数体留空,Agent 既要写实现,也要证明自己的实现满足全部规范。每次运行可用文件系统、构建工具和 Lean 工具链,时间预算是 90 分钟。
最强配置 GPT-5.5(xhigh)配合 Codex,在代码加证明模式里完整解出 27/43 个实例,逐条规范通过率达到 87.3%。Claude Opus 4.8 配合 Claude Code 完整解出 8 个,另外两种配置都只有 2 个。
如果只盯 87.3%,会觉得这事快做完了。Vero 偏偏把主指标定成完整仓库,只要一个规范还开着,或者干净环境里构建不起来,就不能算交付。
这个评分挺残酷,也挺像生产环境。
支付、权限、并发状态这些地方,没有「87% 安全」的说法。一个接口没守住不变量,事故不会因为另外 742 个 API 很努力就少扣一点钱。
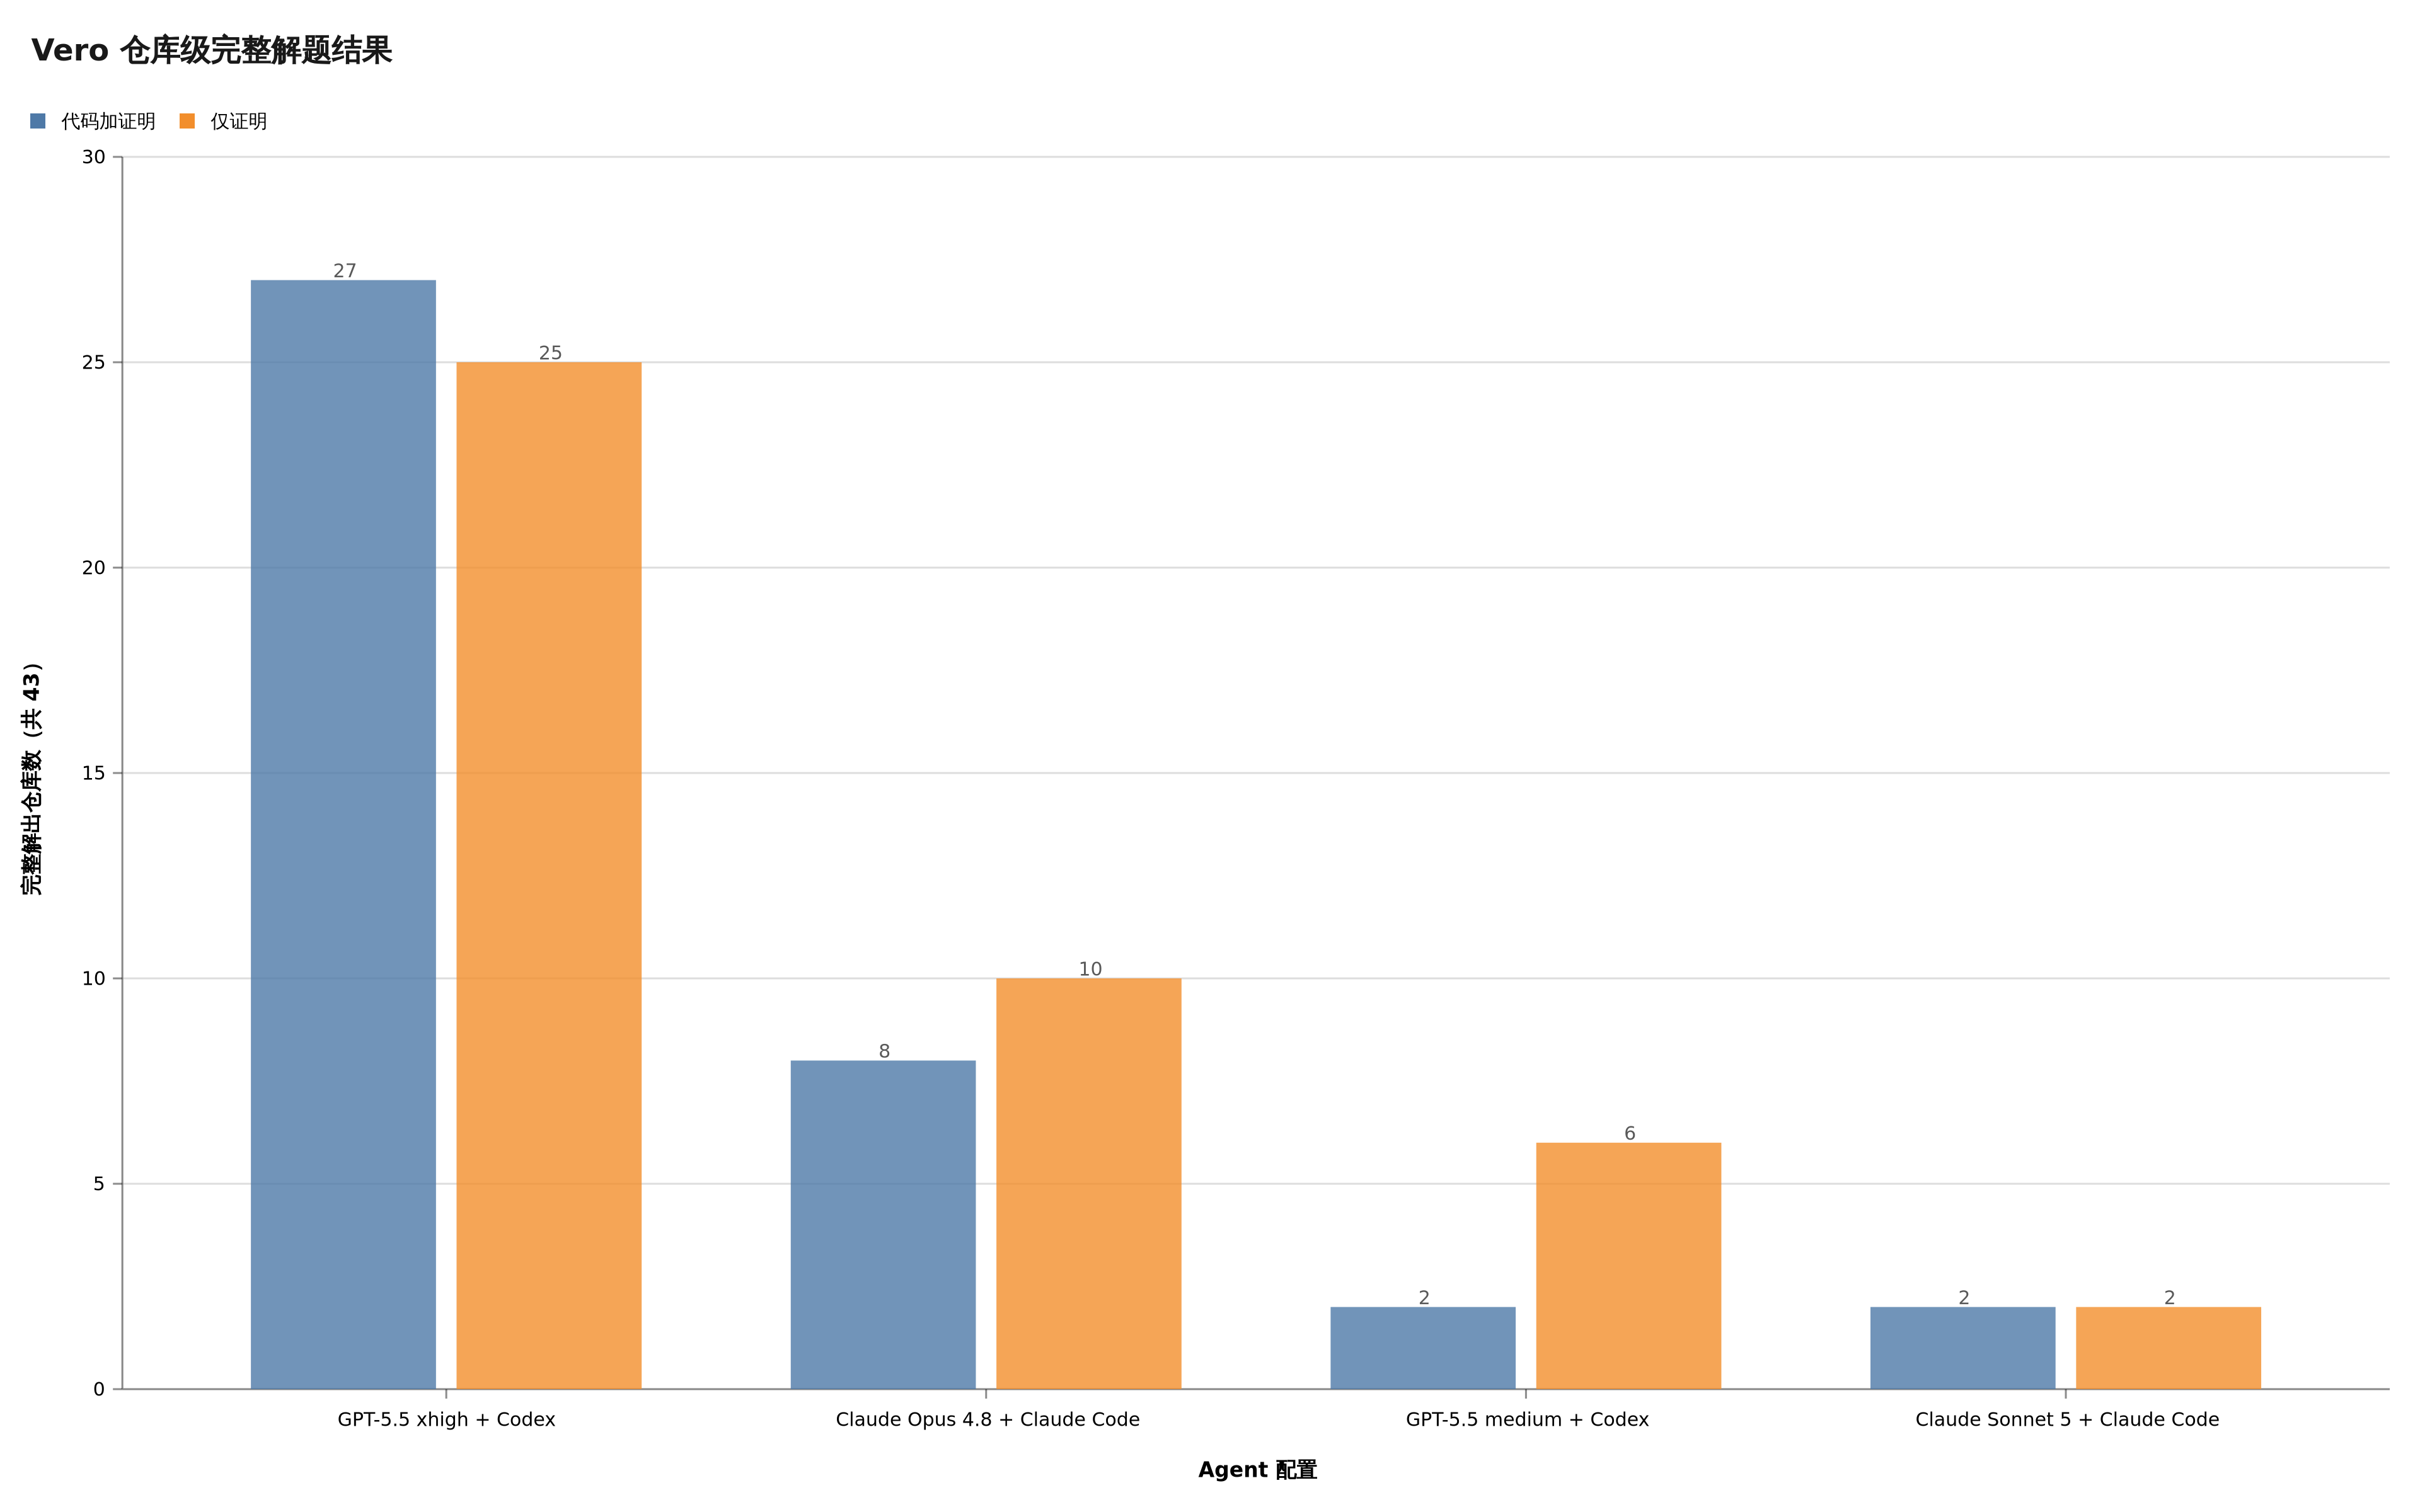
图 2,逐条规范得分很高,不等于整个仓库已经可以交付。
Agent 卡住的不是语法,是全局结构
Vero 里有个数字很妙。
在 82 次完整解题运行中,Agent 自己写的辅助定理,占证明代码行数的中位数超过七成。代码加证明模式是 73.6%,仅证明模式是 71.6%。80 次完整解题都出现了至少一个被两条以上规范复用的辅助定理,65 次里还有辅助定理被至少五条规范复用。
也就是说,真正做完仓库的 Agent 不是在 2705 个洞前逐个硬填。它会先找到共享不变量,搭一层可以复用的证明结构,再让后面的任务踩着这层结构往前走。
这跟大型代码库太像了。一个局部函数写对不算稀奇,难的是它有没有顺着领域模型、类型约束和模块边界长出来。局部 patch 看着都合理,凑在一起却可能互相打架。很多 Agent 能写漂亮的 50 行代码,一进跨模块状态管理就开始迷路,不是语法不会,而是脑子里没立住整张依赖图。
研究数据还把这个困难拍得更清楚。不依赖辅助引理的规范,通过率在两种模式下分别是 83.9% 和 80.1%。当辅助链深度达到四层或更多,通过率掉到 50.6% 和 39.1%。
厉害了,问题从「会不会写证明」一路升级成了「会不会维护证明架构」。
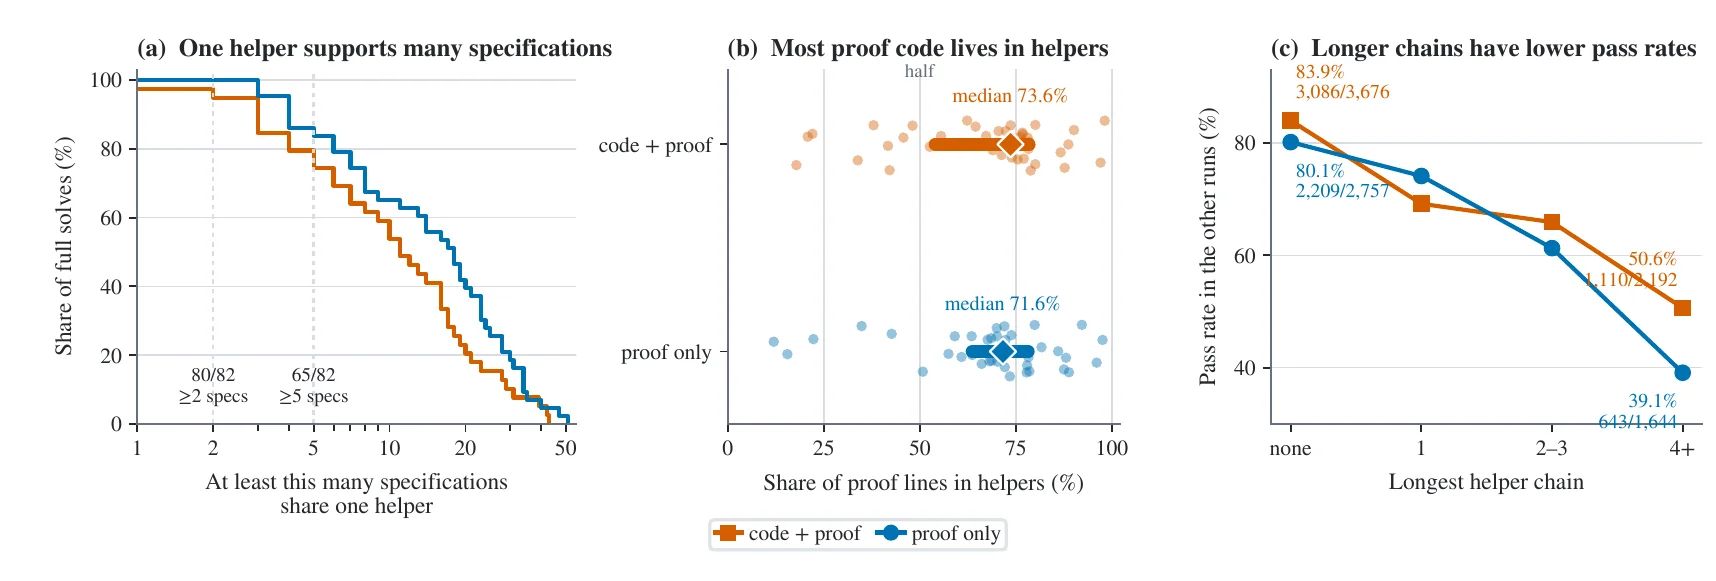
图 3,完整解题里七成以上证明代码来自辅助定理,依赖链变深后通过率明显下降。
这也是 Vero 论文 跟普通代码榜单拉开距离的地方。像 SWE-bench 这类评测主要看补丁能否解决真实 issue,Vero 再往前推了一步,它要求 Agent 维护一套跨模块成立的逻辑承诺。
更骚的一段发生在「实现自由」上。
Agent 不必忠实复刻参考算法,只要实现满足规范就行。研究者找到五组实例,Agent 把难证明的参考算法换成更容易证明的实现后,代码加证明模式关闭了全部 250 条规范,而固定参考实现的仅证明运行只关闭了 201 条。
听起来像 Agent 找到了捷径。问题是,原文也明确提醒,其中一些替换牺牲了渐进性能。证明更容易,不代表生产质量更高。一个算法可以逻辑上完全正确,同时慢得没法上线。
反方向也存在。17 组配对在仅证明模式里做完了,到了自己写代码再证明时反而没做完。轨迹显示,Agent 常常很早就押定一种实现,然后不停往上堆证明,直到时间耗尽。它不太擅长在证明路线连续撞墙后回头说,核心定义选错了,重来。
写代码的人对这个画面应该不陌生。只不过人类会把它叫沉没成本,Agent 会把它叫继续迭代。
普通团队不用明天改写 Lean 4
看到这里,可能有小伙伴纳闷,难道以后每个 CRUD 都要配一套数学证明?
不用,真没必要。
形式化验证很贵,写对规范本身也难。规范如果把错误需求写得严丝合缝,证明器只会非常认真地证明你错得很一致。Vero 对这点没有装看不见,它允许 Agent 提交机器可检查的反证,指出参考实现违反规范、单条规范无解,或者多条规范放在一起互相矛盾。确认问题后,实例会回到人工审查再修。
这块很关键。证明不是现实真理,它只是实现相对规范的强保证。规范是谁写的、边界有没有漏、性能和安全目标有没有进入规范,仍然需要人负责。
普通团队真正该抄的,是 Vero 的验收思路,而不是它的全部工具链。
第一层,把一句「测试通过」改成可复跑的证据包。固定 commit SHA,在干净环境重新构建,保留测试、类型检查、静态分析和制品摘要。Agent 自己终端里跑绿不算,验收过程要从它碰不到的干净源重新执行。Vero 的评分器正是这么做,它只抽取允许编辑的片段,塞回全新项目再编译。
一条最朴素的门禁脚本,可以先长这样。
set -euo pipefail
git diff --check
ruff check .
mypy --strict .
pytest -q
这几行没有形式化证明那么强,却能先堵住一大批「Agent 说跑过,换台机器就坏」的交付。
第二层,把关键业务规则从示例变成属性。不要只测一个订单金额,写清楚金额不能为负、幂等键不能重复扣款、权限收紧后不能被旧缓存绕过。Python 项目可以用 Hypothesis 生成大量边界输入,状态机则可以先用模型测试把不变量钉住。
第三层,确认你的测试真的会判错。故意删掉鉴权、翻转比较符、跳过异常分支,再看门禁能不能变红。测试数量再多,如果代码被破坏后仍然全绿,那只是绿色壁纸。变异测试和故障注入做的就是这件事。
第四层,只把最昂贵的边界送进形式化方法。权限模型、资金状态机、共识协议、加密协议值得用 TLA+、Lean 或 Coq 多走一步。营销页面的圆角不用证明,转账状态不能重复提交,值得。
这四层不是一夜之间全上。可以先挑一个事故代价最高、规则又相对稳定的模块,把它的「测试案例」往「可执行属性」推一步。等团队连属性都说不清时,直接上证明只会把混乱写成更昂贵的混乱。
Vero 的 代码和评测工具链已经开源。想亲手感受这道证明题的人,可以先跑它提供的 BankLedger 示例,不必直接冲最难的分布式仓库。说真的,哪怕不打算在生产里用 Lean 4,看看它如何隔离 Agent 可编辑区域、如何在干净环境重新评分,也很值。
回到开头那两个数字。
87.3% 是能力,27/43 是交付。两者之间那段没走完的路,才是 Agent 工程接下来真正要补的东西。