posts/ai-datacenter-ghost-power-demand.md
AI 数据中心要电 700GW,电网先别全信
700GW。
这是美国中西部、中大西洋和南部,超大型用电户递给电网的接电申请总量。申请方主要是数据中心。它超过美国数据中心当前实际用电估算的十倍,大致相当于给全美所有家庭供电所需的规模。
好家伙,服务器还没搬进机房,电力需求已经先把地图涂满了。
路透社 9 月 1 日的调查给这种需求起了个很形象的名字,「幽灵需求」。有些申请来自认真准备建设的项目,有些是同一个项目在多个地区重复排队,有些没有足够资金和建设经验,还有些连最终客户和电源都没找到。
最容易写的结论,是 AI 又开始吞电了。
但 700GW 真正让我在意的,不是耗电量,而是一个更像软件工程的问题。一个稀缺资源队列里,意向、询价、重复申请、签约项目和真正在建的项目全混在一起。规划者看到的不是需求,而是一坨没有类型标记的数据。
如果你做过任务调度,大概能闻到熟悉的味道。队列长度暴涨,不一定说明工作量真的暴涨。可能是客户端超时后不断重试,可能是同一个任务缺少幂等键被塞了五遍,也可能是有人先抢一个资源槽位,等机会合适再决定要不要干。
电网当然比 Redis 队列复杂得多,但这里的故障形状很像。
数据中心还没开机,容量已经被预约了。预约不花太多代价时,多报一个地区的收益很高,代价却接近于零。对申请方,这是给未来买期权。对电网,这是拿几十年的基础设施投资去猜谁在认真。
空指针。
700GW 不是一份建设清单
先把这组数字放回原来的位置。
路透社审查了美国多地公用事业公司和电网运营机构的公开数据。得州的大型用电接入申请,从 2023 年约 48GW 涨到 474GW 以上。得州以外,10 家大型公用事业公司收到的数据中心用电申请约 270GW。
两个池子加在一起,超过 700GW。
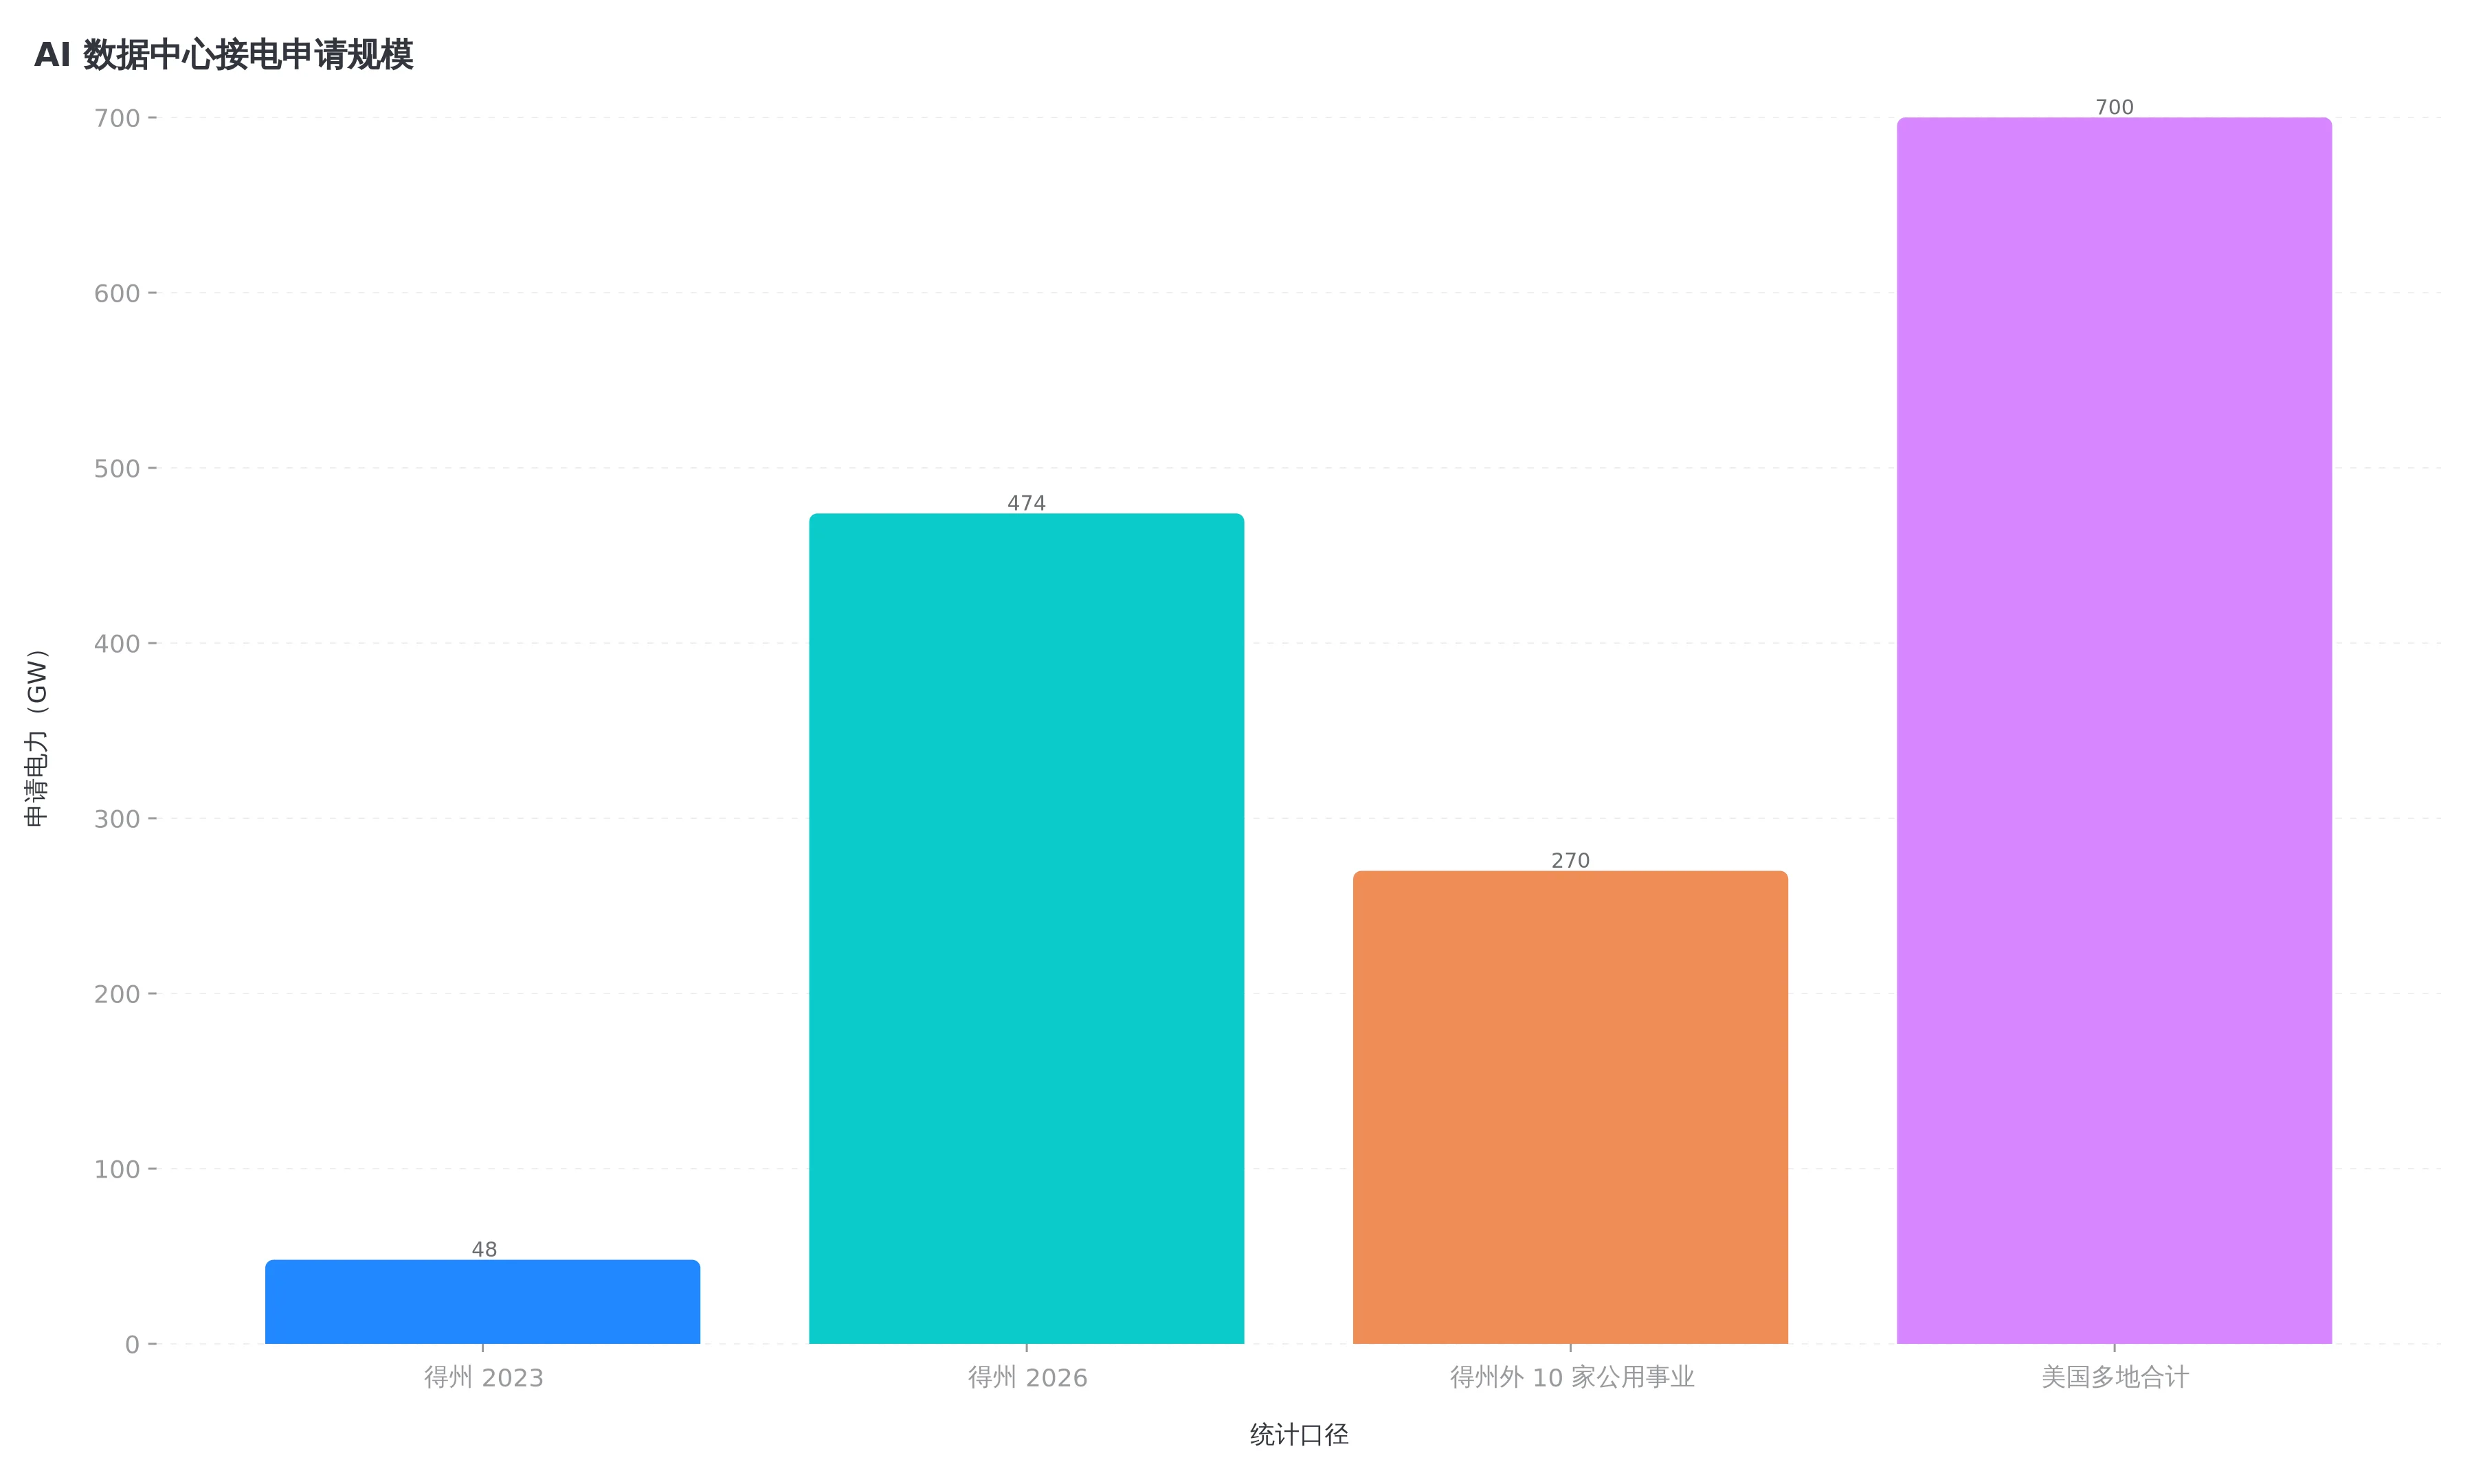
路透社审查的公开数据,单位为 GW。最右一列是多地合计下限,不与前两列按同一口径直接相加。
这里有个很关键的口径问题。各家公司统计申请的方式并不统一。有的只算已经签合同的项目,有的连没有硬承诺的询价也算。有人报的是准备开工的负荷,有人报的是「如果一切都顺利,我可能需要这么多」。同一张表里,字段名都叫需求,置信度却差了好几级。
你可以把它想成产品团队收需求。
销售说这个客户可能要 500 个席位,渠道说另一个地区可能再要 500 个,合作伙伴也为同一个最终客户报了 500 个。财务把三个数字相加,工程团队开始按 1500 个席位扩容。几个月后客户只签了 300 个,机器已经买了,账单不会自己消失。
这不是一个虚构的「我有个朋友」故事,而是需求预测里常见的重复计算模型。数据中心把它放大到了发电厂、输电线和变电站的尺度。
更麻烦的是,电力基础设施不像 Kubernetes Pod,多开了还能一键缩容。输电项目从审批到投运可能跨很多年,成本最终要有人承担。如果按夸大的申请过度建设,没落地的项目会留下搁浅资产,家庭和企业用户可能被迫分摊。如果电网因为不信这些数字而建得太少,真项目投运时又会碰到供给不足和可靠性风险。
两边都能翻车。
而且真实成本已经出现。PJM Interconnection 是覆盖美国 13 个州的大型电网。报道援引其独立市场监测机构 Monitoring Analytics 的数据,现有和预测的数据中心需求,在过去约四轮容量拍卖里推动家庭与企业的容量成本增加 294 亿美元。
项目可能还是一张效果图,容量成本已经进账了。
这一下就不只是 AI 公司和云厂商的资本开支故事。队列里每一个没有被验真的数字,都可能变成别人的电费。
让预约先付一点真金白银
怎么知道谁是真的?
很朴素,让占用稀缺资源的人付出一部分不可忽略的成本,并且逐步提交更强的证据。
芝加哥的 Exelon 开始要求更严格的抵押品后,把高概率数据中心需求下调约 40%,降到 11GW。AEP Ohio 在新规则里加入最高 10 万美元的并网研究费后,需求管线缩水了一半以上。
一加保证金,幽灵就开始穿墙离场了。
我是真的觉得,这个变化比 700GW 本身更有信息量。问卷里说「我有兴趣」很容易,刷卡付定金就完全是另一回事。前者衡量情绪,后者才开始接近需求。
工程系统里也有同样的纪律。调用方想长期占住 GPU,不能只发一句「我以后可能有大任务」。它要给出配额申请、预算、预计开始时间和释放条件。进入执行队列后,要有租约,也就是资源只保留一段时间,没续约就回收。任务重试要带幂等键,避免同一个请求重复占位。项目成熟度变化,还要更新状态,不能让半年前的一次询价永远挂在预测里。
把这套语言翻回电网,大概是五个状态。
询价,只说明有人在看。
申请,说明地点和规模开始成形。
签约,说明申请方愿意承担违约成本。
许可和电源就绪,说明项目越过了纸面阶段。
投运,才是电网真正看到的负荷。
这不是为了用流程折腾申请方,而是给每个数字补上置信度。把 700GW 写成一个总数,信息很炸。把 700GW 拆成五个成熟度区间,规划才有可能开始。
得州电网运营机构 ERCOT 和 得州公共事业委员会 正在做类似的事。新审查要求数据中心披露最终所有者、公共激励、用水情况和现场发电计划。过去只披露关联公司也能进入流程,谁是真正承担建设责任的人,可能藏在多层公司结构后面。
宾夕法尼亚州也在提高门槛。州政府 8 月 18 日签署的新规,要求 25MW 及以上项目接受更严格的许可审查,并披露项目计划与最终用户。路透社拿到的公开情况是,100 多个拟建数据中心里,只有 20 个申请了推进项目所需的许可。多数提案还没锁定电源,也没有能为机房融资的客户。
100 多个提案,20 个进许可。
这个比例比任何发布会里的效果图都诚实。
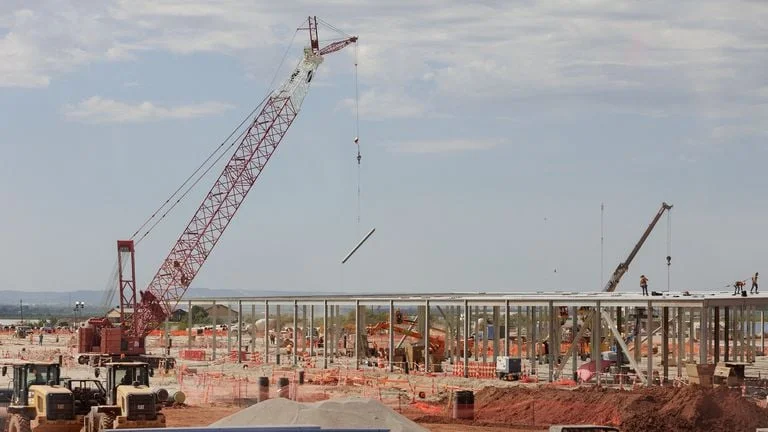
数据中心施工现场。照片来自路透社报道,真正开工与排进接电队列,是两种完全不同的项目状态。
电力队列也需要防重、限流和过期
如果把这件事当成一个系统设计题,我会盯住三个字段。
一个是最终受益所有者。同一个云厂商通过不同开发商、关联公司和不同州重复申请,系统需要知道这些请求是不是同一个需求的多个副本。软件里靠幂等键和全局任务 ID 防重,电网不能只看申请表上的公司名。
另一个是阶段性承诺。项目每往前走一步,都要交出更难伪造的证据。土地控制权、客户合同、资金证明、设备订单、许可进度、电源方案,这些证据不必一开始全齐,但必须随着时间递增。否则一个两年前的意向,还会和昨天拿到建设许可的项目占同样权重。
还有过期时间。
稀缺容量一旦被无限期保留,队列就会被最会抢位置的人占满。设定里程碑和释放条件,才不会让后来但更真实的项目永远排在幽灵后面。做 Agent 调度的人都知道,没有 timeout 的任务迟早会把 worker 池拖死。电力接入申请如果没有逾期回收,也会把规划空间锁住。
当然,这套办法不是免费午餐。
保证金太高,小型但真实的开发商可能被大公司挤出去。审查太慢,电网会错过真实增长。所有权披露不完整,重复申请仍然能换一层壳回来。不同州口径不一致,项目还可以到处排队。
所以,门槛不能只有一个大锤。更合理的做法,是让承诺成本跟申请成熟度一起上升。早期询价保持低门槛,但不进入硬容量预测。进入并网研究时交研究费。要求长期预留容量时提供抵押品。到了建设窗口还没有许可、客户或电源,就降低优先级,甚至释放位置。
这套机制听着不性感,甚至有点像一份认真到烦人的状态机。
可基础设施真正需要的,往往就是这种不性感。
还有一块不能躲,预测误差到底由谁买单。
普通软件服务扩容失误,最常见的代价是云账单难看,或者高峰期多等几秒。电网把需求看高了,可能提前建设发电和输电资产,成本会通过长期费率摊给用户。看低了,真实项目接入时可能挤压可靠性,或者让后来者为加急建设付更高价格。一个错误数字,会沿着几十年的资产寿命往下传。
这也是为什么保证金不该只被理解成「劝退费」。如果申请方要求电网为自己提前承担建设风险,它就该承担一部分预测错误的成本。项目按承诺推进,保证金可以返还或抵扣。项目退出,已经发生的研究和建设成本不能全留给其他用户。
软件工程里有个很朴素的原则,制造外部成本的人,不能永远把失败重试免费甩给系统。API 如果完全没有限流,最激进的客户端会吃掉大家的容量。电力接入也一样。免费排队会奖励重复申请,合理的阶段性成本才会奖励更准确的需求表达。
但收费机制也得能被审计。费用怎么计算,什么条件下退还,项目延期多久会失去位置,释放的容量如何重新分配,都要写清楚。否则门槛会从过滤幽灵,变成保护先到者的护城河。大公司交得起钱,不代表它的项目更真实,小开发商资金薄,也不代表它只会画饼。
靠谱的验真系统,看的应该是证据强度,不是公司名气。
资金承诺是一类证据,许可进度是一类证据,最终客户和设备订单也是证据。它们彼此独立,组合起来才形成可信度。只交一笔钱就永久锁住容量,照样可能制造新的占位生意。只看一份客户意向,又会回到 700GW 那张混乱的总表。
我有时候觉得,基础设施行业和 Agent 工程最像的地方,就在这里。模型说「任务完成了」不算完成,得有测试结果、产物路径和外部状态。项目说「我要 1GW」也不算需求,得有土地、资金、客户、许可和时间表。
证据比声明贵一点,也可靠得多。
砍掉幽灵,真缺口还在
写到这里,很容易滑向另一个舒服的结论。既然 700GW 里有大量重复和投机申请,那 AI 的电力焦虑是不是被夸大了?
也不能这么偷懒。
路透社报道里有一句很重要的话。即使公用事业公司大幅削减需求预测,剩下那些能被证实的数据中心申请,仍足以压垮供给紧张的电网。PJM 的回应也很直接,负荷确实在到来,新增发电却没有跟上需要的速度。
幽灵需求和真实缺口,可以同时存在。
过滤垃圾申请,不是为了证明 AI 不耗电,而是把真正的缺口从噪声里抠出来。只有知道哪些项目会落地,电网才知道该在哪里建、什么时候建、由谁付钱。否则 700GW 这个大数既能被拿来催促无上限扩张,也能在被揭穿后被反过来当成「都是泡沫」的证据。
两种叙事都省事,工程不允许这么省事。
对做 AI 基础设施的人,这事还有一层提醒。容量规划最怕把愿望当负载,把一次峰值当长期基线,把重复重试当新增用户。无论是 GPU、Token 预算、API 并发,还是电力,预约都不等于消耗,意向也不等于承诺。
真正可靠的数字,通常不是问出来的,是用成本、状态和时间一点点验出来的。
所以我对 700GW 的判断很简单。
别全信,也别不信。
先给它加幂等键,分成熟度,设过期时间,让想占位置的人交一点真金白银。等幽灵散开,剩下的那条电力曲线,才是该拿去建基础设施的地图。
海上雾大的时候,罗盘不会替你消灭暗礁。它只负责告诉你,哪个信号是真的。