
视频字幕可以交给 AI,人别退出生产线
听写、初翻和打轴可以交给模型,但专有名词、断句与画面语气还得有人签字。给内容团队留三道人工关,才能把提效真的换成可交付。
一段 20 分钟的视频,光给每句话对齐出现和消失的时间,人工可能要花 3 到 5 个小时。现在有字幕组把听写、打轴和初翻交给模型,最快 20 分钟到 1 小时就能出底稿。
看上去挺像那个熟悉的故事,机器来了,苦活没了,人也该退场了。
但我读完 虎嗅授权转载的一篇汉化组访谈,反而觉得这事没那么简单。采访里的字幕组没有把人从流程里删掉,懂日语的人转去校对,其他人盯时间轴、专有名词、字幕位置和发布前的拼接。AI 把最笨、最重复的一段接走了,剩下那段才刚刚开始值钱。
这对做课程、访谈、直播切片和短视频的团队很有参考价值。字幕不是把声音变成字就结束了。它落到观众眼前时,还是一份要承担理解成本的成品。错一个人名,观众会出戏。断句断在半句话里,讲者像在卡顿。字幕压住关键画面,前面省下的时间全得从评论区和返工里还回去。
好家伙,真正应该讨论的不是字幕能不能全自动,而是人应该留在哪一段。
把最笨的活交出去
采访里的流程很朴素。原始视频先进入转写程序,得到带时间点的日语字幕轴。语言底稿经过检查后,再生成中文。接着由人校对中文、微调时间轴,最后把片段拼好发布。
它之所以跑得起来,不是因为模型突然懂了所有语境,而是因为把任务拆得足够老实。机器负责听写、按时间切片、给出初译。人负责判断一句话在这个节目里到底在说什么。
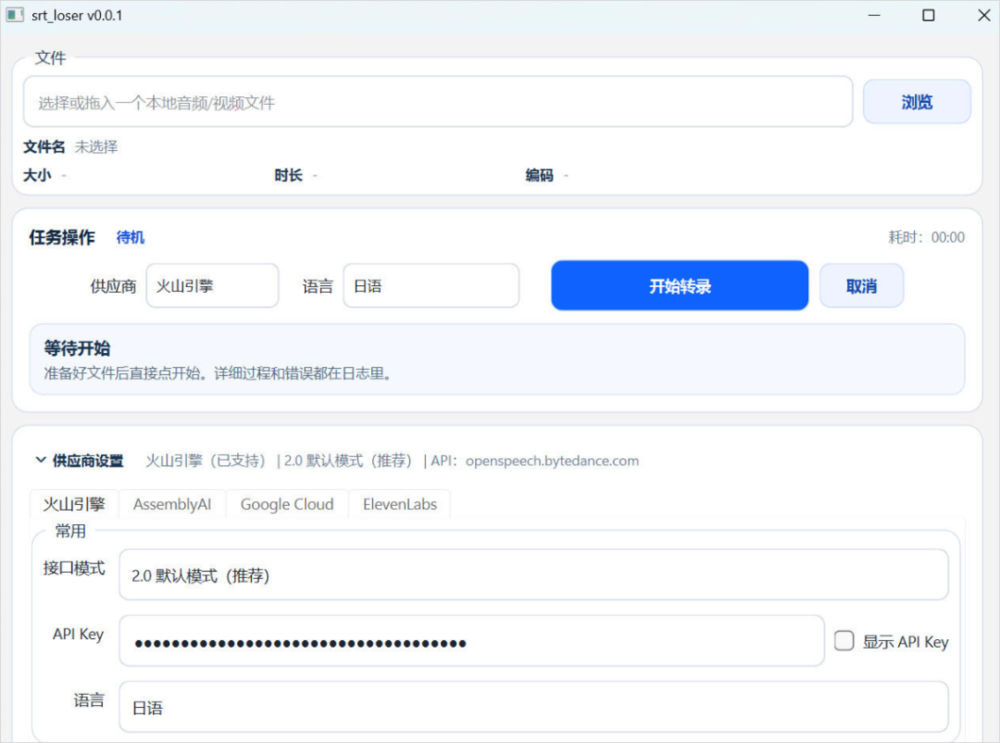
图为采访中展示的转写工具界面,来源于原访谈。
这个分工比一键生成更接近内容生产的现实。声音清楚、时长不长、语速稳定的素材,转写和打轴确实很适合先让模型跑一遍。把人困在拖拽时间轴、反复试听、填同一类空白里,既慢也不浪漫。能省就省,没必要为了手工感把所有人拴在最容易出错的重复劳动上。
不过别急着把自动化开到最大。模型给出的不是成片,是一张待验收的工单。团队如果把它当终稿,问题只会从编辑器里搬到发布后。
第一关,名字和语境不能靠概率
采访里那位做个人汉化的程序员,会专门检查时效性背景、作品名和人名。这个动作看着小,实际是字幕里最容易把信任打穿的地方。
转写模型听到一个外文专名,常常会给出一个发音上很像的词。翻译模型看见一句没有上下文的台词,也可能把角色关系、梗和语气补错。它们不是故意捣乱,只是输入里没有足够证据。可观众不会因为模型缺上下文就少挑一次错。
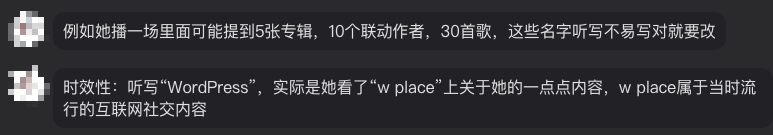
图为采访中对专有名词与时效性信息的复核示例,来源于原访谈。
所以字幕上线前,至少该留一个能回答三个问题的人。这个名字是不是原片里的那个人。这个词是不是本期节目所指的作品、歌或事件。这个翻译放回前后两分钟里,人物还像在说同一种话吗。
这些问题不一定都要由日语最强的人承担。团队可以把高风险条目先标出来,让懂领域的人看作品名和资料,让熟悉语言的人看句意,让剪辑师看字幕是否跟镜头合拍。关键不在谁最全能,在于有人对每一类错负责。
很多团队最容易省掉的就是这一步。因为它没有显眼的生成按钮,也不产出一张漂亮的前后对比图。但它决定了自动化是在帮你减负,还是在批量制造一次次小尴尬。
第二关,断句和时间轴是阅读体验
字幕的时间轴不只是技术字段。它决定观众什么时候读到一句话,读完时画面是不是已经跳走。
原访谈里,AI 可以把打轴从数小时压缩到几十分钟。这个数字很诱人,但更有意思的是,字幕组仍然会手工微调中文和时间轴。因为翻译之后的句子长度变了,口语停顿变了,人物抢话和笑场也变了。原语言的切分点,未必就是中文最舒服的切分点。
做过视频的人大概都见过这种情况。字幕每个字都对,可一句话被劈成两半,观众得先把眼睛从画面移开,再回头猜后半句。内容没错,体验已经掉分。
这一步可以给团队一个很轻的验收规则。随机挑出开头、中段和结尾各一段,在静音状态下看一遍。看不懂,往往是断句或停留时间有问题。再开声音看一遍,人物的停顿、重音和笑点跟字幕对不上,就回去调轴。它不需要把每一秒都重新手搓,但必须有人看过成片。
厉害了,模型替你做完第一轮,人终于有时间把注意力放到观众真正能感到的那一轮。
第三关,画面里的字不只是在传信息
漫画汉化给了一个很好的反例。采访中的漫画组试过不少自动化方案,几分钟能跑完整话,却还是没有直接用。原因不玄,嵌字要处理的不只是文字识别和翻译,还包括气泡的空间、中文口语的换行、人物情绪、字体和被原文盖住的背景。
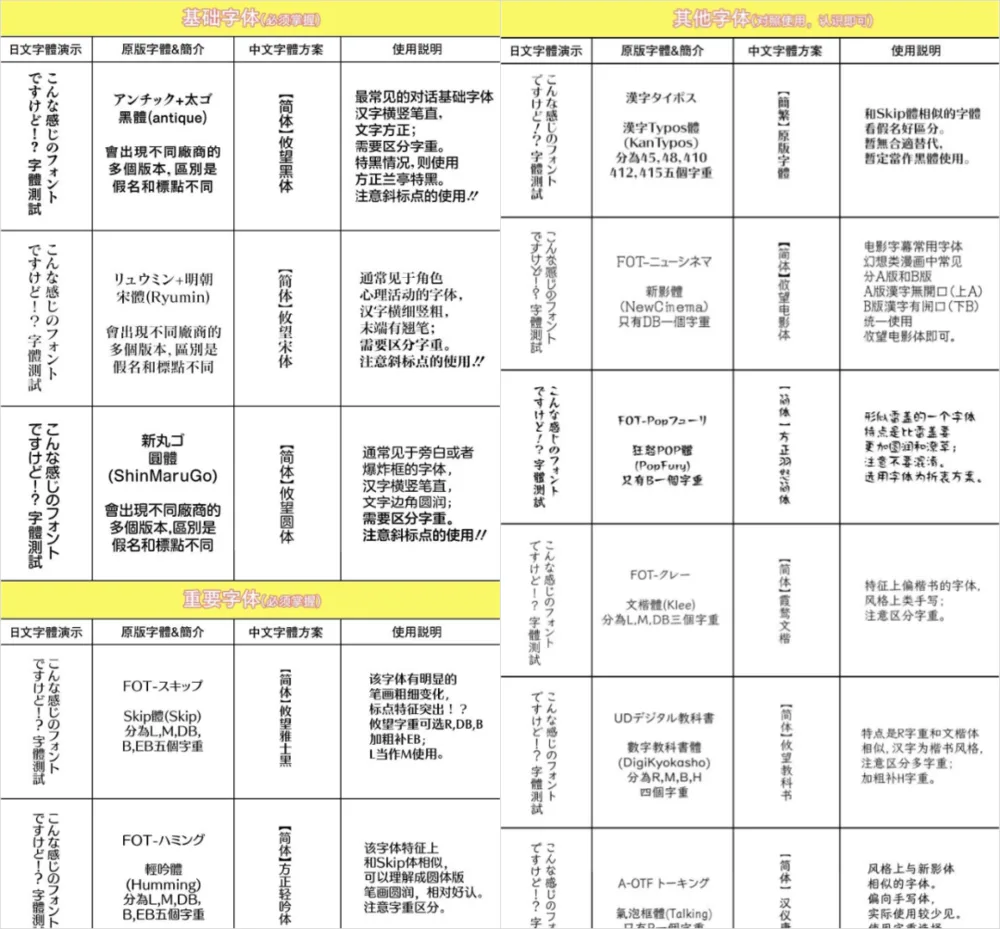
图为采访中展示的字体参考表,来源于原访谈。
一张图里,AI 也许能把字放进气泡,人却会看字是不是挤成一团,留白是不是还在,那个角色大喊时该不该换一种字体。前者是完成了任务,后者是在完成阅读。
视频字幕同样如此。访谈里、课程里、产品演示里,字幕不该挡住演示操作,不该盖住讲者正在指的按钮,也不该让观众为了追字错过关键表情。自动化越省时间,越应该把省下来的时间还给这一层,而不是顺手把它砍掉。
这也是为什么我不太相信一键完成会是内容团队最终的答案。它当然可以是很好的起点。尤其是素材积压、语言不熟、预算有限的时候,先拿到一个可编辑的底稿,已经把门槛降得很低。但从底稿到发布,中间仍有一段需要人给出审美判断和责任签字。
如果团队正准备把字幕流程交给模型,可以先把发布前的责任写成三行。专有名词和语境谁看。断句和时间轴谁看。画面、字体和最终成片谁看。三个人也可以是同一个人,重点是别让这三行消失。
采访里最打动人的地方,是那群人并不把 AI 当敌人。他们希望喜欢的内容能更快被更多人看懂,也愿意把脏活累活交出去。这个心态挺棒棒的。效率不是目的,能把热爱做得更久、让观众少等一点,才是。
字幕可以交给 AI。
但人别退出生产线。
如果你负责过字幕或内容交付,你最不愿意交给模型的那一关是什么。