
Claude Code 默认 auto mode:长任务能连续跑,生产权限仍得手动守
Claude 不再把每一个命令都抛回来让你点允许。真正要补上的不是更宽的放行规则,而是把连续执行和生产变更分成两条清楚的边界。
让 Claude Code 连续改完一批文件、跑完测试、整理出一个可审的 PR,本来是挺顺手的事。最容易把人劝退的,往往不是模型卡住,而是中途跳出一串权限确认:这个命令能跑吗?那个文件能改吗?又一个。
弹窗一多,人会形成肌肉记忆。Anthropic 公开的统计里,开发者批准权限提示的比例是 97%;相比之下,面对一份完整计划时,拒绝率有 39%。逐条确认看上去很谨慎,实际常常只是在给“全都允许”增加手指运动量。
这也是 Claude Code 的 auto mode 变成默认模式后,真正值得看的地方。它不是让 agent 获得一张无限额度的通行证,而是把“每个动作都找人点头”换成“让分类器先判断动作是否越过边界”。安全操作继续走,危险操作被拦住,Claude 再尝试别的路。
10 月 22 日的官方更新把这套默认设置扩展到多数 Claude 应用的新会话。Claude Code 里,Pro、Max 与 Team 用户的新会话此前已开始默认进入 auto mode;已经固定其他默认值的用户不会被悄悄改掉。对经常把一段编码任务留给 agent 连续做的人,这不是一个小开关变化,而是一道新的分工题:什么能让它自己跑,什么必须留在人手里。
弹窗消失后,审查并没有消失
auto mode 审的是原本会弹出确认框的动作。分类器会特别关注不可逆、破坏性,或者可能把内容带到当前环境之外的行为。被拦住以后,Claude 不一定立刻把任务扔回来;它会尝试一条风险更低的路径。连续三次被拦,或者一个会话累计二十次被拦,才会退回手动确认;完整规则见 官方配置文档。
这和直接开 bypassPermissions 不是一回事。后者的逻辑是“别来烦我”,auto mode 的逻辑是“低风险事情别来烦我”。两句话看起来只差几个字,工程后果差得很远。
官方在受控实验里找了 1,053 名付费专业测试者:手动审查只拦住了 13.6% 的危险命令,auto mode 拦住了 89%。实验环境里没有真的执行危险操作,研究人员只是把其中一次权限提示换成了危险命令的文字。这个边界很重要:它证明人会被高频提示磨钝,也证明分类器在这组题里更会拒绝;它不等于你的生产仓库从此安全。
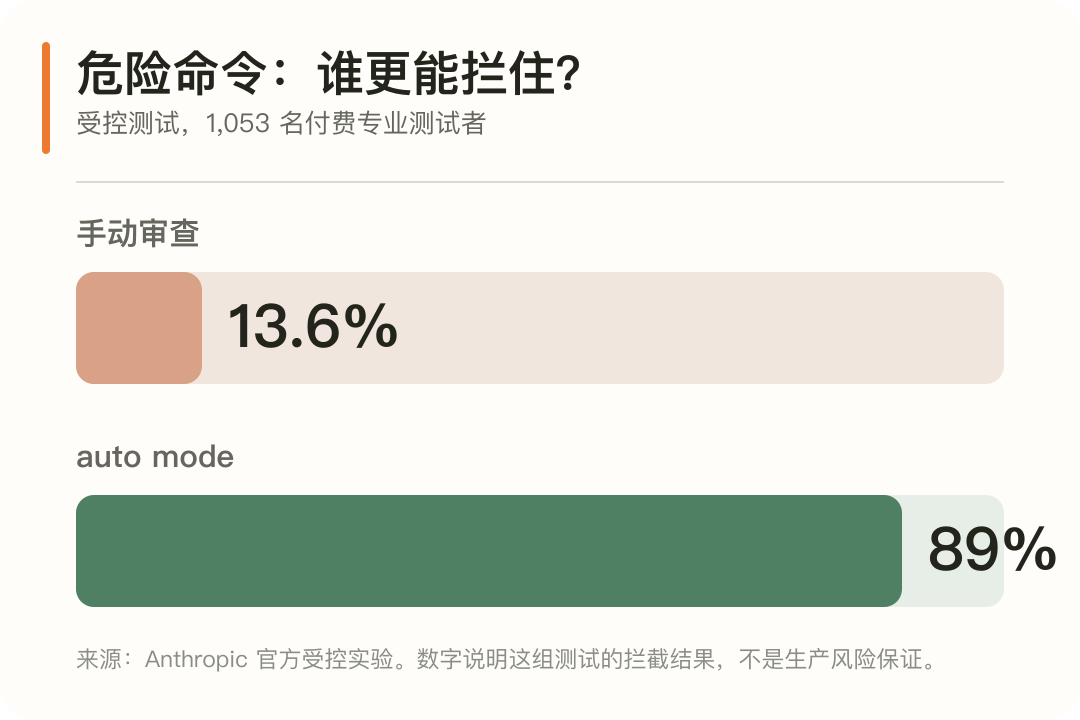
官方受控实验口径:1,053 名测试者中,手动审查拦住 13.6%,auto mode 拦住 89%。这不是生产环境的风险承诺。
真正值得留意的是审查所见的上下文。比如一个 git push,推往团队私有仓库和推往公开仓库,命令长得几乎一样,风险却不是一回事。auto mode 会结合目的地的信任级别判断;对可能丢弃未提交改动的操作,它还会看当前的 git 状态。这里终于不是拿一张允许列表硬盖所有场景了。
给它连续做事,不等于交出生产权限
比较稳妥的拆法,是按“失败后能否轻松回滚、影响范围有没有跑出仓库、是否会碰到真实用户或真实钱”分成三层。不是为了把团队制度写成一面墙,而是避免每次 agent 开工都临场猜规则。
第一层,是可以连续完成的本地工作。 读代码、改工作区文件、跑单测、生成文档、整理一个还没发出的变更集,通常适合 auto mode。它们仍可能写错,但影响大多局限在本地分支,能看 diff、能重跑、能撤回。把这些动作留在长会话里,才能把“agent 一直被确认框打断”的收益真正拿到。
第二层,是可以让它准备、但需要把出口写清楚的协作动作。 比如创建 PR、更新内部测试环境、推送到受信任的私有远端。这里不该只写一句“允许 git”,而应该把仓库、分支和命令范围讲明白。宽泛的 python:*、node:* 一类规则表面上省事,实际上可能放过任意代码执行;官方说明,这类能绕开审查的规则在 auto mode 下会被搁置。这个限制不是麻烦,是在阻止配置文件把安全检查架空。
第三层,是必须保留人工确认的生产动作。 生产数据库写入或删除、面向外部的发布、付款、权限升级、密钥处理、把私有代码或客户资料发到外部位置,都不该靠“模型看起来挺懂事”来放行。官方也把数据外泄列为不会自动批准的硬性拒绝类别。把这些列成团队规则,反而让 agent 在被拦时少绕弯路。
# 这是团队运行约定,不是 Claude Code 官方配置格式

可连续执行:工作区修改、测试、构建、草稿文档
需要受限出口:私有仓库 PR、测试环境部署、内部工单更新
必须人工确认:生产发布、数据库写删、权限升级、付款、密钥和外发数据
这份约定要跟仓库走,而不是只存在某位同事的脑子里。权限策略真正有用的时候,不是模型正常发挥,而是它误把“修一个小问题”延伸成“顺手清一批资源”的时候。
该盯的是动作边界,不是“auto”这个词
Anthropic 还给了一组值得克制看待的数据:在它们安全流程标记出来的会话里,生产级及以上的非明确授权伤害,手动批准会话占 6.3%,auto mode 会话占 2.4%。这说明高频手动批准并不天然更安全;但样本来自被标记会话,不能拿它当作所有项目的真实事故率。
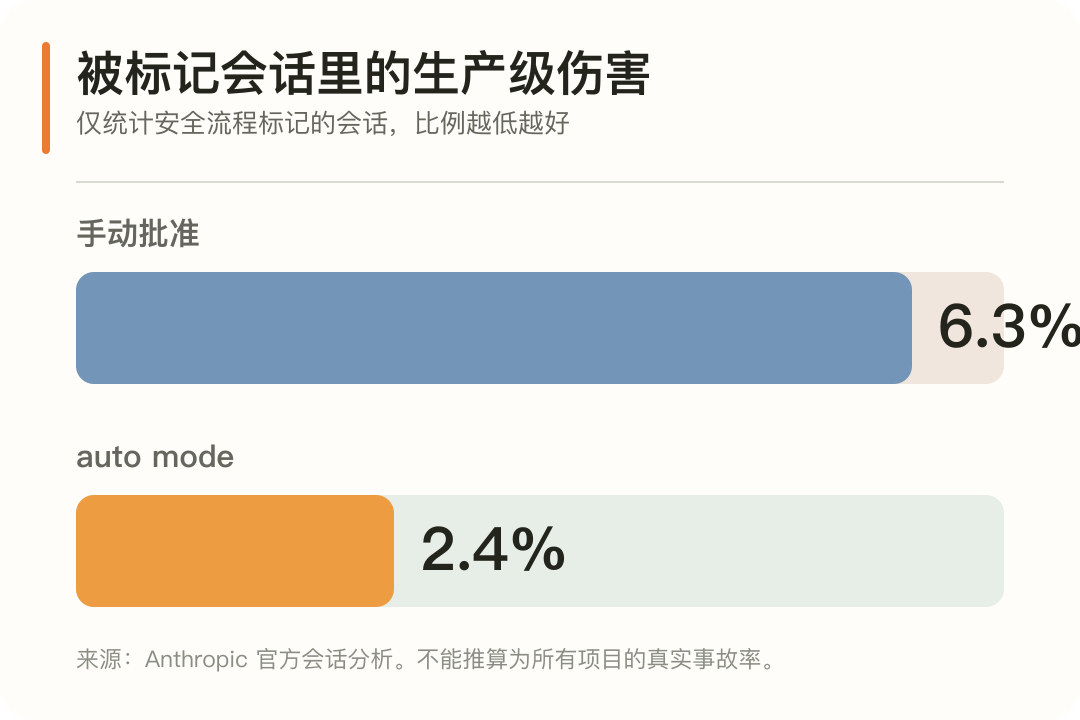
根据官方公开口径绘制:只统计被其安全流程标记的会话,不代表所有项目的真实事故率。手动批准为 6.3%,auto mode 为 2.4%。
这类模式最容易走向两个极端:一种是每个命令都手点,点到最后谁也没看;另一种是为了顺滑,干脆把所有权限都抹平。auto mode 有价值,恰好在中间那块地带——让可逆、低影响的工作跑得更远,让真正会改变外部世界的动作仍然露出来。
如果你是个人开发者,开一个小项目跑一轮 auto mode,看它在哪些地方反复被拦,再补最窄的规则,比直接抄一份巨大的 allowlist 更靠谱。如果你在团队里用,先把第三层列给所有人看,再讨论第二层能不能自动化。不要反过来。
auto mode 解决不了模型理解错需求、测试没覆盖、发布流程本身没有回滚这些老问题。它解决的是另一个更朴素的问题:当 agent 已经能连续干几十分钟活时,我们终于不必把安全寄托在数十次点击“允许”上。
你在自己的项目里,最不愿意交给代码 agent 的那一类操作是什么?
小岛 AI
记录一线实战、踩坑与成长