
Claude Code 能并行开工后,真正要补的是合并规则
Claude Code Projects 能把长任务拆进云端线程并行推进。真正该先设计的不是线程数,而是任务边界、合并门槛、额度和私网限制。
一项重构拖到第三天,最烦人的通常不是代码还没改完。
是这边的 Agent 在补测试,那边的 Agent 已经动了同一个服务。一个 PR 看着挺干净,另一个也没毛病,排到合并队列才发现,两个人都把同一段接口当成了自己的地盘。
人多时,这叫协作成本。
Agent 多了,也一样。
Anthropic 昨天把 Claude Code 的 Projects 从一个装资料和说明的文件夹,改成了一个能持续对话、持续分派工作的项目。你写下目标,Claude 可以拆任务、开多个云端线程、让线程跑测试和开 PR,再把需要你决定的事收回来。合上电脑,任务还会继续。
好家伙,终于有人把「多开几个会话」这件事做成了产品。
但我看完官方说明,脑子里最先跳出来的不是「它能跑多少线程」,而是一个很朴素的问题。
如果三条线程同时都觉得自己该改支付服务,谁来规定它们该停在哪里。
这次更新最值得工程团队认真对待的地方,也正在这里。Coding Agent 从一段对话变成一群带分支、带记忆、带执行环境的工作单元后,管理的单位就不再是一句提示词,而是一次可以验收的交接。
它不是会话文件夹了,更像一个项目调度台
官方给的场景很具体。你可以让一个项目去降低结账链路的 p75 延迟,让线程分别分析端点、测试优化、开 PR。也可以连接 API、Web、移动端多个仓库,让不同线程迁移被废弃的接口,并告诉你哪些 PR 应该先合。
听上去很丝滑,实际上的分水岭是它没有假装「并行」能消灭工程约束。
Claude 写得很明白,每个线程都是独立的 Claude Code 云端会话,各自有分支和仓库副本。两个线程如果改到同一处,最终仍会变成普通的合并冲突。协调者能把工作排开,不能替你发明一份不会互相踩脚的改造计划。
这句比宣传里那些「离机持续工作」更有价值。
因为一旦有了独立分支,我们熟悉的东西都回来了。改动要有范围,PR 要能读,测试要能复跑,合并要有顺序,坏了要能退。Agent 写代码很快,但 Git 并不会突然学会替团队做架构决策。
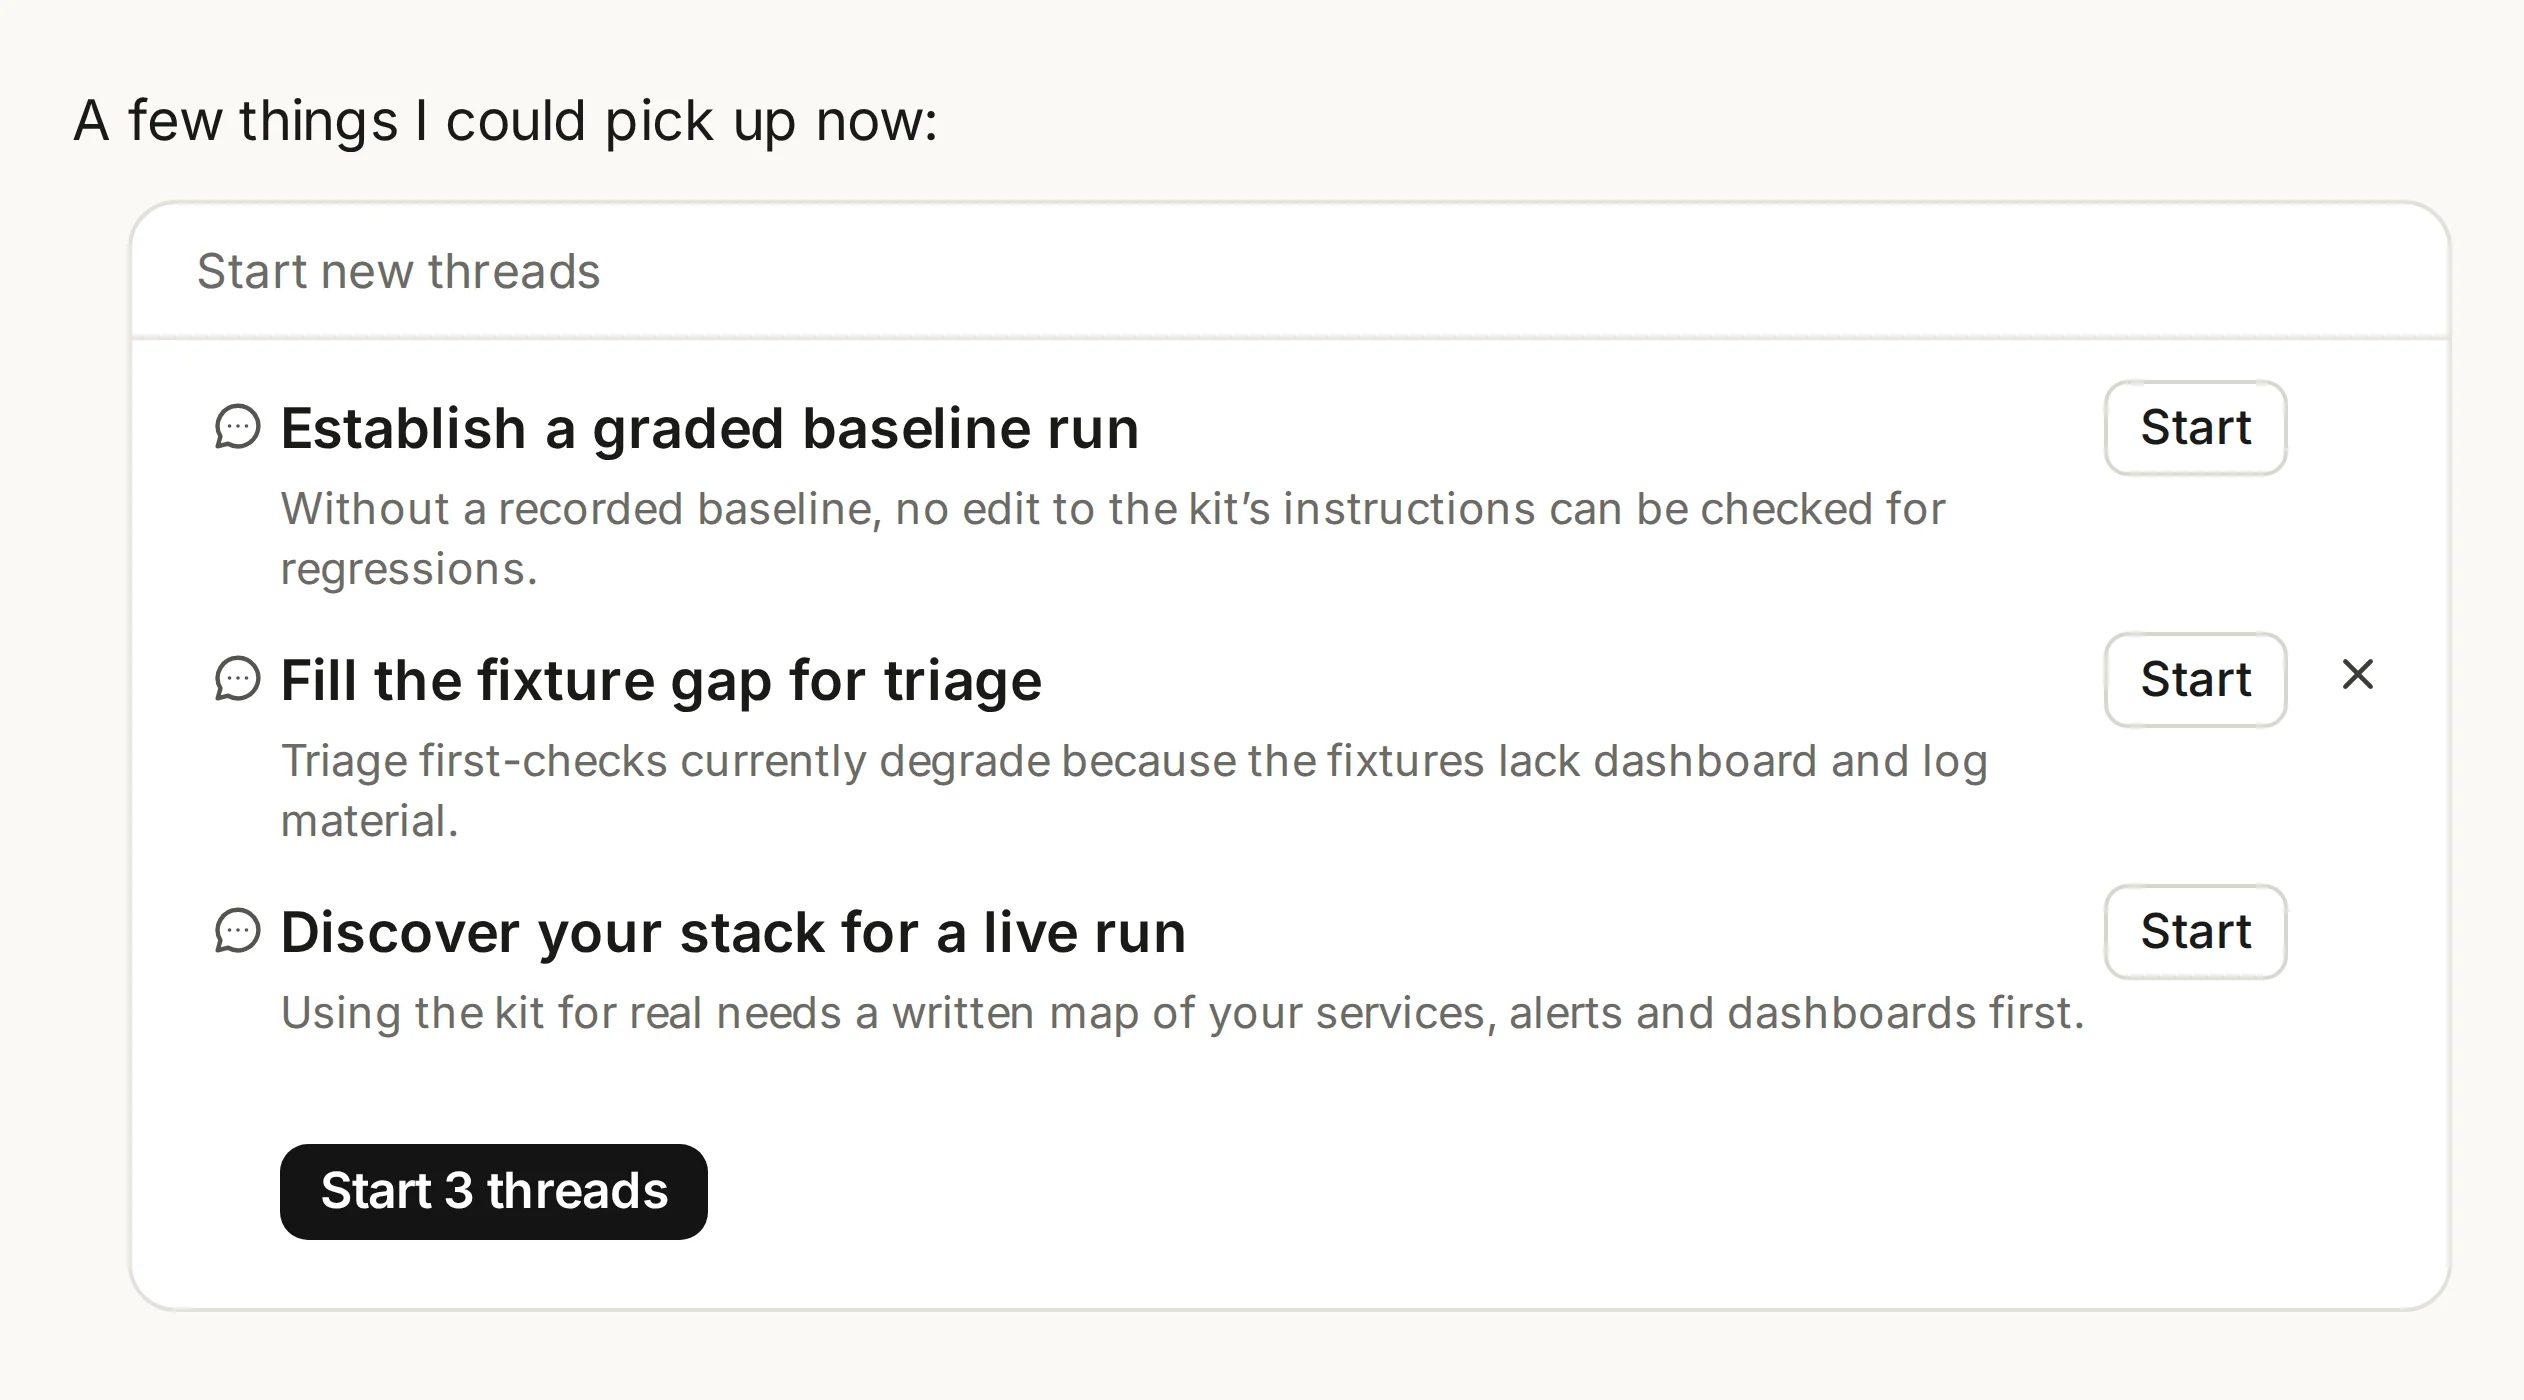
官方界面展示了待启动的任务。任务能并行,不等于它们可以无边界地并行。
如果团队现在就想试,不必拿一整个大重构去献祭。挑一个边界已经画得比较清楚的任务更合适,比如一个废弃接口的调用方迁移,或一批彼此独立的回归测试补齐。它们共享目标,但文件和责任别混在一起。
不要让三个线程一起「看看性能哪里可以优化」。这句话对人都太大,对 Agent 更像往空旷停车场里扔了三把钥匙。
先写交接单,再让它分派
Projects 的共享记忆会保存项目背景。发布从周四改到周五,某个导出功能为什么撤掉,动计费服务前该找谁确认,这类信息可以被后续线程继续使用。项目库也会收集资料和产物,省下重复把上下文搬来搬去的体力活。
这个能力很诱人,不过别把记忆当成需求文档的替身。
记忆擅长留住已经发生过的事,却不自动替你裁定「这次改动到底允许碰什么」。如果最初目标模糊,线程会很勤快地把模糊扩大。到头来你拿到的可能是一堆能运行的 PR,和一个更难回答的问题,哪一份才是原来要交付的东西。
我会在开项目之前,先把下面这段写给协调者。它不是什么神秘提示词,只是把平时项目负责人脑子里那张交接单摊到台面上。
目标
把 v1 订单查询接口的调用方迁移到 v2,不改变返回字段含义。

线程边界
Web、iOS、Android 各自一个线程。不得修改订单服务、鉴权中间件和计费模块。

验收证据
每个线程提交 PR,附迁移文件清单、现有测试结果、失败用例和回滚步骤。

合并规则
先合共享类型与契约测试,再合各端调用方。出现接口定义冲突时停止,不自行选择兼容方案。

停止条件
需要生产数据、私网服务、客户信息或新增权限时,停下来说明缺什么,由负责人决定下一步。
这里最重要的不是「分三个线程」。
是那句「不得修改什么」,和那句「冲突时停止」。很多长任务的事故,不是 Agent 没做事,而是它看见近路后很自然地多走了两步。工程里最贵的返工,常常从这两步开始。
这也解释了为什么我不太喜欢把 Projects 讲成一个会替你管理项目的「工头」。它能做调度,但项目真正的边界,仍得由能承担后果的人写下来。你把停手点写得越早,后面需要救火的概率通常越低。
合并前看的不是聊天记录,是证据
官方说协调者会审查输出、汇总结果,也允许你钻进每条线程看细节。这个设计很对,不过团队别把「主对话里有一个漂亮总结」当成验收。
总结是索引,不是证据。
一条线程说「已完成迁移」,至少还要能回答几件小事。改了哪些文件。没改哪些文件。测试跑的是哪一套。失败过没有。依赖的接口版本是什么。回滚时该撤哪个提交。
这些听着像老派的 PR 要求。厉害了,Agent 一多,它们反而更值钱。因为人脑原来还能勉强记住两三个会话分别做了什么,线程变成五条、十条之后,靠记忆去拼全貌很快就会翻车。
线程负责把路跑出来,是否并入主干仍需要可检查的证据。
可以把主项目对话当成一个控制面板。它负责看进度、补背景、调整优先级。真正提交给合并者的,仍该是 PR、测试结果、差异说明和可回滚的提交。
这里还有个容易被忽略的坑。官方明确说,共享记忆会随着线程积累项目细节。那当然能减少重复提示,可一条已经过期的决策也可能被新的线程继续拿来当背景。对变动很快的项目,最好给关键约定一个能回到仓库核验的落点,比如架构说明、接口契约或发布清单,而不是只期待它存在于某段对话里。
记忆该帮助执行,不该成为唯一真相。
额度和私网,是这次测试版的两道现实边界
现在的新版只向部分使用 Claude Code 云端会话、且没有既有网页或桌面 Projects 的 Pro 和 Max 用户开放。官方说会逐步扩大,现有项目也会继续按原方式运行。没有入口,不代表账号有问题,先看候补名单和项目页的实际状态。
更实在的是额度。每一条线程都是完整的云端 Claude Code 会话,多线程会更快吃掉套餐用量。协调者和工作线程可以分别选模型与推理强度,也能看项目级消耗。
别因为它能一口气开很多线程,就让它把十个「也许有用」的探索全跑一遍。先挑两个最能缩短路径的分支,给每条线程一个明确的产出和停点。跑完看冲突率、返工率和额度,再决定要不要扩。
还有本地环境。官方目前说线程跑在云端,能在本机、工具链和内网旁边运行的能力还在路上。所以私网数据库、内部服务、生产凭据、只能在本地复现的问题,今天都不该假设它已经碰得到。能不能接入,先看实际权限和环境,再谈自动化。
这不是保守,是把产品现在能做到什么,和我们希望它将来做到什么分开。
Claude Code Projects 这次最有意思的,不是又多了一个能写代码的窗口。它把长任务的拆分、执行和回收放到同一个项目里,让 Agent 开始像真正的协作成员一样占用分支、消耗额度、留下待合并的改动。
可协作成员从来不是放出去就完事了。
目标怎么拆,边界怎么画,什么证据够合并,碰到私网和冲突该在哪里停,还是团队自己的活。
如果你准备让它跑第一个 Projects,不妨先回答一个问题。你最希望 Agent 并行替你跑掉的工作是什么,而它绝对不该替你合上的哪一个 PR?
官方材料可从 Claude Projects 公告 和 中文帮助中心说明 交叉核验。