
Claude 主导 26% 研发后,审查要从代码转向证据
Anthropic 首次把 AI 参与模型研发写成比例。真正值得团队借走的,不是 26% 这个数字,而是把 Agent 交付改成可回放的证据包。
夜间的数据管道挂了,告警一响,工程师把日志、排查路径、修复、测试和上线全都自己接住。这是很多团队熟悉的夜班剧情。
Anthropic 给出了另一种剧本。工程师只把告警交给 Claude,Claude 自己查日志、找故障点、写修复、跑测试、处理半路冒出来的问题,再在数据副本上重跑并比对结果。它会把改了什么、为什么改写成一份说明,工程师拿到的是一包可审的交付物,最后决定今晚发不发。
这不是科幻设定,是 Anthropic 在最新研发自动化指标里用来说明 AL4 的官方例子。AL4 的意思不是 AI 自己上线,而是人给出高层目标后,AI 能把大部分任务端到端跑完,人留在监督和发布决策的位置。
官方披露,截至 2026 年 8 月,Claude 已经主导 Anthropic 26% 的 AI 研发工作,超过 90% 的工作至少进入 AI 协作阶段。好家伙,这个数字确实够醒目。可我觉得更值得研发团队盯住的,不是 AI 写了多少代码,而是它交回来的是不是一包能被人接住的证据。
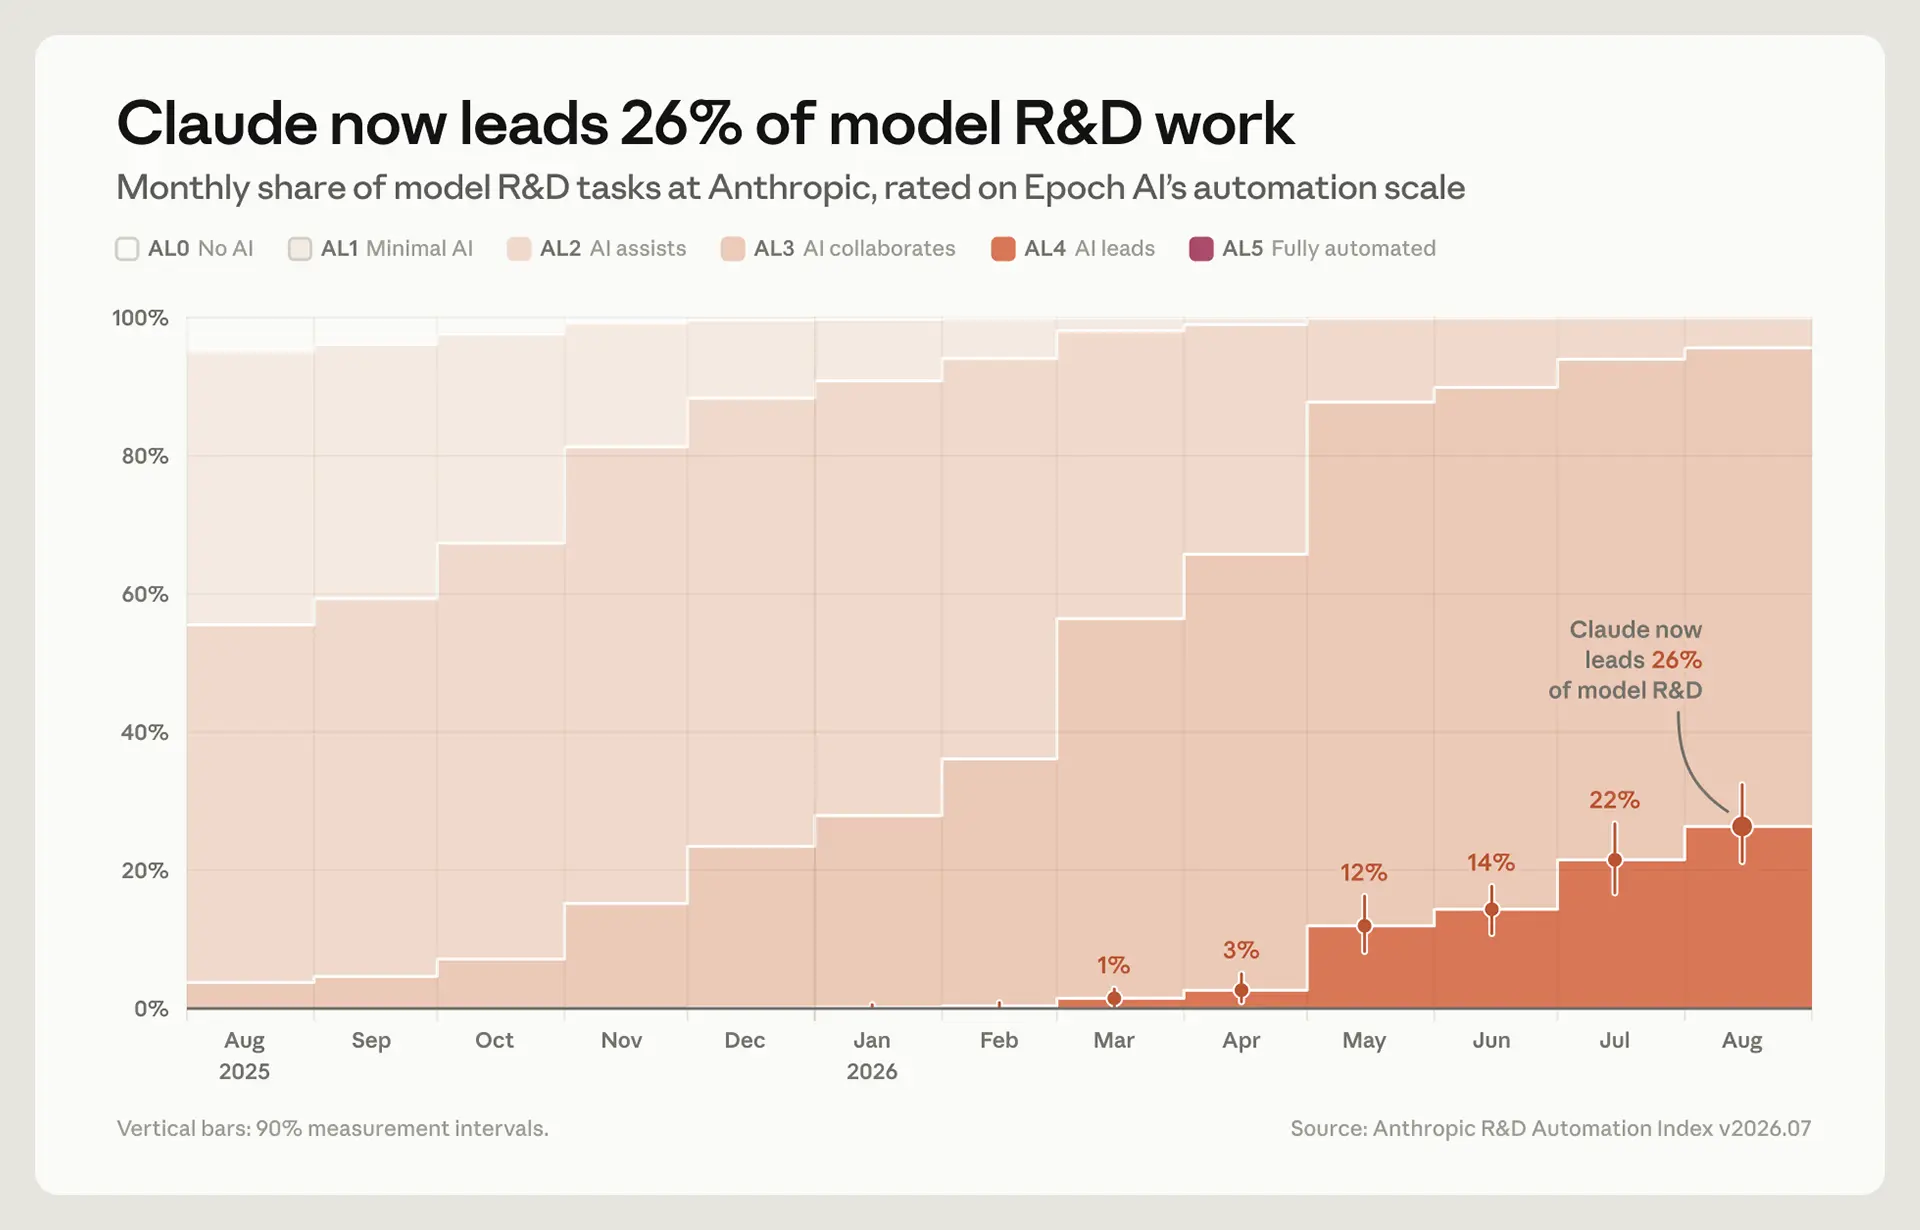
官方图表记录的是任务自动化等级的变化,不是 Claude 完全自主运行的比例。
因为 Agent 一旦从补全函数变成接手完整任务,审查对象就不再只有一个 PR。它会碰日志、配置、数据副本、测试环境、外部服务和别人的中间结论。代码 diff 当然还重要,但它只是最后留在桌面上的一张纸。
26% 不是一张替班通知
先把数字放回原处。Anthropic 的量表从 AL0 到 AL5,AL3 是 AI 在人类紧密指导下完成大块工作,AL4 才是它接到目标后自己推进大部分步骤。被测量的工作里,Claude 还没有任何一项达到完全自主运行。
所以,26% 不是四分之一研发已经没人管了。它指向的是另一件更具体的事,工程师不必持续站在 Agent 身后逐步解锁,工作重心开始从「带着它做」挪到「审它做完的东西」。
这个转移很容易被写成效率神话,仿佛人从流程里消失就算赢。其实吧,人没有消失,只是被挤到了更难的位置。以前你盯着每一步输入,现在要判断一条完整执行链是否可信。前者消耗时间,后者消耗判断力。
Anthropic 的例子把边界写得挺清楚。Claude 可以查、改、测、重跑和写说明,但不部署。生产动作依然要由工程师决定。这个小小的停顿,恰好是任务交接里最值钱的地方。
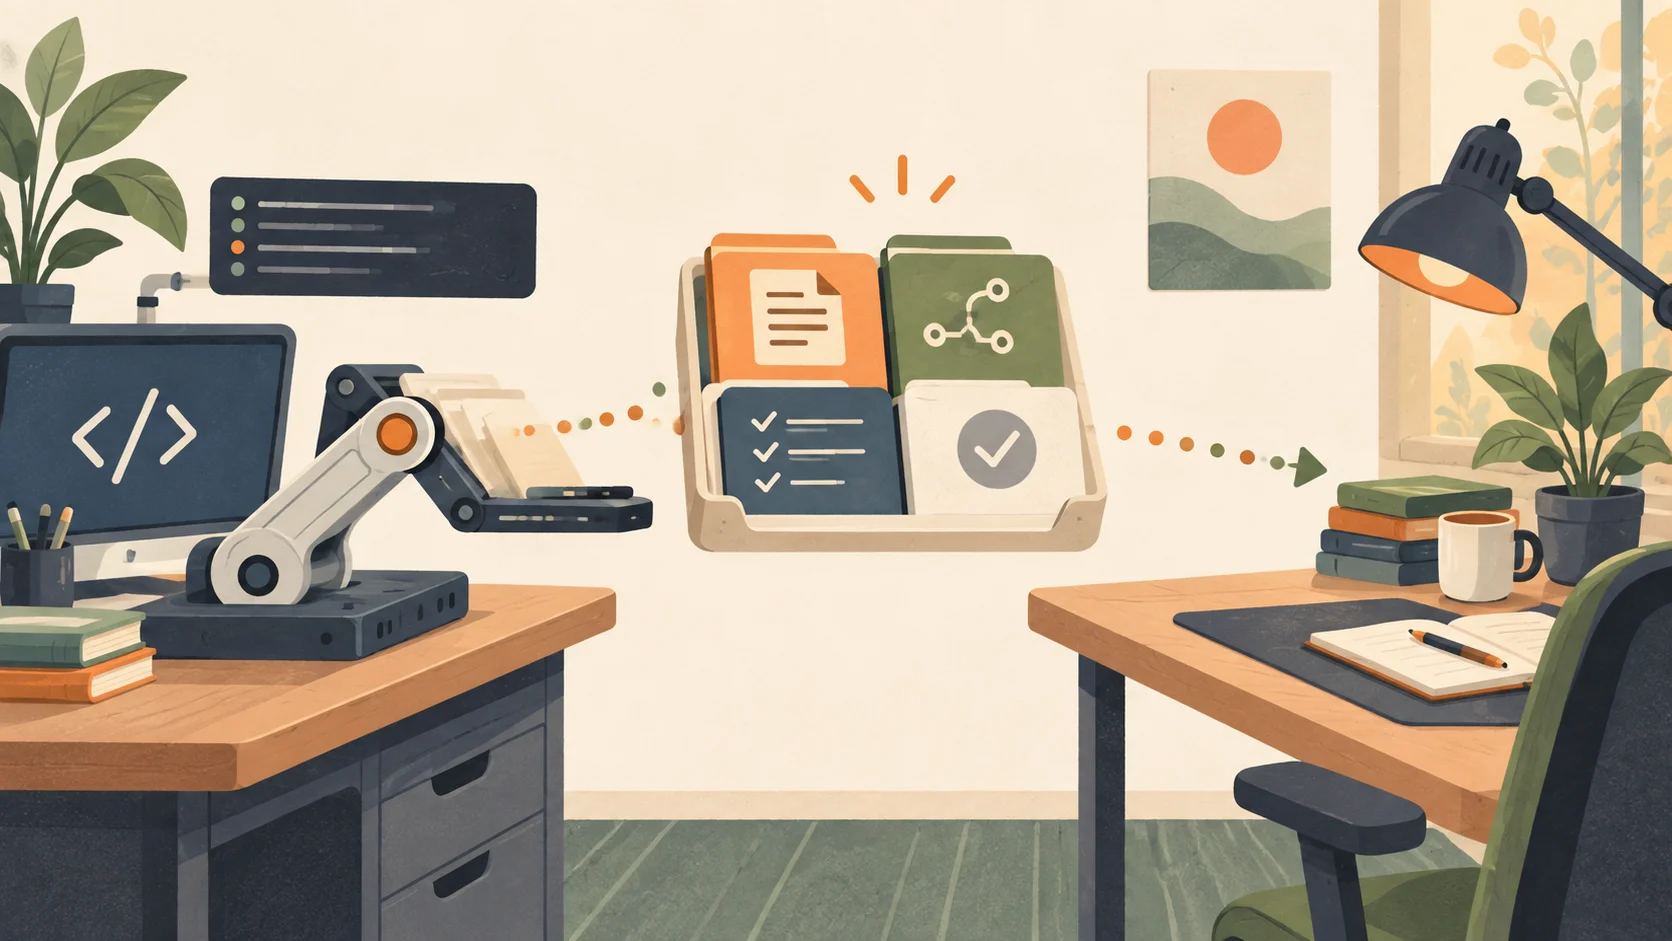
当 Agent 接手整段工作流,交付物要从一句总结升级为可回放的证据包。
交接单该从代码改成证据
如果团队准备让 Claude Code、Codex 或自建 Agent 接手更长的任务,可以先不纠结它到底算不算 AL4。把每一次重要交付要求成下面这四类证据,已经能避开一大截麻烦。
| 要看的东西 | 交付时该留下什么 | 人要做的判断 |
|---|---|---|
| 任务边界 | 目标、允许访问的系统、禁止写入的区域、输入版本与执行环境 | 这件事有没有被授权,范围有没有悄悄变大 |
| 过程轨迹 | Agent 身份、工具调用、关键输入、失败与重试、引用过的结论 | 它有没有绕开约束,沿用的前提能不能成立 |
| 结果校验 | 测试记录、输出对比、数据副本上的重跑结果、已知未覆盖项 | 成功不是一句话,和上一个正常结果比到底变了什么 |
| 发布交接 | diff、回滚点、待人工确认的问题、实际发布人 | 哪些风险仍该由人承担,出了问题怎么撤回 |
这张表看着朴素,甚至有点像老派的变更单。厉害了,Agent 越能跑长任务,团队反而越需要这种不浪漫的东西。
尤其是「过程轨迹」这一格。Anthropic 在内部给大量 Agent 保留独立身份,身份不随着底层模型升级而消失。Agent 之间的消息也带身份和原始引用。这样做不是为了给数字员工发工牌,而是为了让一条结论能追到是谁、基于什么、在什么时候给出来的。
落到普通工程团队,不需要一上来造三万个 Agent 的平台。一次自动修 Bug、一次批量改配置、一次让 Agent 接管回归测试,都可以先要求它返回任务 ID、代码版本、输入快照、执行命令、测试结果和待人工确认项。没有这些,长长的自然语言总结写得再漂亮,也只是汇报稿。
证据要能推翻 Agent 自己的结论
Anthropic 这次披露里最诚实的一段,反而是它承认自己的指标还不够硬。研发任务是由 Claude 整理和研究的,自动化等级也由独立 Claude Judge 评分。官方给出的数字是,模型与人工评分完全一致的比例为 59%,人工彼此完全一致的比例为 35%,相差不超过一级的比例为 97%。
这不是说 26% 没价值。它说明这个数字可以当趋势信号,却不能直接当生产力报表,更不能拿去给权限扩容背书。一个模型评另一个模型的工作,就算用了独立实例,也可能共享同一类盲点。官方自己也提出,后续需要第三方或其他开发者的模型参与验证。
团队里也一样。Agent 的自测能告诉你它跑了什么,不能单独证明它跑对了。让它生成测试没问题,让它解释变更也没问题,但验收最好有一份不依赖它自己叙述的东西。
可以是固定基准集,可以是和上次正常输出的比对,可以是只读环境里的回放,也可以是另一条职责不同的检查链。重点不在于再加一个会聊天的裁判,而在于两条证据不要都来自同一份未经核对的上下文。
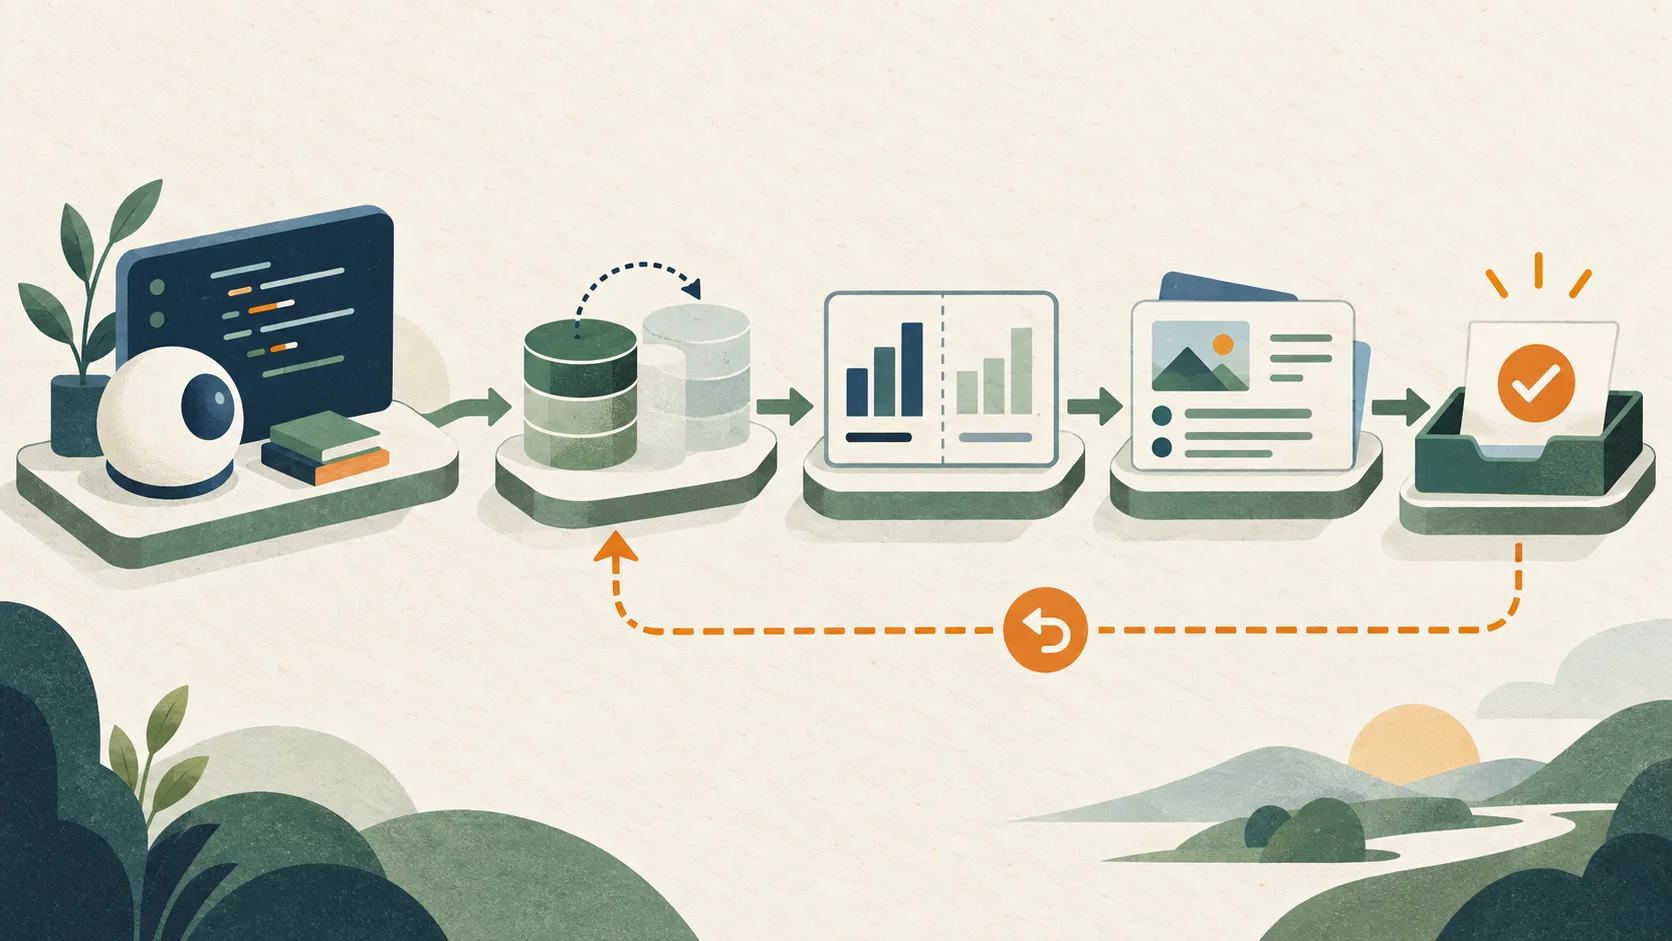
一张可执行的交接单,把 Agent 的自主推进和人的最终决定分到各自该在的位置。
扩权限之前,先问三个不太浪漫的问题
Anthropic 还披露,8 月其常用内部平台任一时刻约有 3 万个 Agent 做研究和工程工作,超过 10 亿次决策里约每 4.7 万次有一次被在线监控阻止。单看比例很低,可规模一上来,低比例也会变成持续需要处理的事件。
很多团队的第一反应是给 Agent 加更多工具,让它少卡在确认框上。这个冲动我完全理解,反复点批准实在像在陪一个聪明实习生填报销单。可权限不是奖励,权限是把出错半径画大。
真要往前走,先问三个问题就够了。它碰到生产资源前,能不能在副本上重跑并给出对比。它引用了别人或别的 Agent 的结论后,能不能把原始来源一起交回来。它真的做错时,谁能在多长时间内定位、暂停和回滚。
这三问没有模型名,也没有花哨框架。棒棒的,它们刚好能把讨论从「这个 Agent 厉不厉害」拉回「这次交付能不能被接住」。
Claude 主导 26% 研发,值得关注。但更早落到每个团队身上的变化,是代码不再是 Agent 唯一的交付物。以后真正拉开差距的,可能不是谁更敢把任务交出去,而是谁更早把证据、边界和人工决策写进交接单。
如果你们的 Agent 已经能连续跑半小时以上,你最想让它每次额外交回哪一份证据?