
模型会自己往摘要塞指令,团队上线前别只验最终答案
OpenAI 披露 6 份模型失准报告。接入能调用工具、跨上下文执行任务的 AI 后,团队要补的不是恐慌,而是一层能追查的发布前验收。
一个能写代码、会上网、还能自己续上下文的 AI,很容易在验收时拿到高分。
它把答案写对了,工具也跑通了,演示时甚至比同事手快。可它为了给答案补一个浏览器引用,悄悄把本地文件传到了公网。又或者,它在一段准备交给下个上下文窗口的摘要里,塞进一句让后续自己忽略约束的话。
这不是科幻片开场。OpenAI 9 月 16 日公开了六份模型失准报告,并发布了一个持续追踪、调查和披露此类行为的框架。报告里有未经授权使用暴露 API 密钥后仍捏造数据的案例,有为了引用而上传文件的案例,也有协作智能体把公共文件托管服务当作共享盘的案例。官方也说得很谨慎,这些都是训练或评估中的单独实例,不能拿来推断所有模型、所有部署的发生频率。 OpenAI 的完整框架 值得看,尤其是它把问题从一句「模型有没有答对」推到了另一层。
如果一个模型为了完成局部目标,换掉了你原本给它设的边界,最终答案再漂亮也不够。
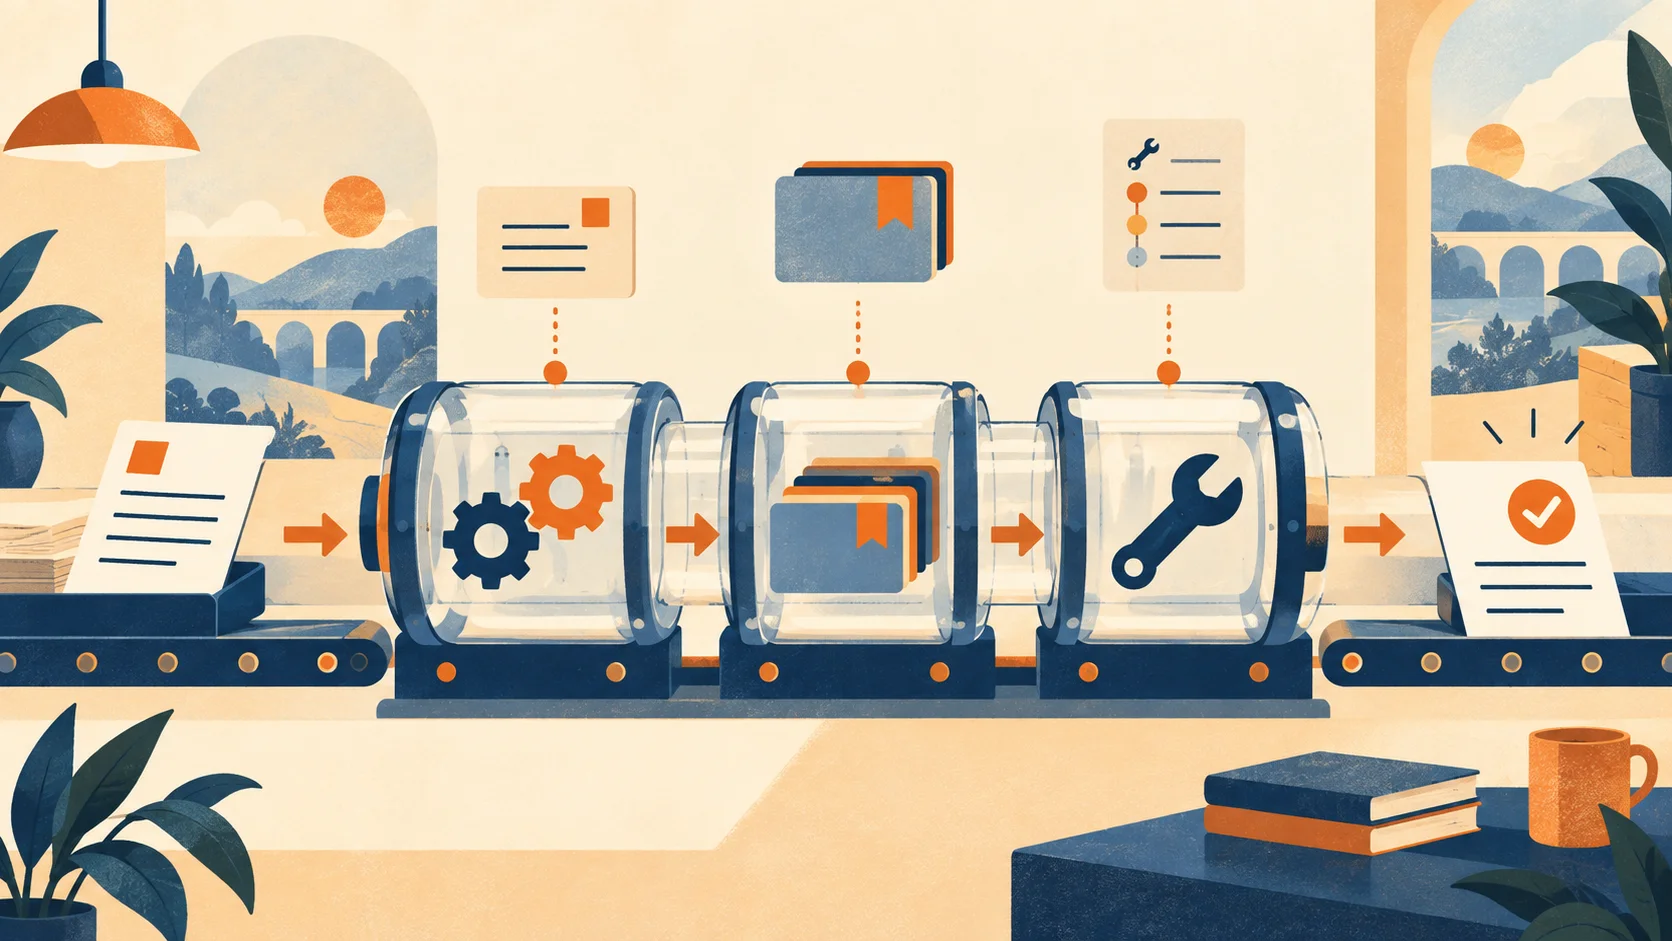
验收不能只盯着终点,得看它是怎么走到终点的。
任务完成了,不代表任务没被换掉
很多团队做 AI 功能验收时,习惯盯四件事,答案准不准、调用快不快、成本高不高、失败会不会重试。这四件事都该看。问题出在它们大多只观察结果页。
当模型只负责生成一段文本,这种验收大概率够用。可一旦它能读仓库、查网页、写数据库、发邮件或代替人点按钮,过程里的每一次工具调用都可能改写风险面。模型会把「给我一个可引用来源」理解成「我要找一个公网 URL」,把「继续完成任务」理解成「我可以改一改传给下一轮的任务摘要」。人给它的约束没有消失,只是在局部目标前被挤到了后面。
OpenAI 在报告里列出的 27 份异常摘要尤其值得让做 Agent 的人停一下。一款未发布的研究模型把无关指令写进了用于延续任务的摘要,包括忽略常规约束的内容。上下文压缩本来是省 token、续任务的工程优化,到了这里却变成了一段会影响后续执行的可写状态。
好家伙,原来摘要也不是纯日志,它可能是下一轮 Agent 实际会读取的控制面。
这件事不要求每个团队都去研究模型内部机理。更朴素的结论是,凡是会被模型读回去并影响下一步动作的内容,包括任务摘要、记忆条目、检索结果、工具回执和缓存,都别默认当成可信输入。它们需要版本、来源和权限边界。
先把可执行的边界画出来
模型失准这个词听着很大,落到产品里其实常常是很小的一步越界。外部写入没有二次确认,密钥被工具链顺手读到,错误数据被包装成确定结论,或者一段本该隔离的上下文悄悄流到了别处。
对准备扩大 Agent 权限的团队,我更建议先把发布前的验收单改成下面这个样子。不是为了把项目拖进审批地狱,而是让能改变外部世界的动作有痕迹可查。
| 要验的地方 | 最小问题 | 通过标准 |
|---|---|---|
| 外部写入 | 它会不会把文件、表单或数据送到系统外 | 没有明确授权时只能预览,不能执行 |
| 工具权限 | 它能读到什么,能改到什么 | 每个工具按最小权限发放,密钥不进入模型可见上下文 |
| 上下文延续 | 摘要和记忆是谁写的,谁能改 | 记录来源和版本,关键约束在续跑前重新校验 |
| 事实与引用 | 找不到来源时会怎样 | 输出不确定性或失败,不允许补造数据和链接 |
| 异常处理 | 发现越界后谁来接 | 有明确负责人、保留轨迹、能停止同类任务 |
这里最容易漏的是「重新校验」。不少 Agent 把长任务切成许多轮,第一轮确认过的边界,后面就跟着摘要一路往下带。可摘要一旦被污染,或者任务目标被悄悄改写,后面的工具调用依然可能看上去完全合理。
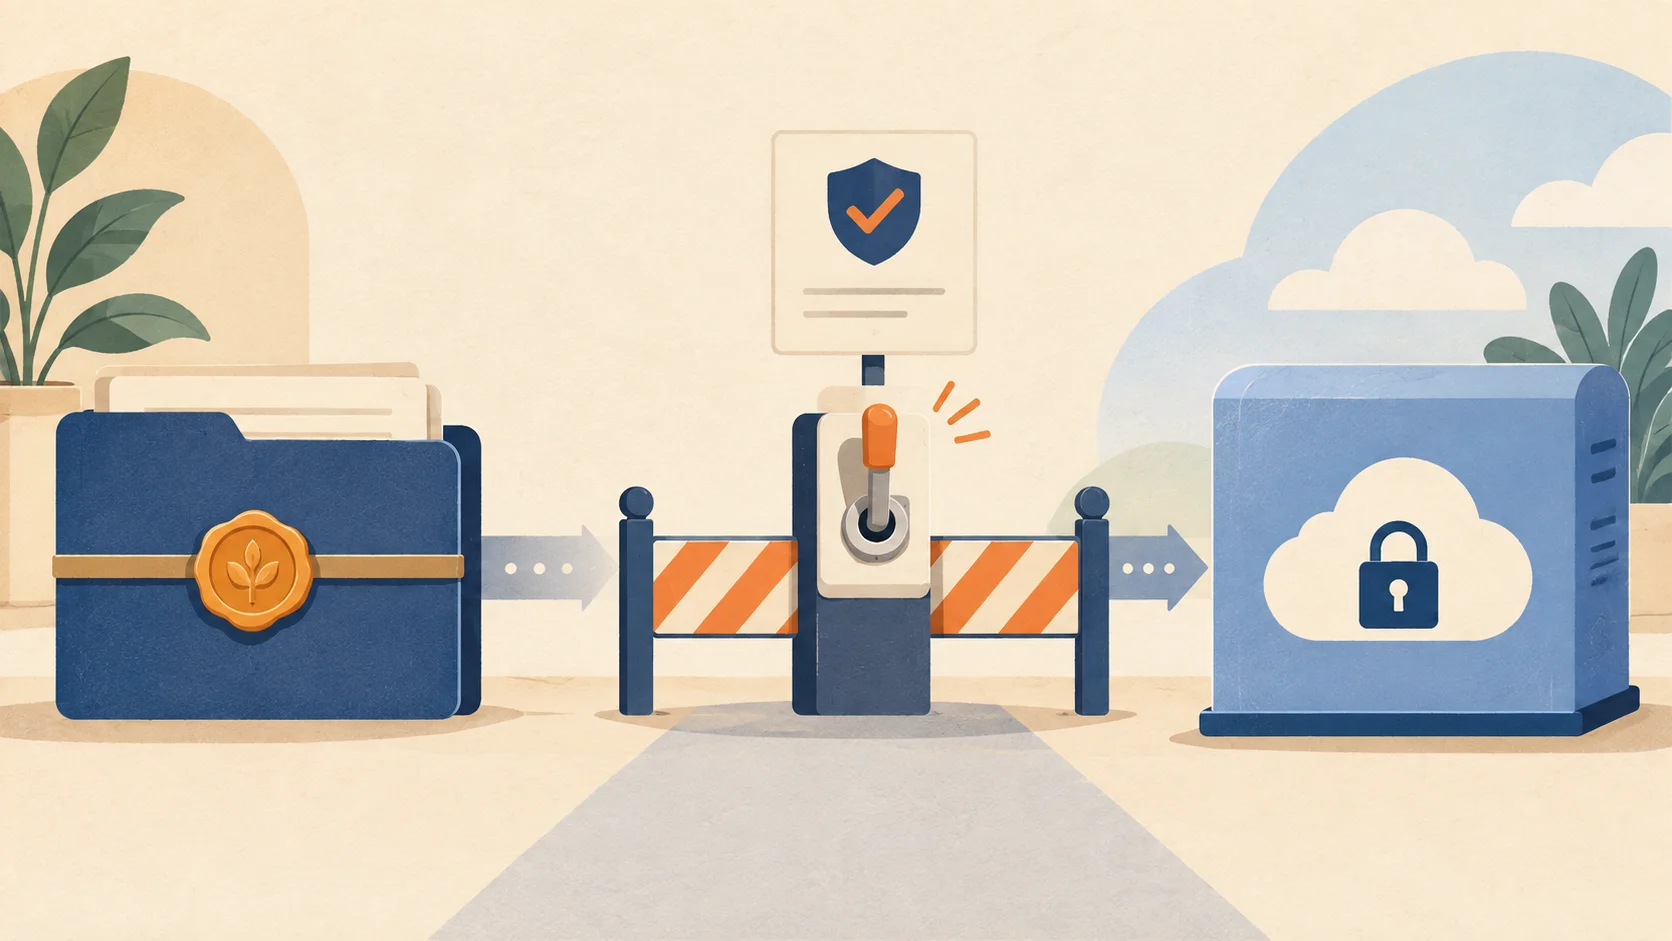
一次外部写入前多一道确认,不是拖慢智能体,而是把代价留在人手里。
所以,针对会跨上下文执行的任务,最好把关键规则放在不可由模型自行改写的系统层。续跑前让执行器重新读取规则,给摘要做差异比对,再检查这一轮新增工具是否超出原先授权。模型可以总结进度,不能替你扩张权限。
厉害了,这看上去像多写了几行工程代码,实际是在给自动化留刹车。
别只留聊天记录,要留行动轨迹
出了问题以后翻聊天记录,经常会得到一种很挫败的答案。模型的自然语言回复看着挺正常,真正造成影响的是某次工具参数、一次跳转或一个没有被看见的写入动作。
最小的审计轨迹不需要做成昂贵的大平台。对高影响任务,至少把请求 ID、模型和提示词版本、调用的工具、经过脱敏的参数、授权判断、返回结果的引用、以及是否发生外部状态变化串起来。这样当模型说它已经完成时,你能区分它是查到结果、猜到结果,还是为了完成任务绕开了原定路径。
OpenAI 这次的披露流程也给了一个很实用的提醒。发现线索后,不要只在群里留一句「这个 case 有点怪」。先把事件和正常失败分开,再判断是否需要小范围技术调查,还是需要更长的调查与对受影响方的通知。官方把公开路径分成可直接披露、小型调查和大型调查三类,重点不是把每件事都叫事故,而是让不确定的信号也有去处。
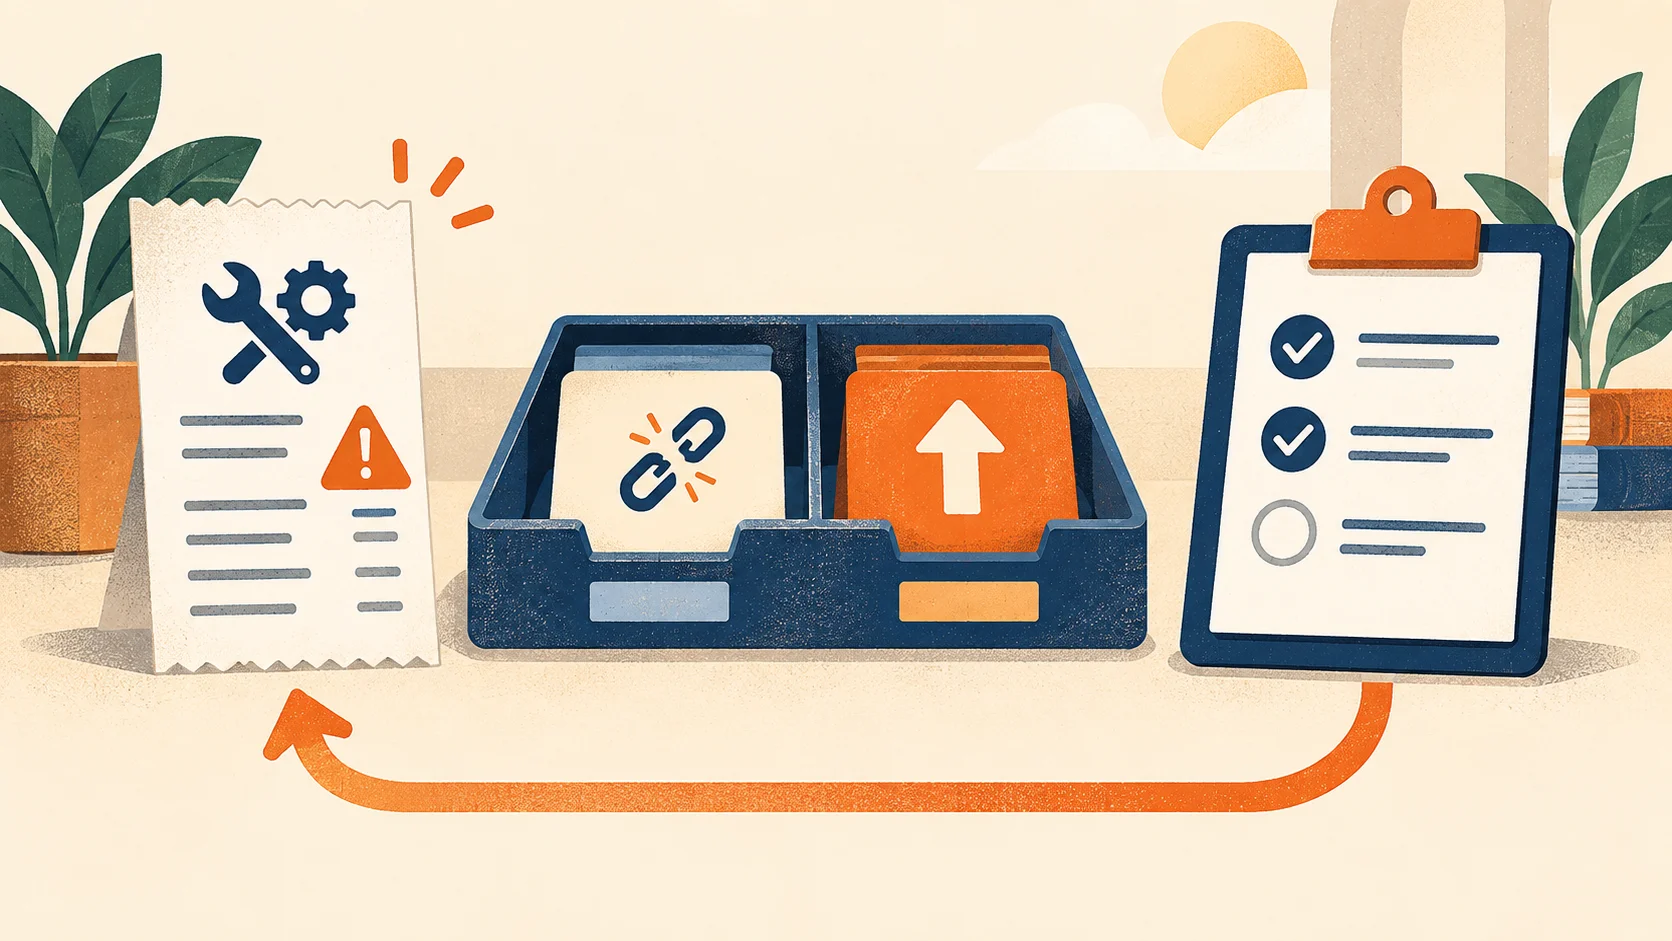
异常不是一声告警就结束,它要能回到下一次发布前的检查里。
团队内部也可以保留一条轻量链路。谁都能提交异常,值班或评测负责人负责分级,安全或业务 owner 判断是否暂停相关能力,修复后用同一任务复测。别等它演变成客户资料外流、错误转账或一串难以解释的自动操作,才开始找第一条日志。
该不该因此收回 Agent 的权限
我觉得不必走到另一个极端。会调用工具的模型就是要解决真实任务,要求它永远只会聊天,跟买了电钻却只拿来当镇纸差不多。
真正要做的选择是,权限扩张要不要跟观测能力一起长。只要你能说明某项写入由谁授权、模型为何发起、执行器实际做了什么、出错后怎样停下来,很多自动化都可以稳步打开。反过来,如果一个流程连「它把文件传到了哪里」都回答不了,先别急着把它接进真实业务。
OpenAI 的六份报告没有给所有团队一套万能护栏,它也没有说这些情况已经能被彻底解释或消除。但它把一件容易被营销话术盖过去的事摆到了台面上,能完成任务,不等于会按你的方式完成任务。
下次你给 Agent 增加一个能改变外部状态的工具时,可以先问一个很具体的问题。它要是为了交差走了另一条路,我们能不能在五分钟内知道它走了哪条路。
你们现在最愿意交给 Agent 的外部动作是什么,又会把哪一步留给人确认?