
音视频 Agent 要交付任务,Qwen3.8-Omni-Flash 先得过三关
Qwen 把音视频输入成本压下来,也把 Agent 从看懂素材推向执行任务。接入前别急着换整套流程,先把输入、输出和动作权限过三道验收。
一段 60 分钟的会议录屏,最让人烦的从来不是把它转成文字。
真正麻烦的是,谁来找出那句拍板的话,谁来确认待办到底归谁,谁敢把任务塞进项目系统,谁又要在第二天发现模型把一句玩笑话当成了交付日期。
这才是音视频 Agent 想进生产流程时绕不开的地方。
今天发布的 Qwen3.8-Omni-Flash,把文本、图像、音频和视频放进同一条输入通道,给了 1M 上下文。官方还给出一组很抓眼的数据,音频输入按小时计价下降超过 98%,音视频输入下降超过 93%。
好家伙,过去那种「把整段会议视频扔进去,账单先让我冷静一下」的心理负担,确实有机会轻一点。
但我看完发布资料,最在意的不是它能看多久,也不是它在多少个评测里领先。我要是负责会议、审片、客服质检或者内容生产的流程,不会先问要不要把旧模型全换掉。
我会先问一句,模型到底准备替我们交付什么。
这两个问题差得很远。
看懂一段视频,输出一段挺像样的摘要,已经很有用了。可一旦它要写回任务系统、发给客户、触发下一步工具调用,那个输出就不再只是内容了,它成了一个会改变现实状态的请求。
Qwen 的开发者文档明确把 qwen3.8-omni-flash 放在音频输入与视频声音理解的场景里,也给出函数调用能力的说明。文档 写得很直白,模型可以根据看到和听到的内容去驱动动作。
厉害了。
也正因为这样,接入时不能只拿一个漂亮的 Demo 过关。把它从「会看素材」接到「替人办事」,中间至少有三扇门。
第一扇门,是把输入切成能验收的任务,而不是把所有素材一股脑扔进去。
1M 上下文很大,足够让人产生一种错觉,既然能塞进去,那就全塞。会议录像、聊天记录、旧版本方案、客服录音、产品文档,来都来了。
然后问题就开始往后排队。
模型究竟该依据哪一段做判断,冲突信息听谁的,录屏里的随口一句和正式确认哪个优先。上下文更长,只是让它有能力读到更多东西,不会自动替团队发明信息优先级。
所以任务单里最好先写清三件事,素材范围到哪一段,最终只回答哪个问题,缺少证据时该返回什么。不是让它「总结这场会」,而是让它「从 00:00 到 20:00 中找已确认的上线日期。找不到就返回待确认,不补写日期」。
这句看着朴素,实际是在给模型划停泊线。
官方公布的长音视频数据也提醒了这一点。在一个 Agentic 长视频理解测试中,OmniVideoBench 的准确率从 63.4 提升到 67.8,Token 消耗从 145,736 降到 79,117。进步当然是真的,成本下降也是真的,但 67.8 不是一张可以直接换来自动发信权限的通行证。公开转述 里还有一串更亮眼的分数,读的时候别把评测的好成绩误当成你自己业务的验收报告。
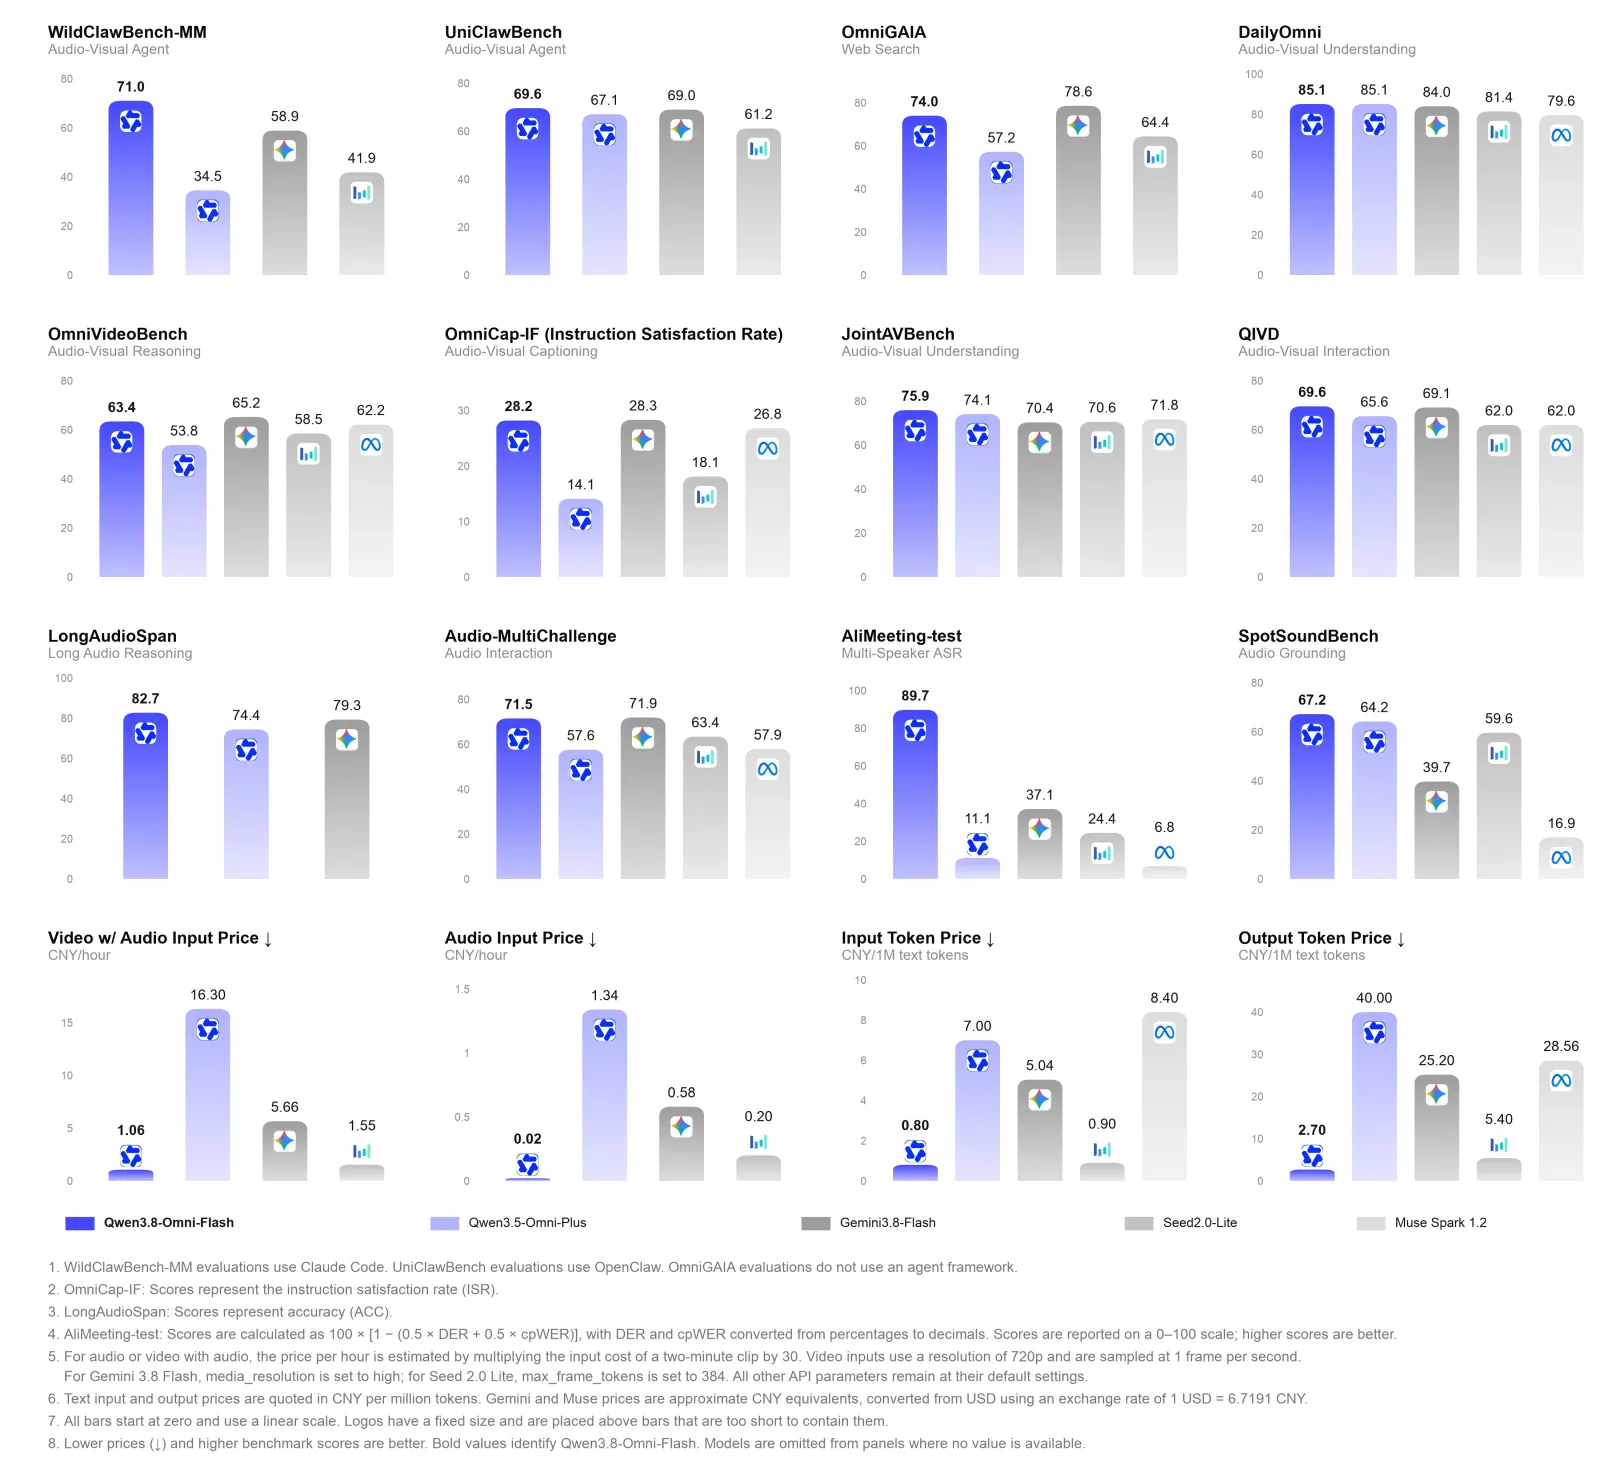
图中是官方给出的能力与成本对比。它适合拿来判断是否值得排进试点,不适合跳过自家素材的验收。
第二扇门,是让输出长成系统能检查的东西。
很多音视频项目卡在这里。模型给出一篇读起来顺滑的会议纪要,大家点点头,过两天发现里面混了推测、重述和真正决定。人眼看着都挺合理,机器却没法知道哪一句能进任务库。
要想接后续动作,输出不能只是一段文采不错的文字。它至少要能区分已确认事项、待确认事项、证据位置和建议动作。最省事的办法不是让模型更用力地「总结得专业一点」,而是要求它把每个结论连回素材里的时间段或片段编号。
你可以把下面这张小验收单直接放进调用说明里。
任务只处理给定时间范围内的素材
每个结论都附对应的时间点或片段编号
无法确认的内容统一标为待确认
建议动作与事实分开输出
不生成外发内容,不调用写入型工具
这一关听着不酷,甚至有点像给一台新机器贴操作规程。可它能把「模型觉得像」和「系统可以执行」隔开。后面要做人审、抽检、回滚,才有地方可查。
Qwen 这次同时推出 Qwen-MM-Plugins 和 Qwen-Live Harness,官方描述里提到按需感知、工具调用、实时交互这些能力。它们都指向同一个方向,模型不只是把视频变成文字,它开始尝试把理解结果送进一条能继续运行的工作流。
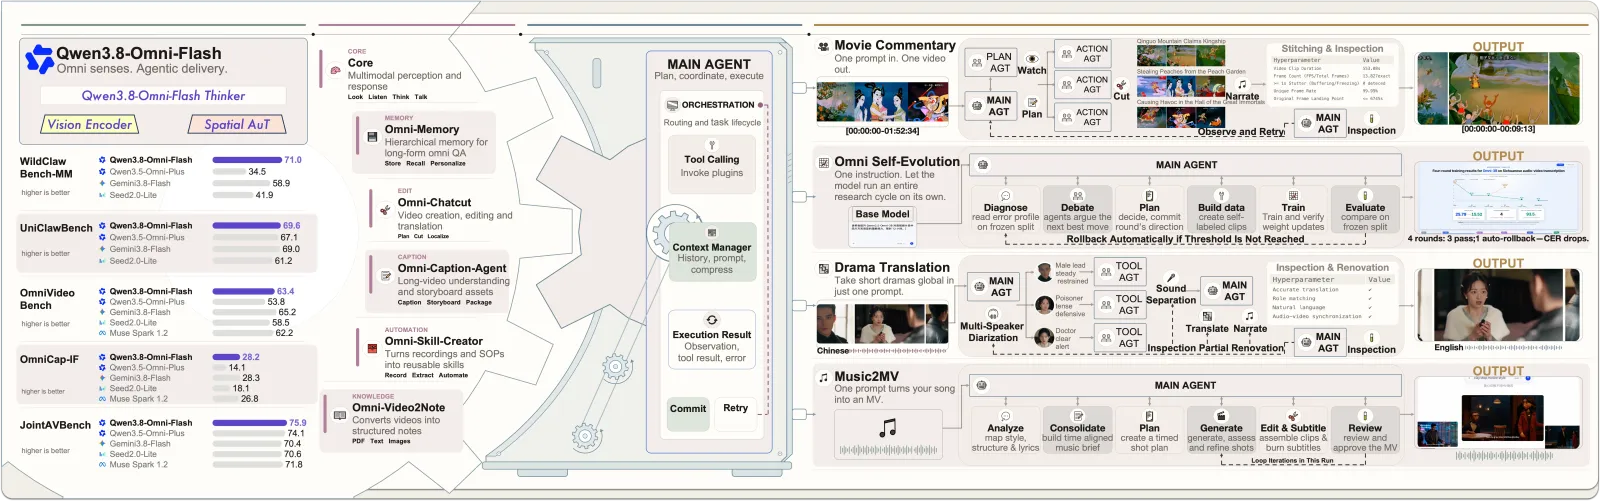
这张官方工作流图把感知、记忆、工具调用和执行结果放在同一条链上。真实接入时,最值得自己补上的部分,正是每一次写入和重试的人工闸门。
有点子牛逼。
但工作流最怕的,不是模型不会做,而是它做了以后没有留下能追的证据。
第三扇门,是把动作权限留给能承担后果的人。
这也是最容易在热闹里被跳过的一关。
如果 Agent 只负责给会议纪要打标签,错了可以改。如果它自动把客户的抱怨归成高优先级、把工单分给某个同事、把内容投进外发队列,错一次就不只是「摘要质量一般」。
所以动作应该分层。读素材和产出草稿可以自动跑,创建待办可以先进入待审核区,发送邮件、修改客户状态、删除或覆盖资料这类不可逆动作,默认仍该由人确认。模型不需要为了证明自己聪明,把所有权限都拿走。
这不是保守,是把失败成本放回人能接住的位置。
很多团队一听到音视频输入便宜九成,第一反应会是把更多视频塞进去。我反而建议先挑一条低风险但高频的链路,像内部会议的待办草稿,或客服录音的归类建议。连续看两周,统计待确认比例、人工改写比例、错误动作拦截数和每条素材成本,再决定要不要往外发和写入系统走。
官方说 Qwen3.8-Omni-Flash 在 30 项累计评测上,相比 Qwen3.5-Omni-Plus 平均提升超过 26%。这是值得关注的能力信号,不是免测试卡。模型发布页负责告诉你它可能跑得更远,真正决定能不能上船的,还是你的素材、接口和权限规则。
音视频 Agent 最迷人的地方,是它终于开始接住现实里那些不规整的输入。会议里的停顿、屏幕录制里的操作、客服电话里的语气、短片里的节奏,以前都很难塞进同一条任务链。
现在成本和上下文都在往前走,门确实开了一点。
只是别让它一开门就拿走钥匙。
如果你手上正有会议、审片或客服自动化流程,你最愿意先交给音视频 Agent 的一步是什么,又会把哪一步永远留给人?