
代码审计用上 Agent 后,最值钱的是那套临时工具
Trail of Bits 为一次 Miden 审计补齐 LSP、反编译器、静态分析和 Lean 模型,抓到高危漏洞与 400 多处缺口。普通团队不必照搬形式化证明,但该把 Agent 产物送进可读、可测、可审的入口。
把一个仓库交给 Agent,让它跑一轮代码审查,这件事现在已经不稀奇了。
真正难的是下一步。它给你几十条看上去很专业的结论,夹着一堆文件路径、调用链和修复建议。你盯着屏幕,心里只有一个问题,它说得对吗?
Trail of Bits 刚公开的一次 Miden 审计,给了一个很不时髦、却很扎实的答案。他们没有把 Agent 当成会自动盖章的审计员,而是拿出约六个月,让 Claude 和 Codex 为一种陌生汇编语言造了一套临时工具。
LSP 服务、反编译器、静态分析引擎,还有 Miden 虚拟机的 Lean 形式化模型。
好家伙,听上去像准备再开一家编译器公司。
但这套准备工作最终找到了一个高危问题、400 多处类型验证缺口,又留下了 95 个由 Lean 内核检查的正确性证明。那套临时工具没有跟着审计报告一起消失,Miden 团队把静态分析引擎留下来,继续检查后续更新。
这件事最值得带走的,不是「Agent 又能找多少 bug」。而是代码审计一旦让 Agent 参与,最值钱的产物常常藏在它替你造出的检查入口里。
审计还没开始,工具链已经开工
Miden 的核心库写在 MASM 里。这是一种栈式汇编,很多指令的输入和输出不写在参数表上,全靠栈顶位置默默传递。人读它时,得一直在脑子里记住上一个值被谁拿走、下一条指令又把什么压了回去。
这类代码最怕两件事。第一是陌生,第二是没有工具。没有跳转定义,没有引用查询,没有 linter,也没有把底层过程翻成较高层逻辑的反编译器。你以为自己在审一段加密代码,实际还在同时手动当 IDE、数据流分析器和记忆管理器。
Trail of Bits 没有让模型一上来对着整库输出漏洞清单。他们先让 Agent 造出一个 LSP 服务,让代码里能显示指令说明、过程文档和每一步的栈效果。人终于能看见这些隐含值在怎么流动,不用靠意志力把整条栈链背下来。
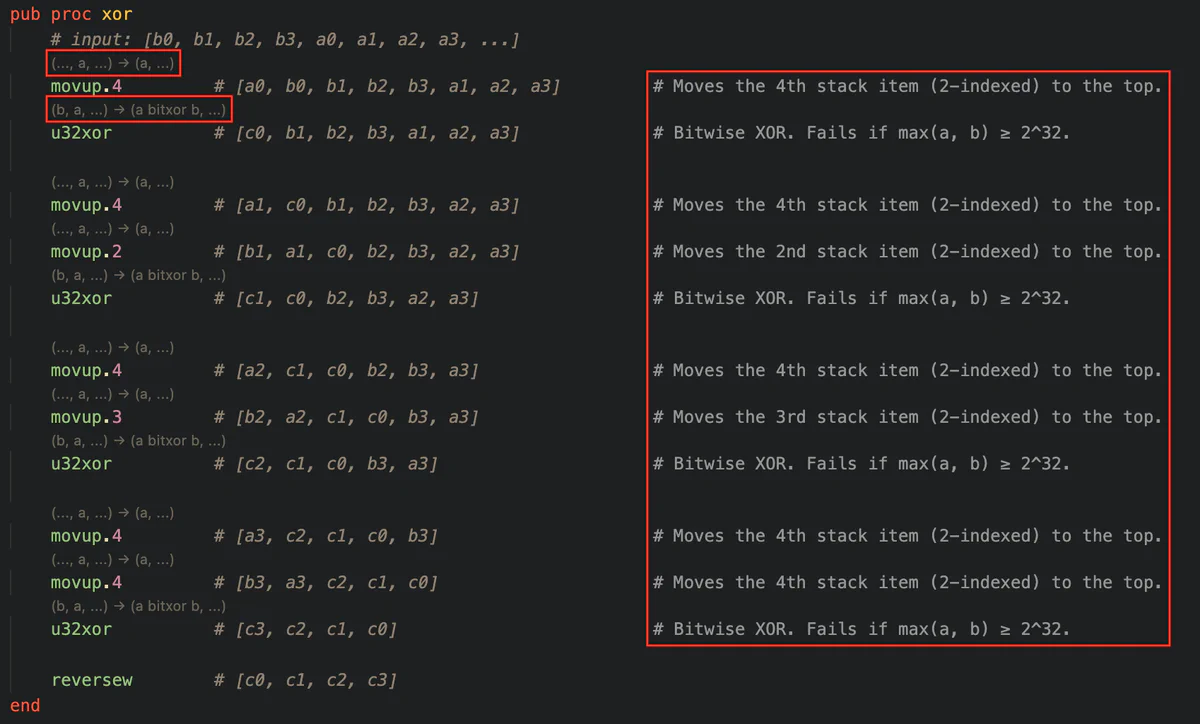
图中每一行旁边的提示,正是给人类审计者减负的那一层。它没有替人下结论,却把结论所需的上下文摆到了眼前。
反编译器的处理更克制。他们没有承诺把所有 MASM 过程都翻成正确的伪代码,只处理一个能保证正确的子集。每多做一个特性,就让 Agent 随机抽一批过程,把反编译结果和原始 MASM 对照。发现问题就补成回归测试。
有点子牛逼的地方在这儿,Agent 生成的内容没有因为「看起来能用」就拿去当依据。它先被塞进了一条会反复撞墙的测试链路。能留下来的,才有资格变成审计工具。
把阅读变成规则,bug 才有地方现形
有了反编译器,团队得到的并不只是更好看的伪代码。他们拿到了每个过程的中间表示,也就是把指令输入和输出写成表达式后的结构化视图。接着才有机会做数据流分析和抽象解释。
这些名字听着有点硬,落到审计里其实很朴素。证明者塞进来的余数和模逆有没有验证范围?输入被当成 32 位整数或布尔值时,约束有没有真的执行?局部变量会不会只在某条分支初始化?
规则一旦变成可执行的检查,审计就不再只依赖谁读代码时最清醒。
实际审计里,静态分析报告了 400 多处类型验证可以补强的位置,还撞到一个高危问题。一个模运算过程把证明者提供的余数送入 32 位指令之前,没有验证它是否仍在合法范围。攻击者可以借此构造错误结果,伪造 Falcon 签名并转走相应账户的资产。
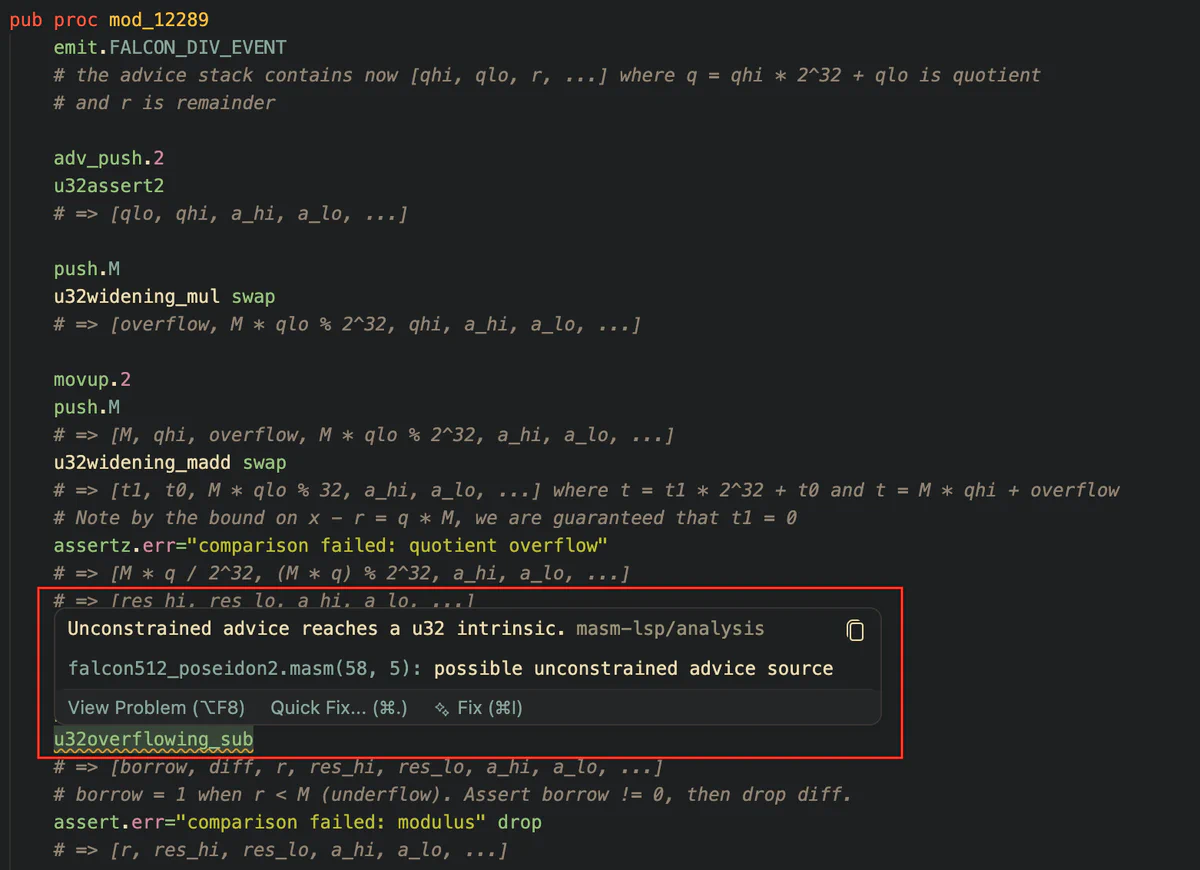
这张截图比一段漂亮的漏洞摘要更有用。它把风险落到了具体位置、具体条件和一个可继续追的检查规则上。
很多团队让 Agent 参与审查时,会卡在一个很尴尬的状态。模型会解释,会给修复建议,也会画调用链,厉害了。但它交出的东西依旧像一封写得很长的邮件。审阅者读完,还是得从头确认。
Trail of Bits 的做法把这个顺序倒了过来。让模型优先造能反复运行的分析器,再让分析器和人一起找问题。模型的输出从意见,慢慢变成了可以复查的仪器。
证明能自动验,人该盯住命题
他们又往前走了一步,把 MASM 过程转成 Lean,尝试证明这些过程满足应有的正确性。最终有 95 个证明通过 Lean 内核检查,覆盖了核心库全部二元算术组件,还抓到两个原单元测试没抓住的边界 bug。
这部分最容易被吹成「Agent 自动形式化验证」。别急,真正重要的边界反而很清楚。
Lean 内核能检查证明体有没有推理漏洞,人要审的是定理到底在说什么。一个数学上无懈可击、但写错了安全性质的定理,依然帮不了你。人没有退出审计,只是从逐行追一大坨生成代码,收缩到了检查性质、前提和业务语义。
这就很像给 Agent 写的测试定验收。模型可以写实现、补样例、甚至起一个分析框架。可你得先决定什么情况算通过,哪些输入属于边界,哪类异常绝不能被吞掉。没有这层判断,跑绿的日志再长也只是一叠很有礼貌的噪声。
普通团队当然不用明天就去给业务代码写 Lean。小项目也未必需要造反编译器。可这次审计留下了一张挺好用的准备单,碰到陌生、高风险、又准备让 Agent 深度参与的代码库时,可以从这里开始。
先让人看得懂,补符号、跳转、数据流与关键状态的可视化
再让规则跑起来,把类型、来源、初始化与边界条件写成检查
让 Agent 的每项新能力都撞过随机样本和回归测试
再由人确认检查的性质、威胁模型和发布门槛
Trail of Bits 这篇公开复盘有一个挺现实的判断。过去,为一次审计临时造工具,很难提前向客户解释为什么值得花这么多钱。现在,探索失败主要消耗 token。工具一旦做成,之后每一次改动都能继续受益。
不是每个 Agent 都得去写一百多个提交。可如果它参与的是安全审计、支付链路、权限系统,或者你根本不熟悉的旧代码,别只收它给的结论。让它把一部分聪明劲花在造检查入口上。
这样下一次有人问「它说得对吗」,团队手里至少有能回放、能追问、也能亲手推翻的东西。
你们团队里,最希望 Agent 先替你补上的审计工具是什么?