
蛋白模型跑不动时,Claude 给 30 多个开源项目提了速
Anthropic 称 Claude 在不到四周优化了 30 多个开源生物模型,平均提速约四倍并开源代码。更值得工程团队拿走的,是一条可复用的优化与验证路径。
把一个生物分子模型的输入长度翻一倍,运行时间和显存不一定只是多一倍,常见的结构预测算子会把账单翻到八倍。
做过 AlphaFold、OpenFold 或类似结构预测的人,对这种感觉大概不陌生。实验还没开始,GPU 队列先把人晾在门口。模型能不能跑出来,往往不是研究问题已经想清楚了没,而是显存、内核和那段谁也不想碰的推理代码肯不肯配合。
Anthropic 昨天发布了一组结果,称 Claude 在不到四周里优化了 30 多个开源生物分子模型,平均提速约四倍,同时把代码放到了 GitHub。
好家伙,30 多个。
如果这只是一条「模型又会做科学」的新闻,刷过去也就刷过去了。真正有意思的是,它没有让 Claude 假装成一个发现新理论的科学家,而是让它去干科学软件里最脏、最贵、也最不容易被写成发布会标题的活,改推理路径,省显存,跑基准,盯住结果别变坏。
这条路对做科学计算的人很熟,对做普通软件的人也不陌生。很多团队嘴上都在聊 Agent 能不能替人工作,落到生产环境,第一关往往是更朴素的问题,改完之后,测试还过吗,成本降了吗,别人能复核吗。
这次公布的材料不该被读成「Claude 已经替代了生物信息工程师」。官方结果来自 Anthropic 自己的评测,本文也没有做本地复现。它更像是一份相当具体的工程案例,告诉我们,模型开始能进入那些原来需要专家手艺、但又有明确验收标准的重活了。
最贵的地方,通常不是模型参数
蛋白结构预测和设计模型里,有两类操作很出名,triangle attention 和 triangle multiplication。名字听着像课堂作业,脾气却一点也不温柔。它们要同时看一组三元关系,用来描述分子内部的空间几何。系统规模翻倍,计算量和内存开销可能接近八倍。
所以很多科学团队的现实不是「模型够不够聪明」,而是「这次能不能在现有 GPU 上跑完」。你可以有一个好想法,也可以有一堆公开模型,到头来还是会卡在等待、显存溢出和昂贵的多节点推理上。
Anthropic 这次先让 Claude 处理的,正是这块硬骨头。它们称 Claude 协助做出了 FlashPairformer,一组用于替换关键计算路径的 GPU kernels。和 NVIDIA 的公开基准实现相比,官方报告里 triangle attention 的加速范围约为 2.7 到 2.9 倍,triangle multiplication 约为 1.7 到 3.2 倍,具体会随模型配置变化。
这个数字不该被粗暴翻译成「所有蛋白任务都快三倍」。kernel 的局部跑分和整条推理链路不是同一件事,硬件、输入长度、模型版本都会把结果拉开。可它有一层很实在的价值,那个最贵的瓶颈被摊在了台面上,外人知道应该看哪里,团队也有机会自己验证哪里。
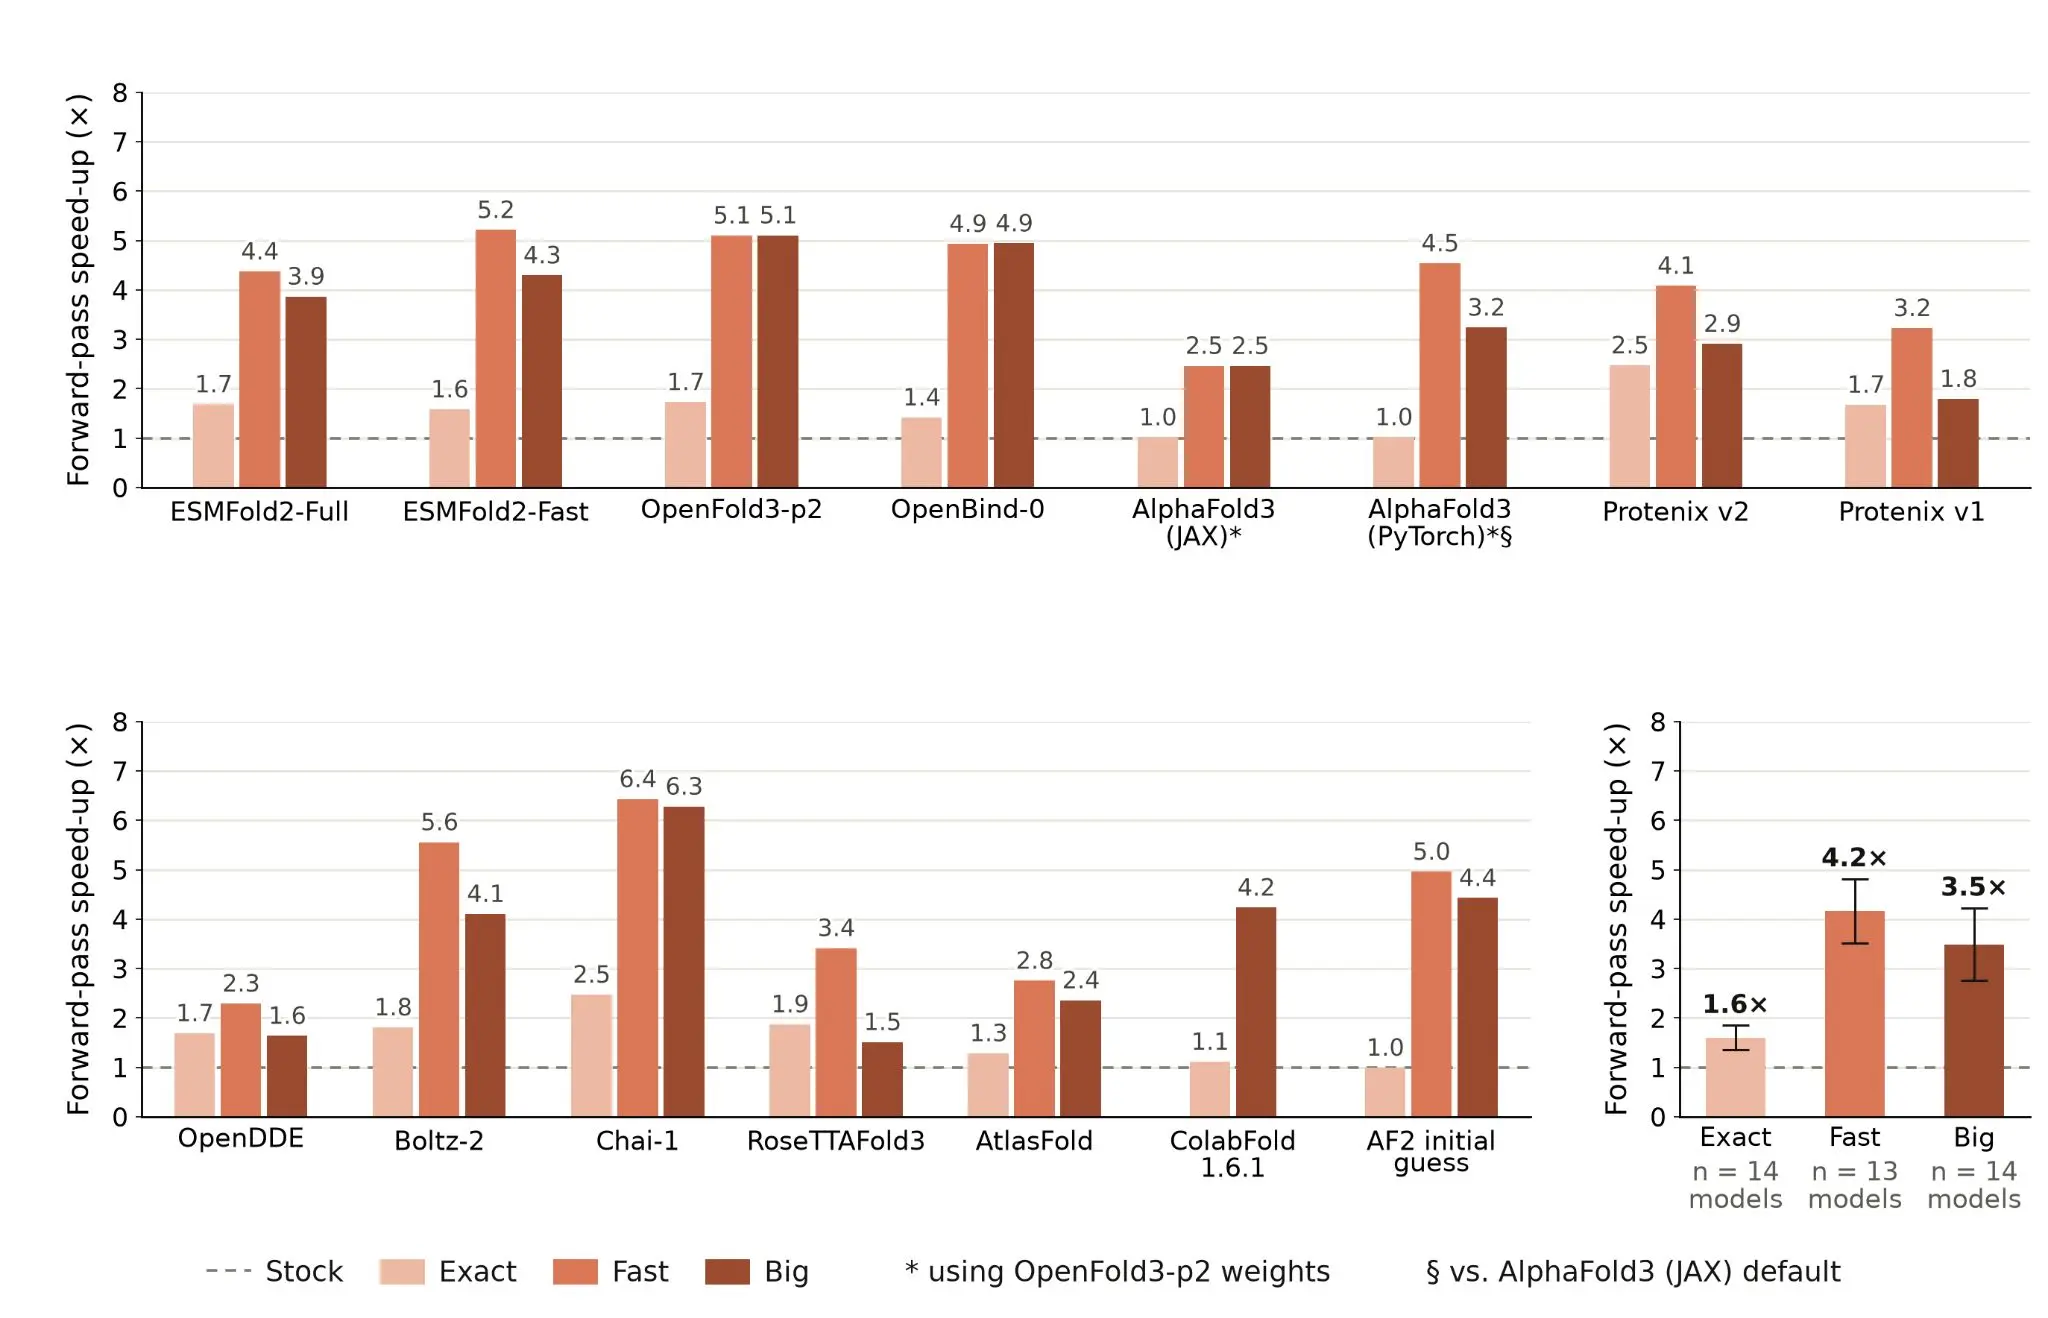
官方图展示了多种结构预测模型的加速情况,图表来自 Anthropic,本文未复现。
再往下一层,Claude 做的不是只写一段更快的底层代码。官方描述里还有缓存重复计算、把无效分支收敛成常量输出、针对单个模型处理特定路径。这些事情听起来不性感,写过服务端的人应该很熟。真正拉成本的,有时不是大架构,而是一个在循环里被白跑了几千次的小动作。
厉害了,但这里的厉害不是把一个黑盒塞进仓库就完了。Anthropic 的说法是,针对每一个模型的加速版本,都检查了下游任务表现没有被影响。对结构预测来说,这个约束很要紧。你当然可以把推理做得飞快,前提是不能把一个看上去正常、实际上失去科学效用的输出端到端地送出去。
我更愿意把这部分看成一条分工线。模型可以参与找机会、写改动、反复尝试。人和评测系统得负责决定哪些改动留在主干。前者负责快,后者负责不乱。
能塞进一张 GPU,不等于答案就变可靠
这篇材料里还有一个很容易被宣传口径盖住的细节。Claude 做了一个低内存的 Big mode,官方称它能让超过一万个 token 的生物分子系统在一台 NVIDIA GPU 节点上得到准确预测。这里的 token 指氨基酸、核苷酸以及小分子、离子等组成单位,不是聊天窗口里那种文字 token。
对做这类任务的人来说,一万个不是装饰数字。核糖体、线粒体复合体、伴侣蛋白这类大分子机器,过去经常要靠更重的资源配置才能碰。官方展示的例子里,人类线粒体复合体 I 和 70S 核糖体都超过一万个单位。
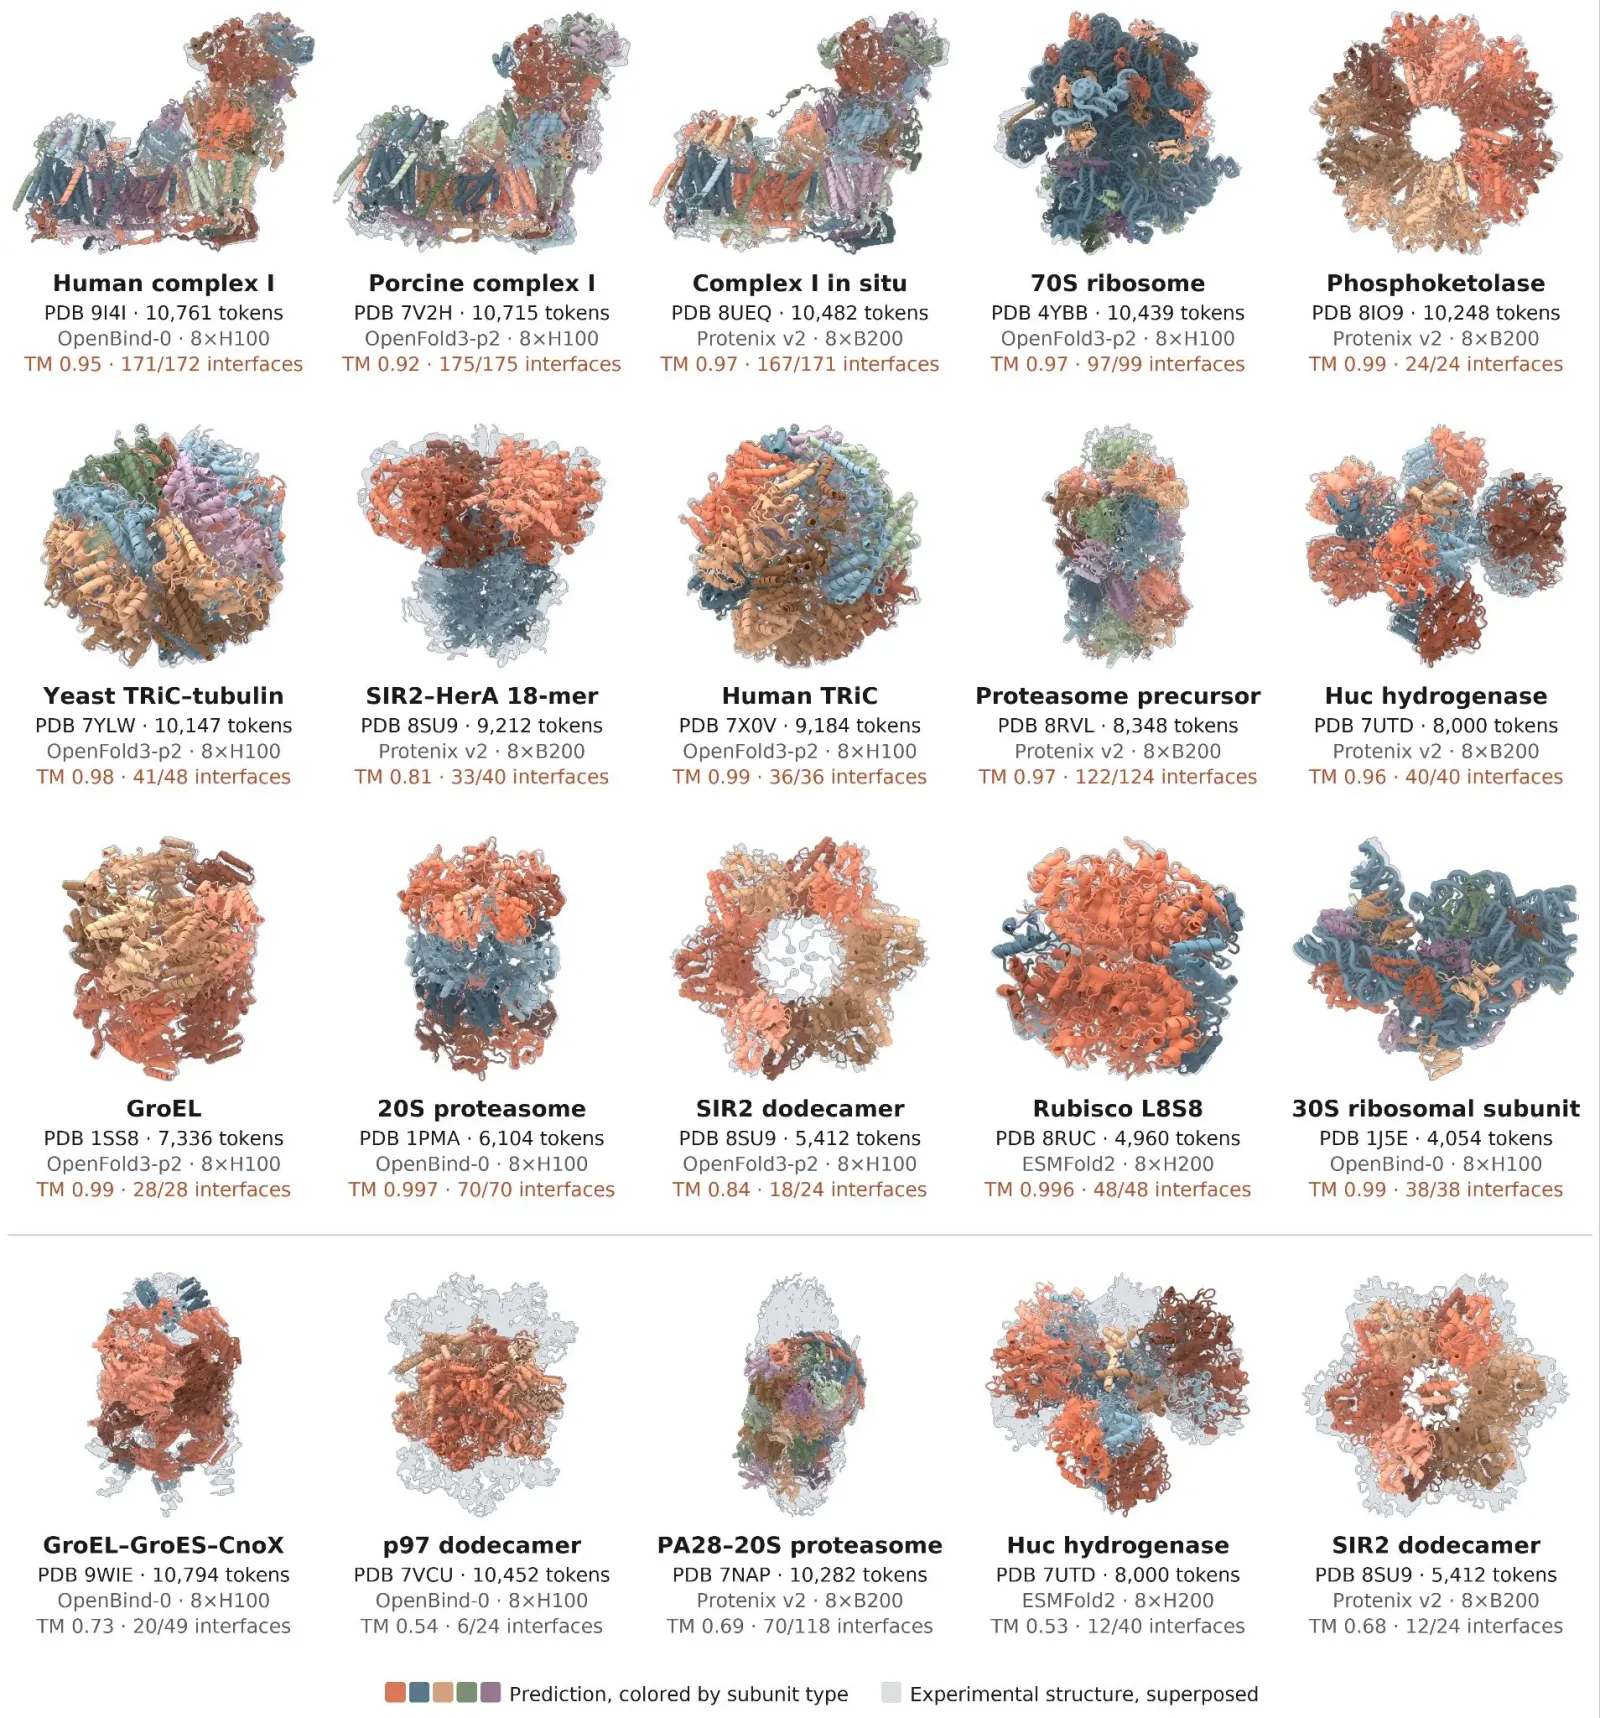
官方图展示了 Big mode 的大系统预测样例,以及准确与失准输出的对照。
但文章后半段没有把这件事写成万能通行证,这一点反而让我觉得材料能看。
Anthropic 又让 Claude 去挑战三万一千到七万个单位的病毒衣壳和蛋白质隔室。推理确实可以在一台 8 卡 B300 节点上完成,不过预测出来的结构塌掉了,官方明确写了这些结果不正确。也就是说,计算门槛被压低了,不代表模型的泛化边界跟着被突破。
这个区分太重要了。工程团队很容易把「跑通」错当成「可信」,尤其当那个结果刚好很快、很便宜、还配了一张漂亮的图。其实吧,能跑只是准入,准确性、稳定性、可重复性才是交付。
做业务 Agent 也是同一个道理。一个自动化流程能把表填上、把邮件草稿生成出来、把代码提交上去,并不等于它就该拥有收口那一步的权限。输出越便宜,复核越不能省。不是因为模型不够聪明,而是因为成本下降后,错误扩散得也更快。
这次官方材料没有藏起失败边界,算是给后来人留了一个很好的参照。好的 benchmark 不只是列胜利,也要告诉你从哪一段开始别信。
真正能复用的,是验收方式
Anthropic 还给出了两组成本很不一样的蛋白设计设置。较早的实验允许模型使用大约一万六千词的提示词、子智能体和每个目标最多一万美元的计算资源,约等于 2,500 个 H100 GPU 小时。
新的设置收紧了很多。单个 Claude 模型,一张 H200,24 小时,一段约 1,100 词的提示和预装工具说明,没有子智能体。它们在 16 个目标上做了比较,官方称三种 Claude 模型拿到了与早期活动接近的计算机模拟表现,同时用了约两个数量级更少的 GPU 小时。官方估算 GPU 与 token 的合计花费约为 150 美元。
看到这儿,很多人第一反应会是「模型更强了」。我觉得更值得盯的是另外一件事,工作流被缩短了。
早期的长提示、多个子任务和巨额计算预算,像一支临时拼起的远征队。新设置把目标、工具和验收边界收紧,模型才有机会在更小的资源盒子里完成同类工作。它不是把人从流程里抽掉,而是把每一步该交什么、怎么验,写得更清楚了。
这不只属于蛋白设计。你让编码 Agent 去优化一个慢查询、重构一段 CUDA 代码,甚至修一条很长的数据流水线,真正能复制的顺序也差不多。
先留住一个干净的基线,知道原来花多少时间、内存和钱。再明确哪些结果绝对不能变,可能是单元测试、数值误差、结构评分,也可能是业务规则。然后才放模型去找缓存、分支、批处理和调用次数里的浪费。收口时,把所有有收益的改动放回同一套基准里跑。
这套顺序看上去普通,普通到有点像废话。可很多 Agent 项目就是在这里翻车的。它们有生成,没有基线。有动作,没有验收。有一堆看起来很会干活的轨迹,没有一条别人能重复的结论。
Anthropic 把优化代码开源出来,是这次发布比漂亮数字更有分量的地方。你可以去看 仓库,也可以对照 技术报告 里的方法和限制。要是只剩一张「平均四倍」的海报,这件事离工程资产还很远。代码、图表、失败案例和可复跑的评测摆在一起,才有机会被别人接着做。
棒棒的,科学软件终于不只是在等更大的模型,也开始把旧代码里藏着的成本找出来了。
不过我还是想留一个有点扫兴的问题。模型越来越擅长改代码以后,你们团队最先愿意交给它优化的,会是哪一段?又准备拿什么证据证明,它真的改对了?