
AI 网关终于能看懂 Agent 在忙什么了
Claude Code 给 LLM 网关补了五个可选请求头。它们不让模型更聪明,却能让排障的人分清一条 Agent 请求卡在模型、工具还是上下文。
一条 Claude Code 请求穿过公司网关,日志里常常只剩一个模型名、耗时和状态码。
然后它慢了。
你知道它慢了,却不知道是在等模型吐字、等工具返回,还是刚经历了一次上下文压缩。最尴尬的是,几种情况的处理手法完全不同,日志却长得像同一种事故。
Claude Code v2.1.273 这次补的东西不大,甚至默认关闭。它往 LLM 网关请求里加了五个 hint headers,带上请求类别、Agent 类型、上一轮工具耗时,以及上下文是否刚被压缩。官方 release 给出的开关只有一行。
export CLAUDE_CODE_GATEWAY_HINT_HEADERS=1好家伙,表面是一行环境变量,背后其实是在给网关补一双眼睛。
对只直连官方服务的个人用户,这个更新大概没有什么体感。对把 Claude Code 接进 LiteLLM、Cloudflare AI Gateway 或自建代理的团队,它值得认真看一眼。很多时候你并不缺一个更漂亮的仪表盘,缺的是在同一条请求里知道 Agent 正在干什么。
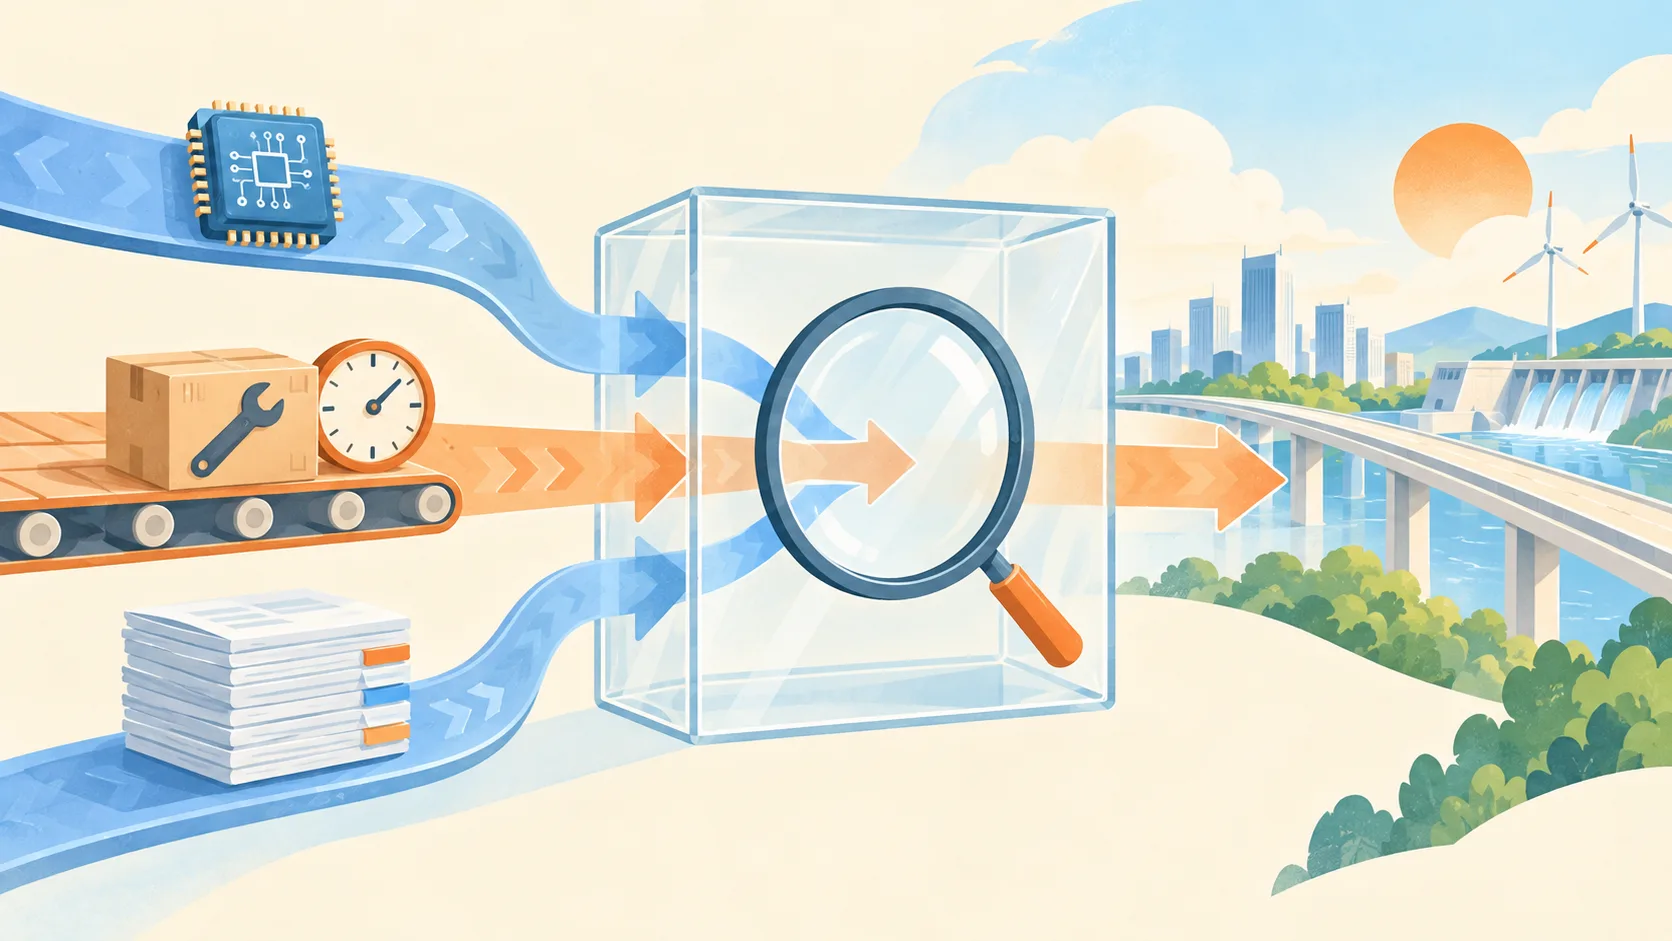
以前网关只看见模型名和耗时,现在可以把 Agent 阶段、工具等待与上下文状态放进同一条排障线索。
先把这五个字段翻译成人话。x-claude-code-request-class 是这次请求属于哪一类工作,x-claude-code-agent-type 说明是哪一种 Agent 在发起请求。前两个字段解决的是最朴素的问题,同一个模型突然贵了,到底是主会话在推理,还是后台子任务正在扎堆。
x-claude-code-prev-tool-durations 更有意思。它不是模型生成耗时,而是上一轮工具执行花了多久。一个 Agent 卡 40 秒,模型可能只用了 3 秒,剩下的时间全耗在仓库搜索、测试、浏览器或某个摇摇欲坠的 MCP 服务上。没有这个信号,网关监控很容易把锅扣给模型。模型也挺冤的。
剩下两个字段和上下文压缩有关。长任务跑到后面,系统为了不把窗口塞爆,会压缩前文。压缩后模型的回答质量、缓存命中和后续 token 消耗都可能变样。以前你只能看见某一轮突然慢了、贵了,猜半天是不是提示词变了。现在至少能先确认,它刚换过一只更小的行李箱。
这五个字段放在一起,才像一份可以开始工作的日志。
实际排错时,可以记住四个对应关系。请求突然变慢,就先看 prev-tool-durations,不要上来拉长模型超时。成本突然上升,就把 request-class 和 agent-type 拿出来分组,不要把所有 Agent 一股脑切去便宜模型。长任务后表现变了,就对照 compaction 和 context-compacted,别只改 system prompt。某类工作拥塞,再按 request-class 定向限流,不要只盯着模型名。
拿一个很常见的场景说。团队里有个修 Bug 的 Agent,它先搜仓库,再读一串文件,接着跑测试。上午一切正常,下午大家开始觉得它变慢了。网关的 p95 延迟翻了一倍,负责人很容易去改模型参数,或者给模型多开一点并发。
可如果 prev-tool-durations 显示耗时都堆在测试命令上,事情就完全不是一回事。也许是 CI 的共享 runner 被占满,也许是一个测试数据服务开始抖。模型端不需要加钱,工具端需要隔离。这个区别不性感,却能少掉一轮错误的救火。
再看成本。一个长任务经历上下文压缩以后,下一轮的 token 账单和缓存命中突然变样,并不自动说明模型退化了。它可能只是失去了部分前文结构,或者网关用完整请求体做缓存键时自然失配。把 context-compacted 作为分析维度后,才能把压缩前后放进同一张图里比。没有这层分组,成本曲线永远像一锅糊粥。
这也是我不建议上线第一天就让这些字段驱动自动路由的原因。观测字段不是事实本身,它只是客户端给网关的提示。一个靠谱的网关应该把它们当成可查询的标签,而不是可以直接信任的权限凭证。外部请求进来时,代理还要确认这些 header 只来自预期客户端,避免有人随手伪造一个 Agent 类型,把流量塞进本不该走的队列。
比较稳的落地方式,是让它们先经历三个小阶段。第一阶段只记录,选一小部分内部环境打开开关,看字段是否被代理或日志系统吃掉。第二阶段只做看板,把模型延迟、工具耗时、压缩状态分开看。第三阶段才写规则,而且一次只写一条,比如某类后台 Agent 连续出现长工具等待时告警给工具服务,而不是告警给模型平台。
没有一手实测数据时,别凭感觉替团队宣布它能省多少 token 或少多少钱。官方 release 也没有给出这类数字。它提供的是信号,不是收益保证。你得先看自己的请求分布,才知道工具等待、上下文压缩和模型生成究竟谁更常把用户留在加载页上。
还有一个很容易被忽略的地方,日志保留期。把 Agent 类型、请求类别和工具时长组合起来,在人员很少的团队里已经能还原出不少工作节奏。它未必包含代码或提示词,也不该因此被当成无害数据。采集前就要定好谁能看、保留多久、故障调查结束后是否需要降采样。可观测性做得太兴奋,反倒把内部行为轨迹存成另一份隐形资产,多少有点本末倒置。
如果要把它写进 runbook,我会给每条异常先留一个归因栏。模型生成、工具等待、上下文压缩、网关本身,四格足够。每次事故先填哪一格,再决定找谁。这个动作没什么花活,却能避免同一个问题在模型团队、平台团队和业务团队之间绕三圈。
这张表不是官方承诺的自动路由方案,而是一个很小的决策框架。模型慢,就看模型。工具慢,就看工具。压缩后的请求不稳定,就把它和没压缩的请求分开比较。听着朴素,生产事故里最难得的恰好就是这点朴素。
不少网关已经能根据模型、租户和 token 数做路由。Claude Code 官方的 LLM gateway 文档 也一直把网关放在模型路由、密钥管理和可观测性的交叉点上。问题在于,Agent 的请求不像传统聊天接口那么单一。它会读文件、跑命令、等工具、启动子任务,再带着一大段上下文回来继续问模型。
如果网关仍把这一串动作当成一团同质流量,缓存规则、限流和告警就会很粗。粗到什么程度呢,像看见晚高峰堵车,只知道全城车多,却分不清是地铁停了还是一条支路挖路。
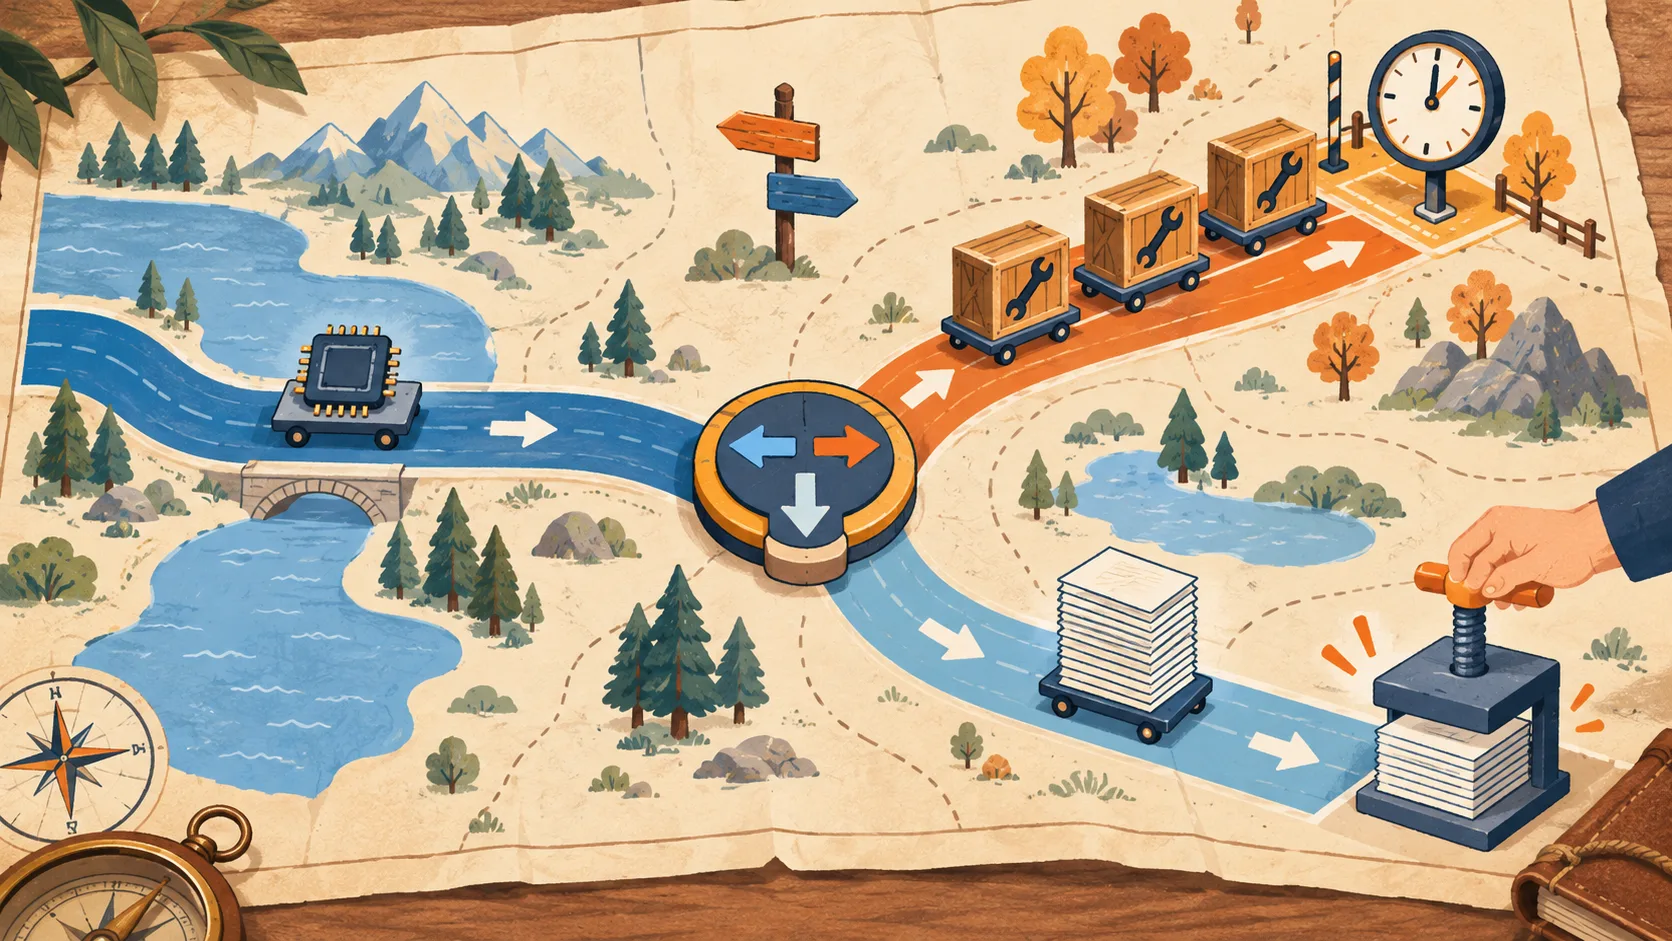
把工具等待和上下文状态带进规则后,网关可以先把异常归到正确的一层,再决定要不要路由或告警。
不过,别把这五个 header 当成打开就灵的魔法开关。它默认关闭很合理。
第一层是兼容性。你的反向代理、API 网关和日志采集器会不会丢弃未知 header,要先确认。第二层是隐私和保留期。Agent 类型与工具耗时虽然不直接等于用户内容,但在小团队里也足够勾勒出谁在做什么任务。第三层才是路由。没有两周左右的基线数据,直接拿这些信号去自动换模型、自动提权或自动限流,很容易把一次短暂波动做成长期规则。
我觉得比较稳的顺序是,先只采集,不改路由。把每一条记录补成下面这种形状,跑一段时间再看分布。
request_id
model
latency_ms
request_class
agent_type
previous_tool_duration_ms
context_compacted
status
这里有个不那么显眼的好处。MCP 服务断开时,v2.1.273 也会在自动重连放弃后通知用户去检查 /mcp。工具层终于开始愿意承认自己掉线了。厉害了,这比让人盯着一个泛泛的 500 错误舒服多了。
等你发现某类请求总是工具慢,再去修那个 MCP 服务或给它单独设超时。等你确认上下文压缩后缓存命中明显下降,再考虑把压缩前后拆成不同的缓存与评测桶。等你确认某个后台 Agent 长时间挤占额度,再为它单独限流。每一步都有证据,才不会把网关做成一个不停猜谜的转发器。
这次更新不负责让 Agent 更会写代码。它做的是更基础、也更容易被忽略的一件事,把一段 Agent 行为从黑盒里拎出几个可观察的角。
做 Agent 系统久了,会发现最可怕的不是一次报错,而是所有报错都长得一样。模型名只是门牌号,真正的堵点往往藏在门后。现在 Claude Code 给网关留了几张便签,至少我们终于知道该往哪扇门敲。
你们团队现在的网关日志,能区分模型慢、工具慢和上下文压缩后的请求吗?