
Claude Code 更新:MCP 任务能后台跑了,权限怎么配
v2.1.319 把任务型 MCP 调用移到后台,也能让权限提示直接拒绝后继续。它解决的不是“更快”,而是让等待与放权终于能分别设计。
让 Agent 去调一次外部工具,最烦的往往不是它慢。
更烦的是:终端卡在那儿,你不知道它是在等一个长任务,还是在等你点权限确认。前者该不该让它继续干别的活,后者该不该直接拒绝,原来常被混成一个问题。
Claude Code 的 v2.1.319 官方发布把这两个开关拆开了:支持任务语义的 MCP 工具调用可以转到后台;而一个原本会停在权限提示上的调用,也可以被设成直接拒绝、让当前回合继续。这个版本不只是又多了几条 release note,它把 Agent 的「等结果」和「要授权」摆到了两条不同的轨道上。
先把 MCP 说成人话。它可以理解为给 Agent 接外部服务的接口层:代码仓库、测试系统、内部知识库,甚至你的部署平台,都可能在另一端。工具一多,等待也会跟着变复杂。
这次的关键变化是:如果 MCP 服务器把一次调用作为任务运行,Claude Code 会立即把它转入后台,等任务完成再把结果交回给 Claude。 注意这个限定——不是所有 MCP 调用都被魔法加速,而是任务型调用的调度方式变了。它让终端不用一直被同一件慢活堵住。
后台化不是「更快」,是把等待放到对的位置
假设你的 Agent 启动了一个需要十几分钟的远端检查。真正要问的不是「能不能后台」,而是:这份结果是不是它下一步动作的前提?
如果后面的工作必须等检查结果才能继续,例如结果会决定该改哪个文件、能不能合并、要不要停止部署,那么留在前台更稳。先拿到答案,再走下一步,虽然慢一点,逻辑不会分叉。
如果这份任务只是收集补充信息,或者 Agent 可以先完成不依赖结果的其他部分,后台化就有意义。它改变的是人和 Agent 的排队关系:不用把整个回合钉死在一个慢工具上,结果回来后再进入下一轮判断。
这里有个容易被忽略的代价:任务在后台跑着,前台的上下文还会继续往前走。等结果回来时,Agent 眼前的代码、计划,甚至用户的新要求都可能已经变了。后台任务不是一张「以后再说」的纸条,它应该带着能对上的身份:这是谁发起的、查的是什么范围、结果最晚何时还有效、回来以后哪些动作仍然需要重新判断。
所以别把「移到后台」理解成把责任也移走。真正适合后台的,是结果晚一点出现也不会让当前决策失真的工作。只要结果会推翻下一步,就该明确停下来等,或者让 Agent 在结果回来后重新确认计划,而不是顺着旧上下文一路冲。
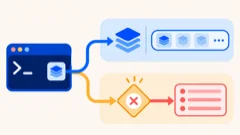
图:本篇的编辑示意图。后台化解决的是调度;直接拒绝解决的是无人值守时怎样结束权限等待。两者不能互相替代。
官方同时给了一个反向开关:CLAUDE_CODE_DISABLE_MCP_TASK_BACKGROUND。需要让任务留在原工具调用里、由 Claude 一直等到完成时,可以用它关闭这项后台化行为。还有 CLAUDE_CODE_DISABLE_MCP_TASKS=1,用于完全关闭任务型 MCP。
这两个名字看起来很像,作用却差一层。前者是「别转后台,我仍要等」;后者是「这种任务能力先不要」。别为了排查一个流程就顺手把两条都塞进环境变量,最后只会把真正的问题藏起来。
权限提示也不该被当成后台任务
另一项新增设置叫 permissions.denyInsteadOfPrompting。它处理的不是耗时,而是一个更尴尬的场景:调用本来要停下来问你「要不要允许」,但你此刻根本不在终端前。
开启后,这类调用会被直接拒绝,当前回合继续走。对无人值守任务来说,这比在一个永远等不到回答的提示框前挂住要诚实得多。失败至少是可观察的;假装还在跑,才会让排查变成考古。
但这也不等于把权限问题「解决」了。若一个外部写入、发布、删除或跨系统调用是任务成功的必要步骤,直接拒绝只会让它在关键处失败。你得先把这类动作拆出来:哪些应该在有人值守时明确确认,哪些能通过更窄的规则预先允许,哪些失败后可以安全地留待下一轮。
所以,后台化和直接拒绝是一组很适合放在一起看的能力,却不该绑在一起开。一个解决「结果什么时候回来」,另一个解决「没人确认时怎么收场」。
给接 MCP 的团队一份三问检查
每次准备把一个工具调用放进自动化链路前,我建议先问三句。它们不依赖某个版本,换任何 Agent 都能用。
第一,结果是不是下一步的输入? 是,就先别急着后台。把结果、超时和失败路径写清楚,前台等待可能反而更省时间。
第二,这个调用会不会跨过权限边界? 会,就不要把「无人值守」理解成「默认放行」。直接拒绝可以避免死等,但应该配合清晰的失败报告,让人知道哪个动作被挡住了。
第三,结果晚到或失败时,谁来收尾? 如果没有一条可见的状态、日志或后续通知,后台任务只是把卡住从终端搬到了更难找的地方。
这三句听起来没什么神秘的,可它们正好把很多 Agent 流程里最容易糊掉的边界拉开:调度、授权、可观测性,各管各的。
真要把它接进团队的日常流程,也不用一上来就在最重要的自动化上赌。先挑一个低风险、结果可复核的任务做小范围验收:让 MCP 服务返回一个故意延迟的结果,确认任务进入后台后终端还能继续做不依赖它的事;再让一个本该询问权限的调用走一次直接拒绝,确认日志和最终答复都能把「被拒绝」说出来;最后模拟一次中断与恢复,确认结果不会悄悄丢在半路。
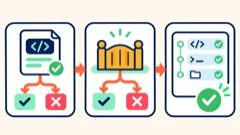
图:本篇的编辑示意图。先看结果是否是下一步输入,再看权限是否跨边界,最后确认失败或恢复后有可见状态。
这不是为了做一张漂亮的验收表,而是为了给失败留出口。后台任务最怕的不是失败本身,而是它失败后没有状态、没有归属、没有人知道该从哪里接起。官方这次正好修了 --resume 后长 MCP 调用偶尔不回报结果的问题,也让这条检查更值得做:恢复流程不是边角料,它就是长任务的一部分。
v2.1.319 还修了两类跟这件事很贴近的问题:旧握手方式的 MCP 服务可能连不上或返回空结果;在 --resume 之后,长时间运行的 MCP 调用有时不会回报结果。它们都提醒了一件很朴素的事:当 Agent 真开始调用外部世界,最难的往往不是「会不会调用」,而是失败、恢复和等待能不能说清楚。
如果你已经在用 Claude Code 接 MCP,这次更新值得先看自己的长任务:哪些是等待结果,哪些是在等待授权。把这两类等待分开,才知道该让谁去后台,也才知道什么地方必须留给人。
你现在的 Agent 工具调用里,最常见的「卡住」到底是慢,还是等人点确认?
— 小岛AI
记录一线实战、踩坑与成长