
Claude Code 跑子代理,10 万 token 是条成本分界线
Haiku 5.5 的低价只在单次提示不超过 10 万 token 时成立。把这条线写进子代理路由,才不会把便宜模型用成昂贵长会话。
如果你在 Claude Code 里把一个大任务拆成检索、归纳、跑测试、回填代码几步,最近这条更新值得停两分钟。
Anthropic 在 10 月 7 日发布 Claude Haiku 5.5。看数字很容易只记住一件事,输入每百万 token 最低 0.10 美元,输出 0.50 美元,比 Haiku 4.5 低很多。
可真正会影响你配置的,不是最低价,而是价格表里那句小字。
单次提示不超过 10 万 token,输入、输出和缓存读取都按低档计价。超过以后,三项单价一起变成五倍。输入从 0.10 到 0.50,输出从 0.50 到 2.50,缓存读取从 0.01 到 0.05,单位都是每百万 token。
这篇不把官方演示当独立实测。要讲的只是一条很朴素的工程判断,Haiku 5.5 很适合被安排进一条任务边界清楚、上下文受控的流水线。它不适合被当成便宜的长会话大模型,然后让它背着整个仓库和半截历史一路往前跑。
100 万上下文很大,10 万计费线更近
Haiku 5.5 支持 100 万 token 上下文,最长输出 128K,还第一次给 Haiku 档加了可调 effort。只看这几项,很容易得出一个顺手的结论,窗口这么大,那就把更多资料塞进去。
先缓一下。
上下文窗口说的是模型最多能看多少,价格分档说的是你每次把多少内容送进去会走哪张价目表。这是两件事。一个容量很大的行李箱,和你能否一路免费托运,不是同一道题。
Anthropic 的官方表格写得很直。单次提示在 100K 以内时,Haiku 5.5 的输入、输出与缓存读价相对 Haiku 4.5 大约低九成。跨过 100K 后,仍比上一代便宜,但折扣收窄到大约五成。官方也说,过去 Haiku 的请求约九成在低档里。
所以它不是一台全天候低价发动机,更像一块很适合跑短航程的轻快马达。
对很多 Agent 流程,这反而是个好消息。摘要一份文档、从日志里抽字段、把上一轮工具输出压成状态、给主代理找一组文件、跑一个边界明确的检查,这些工作没必要带着整段聊天记录和所有工具回放。把输入整理到 100K 以内,价格和延迟才会真的落到它擅长的区间。
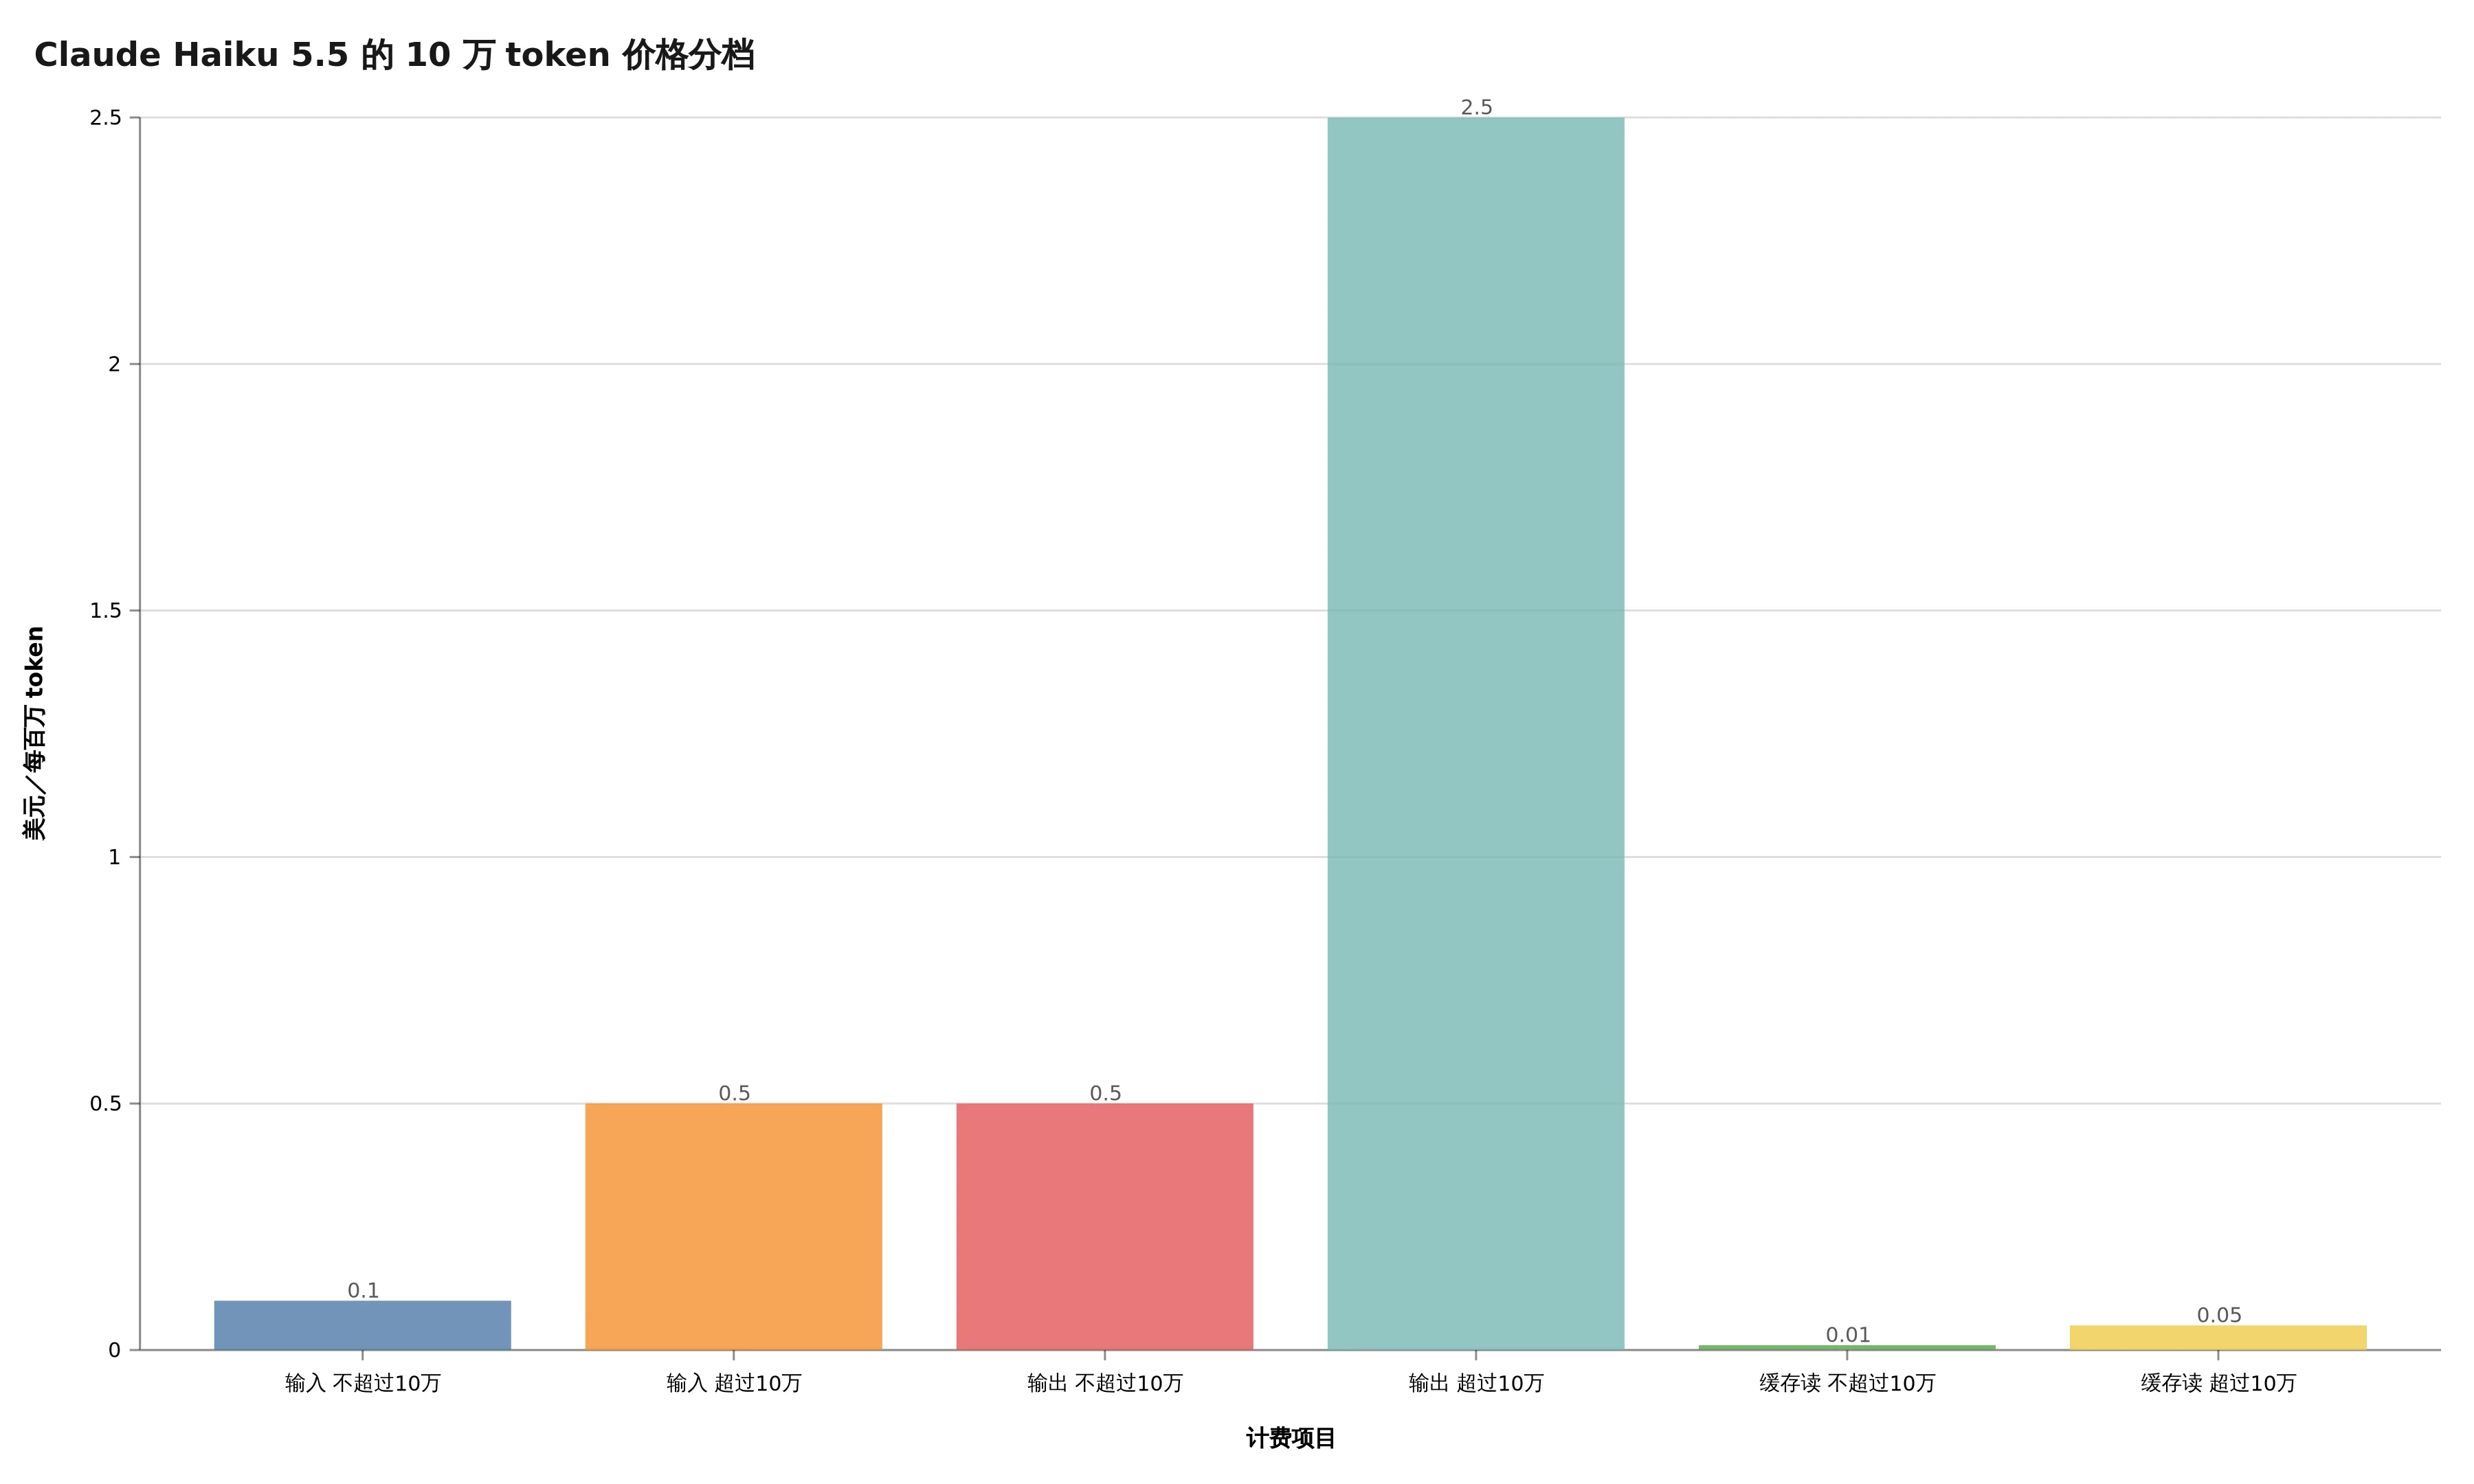
单次提示越过 100K 后,Haiku 5.5 的输入、输出与缓存读取单价都会升为五倍。数据来自 Anthropic 官方定价表。
子代理该怎么分活
我更愿意把这次发布翻成一个分工规则。
| 任务特征 | 更合适的选择 | 为什么 |
|---|---|---|
| 分类、抽取、摘要、压缩、固定格式检查 | Haiku 5.5 | 任务边界清楚,输入能提前裁好,低档价格能兑现 |
| 小范围检索、单文件改动、测试结果归纳 | Haiku 5.5 | 可以把检索结果和要求打包,交付物容易验收 |
| 跨目录重构、含糊需求、需要来回判断 | Sonnet 5.5 或 Opus 5.5 | 需要更强的规划、工具选择和失败恢复 |
| 长历史会话、资料包不断膨胀 | 先压缩再路由 | 先处理上下文,不要让低价档无意间跨过 100K |
这里最容易犯的错,是按模型名字分活。看到 Haiku 就把所有小任务扔过去,看到 Opus 就把所有难任务扔过去。实际应该按任务包分活。
一个能交给 Haiku 的任务包,至少要有三个东西。输入材料已经收拢,输出格式可以验收,失败时知道交回给谁。比如让它从一百条测试失败里归纳三类根因,这个包很好。让它「看看仓库哪里有问题,顺便改好」就不好,范围、上下文和回合数都会往外长。
给子代理留一份小而完整的任务说明,往往比给它更长的聊天记录有用。可以直接拿下面这段当检查表,放进路由器或派工提示里。
这件事是否有明确输入
输出是否能用格式或测试验收
完成时是否不用保留全部历史对话
失败后是否能把结论交回主代理
任一项为否,就不要默认送去低价子代理
它不是万能配置。它只是逼着派工的人先把任务切干净。很多账单失控,根本不是模型贵,而是一个本来该拆开的工作被塞进了同一轮对话里。
别把小模型放到它不该承担的位置
Haiku 5.5 这次的能力提升不小。Anthropic 在官方图表里给出,Terminal-Bench 4.0 上它在 Max effort 时达到 39.2%,上一代 Haiku 4.5 为 0.0%。但同一张图里,Sonnet 5.5 的 Max effort 为 70.6%。
官方自己的解释很克制,复杂、多步骤的 Agent 编码仍更适合 Sonnet 5.5 或 Opus 5.5。Haiku 的好位置,是压缩、摘要和范围较窄的子任务。
这话看着保守,其实很实用。
主代理负责看全局、决定下一步、处理模糊和失败。Haiku 负责把一堆重复但可验收的活快速清掉。两边不是谁替代谁,而是把昂贵的思考留给真正需要思考的地方。
如果你只换模型名,不改上下文策略,大概率会得到一条奇怪的流水线。前面因为便宜而加了更多并行,后面又因为每个子代理带着过长输入跨过了价格线,再用更强的模型返工。看上去省了单价,账单和调试时间却一起涨。
这次更新还有一张小牌
Anthropic 同时把 Sonnet 5.5 的缓存读取从每百万 0.20 美元降到 0.10 美元,官方估算多数 Agent 工作成本会下降约两成。它还宣布给 Max 和 Team 用户增加按月发放的 Claude Platform API 额度,分别是 100 美元、200 美元和团队最高 500 美元,具体按计划分批开放。
这两件事放在一起看,路由策略比以前更值得写明白。不是所有子任务都要压到 Haiku,也不是只有高价模型才配用缓存。长期会话里,先让 Sonnet 的缓存读价发挥作用,再把界限清楚的工作拆给 Haiku,可能比粗暴地把整条链路降档更稳。
本文的路由示意只表达任务边界与上下文预算,不是官方架构图,也不是独立性能实测。
把文章收成一句话。
Haiku 5.5 的价值不只是低价,而是给 Agent 工程多了一条更清楚的分工线。你能控制输入、能验收输出、能在 100K 前收住上下文,它就很有吸引力。你准备让它带着漫长历史去做开放式排障,先别被 0.10 美元迷住。
你现在的 Agent 流程里,哪一步最适合被裁成 100K 以内、可验收的小任务?