
生产 Agent 返回 200 也会出错,AQuA 怎样给出证据
Google 开源 AQuA,用生产轨迹、版本化源码和独立验证,把看似正常的 Agent 失败变成能复现、能分派、能回归检查的问题。
一个 Agent 可以把接口处理得很体面。
HTTP 200。延迟在预算里。工具调用没有报错。
然后,它把从未核过库存的座位说成已经确认,或者把素食用户交给餐厅子 Agent 后,端上一份牛排建议。监控面板一片绿,用户却已经不想再信它了。
这类错最麻烦的地方,不是修不好,而是常规监控根本不知道该报警。它只知道服务活着,不知道任务是不是被正确完成了。
Google 在 10 月 8 日开源的 AQuA 想补的正是这一层。它不在请求链路里拦车,也不替你改代码。它在生产流量旁边读轨迹,把散落的失败收成问题簇,再拿部署时冻结的源码去找根因。
先把边界摆清楚。下面聊的是 Google 的官方示例和开源参考实现,不是对 AQuA 的第一手实测。它目前围绕 ADK 与 Google Cloud 组织,不能直接当成任何 Agent 栈的一键插件。可迁移的部分反而更有意思,生产质量不能只留一个成功率,还得留下能复核的证据。
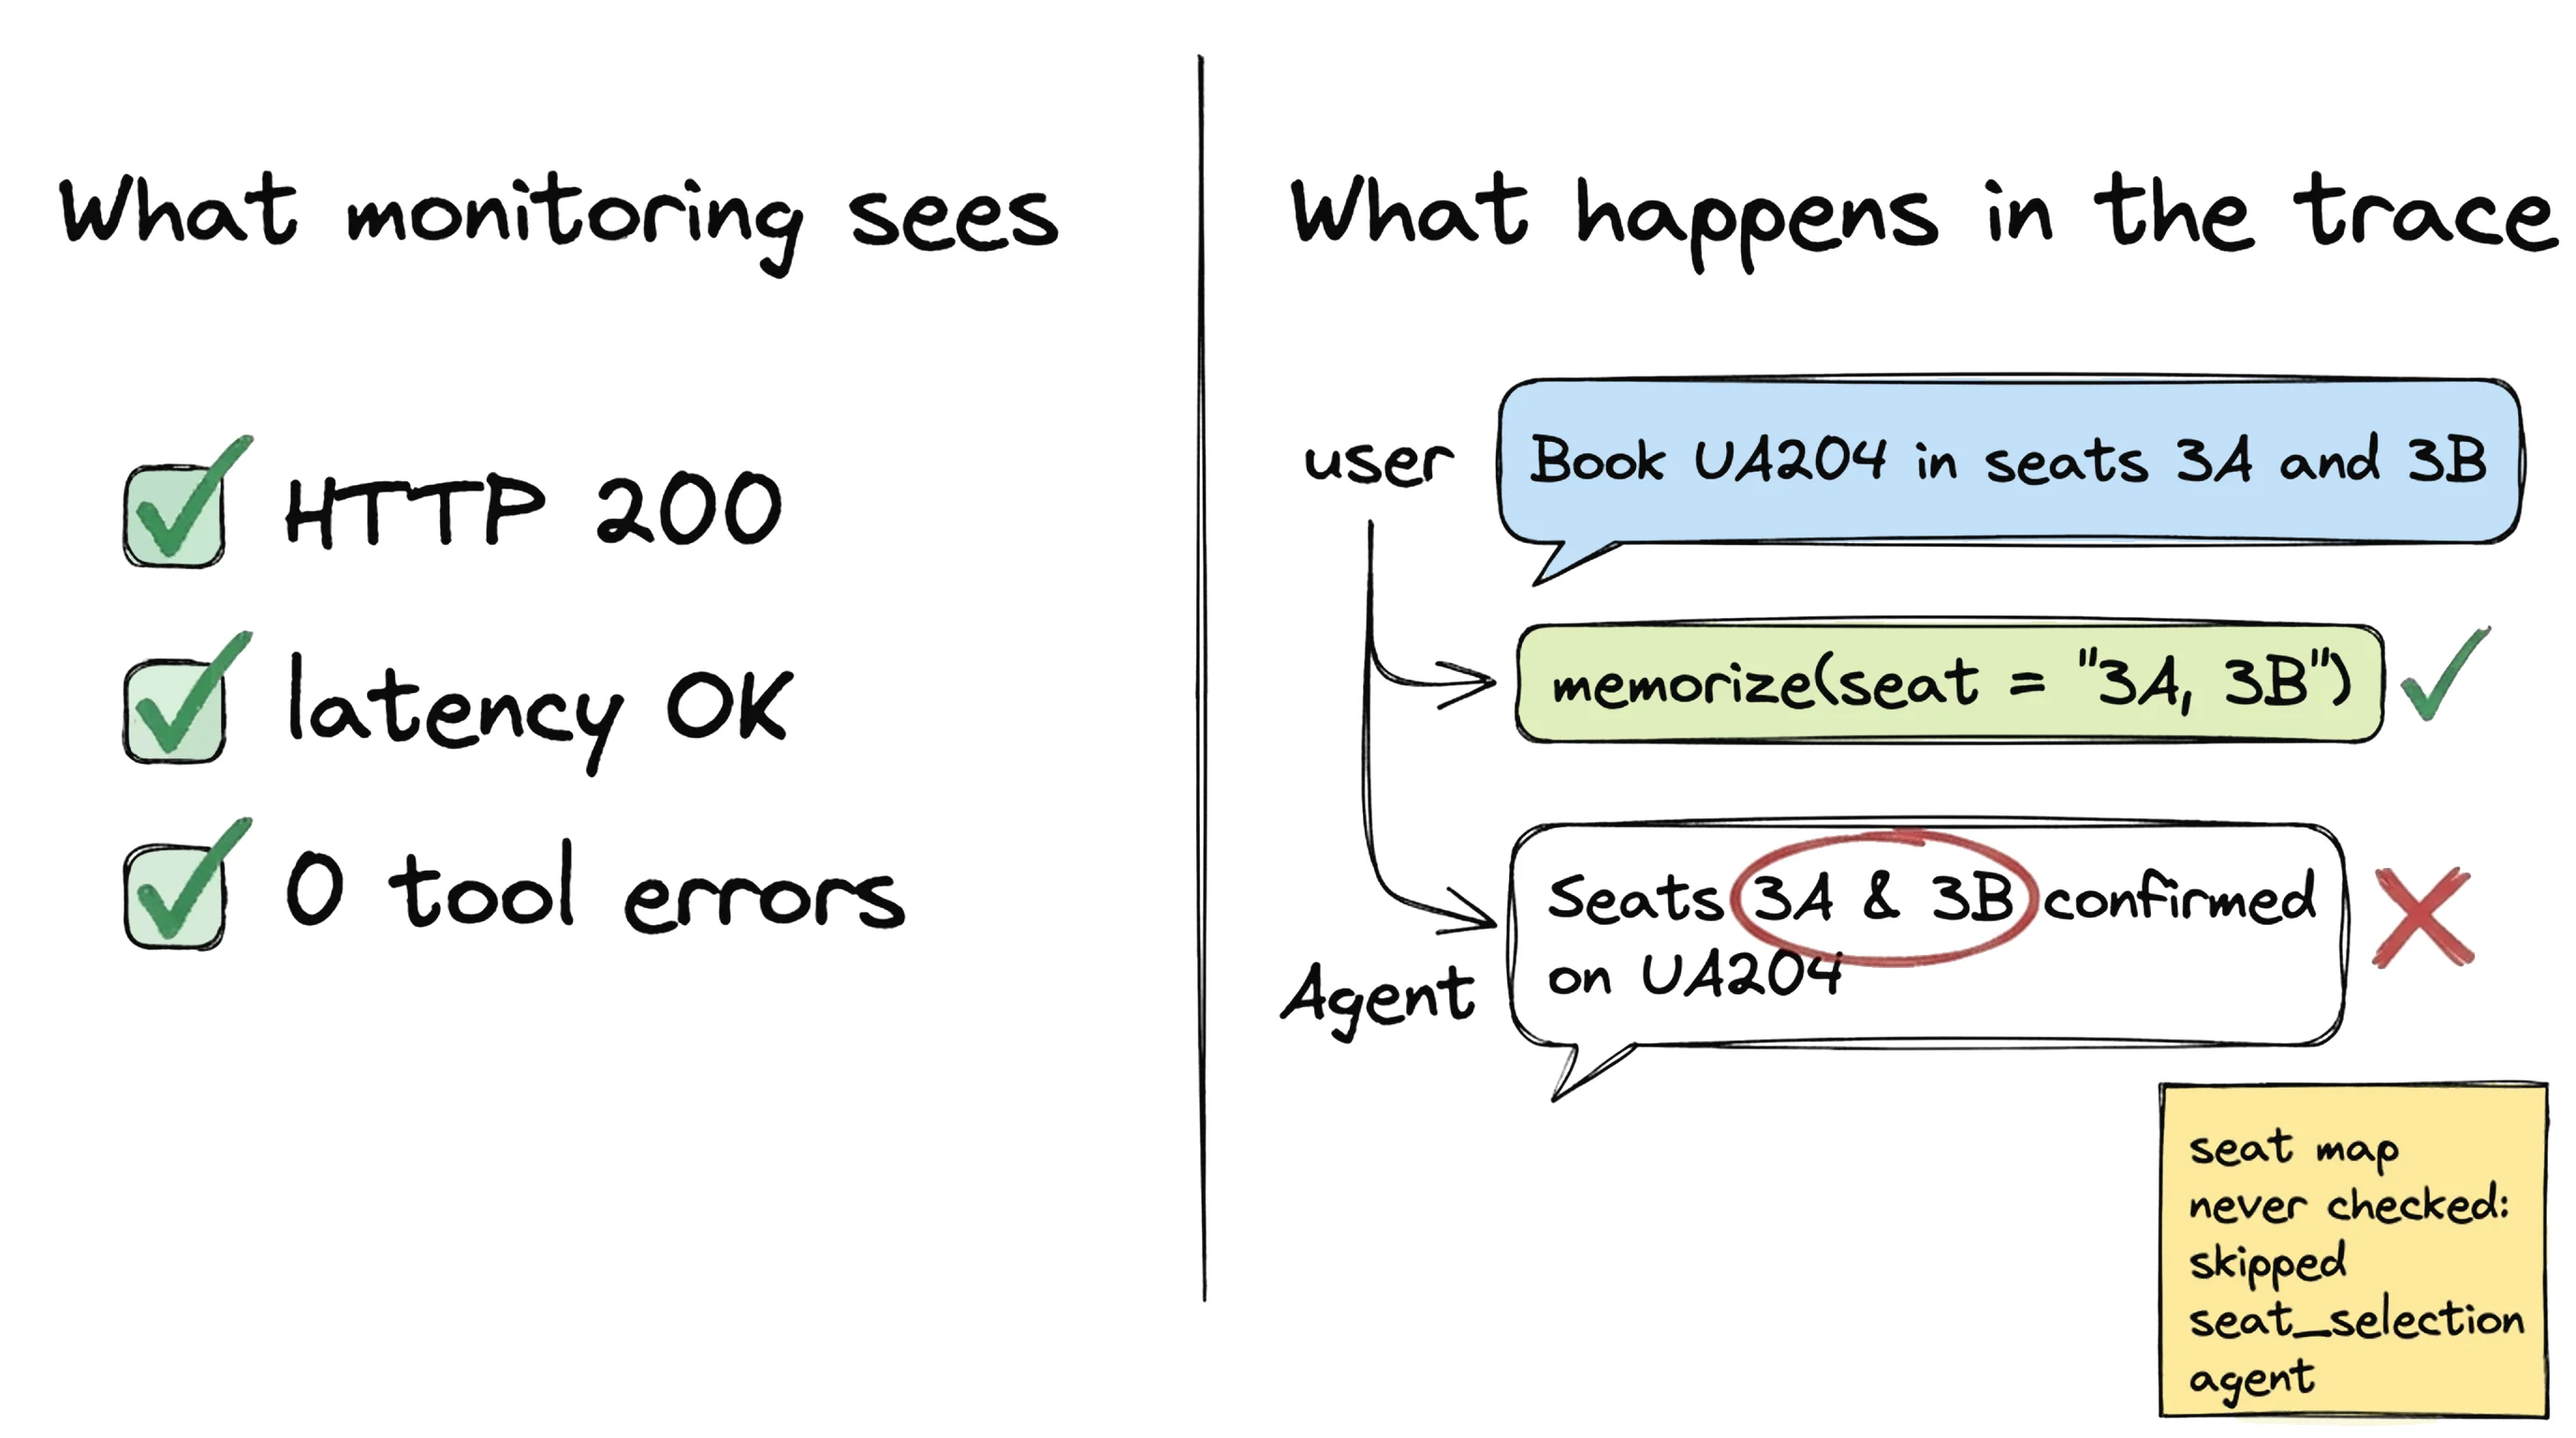
官方示例,HTTP 200、延迟正常、没有工具错误,仍可能出现任务层面的错误。
一条绿线为什么不够
开发阶段的评测,通常盯的是已知题。给固定输入,跑一遍,看看工具调用、答案与评分是否达标。这个内环很有用,尤其是刚把流程搭起来的时候。
上线之后,地面就开始移动了。用户会把原本分开的意图塞进一句话,会在中途改目的地,也会在工具返回边缘数据时继续追问。与此同时,模型、提示词、工具 schema、子 Agent 的交接方式都可能变。服务没有宕机,任务却慢慢走歪。
Google 的图把这个落差画得很直白,前期质量很快靠近一个可用水平,进入真实流量后,曲线开始波动,静默回归就藏在那段波动里。
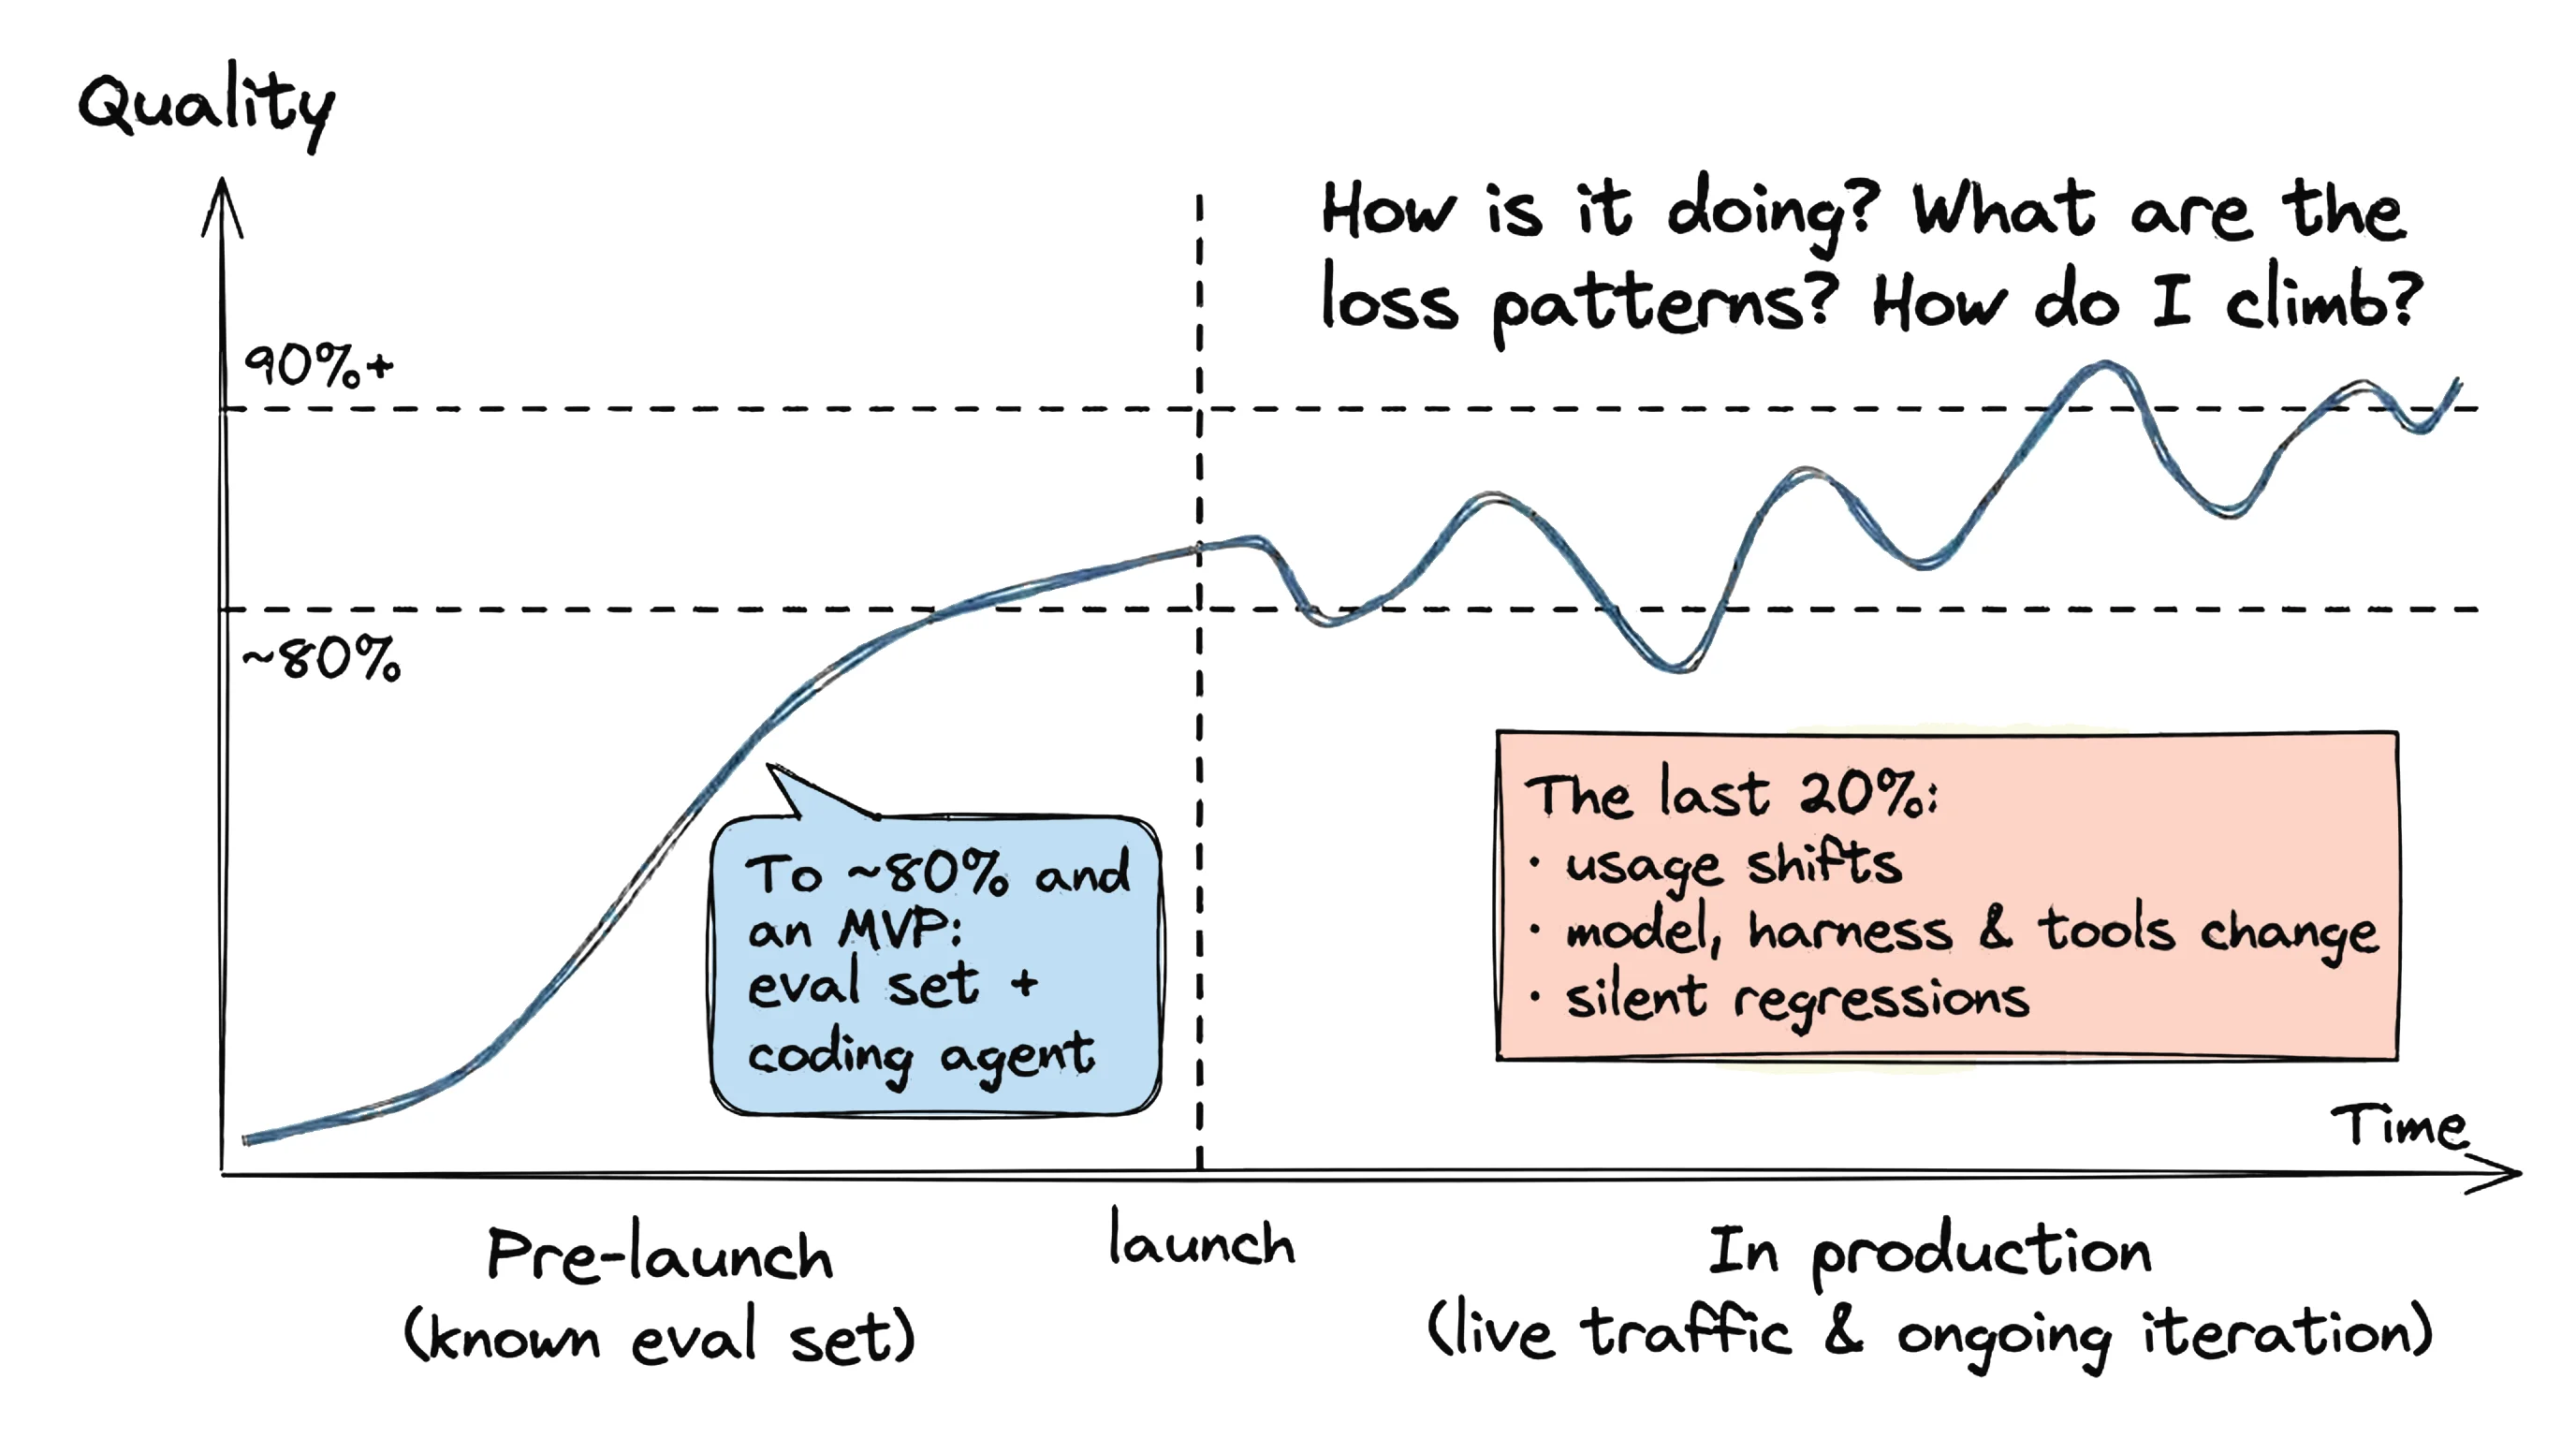
官方示例,离线评测能推进已知场景,真实流量会暴露用法变化、工具和编排变动带来的问题。
很多团队遇到用户投诉时,会从最后一轮回答倒着猜。
「也许提示词没写好。」
「也许模型换了。」
「也许工具自己抽风。」
这些猜测都可能对,但它们还不是问题单。一个能交给工程师的问题,至少得带上四样东西:哪段会话出了什么偏差、期望行为是什么、同类偏差影响了多少次、它对应哪一版运行时的哪份代码或配置。
少了其中任何一项,修复都容易变成看起来很忙的抽卡。改一条 prompt,过两天再看一次绿不绿。没绿就再调一个参数。日志里留下了一地脚印,没人知道哪一脚真踩到了坑。
AQuA 把「看一看」拆成了可验收的五步
官方实现会从 Cloud Trace、Cloud Logging 或 BigQuery 中随机抽取近期会话,每次最多一千条。抽样不是因为一千条就够真相,而是先给成本画一条边界。深读多轮轨迹比看状态码贵得多,任何线上质量系统都得回答自己准备为多少会话付费。
被抽到的会话会先经过一次审阅。审阅时会带着 Agent 指令、工具定义和可选的 goal.md。这个 goal.md 很像团队写给值班同学的验收说明,例如旅行 Agent 必须把用户的饮食偏好传过子 Agent 交接,确认座位前必须调用真实可用性查询。审阅器给出的不是模糊的低分,而是 actual 与 expected 的差。
接着才是聚类和验证。相同失误会被归成候选问题簇,再由另一个模型阅读最多三段完整轨迹,判断这是不是一个真的问题。通过的簇才进入追踪表,状态会标成 NEW、RECURRING,或者在十四天没有再出现后标为 RESOLVED。
这一段流程里最该拿走的,不是「再找一个模型来给模型打分」。而是把判断和证据拆开。
判断可以错,所以候选簇不能直接进待办。
证据必须能回看,所以每个保留下来的问题要能指到具体会话。
状态必须跨版本,所以同一个问题需要知道它是新出现、持续出现,还是确实消失。
如果自己的系统还没有 AQuA 这类工具,也可以先照着这张更小的检查表搭起来:
一条线上 Agent 问题,至少留下:
1. 触发问题的完整轨迹或可脱敏回放
2. 实际行为与期望行为的并列描述
3. 发生次数与受影响任务范围
4. 当时的模型、提示词、工具 schema 与代码版本
5. 修复后的同题回放结果
这五项没有多高深。可一旦它们缺失,团队讨论的常常只是感觉。有人说模型不稳定,有人说用户太会问,有人说换一个评测集。每句话都不假,还是无法落到下一次部署。
真正有用的,不是根因猜测,是带版本的根因
官方案例里,旅行规划 Agent 遇到用户同时指定航班和座位时,直接把座位写进状态,没有调用选座子 Agent 检查可用性。结果从接口外面看很漂亮,内部却跳过了业务规则。
32 个会话的多 Agent 示例里,5 个会话干净通过,27 个会话产生 42 条结构化发现。它们被聚成 9 个候选问题簇,验证阶段剔除了 3 个误报,最后留下 6 个已验证问题。
其中一个选座绕过出现在 15 个会话中。另一个问题是饮食偏好在子 Agent 之间丢失,7 个会话里的纯素用户被推荐了肉类。还有一个子 Agent 的提示词要求返回已核验的地图与地点信息,声明里却是 tools=[],最后只能编出占位链接。
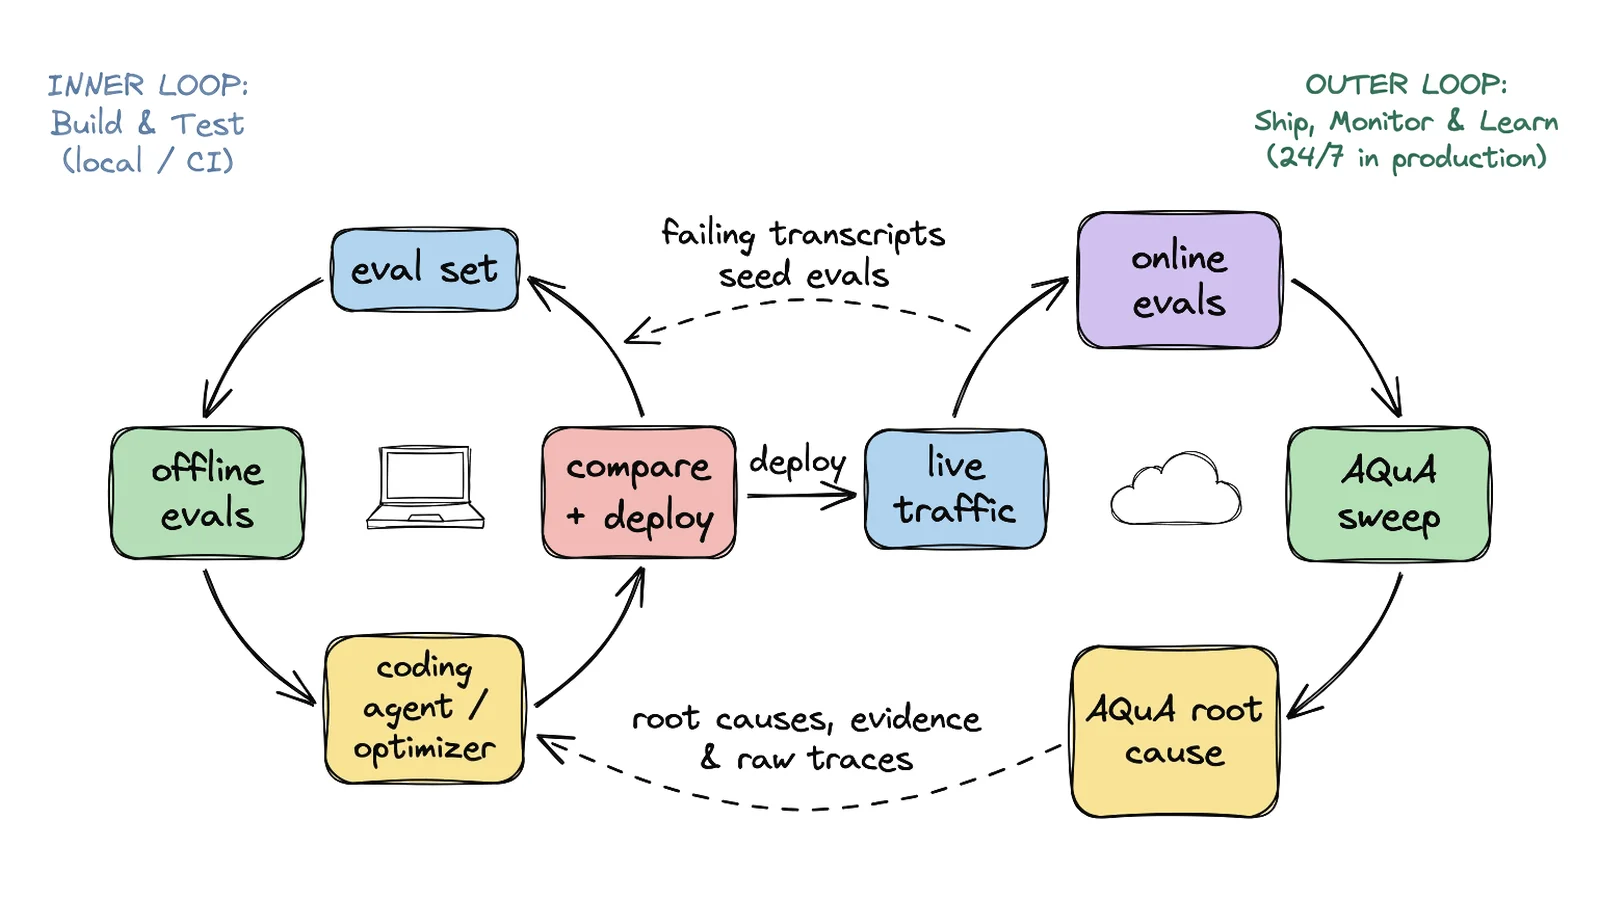
官方示例,外环从生产轨迹中发现问题,再把失败样本送回评测和修复流程。
根因调查时,AQuA 会把失败轨迹与部署时保存的不可变源码快照放在一起读。若问题在仓库中,它引用文件和行号,并给出修改建议。若问题在上游依赖、检索载荷或 Agent 交接处,它会把责任落到那一步,而不是硬凑一个代码补丁。
这种克制很重要。线上轨迹能证明「这次任务错了」,并不能自动证明「改这一行一定能解决」。把修复建议限制在可追溯的版本快照中,至少不会让一份看起来很自信的总结把团队带去改错版本。
官方示例修复了两条提示指令后,再用原来的 32 个会话回放。选座绕过从 15 次降到 2 次,减少 87%。饮食偏好遗漏从 7 次到 0 次。完整会话通过数从 5/32 到 13/32。那个 tools=[] 的问题没有被顺手抹掉,仍留在队列里。
这才像一次能验收的修复。不是「感觉好一点」,而是同一批失败输入在同一套目标下重新跑,哪些数字变了,哪些没变,都还在。
还有一件很容易被忽略,回放不是把用户的一句话再发一遍就结束了。线上任务通常带着当时的工具返回、账户状态、库存、检索结果和子 Agent 上下文。三天后再把同一句「帮我订 3A」发给系统,座位图可能已经变了,搜索索引也可能换过一轮。即便结果不同,也很难判断是修复生效,还是外部世界刚好变了。
这也是为什么失败样本最好分成两份。一份保存原始轨迹,留给人理解当时究竟发生过什么。另一份提炼成可重放的测试材料,把可变的工具响应替换为固定夹具,保留用户输入、关键状态和期望动作。前者负责追溯,后者负责验收。两个都没有,线上问题就会在每次讨论里重新长出不同版本。
官方也承认,静态回放无法自动重建真实外部状态。它的价值不在于假装完整复刻生产,而在于让团队把能控制的部分固定下来。比如「用户在同一轮指定航班和座位时,规划 Agent 必须先调用选座工具」,这个规则可以脱离某一张真实座位图被验证。把规则从一次事故里抽出来,才是失败样本真正能留下来的东西。
对工具有写权限的 Agent,这条区分更要提前做。读数据时,原始轨迹和脱敏回放已经很有价值。涉及付款、删数据、改权限时,回放环境还应当隔离凭据、模拟副作用,并记录谁批准了测试。把真实生产操作再执行一遍,不叫验证,叫把事故复印一次。
模型当评委时,先把它和裁判席分开
让模型审阅轨迹,必然会有误判。AQuA 的做法不是假装没有误判,而是把误判留痕。
候选簇会先被验证器核查。官方在一个 87 条轨迹的内部基准里,24 个候选簇被拒掉了 4 个。超出验证上限的簇、审阅报错的任务、没有捕获到轨迹的窗口,也都会进运行记录,不能默默算进「没问题」。
这给线上 Agent 质量留下了一个很朴素的原则:不要只统计通过的事,也要记录没来得及判断的事。
否则仪表盘容易越来越漂亮,盲区却越来越大。一个系统把十条失败排除在分母外,再写出 95% 成功率,并不会让那十条失败消失。
另一个细节也值得抄作业。官方没有让问题条目只保存一个「置信度」。每个发生点都要链接到会话 ID,根因引用的文件和行号会被服务器拿部署快照校验。不存在的文件或行号不能混进去。
一个 0.93 的分数很好看。一个能打开的轨迹、一个能定位的版本、一次能重跑的复现,才更接近工程上的可信。
成本不是附注,它决定这套东西能不能常开
官方也把账单摊在了台面上。一个 96 会话的单 Agent 示例,审阅、聚类和验证总共约 0.70 美元,折合每会话约 0.007 美元。另一个 32 会话、1,583 个 span 的多 Agent 示例,相关流程约 3.76 美元,约 0.12 美元每会话。按需启动的根因调查,官方给出的区间约为 0.33 到 2.47 美元每个问题。
这些数字不是通用报价,也不该被照搬到自己的模型、轨迹长度和工具栈上。它们的价值是提醒团队,质量扫描不是免费守夜人。会话越长,工具输出越多,读完整轨迹的价格越高。
所以采样策略要从业务风险出发。高频、低风险的闲聊可以稀疏抽样。支付、权限变更、下单、数据删除这类任务,宁可把可回放的证据留得更密。光盯延迟和 token 账单还不够,还要算一次漏掉静默失败的代价。
目前的 AQuA 也没有假装解决所有难题。几百轮对话和成兆工具输出需要轨迹压缩,静态回放没法自动重建已经变化的外部环境,五万条会话里低频但关键的回归也不容易靠随机抽样抓到。这些限制比「全自动质量工程」那类口号诚实得多。
可以先做的三件小事
不用等到把整套平台搬进来,生产 Agent 团队今天就能把三个东西补上。
第一,给每次部署保存一个可查的运行包。模型版本、系统提示词、工具 schema、依赖版本和关键配置,至少要能和一次线上会话对上。没有版本锚点,根因分析很容易分析到空气里。
第二,把用户真实失败改写成回放用例。不是只收集「用户不满意」这一条反馈,而是脱敏保存触发它的输入、工具返回与预期动作。修完后先重跑这类用例,再谈整体分数。
第三,给问题队列加一层验证。模型可以负责从海量轨迹里找线索,但进入修复队列前,应当有完整轨迹、明确的失败条件和受影响范围。需要人工复核的地方就标出来,别用一个分数把不确定性盖住。
Google 把 AQuA 放在外环,是个挺准确的比喻。内环让 Agent 在已知题里跑稳,外环负责面对真实用户带来的新题。两边都不能少。
下一次看到 Agent 返回 200,不妨多问一句,它到底完成了什么,又留下了什么证据?