
实测 DeepSeek 全家桶 API:界面只搜了 1 次,账单记了 4 次
按接进产品的方式把 DeepSeek 刚开放的全家桶 API 测了一遍:默认开深度思考、max_tokens 设小了只剩空回答、多轮丢一个字段网页就没了、流式语音要等收尾才出声。附实测数据和避坑写法。
DeepSeek 11 月 13 日开放了全家桶应用 API:App 里的联网搜索、阅读链接、文件输入、语音和安全审核,开个参数就能接进自己的应用,官方还开源了一个能「1:1 复刻 DeepSeek App」的前端 Demo。
功能演示网上已经很多了。我更关心另一件事:要是真把它接进自己的产品,哪些地方会和预期不一样?
于是周六凌晨,我用自己的 Key 按接产品的方式写了一组测试脚本,前后跑了六十多个请求,测试前后账户余额差了 0.47 元。下文的数字都来自这些请求的原始响应,只测了 deepseek-flash 这一个模型,时间是周末的空闲计价时段。
先说结论,有 6 件事和我预想的不一样:
- 不传
thinking就默认开思考,带上联网工具就是「深度思考搜索」,耗时和搜索次数抖得厉害。 - 界面上显示搜了 1 次,账单按查询词算,一次能记 4 次。
max_tokens设小了,可能钱花了、搜索也做了,回答却是空的。- 多轮对话里,你的代码只要丢了一个字段,上一轮读过的网页就从上下文里消失了。
- 模型不知道今天几号,开了联网也一样,还会为猜日期多花一次搜索钱。
- WebSocket 流式语音合成,在我的测试里要等你说「文字发完了」才开始出声。
一条条说。
默认就是深度思考,搜几次你说了不算
第一个请求我没传 thinking,只声明了 deepseek_web_search,问「DeepSeek 最近一次 API 更新发布了什么」。返回的工具块里 kind 是 deep_search,还带了 209 个思考 Token。
也就是说,在 Messages 和 Chat Completions 里,不写 thinking 就等于开着。我又用「1+1=?」验证了一遍,两种协议都返回了思考内容。
这直接影响成本和延迟。同一个问题「Claude Code 和 Codex CLI 最近一周各自有什么更新」,显式关闭思考跑两次,默认设置跑两次:
| 设置 | 总耗时 | 首字时间 | 计费搜索 | 打开网页 | 输出 Token |
|---|---|---|---|---|---|
| 关闭思考 #1 | 3.9 秒 | 1.8 秒 | 4 次 | 0 | 410 |
| 关闭思考 #2 | 4.1 秒 | 1.8 秒 | 4 次 | 0 | 404 |
| 默认(思考)#1 | 7.5 秒 | 5.7 秒 | 4 次 | 2 | 1054 |
| 默认(思考)#2 | 22.6 秒 | 19.6 秒 | 7 次 | 4 | 2034 |
关闭思考时,两次几乎一模一样。开着思考,同一个问题一次 7.5 秒,一次 22.6 秒,用户要对着空白屏幕等将近 20 秒才看到第一个字。文档写着深度思考搜索最多调用约 20 次工具,搜几轮由模型决定,请求里控制不了。
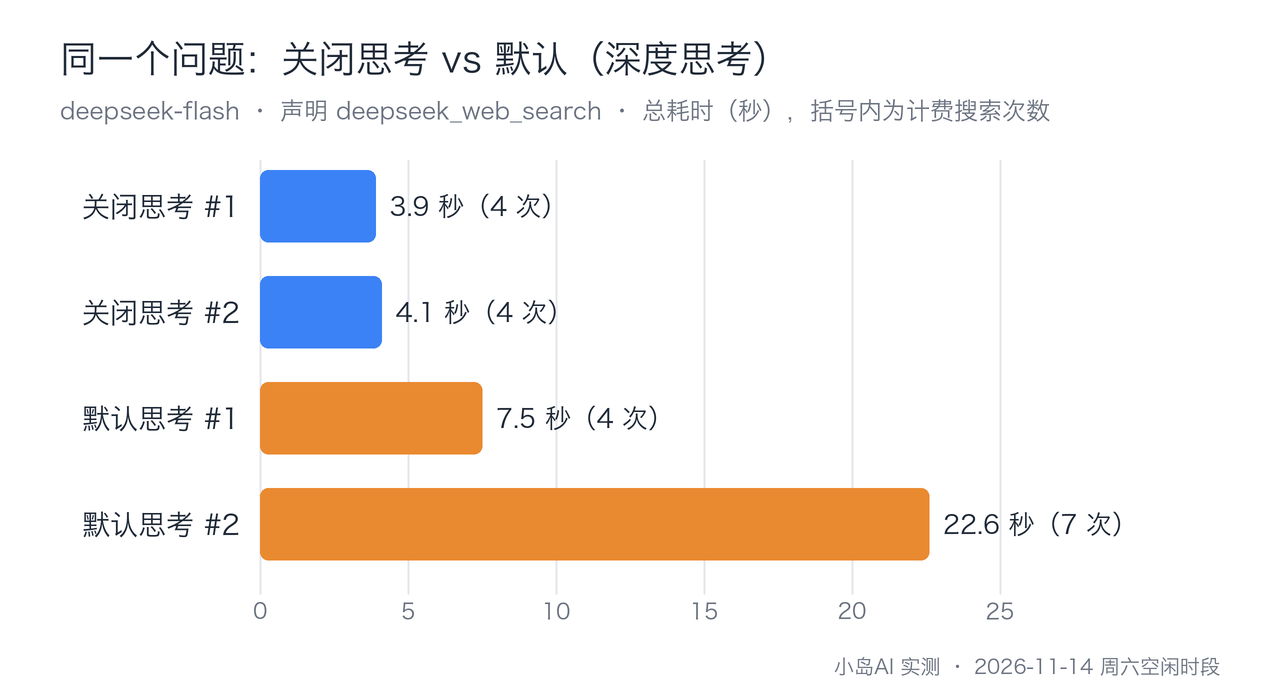
图:四次同题实测的总耗时(秒);数据来自本文 evidence/runs/cost_summary.json。
所以产品里最好把 thinking 写死,别依赖默认值。普通问答关掉,用户主动点了「深度思考」再开,跟 App 的交互保持一致。
界面显示 1 次,账单记 4 次
上表里关闭思考的两次,界面上都只有一张搜索卡片,usage 里的计费次数却是 4。
联网工具文档的计费一节写了原因:一次搜索调用里有几个查询词,就按几次收费。那两次请求,模型都在一个调用里塞了 4 个查询词。
usage.server_tool_use 里有两组长得很像的字段,接计费时千万别取错。下面是我第一个请求的原样数据,注释是我加的:
"server_tool_use": {
  "web_search_requests": 1,   // 结果块数量,仅供展示
  "web_fetch_requests": 4,
  "tool_search": 3,           // 这个才是计费次数
  "tool_fetch": 0,
  "tool_image_search": 0
}
web_fetch_requests 是 4,tool_fetch 却是 0:深度思考里打开的网页,如果内容已经随搜索结果返回,就不再收抓取费。照着展示字段给用户扣额度,搜索会少算,抓取会多算。
再算钱。按周末空闲价,关闭思考那次 Token 约 1.6 分,4 次搜索 2 分;默认思考的 22.6 秒那次,Token 约 2.3 分,7 次搜索 3.5 分。工作日高峰时段 Token 价格翻倍,工具费不变。
联网问答里,工具费已经和 Token 费差不多,有时还更高。做免费额度或者按次收费的产品,这一项要单独记账。
max_tokens 设成 300,换来一个空回答
构建 Chatbot 指南里有一句容易略过:开了这些工具后,max_tokens 限制的是「每一步推理」的输出,不是整轮。
我故意设了 max_tokens: 300,问「对比一下 DeepSeek、Kimi、通义千问三家 API 的联网搜索怎么收费」。结果:
stop_reason是max_tokens- 整轮输出 484 个 Token,超过了设定的 300
- 计费搜索 6 次,打开网页 4 个
- 回答正文:0 个字
搜索钱和 Token 钱都花了,用户看到的是一片空白。很多项目习惯拿 max_tokens 当成本上限,在这里两头落空:既兜不住总花费,设小了还会把回答截没。
更稳的做法是 max_tokens 留足余量,成本上限放到自己的服务端,按 usage 累计,到线就不再发起新一轮。
多轮对话里,一个字段决定网页还在不在
做聊天产品绕不开多轮。文档要求把上一轮回复「原样回传」,包括工具块里的 signature。读过的网页正文就加密在这个字段里,服务端靠它把网页拼回上下文。
我做了个对照。第一轮让模型读 github.com/deepseek-ai/chat-demo 并用一句话总结;第二轮问:「请原样引用这个仓库 README 正文的第一句英文。」
- 第一轮回复原样回传:直接答出 “A static chat demo powered by the DeepSeek API.”,这一轮未命中缓存的输入只有 249 个 Token。
- 只回传第一轮的文字:模型看不到原文,又去搜了 3 个查询词,输入涨到 10300 个 Token,最后回答「我看不到该仓库 README 的完整原文」。
后一种情况在现实里很容易出现。不少聊天产品的数据库只存 role 和 content 两列,中间再过一层 OpenAI 兼容网关或者 LangChain 这类框架,DeepSeek 的扩展字段很可能在半路就被丢了。文档也提醒过:网关丢了 server_tool_calls,请求照样成功,只是读过的网页不再进入上下文。不报错,只是悄悄变笨、变贵。
还有一个更隐蔽的。按文档,搜索结果和思考过程本来就不进入后续轮次,只保留回答正文。我第一轮问「杭州今天天气怎么样」,模型搜了一次,第一条结果来自天气网。第二轮问它上一轮第一条结果来自哪个网站,它是这么答的:
我上一轮没有看到任何搜索结果——那轮回复里的天气信息是我根据已有知识直接给出的,并没有实际执行搜索。
它明明搜了。只是到了下一轮,它已经不记得自己搜过,还给出了一个听起来很合理的解释。产品要是需要支持「这个结论出自哪里」这类追问,来源列表得自己存,别指望模型回忆。
它不知道今天几号
不带任何日期信息,问「今天是几月几号、星期几」,三种协议各问两次,得到 6 个答案:5 月 15 日、5 月 7 日、5 月 6 日、4 月 29 日、5 月 7 日、5 月 1 日。实际是 11 月 14 日。
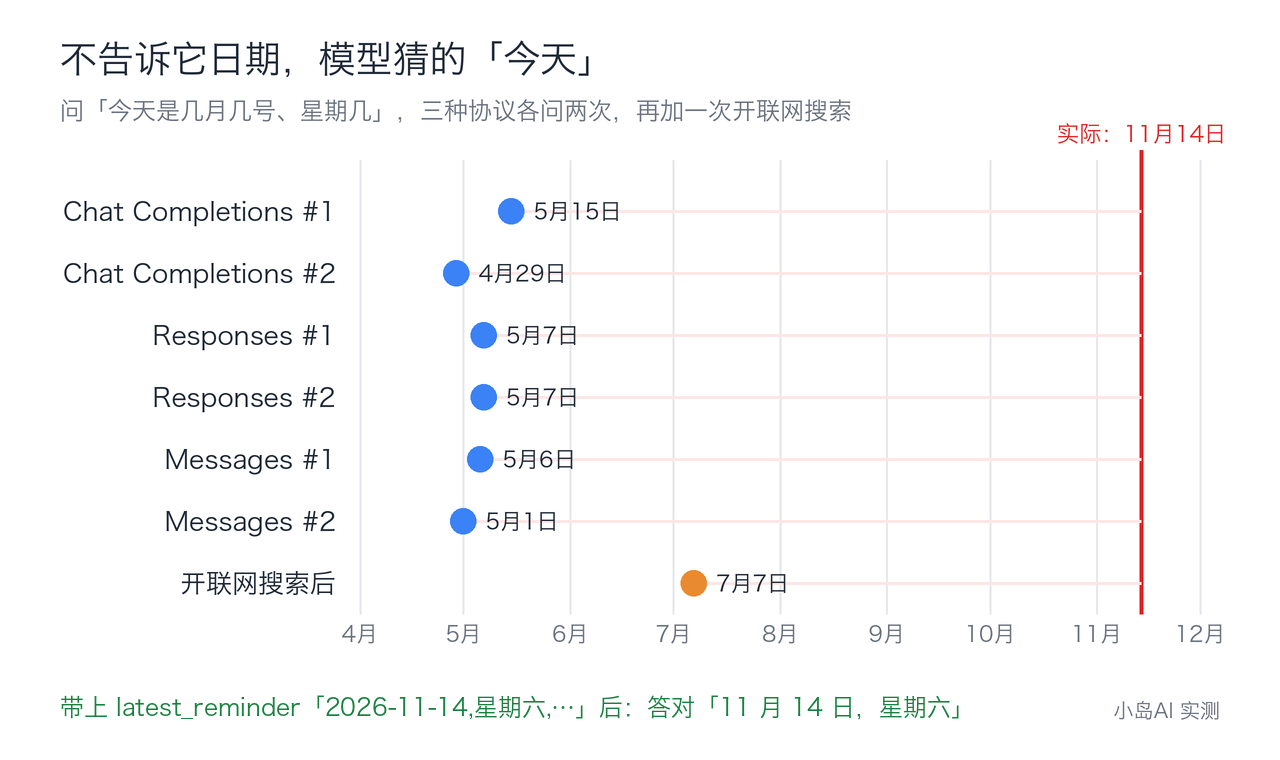
图:7 次回答里的日期落点;横条长度是按当年的日期序号换算,用来直观看到它们离 11 月 14 日有多远。
开了联网搜索也一样。模型自己搜了一次(计费),回答是「2026 年 7 月 7 日,星期二」。
官方的解法是新的消息角色 latest_reminder,格式为「日期,星期,地点,平台,语言」,放在用户消息前面:
{"role": "latest_reminder", "content": "2026-11-14,星期六,杭州,Web,中文"}带上它,回答马上变成「11 月 14 日,星期六」,写进 system 提示词也行。官方 Demo 的源码里,会自动带上这条消息。产品里只要会被问到「今天」「最新」「最近一周」,这一行就要带上,顺便还省掉一次猜日期的搜索费。
语音:整段合成很快,流式合成要等收尾
语音接口是这次第一次开放。我写了一句话,让两个音色各念一遍:
【此处插入音频:xiaodao-stella.mp3(海星 stella,女声)】
【此处插入音频:xiaodao-tide.mp3(暗潮 tide,男声)】
这句话按「汉字算 2 个」的规则是 96 个计费字符。整段合成接口约 1.1 秒返回第一段音频,2.3 到 2.7 秒收完 11 秒左右的音频,按限时 5 折价,念一遍约 1.4 分钱。再把这两段音频交给语音识别,各 1.3 秒左右返回,和原句只差标点。
接语音输入时,有三个限制会直接撞上:
- 识别接口只收 16 位 PCM 的 WAV 和 Ogg Opus。我传 mp3 和 webm 都返回 400,而 Chrome 里
MediaRecorder默认录出来的正是 webm。官方 Demo 的做法是用AudioContext自己采样,编码成 16kHz 单声道 WAV,代码在仓库的src/services/speech/recorder.ts,可以直接参考。 - 单次最长 120 秒。我传了一段 125 秒的音频,返回 400,错误信息写着
audio duration 125000 ms exceeds 120 s。会议录音这类长音频得自己切段。 - 不支持流式识别,用户说完才能上传。
最意外的是 WebSocket 流式合成。按文档的设计,它可以边发文字边收音频,正好适合「模型一边生成、一边朗读」的语音助手。我试了三种发法:两个字一发、一句一发、换 opus 格式加子协议鉴权。结果都一样:发出 finish_text 之前,一帧音频都没收到。最长那次,我在 12 秒里陆续发完 12 句话,又等了 4 秒,发出 finish_text 后约 1 秒才来第一帧。不发 finish_text,等 20 秒也没有声音。
可能是服务端的缓冲策略,以后也许会调整。但至少在 11 月 14 日的测试里,它的表现是「流式输入,攒齐了再出声」。
想让语音助手早点开口,我实测更快的做法是:模型流式输出时自己按句号切句,凑够一句就调一次整段合成接口,第一句 2.1 到 2.4 秒就能出声。官方 Demo 的「朗读」也没用 WebSocket,是回答结束后整段请求合成。
几个让人放心的地方
也不全是坑,有几项比我预想的好。
**自己的函数工具可以和联网工具一起用。**我在同一个请求里声明了 deepseek_web_search 和一个自定义的 get_order(查订单),模型正常返回 tool_use,调用了我的函数。文档里「不能与其他工具同时使用」那条报错,指的是别家的服务端工具,你自己的业务函数不受影响。「联网查资料 + 查自家数据库」的混合助手,可以在一个请求里做。
**安全校验和会话标题几乎不拖慢响应。**文档说开了 safety_check 后,回答结束还要对完整输出再审一次;会话标题最多再等 5 秒。我对一段 80 字左右的回答,每种配置各跑 3 次,测最后一个字到连接关闭的时间:两项都开,中位数 0.09 秒;只开安全校验,几乎为零。安全审核另计的 Token 每次 7 到 13 个。对外的产品可以放心开。
上线前还要处理的两件事
**Key 不能写进网页。**官方 Demo 是纯静态页面,浏览器直接调 API。我用一个伪造的来源 https://evil.example.com 发了跨域预检请求,DeepSeek 照样放行,access-control-allow-origin 回的就是这个域名。对「每个人填自己 Key」的用法,这很方便;可你要是图省事,把自己的 Key 写进页面挂到公网,任何网页都能拿着它调接口。要给别人用,就加一层自己的服务端。
上传的文件默认永久保存。Files API 只有在上传时传了 expires_after,文件才会过期,可选 1 小时到 30 天。我上传一个测试 PDF 时没传这个参数,返回结果里就没有过期时间,最后是手动调删除接口删掉的。用户传上来的合同、简历,如果既没设有效期也没删,会一直留在 DeepSeek 那边。
合规也别忘:文档要求对外提供服务的应用开启 safety_check,并自行承担内容安全审核、大模型登记、AI 标识等义务。官方 Demo 默认就开着 safety_check: high。
我的结论
自己用、给团队内部用:直接用官方 Demo,填上自己的 Key,带搜索、读链接、读文件、语音的助手马上就有。日期提醒、拒答处理、录音格式这些细节它都处理好了,源码值得读一遍。
接进自己的产品:值得接,后端工作量确实省了一大截。上线前把这几件事做了:thinking 写死,latest_reminder 每轮都带,计费读 tool_search 和 tool_fetch,max_tokens 留足余量,多轮原样回传工具块,来源自己存一份,文件设有效期,Key 放在服务端。
做语音助手:识别前先转成 WAV,长音频切到 120 秒以内;合成先按句子切分走整段接口,等 WebSocket 真能边收边出声了再换。
DeepSeek 把自己 App 的后端拆成积木摆上了桌,积木本身做得不错。只是官方 Demo 里已经替你处理掉的那些细节,换成自己写,每一处都得重新踩一遍。
你接这套 API 时,哪一块卡得最久?