
DeepSeek 开源昇腾组件,迁移前先补齐这 6 个依赖
DeepSeek 把昇腾上的语言、算子和通信组件都开了源。真正值得团队拿走的,不是一次模型启动记录,而是一张把运行时拆开验收的迁移清单。
今天上午,DeepSeek 开源了面向昇腾的基础设施组件,一口气把 TileLang、DeepGEMM Ascend、DeepEP Ascend、TileKernels、FlashMLA 和 DeepSelect 摆出来了。
看起来像一条很典型的发布新闻,DeepSeek 又把昇腾适配往前推了一步。可做部署的人看到这六个仓库,脑子里跳出来的应该不是「模型能不能加载」,而是另一件更琐碎也更要命的事。
一套大模型服务从一块卡挪到另一块卡,真正容易翻车的地方,通常不在权重文件。
权重加载成功,给你回一句「你好」,拍张图发群里,当然很开心。好家伙,demo 有了。可一旦请求并发起来、上下文变长、专家模型开始跨卡调度,那个看上去已经跑通的服务,才刚摸到迁移的门把手。
DeepSeek 这次开源的价值,就在于它没有只交付一个「能在昇腾上跑」的模型配方,而是把模型下面那几层也摆上了桌。
模型能起来,服务还不算起来
官方公告里有一句很关键,面向昇腾的组件与此前面向英伟达平台的开源组件一一对应。这不是在说把几个接口改个名字就收工,而是在补一条完整的底层链路。
TileLang 是写高性能算子的高级语言。DeepSeek 说,它在 V4 系列训练里已经承载了大部分算子实现。到昇腾这边,它把底层 Ascend C 指令封起来,让写算子的人不必每次都从更低的接口往上爬。对业务团队来说,这层离日常 API 最远,却常常决定某个模型结构能不能被高效实现。
DeepGEMM 管矩阵计算,DeepEP 管大规模跨设备通信。前者是大模型里最常见也最吃算力的活,后者一旦没跟上,MoE 这类需要在卡间搬运数据的模型就会把延迟写在脸上。TileKernels 补向量计算和访存,FlashMLA 对付长上下文里的稀疏注意力,DeepSelect 则负责高效筛选。它们合在一起,才接近一个真实推理或训练运行时会踩到的地面。
图为 DeepSeek 官方发布视觉,原图只说明了开源事件,性能与稳定性仍需按自身工作负载验证。
把它想成装修一间新机房。模型权重是搬进去的家具,能摆下不代表水电、通风和电梯都接好了。矩阵计算、通信、访存和注意力算子就是那些平时不显眼的管线,少一段,真正住进去的时候就会出问题。
这也是为什么「某个模型已经支持某硬件」这句话,工程上信息量很有限。它可能只代表一个固定版本、固定精度、固定 batch,在固定脚本里跑过。离「我们的线上流量能迁」还隔着一长串条件。
六层依赖,别揉成一句性能结论
准备评估昇腾的团队,可以把这次开源当成一张依赖图,而不是一条迁移指令。顺序最好从上往下捋。
先看模型和运行时。你要服务的是哪个版本,量化方案是什么,长上下文和多模态有没有进来,框架到底走 vLLM、SGLang 还是自己的封装。模型能启动,只回答了这层。
再看高性能算子。TileLang 和 DeepGEMM 能解决多少热路径,哪些算子仍会退回通用实现,精度、数值稳定性和编译缓存会不会在不同版本间变样。这里不做 profiler,只看吞吐数字,很容易把一次偶然的快当成常态。
然后是通信。DeepEP 这种库的存在,本身就在提醒我们,单卡数据算得再漂亮,跨卡调度也可能把尾延迟拖得很长。尤其是专家模型,预填充和解码阶段的流量形态还不一样,不能拿一个平均值把两件事糊过去。
访存、稀疏注意力和选择算子放在后面验。它们听起来更像底层细节,但往往决定长请求会不会突然掉速,或者某类输入一来,显存和队列就一起开始冒烟。厉害了,最难排的故障通常就在这些不够显眼的地方。
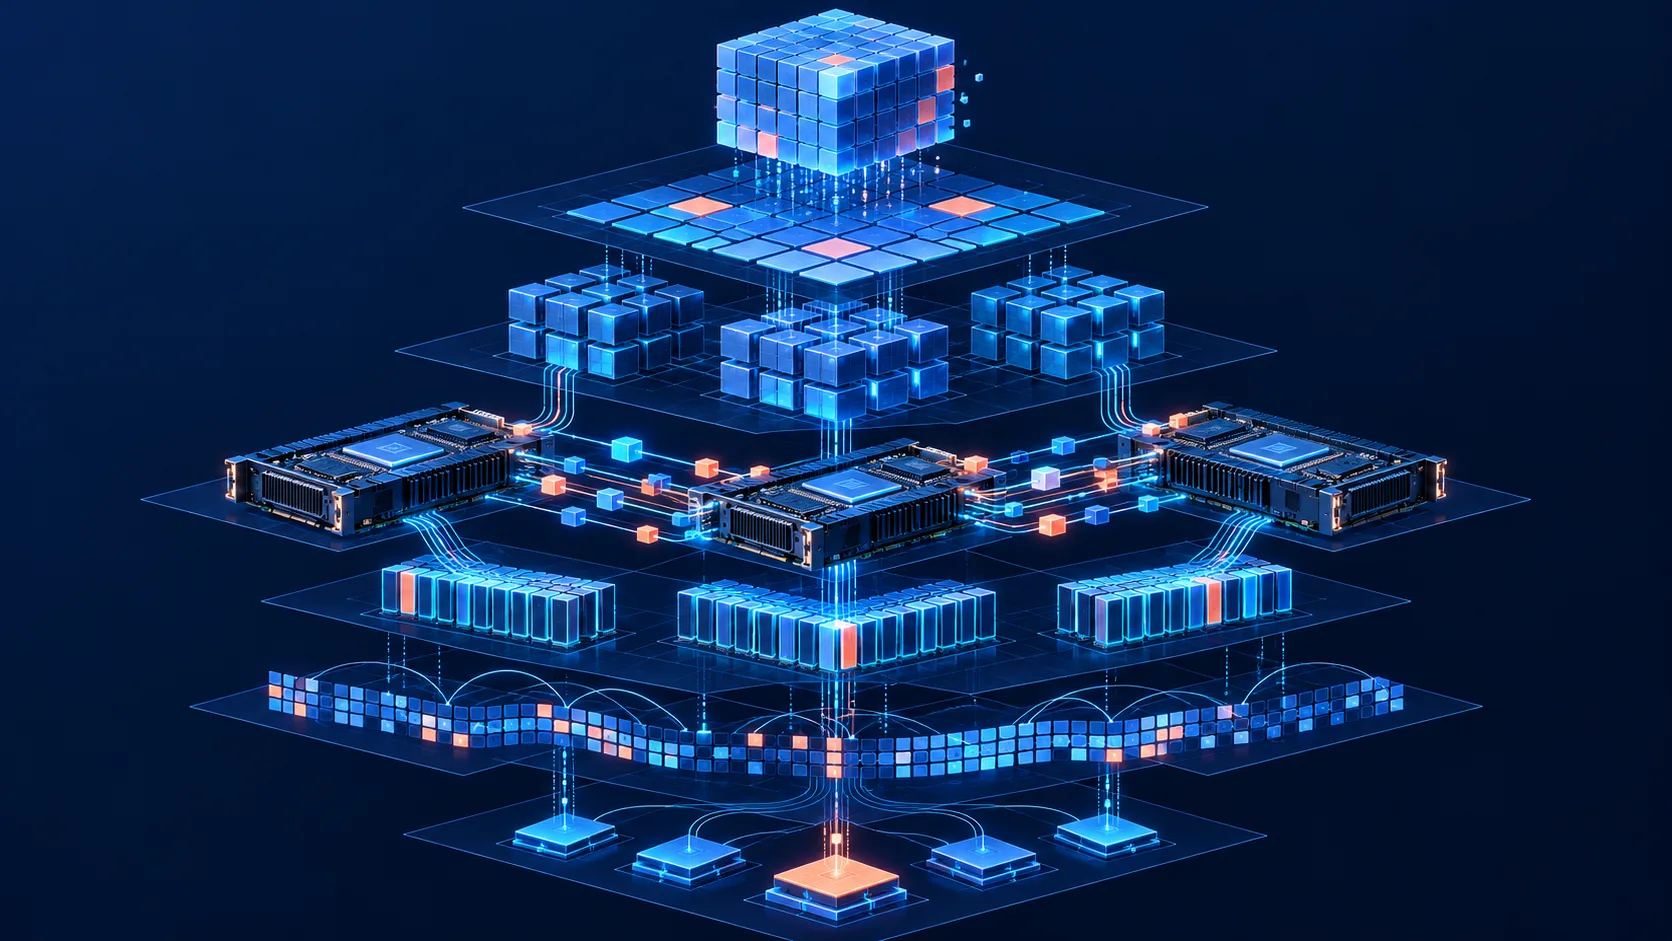
不要把模型加载、算子性能、跨卡通信和线上稳定性压成一个「已适配」。它们是四张不同的验收单。
实际验收时,别拿一条最顺的请求当样本。短输入、小并发和固定 batch 往往会把问题藏得很好,像刚搬完家只开了一盏灯,看哪儿都挺亮。把高峰时段常见的长输入、并发请求和需要跨卡的模型都带进来,才会知道系统是有余量,还是正好踩在边缘。
还有一件特别容易被略过去。性能回退不总是变成一条醒目的错误日志,更多时候会表现成尾延迟一点点变长、某种请求偶尔重试、扩容以后吞吐没有按预期增长。单看平均值,大家可能还会说「挺稳」。等到业务量真的压上来,才发现原来是通信或访存路径一直在默默排队。
所以评估报告里,最好把「什么没测」也写出来。没有跑多节点,就别把结论写成集群性能。没有复现线上请求分布,就别把 demo 吞吐当容量规划。这个习惯不够热闹,却能让后面的同事少接几次半夜告警。说真的,迁移项目最怕的不是结果不好,而是大家以为结果已经够好了。
如果只想拿走一个动作,我建议把下面这段放进每次硬件评估的 PR 或变更单里。它不替代压测,但能防止讨论一上来就被一张 demo 截图带跑。
任务与模型版本已锁定
运行时、驱动、框架与算子版本已记录
关键热路径已采样,不只看总吞吐
单卡、跨卡与长上下文分别压测
P50、P99、失败率和恢复时间一起对比
回滚路径、监控项和告警阈值已写清
这六行里没有一行很酷,甚至有点像工程师的扫地机器人清单。可一套服务真要迁,靠的就是这种无聊。把环境、版本、热路径和回滚写下来,后面碰到性能回退,才知道该找模型、框架还是通信层。
开源组件不是迁移的终点
DeepSeek 在公告中提到,相关计算和通信组件在多项关键测试中已接近硬件上限,也提到双方围绕昇腾 950 的 128 卡超节点做过计算与通信优化。这些是很强的工程信号,说明路径已经不只是概念图。
但这里还是得留个边界。官方测试里的模型版本、请求分布、batch、精度和集群拓扑,未必等于你手上的业务。硬件平台的体验从来不是一个单点跑分,更多像一串相互咬合的齿轮。哪一颗齿轮版本错了,前面再漂亮的数字也可能到不了线上。
这篇没有在自己的集群里实测上述组件,也不把官方公告当成独立基准。它更像一份启动评估前的地图,告诉我们该把问题问到哪里去。
DeepSeek 把这几层开出来,真正给团队省下的,是从零猜测哪里会卡住的时间。接下来更有意思的部分,是社区能不能把这些组件接进更多框架,留下可复现的性能报告和真实故障记录。那时候,硬件迁移才会从「能跑」慢慢变成「可维护」。
你们团队评估一套新算力时,最常漏掉的是算子、通信、观测,还是回滚?
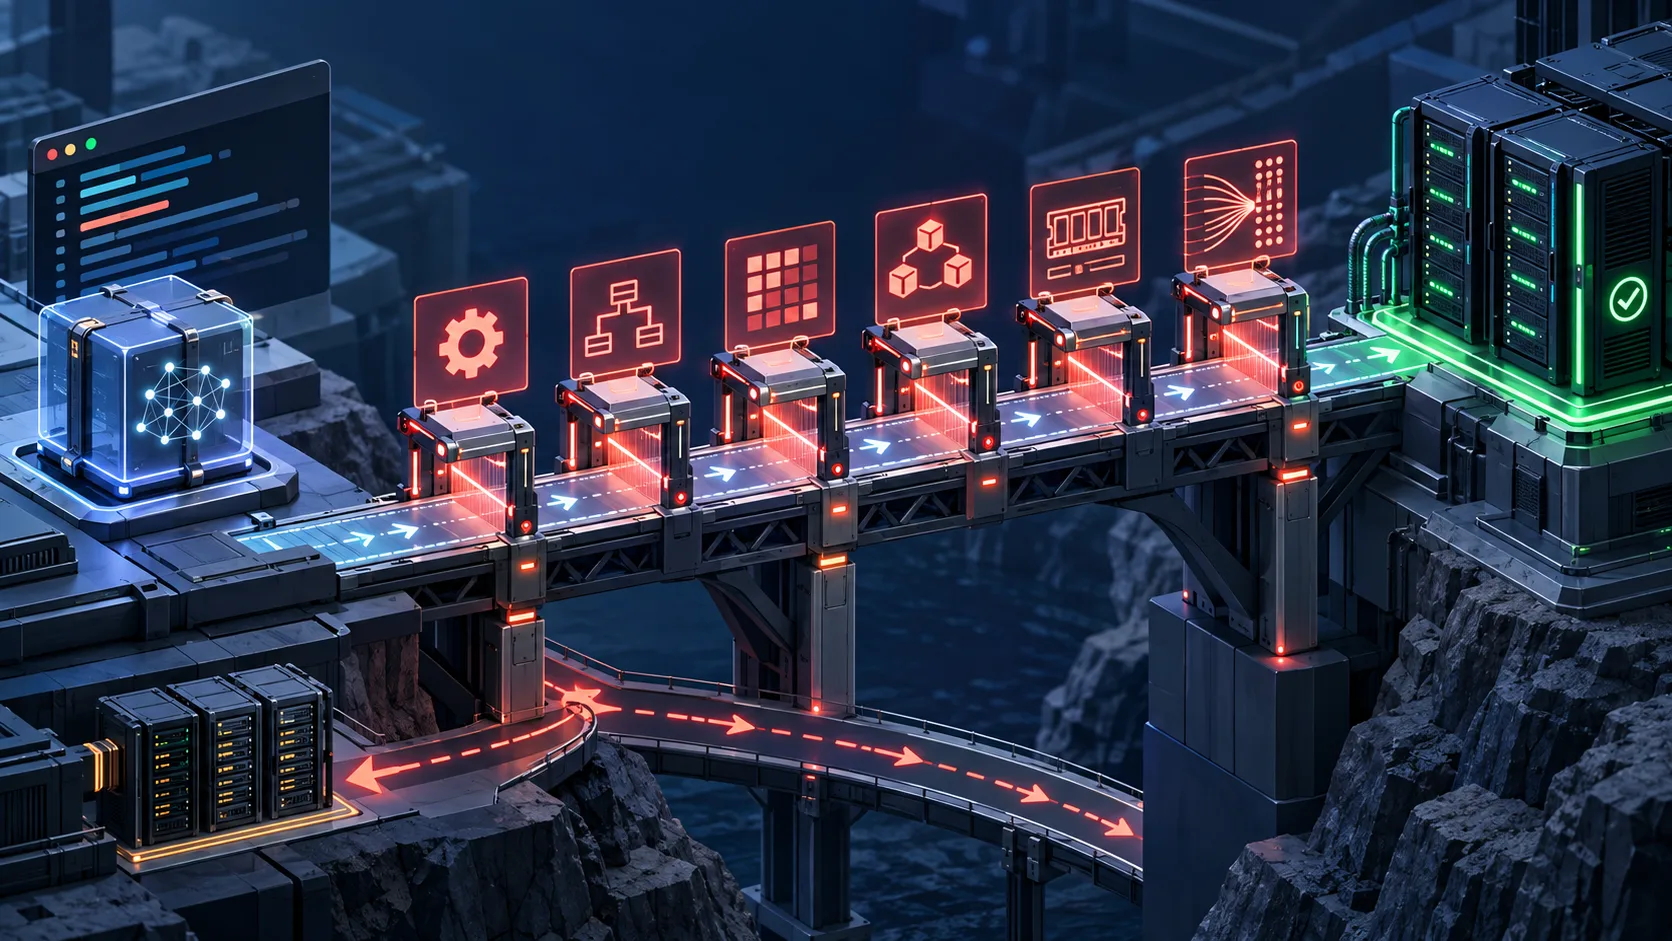
迁移不是一次启动仪式,而是一连串可以复验的工程检查。