
AI 写代码前,先用“没记忆”的审稿人挑刺
Google 开源的 EGM 把“懂项目的人写规格”和“没看过聊天记录的人挑漏洞”拆开。复杂功能值不值得多走这一步?文末有一张可直接带进下一次 Agent 开发的分流表。
给编码 Agent 一句“给账单页加 CSV 导出”,它很可能马上开始改组件、补接口、写测试。看上去很利落。
可真正麻烦的地方,往往不在那几百行代码里。导出的到底是当前筛选结果,还是账户全部历史?谁能导?异步任务失败后,用户是重试、取消,还是拿到半份文件?这些问题没有被写进需求时,Agent 也会替你做决定——只是它不会在 PR 标题里提醒你。
Google 组织这两天开源了一个叫 Elephant-Goldfish Model(EGM) 的插件。仓库当前约 1.5 万 Star。名字有点童话,做的事倒很朴素:让一个带着项目上下文的 Agent 先把规格写出来,再交给一个没看过此前对话的新 Agent 专门挑刺,最后由人决定哪些取舍要进实现。
我觉得它值得看的地方,不是又多了几只 Agent,而是它把一个常被忽略的开发选择摆到台面上:这次任务到底该直接开写,还是先花一轮时间让需求挨骂?
图:EGM 官方 README 的角色图:Elephant 保留项目上下文,Goldfish 不带此前聊天记录。
你缺的可能不是第二个实现 Agent
长会话有个很现实的毛病。它越了解代码库、越记得你刚才讲过什么,越容易顺着同一条思路往下跑。你说“导出 CSV”,它记得你上一次喜欢同步接口;你提到“给运营用”,它就默认运营能看全部数据。上下文是能力,也会带来惯性。
EGM 把这两种工作拆开了。它把带着项目、需求和既往决策的起草者叫 Elephant;它负责把问题问全、把设计稿写出来。随后,Goldfish 只拿设计文档和文档引用的源码,不继承前面的聊天记录。它的职责不是继续补代码,而是追问遗漏假设、含糊表述和实现风险。
这个切分很像 PR 评审里最有价值的那一类评论:不是“这里能不能少一行”,而是“如果用户重复点提交,状态会怎样”“这个字段谁有权看到”“旧客户端没升级时怎么退”。熟悉项目的人往往把这些当默认前提;刚进来的评审反而会问出来。
官方 README 也把边界写得很清楚:Goldfish 评审需要宿主环境真的能创建全新的子 Agent 上下文。做不到时,EGM 会停止评审;它不会假装把同一段聊天另开一个标签页就算“新鲜视角”。而且,设计评审不能替代测试,更不能替代人拍板。
哪些活值得先写规格
不是每个小改动都要摆出设计流程。一个已知原因的测试失败、文案替换、单文件样式修正,直接修、直接测,通常更划算。把这类任务也拉进多轮评审,只会把一次十分钟的修补变成流程税。
我会把下面三类任务拎出来,考虑先做一份能被陌生人读懂的规格:
- 改动跨过了模块边界。 例如前端入口、后端状态、队列任务和通知都要动。代码能分开写,接口契约不能靠默认值碰运气。
- 需求里藏着权限、数据或失败路径。 导出、支付、邀请、删除、Webhook、同步第三方数据,都不是“功能跑通”就结束。
- 同一句需求有两条以上合理实现路。 这时候先争论取舍,比让 Agent 各写一版、最后在 diff 里猜产品意图便宜得多。
反过来,如果任务能在一句话里把输入、改动文件和验收结果说清楚,而且失败时不会碰到数据、权限或外部副作用,直接写代码没什么丢人的。流程应该服务风险,不该拿来装成熟。
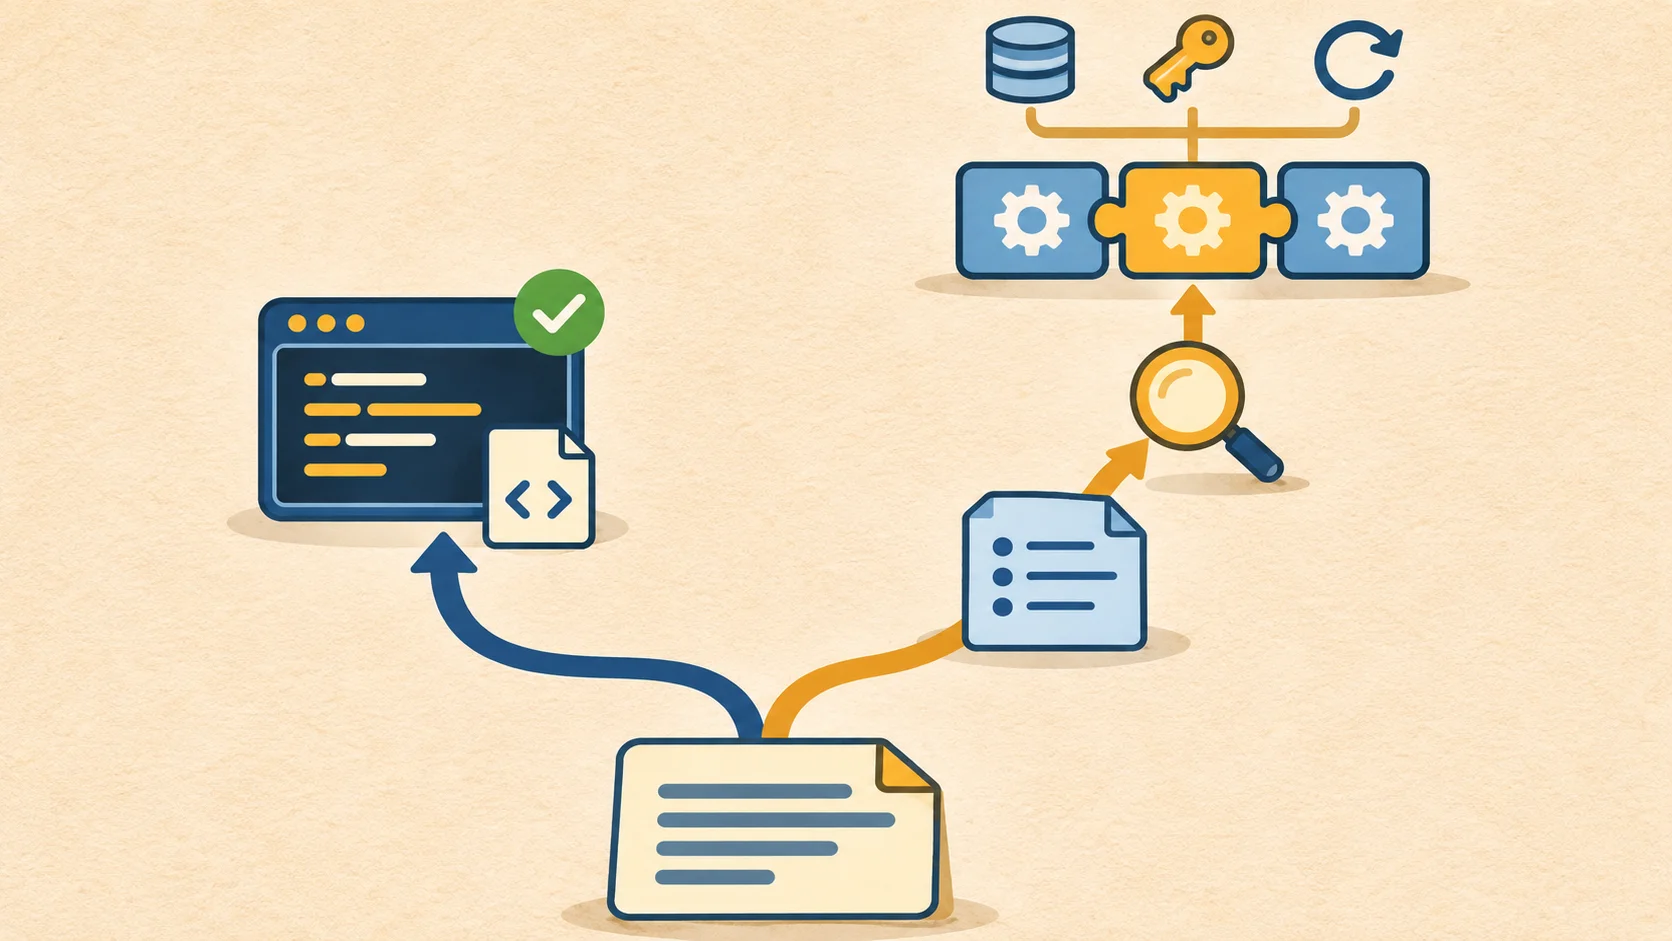
图:复杂度不是按代码行数判断;跨模块、权限数据和失败路径更值得先过规格闸门。
给下一次 Agent 开工前的三屏纸
就算不安装 EGM,这个思路也可以先手动用起来。给复杂功能开工前,先让当前 Agent 写一页 Markdown;再把那页和必要的源码片段交给一个没有前文的新会话,只做评审,不做实现。
第一屏不要写愿景,写这次交付物是什么:谁发起、输入是什么、成功后用户看到什么状态。像“支持导出”太虚;“管理员可导出当前筛选结果,系统生成可下载链接并保留 24 小时”就已经能开始讨论。
第二屏写明确不做什么。比如不导出被删除记录、不支持跨租户合并、不在请求线程里生成大文件。这个部分很省钱,因为许多误解不是需求没写,而是边界没人说出口。
第三屏写失败与验收:权限不足返回什么;重复请求是否复用任务;生成到一半失败如何显示;测试至少覆盖哪三个场景。让审稿人只问这一屏,往往就能把“它能跑”变成“它出了岔子我们也知道会怎样”。
可以直接从这个最小提纲开始:
## 目标
谁在什么条件下得到什么结果?

## 不做
这次明确不覆盖哪些数据、角色或异常情况?

## 失败路径
超时、重复提交、权限不足、外部依赖失败时分别怎么办?

## 验收
哪些可观察结果必须成立?哪些日志、测试或人工检查能证明它成立?
注意,这不是让新会话替你写出“标准答案”。它的价值是把你还没决定的地方标红。最后那句“我们宁可慢一点,也不让普通成员导出全量数据”,只能由真正对产品负责的人写进去。
“没记忆”不等于什么都不给它看
这里最容易走偏。很多人听到零上下文,会把完整仓库、需求背景和历史决定全部拿掉,然后希望审稿 Agent 凭一页模糊的描述发现所有问题。那不叫独立评审,更像闭眼抽查。
EGM 的 Goldfish 不是凭空猜题。它能读设计稿,也能读设计稿明确引用的源码。少掉的是前面那段不断强化某个方案的聊天记录。这个差别很重要:评审者应该知道当前接口、数据结构和业务边界,却不必被“我们前面已经讨论过,应该就是这样”的氛围带着走。
所以,给新会话的材料最好是小而闭合的包:一页规格、会改到的接口或类型定义、现有相邻测试,以及几个不能违反的约束。不要把整个仓库一股脑塞进去,也别只给一句“帮我看看有没有问题”。前者会让评审重新做一遍代码阅读,后者只能换来一张正确但没用的泛泛清单。
我比较喜欢把评审问题写得有点不客气:
请只审这份规格和列出的源码片段。

- 哪个决定一旦上线就最难撤回?
- 哪个权限、数据归属或失败状态没有被写清?
- 哪个验收条件即使全部通过,也仍可能让用户拿到错误结果?

不要设计新功能;若信息不足,请指出缺的是哪一条事实。
这段话的作用,是给“挑刺”设边界。它不让评审 Agent 又开始扩需求,也不让它把“我觉得应该更优雅”当成阻断理由。评审能发现问题,不等于它拥有无限的架构否决权。
真正要留下的是决策记录
规格审过一次,最怕的不是多出几条意见,而是意见消失在对话里。下次有人问“为什么导出链接只保留 24 小时”,团队只剩一句“当时 Agent 建议的”。这比没审还难追。
复杂功能最好把每个被采纳或被拒绝的意见,收成三列:问题是什么、谁决定怎么处理、为什么。它不需要长成设计论文;三五条关键记录就够。之后实现偏离规格时,drift report 这类能力才有东西可对照,PR 讨论也不必从聊天历史里考古。
这也是我不太愿意把 EGM 理解成“让 AI 多想一遍”的原因。多想一遍很容易变成多花一遍 token。把决定留下来,才会让下一次需求变更少一点重复争论。对 Agent 来说,它得到的是更短、更明确的实施边界;对人来说,留下的是可以反驳、也可以更新的工程判断。
EGM 的流程,适合拿来做什么
上游提供的主线是 brainstorm → draft → review:先讨论并形成 concept brief,再生成设计稿,最后让新的评审 Agent 检查完整性、清晰度、与现有代码的契合度和实施准备度。它也有给旧代码库补说明的 bootstrap,以及拿设计稿对照现有代码的 drift report。
如果你已经在用 Codex CLI,README 给出的安装方式是:
codex plugin marketplace add google/elephant-goldfish-model
codex plugin add egm@egm
不过别只复制 skills/ 目录。EGM 的评审还会读取 reviewer personas 和文档标准,官方文档要求完整安装。它支持多个宿主,但不同宿主能否提供隔离的评审上下文,是落地前真正要先核对的条件。
还有一件事得说在前面:这个仓库在 Google GitHub 组织下,README 仍明确标注它不是 Google 官方支持的产品。更重要的是,公开材料没有给出“能少多少返工”或“能多抓多少缺陷”的跑分。我没有拿它在生产项目上实测,也不会拿 Star 数替代效果证据。
所以,把 EGM 当成一台能自动避免事故的机器,肯定会失望。把它当成一个提醒——在 Agent 写得越来越快时,给需求留一个不受前文影响的反对者——反而更靠谱。
下一次让 Agent 改一个跨模块功能时,你最希望一个“没记忆”的审稿人先问哪一句?
小岛AI