
代码不出电脑,Google Agent 本地跑要 24GB 内存
Google 给 Antigravity SDK 补上了本地模型通路。离线并不等于把所有活交给小模型,先从审代码、补丁验证这类低风险步骤开始,硬件和权限边界得自己验。
你给 Agent 一句「把这三个模块审一遍,修掉漏洞,再跑测试」,心里多半会冒出一个小别扭。
它要读的,正是最不适合随手发到云端的代码。
Google 昨天给 Antigravity SDK 加了一条本地模型通路。用 LiteRT 跑 Gemma 4 26B A4B,Agent 可以完全离线干活。官方给的前提也没藏着,机器最好有超过 24GB 的显存或统一内存。
这数字先摆在第一屏,不是为了劝退。它反而把本地 Agent 最容易被口号盖住的事挑明了,隐私和离线不是白送的,你得拿硬件、速度和运维去换。
很多朋友一看到「本地模型」,脑子里浮现的还是终端里慢吞吞吐字的聊天框。可 Agent 的问题不只是回答一句话。它得读文件、写补丁、调用测试、收集报错,再决定下一步干什么。模型只是脑子,工具权限、工作区和验收脚本才是让它别乱跑的围栏。
Google 这次值钱的地方,是把这套围栏带进了本地运行时。
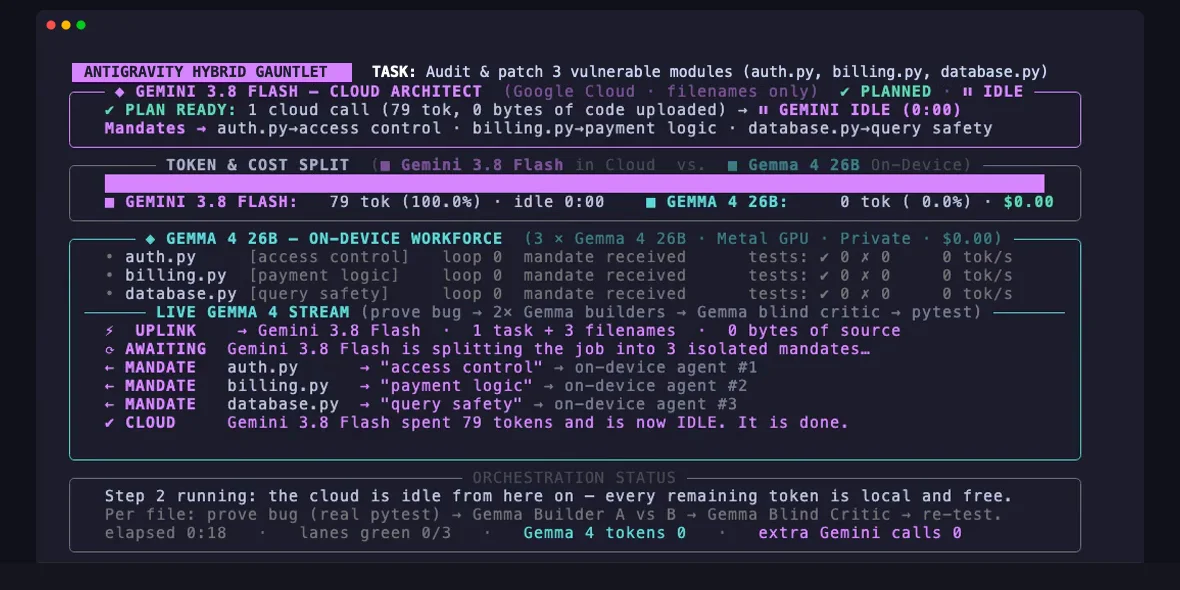
Google 官方演示帧,云端只做任务规划,本地 Agent 分别处理三个模块。
官方演示里有个很克制、也很工程化的分工。云端的 Gemini 3.8 Flash 只看文件名和任务描述,负责把工作拆开。三个真正带漏洞的 Python 模块不上传,由本地的 Gemma 实例在机器上复现问题、写候选补丁、互相挑刺,再跑回归测试。
在那次录制演示中,云端规划只花了 95 个 token,3,322 个 token 里有 97.2% 留在本地。这个数字只能说明官方这套三文件案例跑通了,不能拿去估算你家仓库的账单。可它把一个方向讲得很清楚,云端模型不必每一步都看源码,先把任务边界说清,也能做规划。
好家伙,终于不是「要隐私就别用 Agent」和「想用 Agent 就全交出去」这两档开关了。
真正能先搬回本机的活
真正适合第一批搬回本机的,不是所有任务。
我会优先看三类。第一类是代码审查前的整理活,例如在本地归类错误日志、标记可疑 diff、把测试失败按模块聚起来。第二类是补丁候选的验证活,Agent 可以在隔离工作区里多写几种修法,再交给现有测试筛一遍。第三类是含敏感上下文、但答案仍由人拍板的辅助任务,例如给内部接口改名、补测试夹具、检查配置漂移。
这些活有个共同点,出错不会直接变成生产事故,而且你手上已经有测试、lint 或人工 review 这张网。让本地 Agent 在网里折腾,价值比让它第一次就碰数据库迁移、付款逻辑和部署权限大得多。
官方的入门路径不复杂,先装 SDK 和 LiteRT-LM,再导入模型。
装上之前,先把权限围栏搭好
python3 -m venv .venv
source .venv/bin/activate
pip install google-antigravity litert-lm

litert-lm import \
  --from-huggingface-repo=litert-community/gemma-4-26B-A4B-it-litert-lm \
  gemma-4-26B-A4B-it-gpu.litertlm \
  gemma4-26b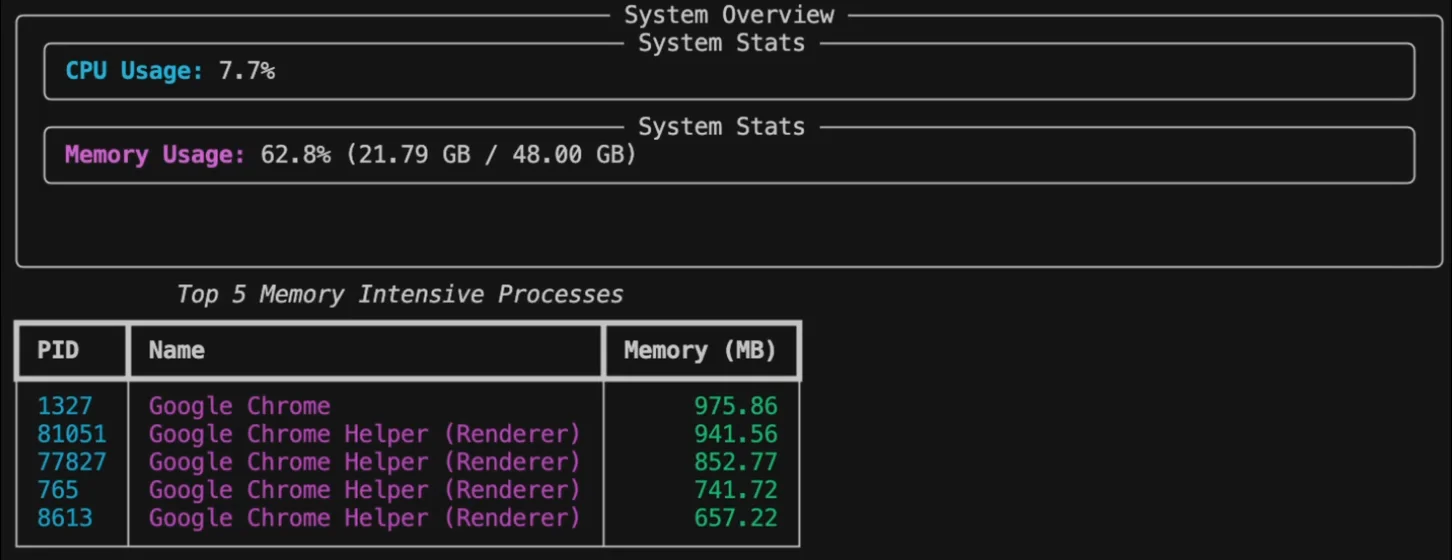
Google 官方演示帧,生成的终端工具会显示 CPU、内存和高占用进程。
但装完不等于能放心接仓库。代码留在电脑里,权限依然可能把它带出工作区。模型能访问哪些目录,能不能执行 shell,允许不允许联网,生成的补丁必须经过哪些测试,这些规则没有因为模型换成本地就自动消失。
本地不是替代云端
所以我不太认同「本地 Agent 会替掉云端 Agent」这种说法。更像是把以前只能交给云端的一段流水线,拆成了两段。云端做它擅长的长程规划、复杂判断和必要的知识检索。本地处理重复、敏感、token 多又能被明确验收的活。
这条路线有个很朴素的好处。你不必等到整个团队都有 24GB 以上的机器,也不用一口气迁移所有 Agent 工作流。先挑一个测试扎实、数据敏感、失败可回滚的小模块,记录一次运行耗时、显存峰值、补丁通过率和人工 review 的返工数。跑完再决定值不值得扩。
厉害了,这才是本地模型该有的打开方式。不是在发布会上替你赢一场架,而是在真正敏感的代码旁边,给你多留一条可控的路。
我没有在自己的机器上跑这套 SDK。本文只依据 Google 的官方说明 和公开演示,硬件兼容性、实际速度与修复质量仍要在自己的隔离仓库里验证。
如果你手里有一段不愿上传、但又很想交给 Agent 帮忙的代码,你会先把哪一步放到本地?