
自建模型加水印,vLLM 把性能账压到 0.19%
vLLM 把文本水印放进采样器,吞吐接近不变。真正该先定的不是开关,而是密钥、检测权和请求绕过权。
如果你的团队把大模型部署在自己的机器上,给客户做摘要、客服回复、内容草稿,迟早会遇到一句很朴素的话。
「这段文字到底是不是我们服务生成的?」
听上去像合规同事递来的一张需求单。真要做,事情马上变得有点拧巴。生成完再往文字里塞标记,容易被复制、改写、转格式一把抹掉。为了留痕而让延迟和吞吐掉下去,线上团队又不会答应。
vLLM 这周把一条新路放进了推理引擎。它把 Gumbel-max 文本水印接进了 Model Runner V2 的采样路径,官方给出的数字挺耐看。Qwen3.5-27B 在一张 H100 上跑 MTP-3、每次生成 512 个 token,八组 batch 的配对吞吐变化在 −1.1% 到 +2.0% 之间。为避免重复上下文导致输出打转,加上的上下文去重,端到端额外开销最高是 0.19%。官方实现说明和功能文档都已经放出来了。
这不是说水印突然成了万能验真器。它更像给自建模型的出站链路补了一张可供回查的收据。收据能不能用,取决于你把密钥、检测和绕过权放在谁手上。把这三个地方留空,吞吐再漂亮也只是多了一个配置项。
水印不是在答案上盖章,而是在模型选词时留下一条路
常见的想象是,模型先写完一段话,系统再偷偷改几个词,像把透明印章压进句子里。文本没这么好摆弄。你一改词,质量、风格和事实都有可能被拖走;你不改词,标记又无从出现。
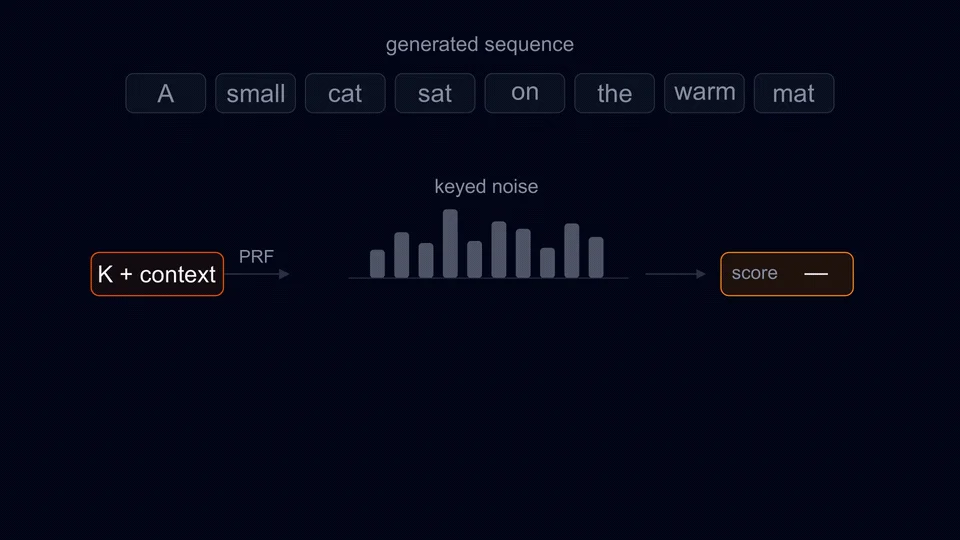
Gumbel-max 走的是另一条路。模型在每一步都有一堆候选 token 和各自概率。普通采样会从随机数里抽一次。水印版本则用密钥、近期上下文和候选 token 推导出一组可复现的随机值,再参与这次抽样。知道同一把密钥和同一套配置的检测器,可以把那些随机值重新算出来,看看文本里是否积累出异常一致的信号。
关键在「参与抽样」而不是「抽完篡改」。官方的论证是,跨密钥看,这种 Gumbel-max 选法保持原来的边际采样分布。换成不那么学院派的话,水印不该系统性偏爱某些词、写出一股固定腔调,或者让解题结果向一个方向歪过去。
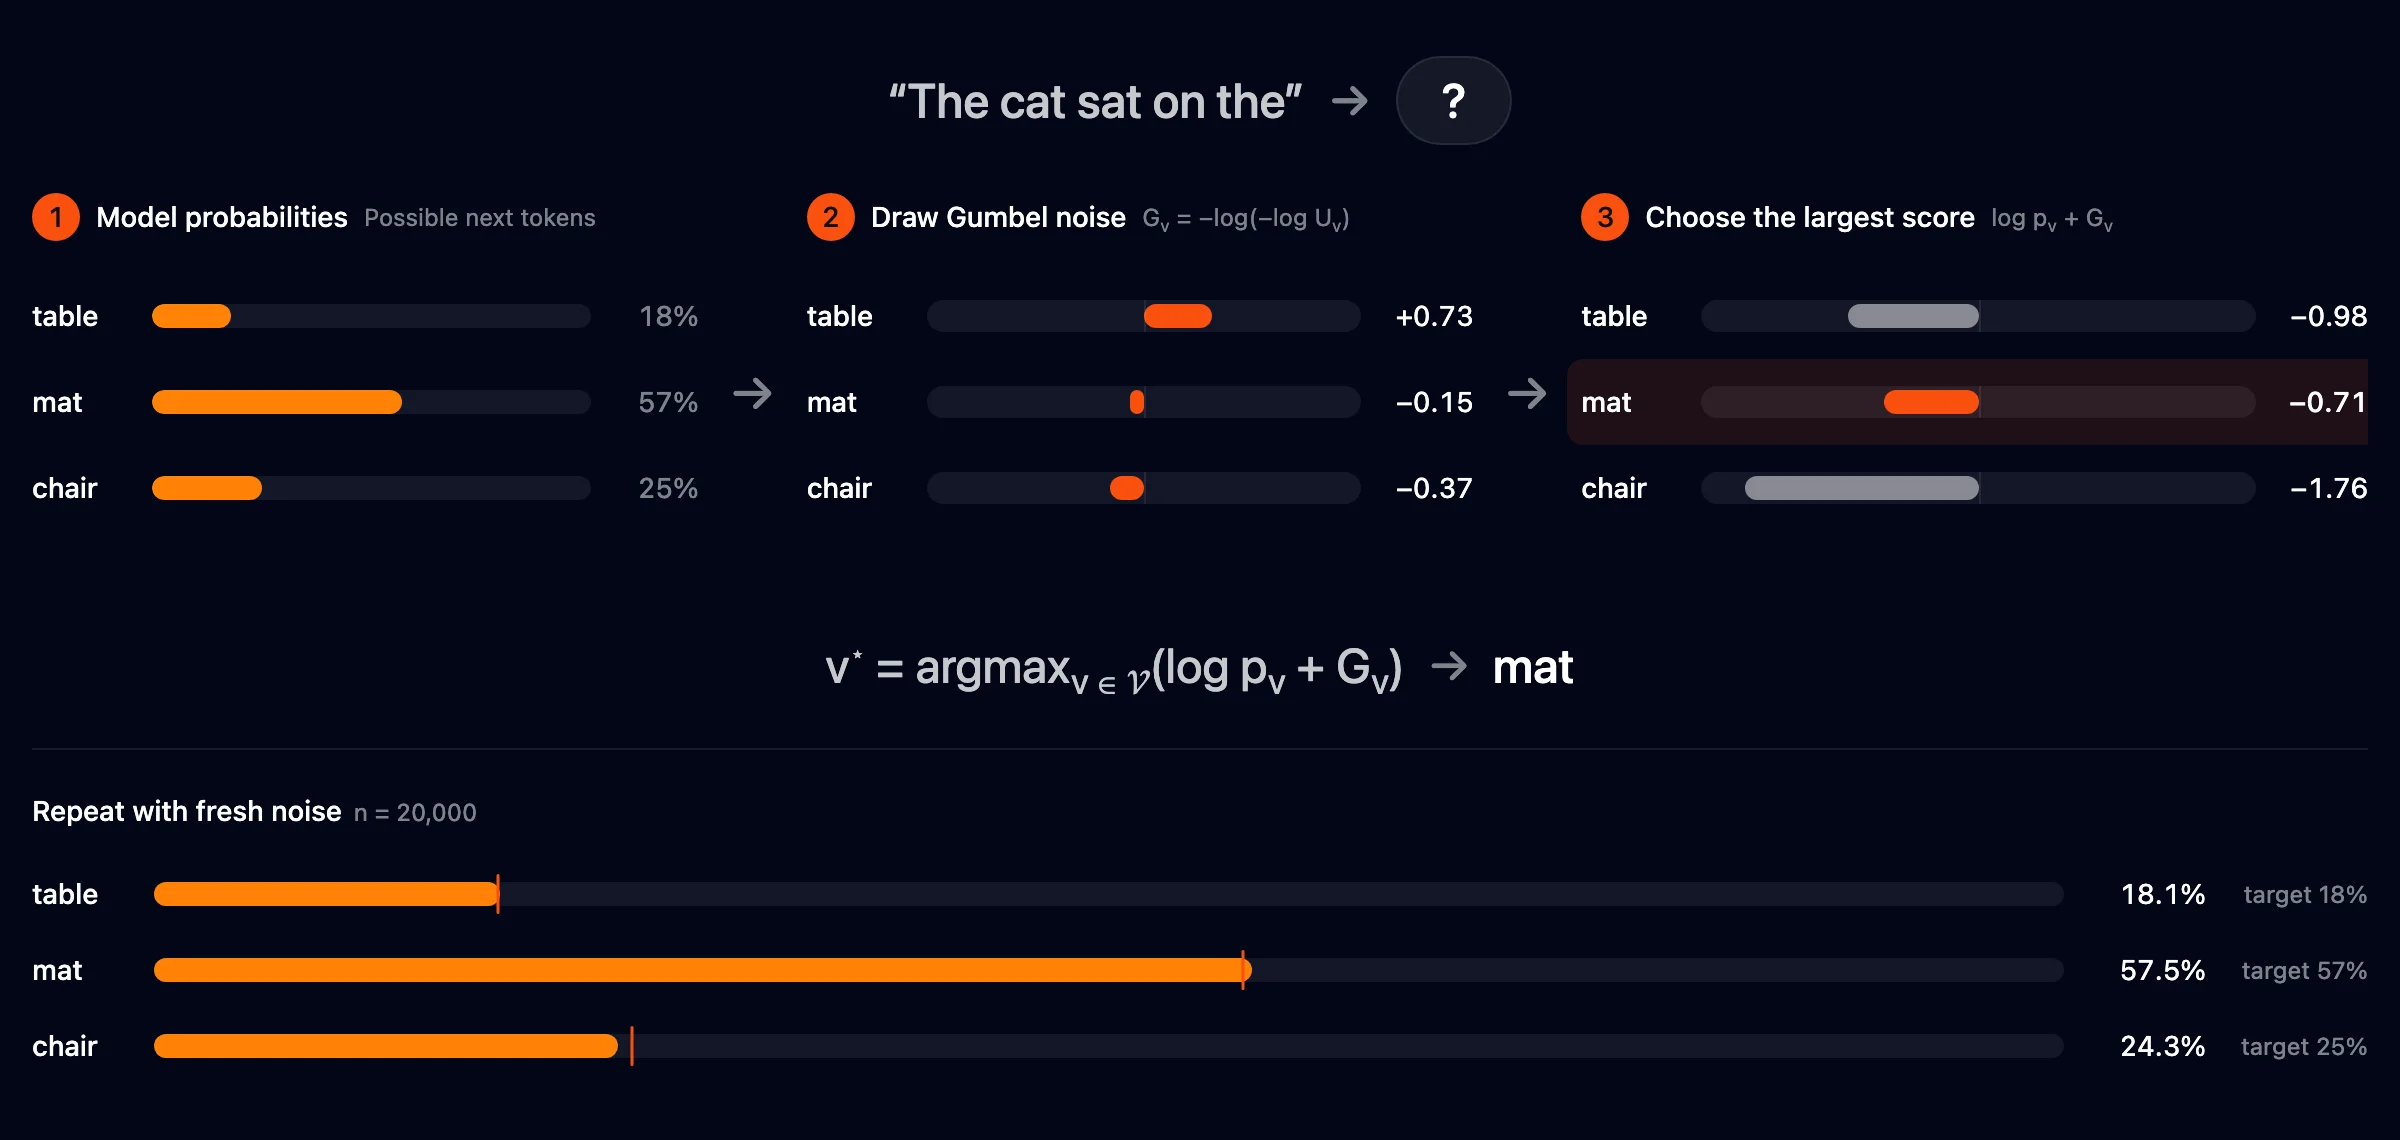
这也是它终于值得在线上推理系统里被认真讨论的原因。以前许多水印方案一碰到高并发就露怯,要么多做几轮采样,要么造出很大的噪声张量。vLLM 把伪随机数、Gumbel 变换和取最大值融进一个 GPU kernel,没把一块 [batch, vocabulary] 的临时大张量摊在显存里。听着是实现细节,落到值班表上就是一句人话:别为了留证据先把显存和吞吐祭了。
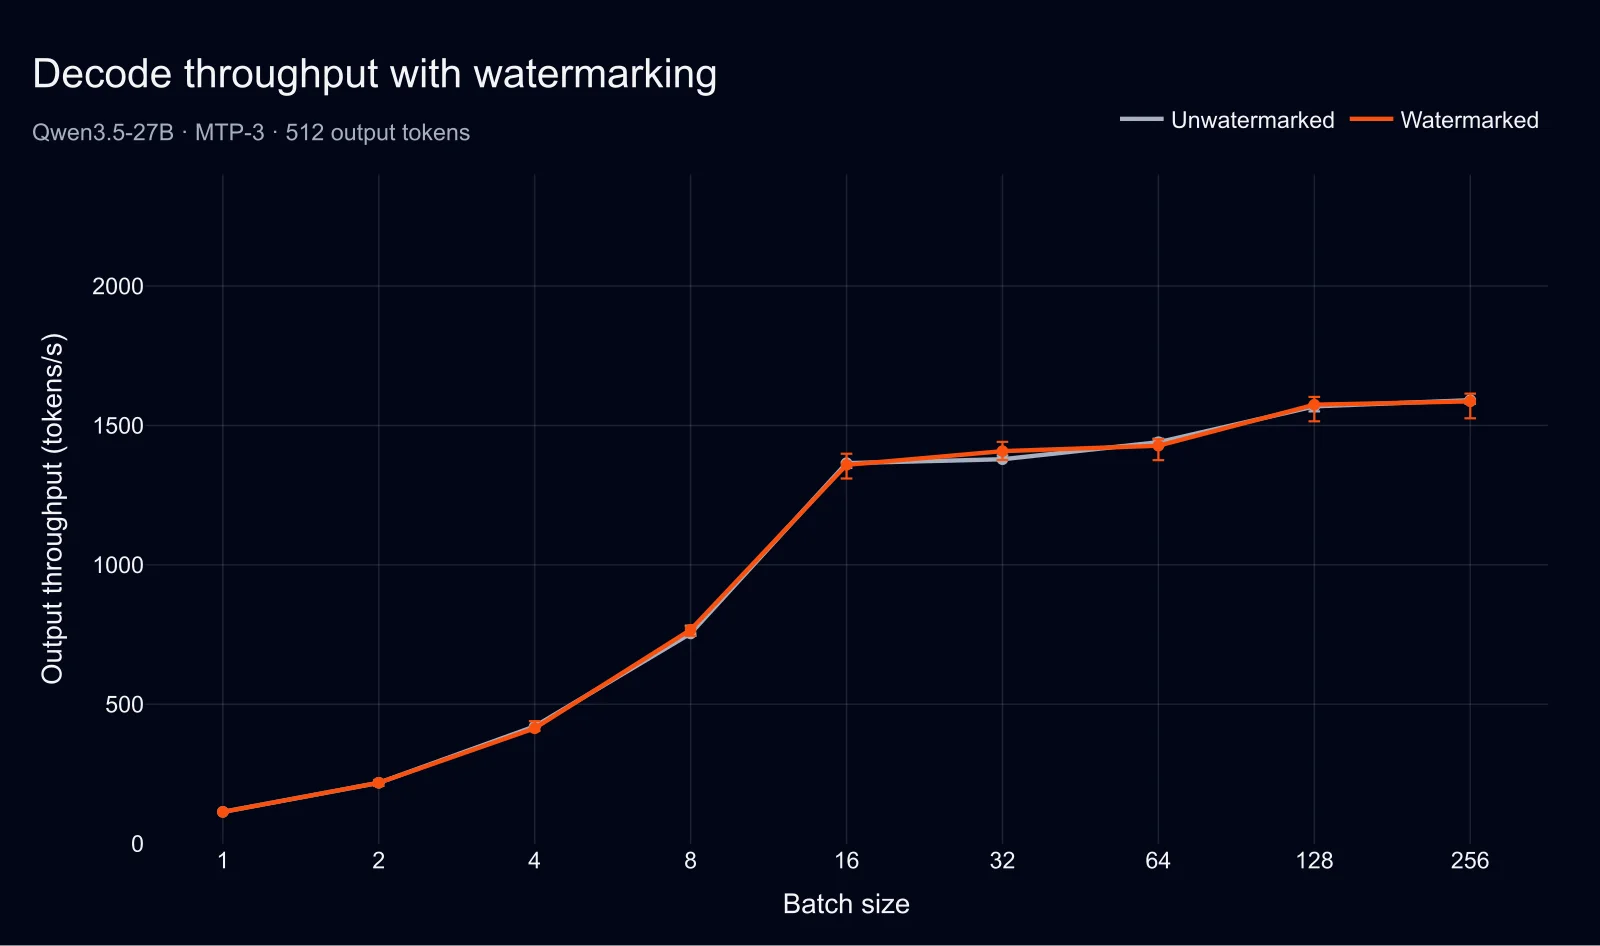
不过,官方的吞吐表不是你的 SLA。那组测试固定了模型、H100、MTP-3 和 512 个输出 token。换成你们的模型、上下文长度、并发、量化方式和流式首 token 目标,账要重新算。这里不能拿一张很顺眼的图去替代压测。
真正容易翻车的,是投机解码和重复上下文
自建服务要速度,很多人已经开了投机解码。小模型先猜一串 token,大模型来验收。水印如果粗暴地让两边用同一把密钥,两个分布各自看着都没毛病,彼此重叠却可能变小,草稿 token 被接受的比例跟着掉。你本来想省算力,结果水印把省下来的又抹回去,多少有点尴尬。
vLLM 的处理是双密钥。已接受的草稿 token 用一把,目标模型补出来的残差和奖励 token 用另一把。检测时再把两套信号合并。代价也很老实,检测信号会被摊薄。所以「支持投机解码」不是一句可以直接写进验收结论的宣传词,还得问一句:在自己的文本长度和业务分布里,检测需要多长的样本,误报和漏报是否还能接受。
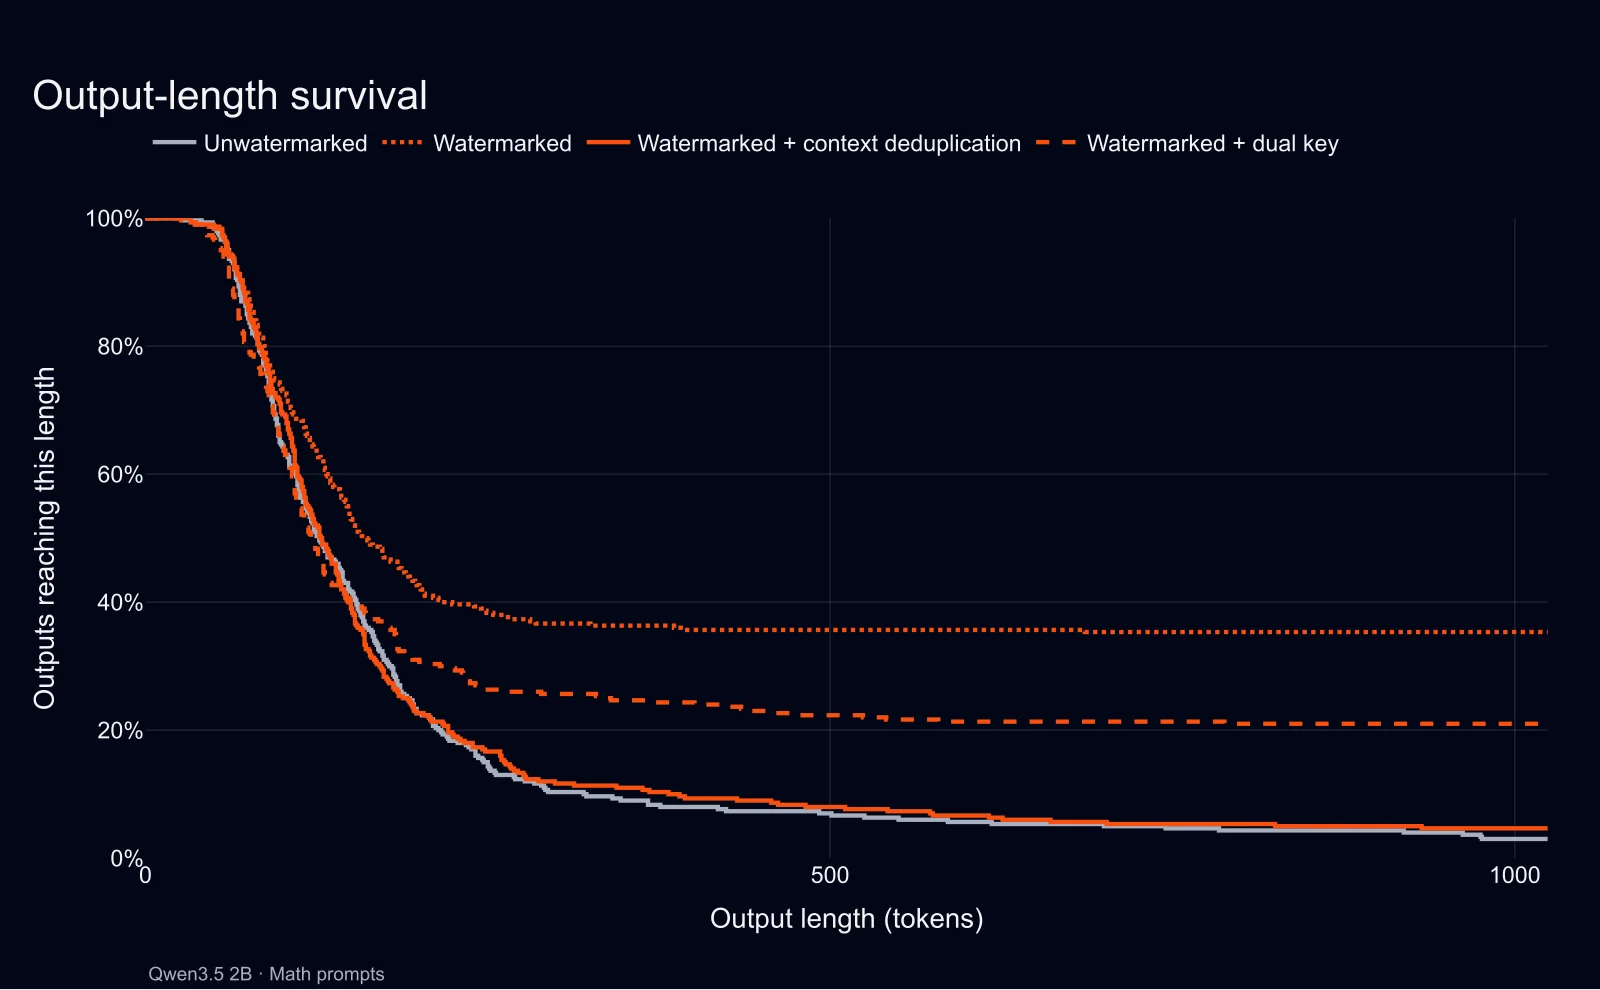
另一个坑更隐蔽。水印要看最近上下文。上下文重复时,随机值也会重复。某些模型概率再刚好相似,输出可能钻进重复循环,越写越长,最终撞到长度上限。官方给的例子很直白,类似「1 加 1 加」的上下文反复出现后,下一步会反复偏向同样的 token。
这次的上下文去重会在上下文重复时跳过水印。官方测试里它的端到端开销最高为 0.19%。这个数字值得看,但更值得带走的是它背后的动作。给模型服务加一个安全或可追溯能力,别只看平均吞吐。长输出比例、重复率、停止原因、草稿接受率,都该进同一张看板。
一把密钥能检测,也意味着它不能散在业务代码里
水印最容易被误解成「我打开了,它就能证明来源」。不能。
检测器至少要拿到匹配的密钥、分词器和水印配置。不同模型、不同 tokenizer、不同上下文宽度混在一起,得出的分数没有可比性。短文本和高度固定的文本也攒不出多少独立信号。官方的检测曲线就显示,创意文本在约 100 个 token 附近已经很强,代码类 MBPP 样本到 400 个 token 仍会因候选配置数量不同而明显变弱。
还有一个更实际的洞。vLLM 的水印在服务启动时配置后默认会开,但请求侧可以显式传 watermarking: false 关闭。文档已经把话说得很清楚,需要水印的部署必须在入口处限制、剥离或校验这个字段,不可信调用方不能自己决定绕过。
这就把工作从「给服务加 flag」变成了权限设计。
业务应用只该有调用权限。密钥要在平台配置或密钥服务里,不能出现在前端、日志和普通业务仓库。检测服务最好单独部署,至少把原始文本、模型版本、tokenizer、配置版本、检测结果和处置编号一并存下。否则三个月后有人拿着一段文本来问,你只能知道当时开过水印,没法知道当时究竟用了哪一套规则。
可以从这四件事开始验收:
- 密钥归属。谁生成、谁轮换、谁能读取,是否按租户或环境隔离。
- 绕过权。网关是否拒绝或改写来自不可信调用方的
watermarking: false。 - 检测样本。每种主要业务文本多长才有足够信号,阈值对应的误报和漏报准备怎么处理。
- 性能账。把首 token、每秒 token、长输出、草稿接受率和重复停止原因,与不开水印的基线并排测。
做完这四项,别急着把开关推到所有流量。先挑一个文本长度够、输出格式相对稳定、又有人工复核出口的业务面。用不开水印和开水印两组流量跑同样的压测,再抽取一批真实但已脱敏的结果给检测器。你要看到的不是「检测过了」四个字,而是三张能对上的记录:哪一版模型在什么配置下生成、检测器用什么配置得出什么统计值、最终由谁按什么规则处置。
如果团队存在多租户或客户自带模型,配置版本比想象中更要紧。相同文本用错 tokenizer 或 context width,分数不会自动提醒你「我在拿错尺子」。把这些版本写进日志,短期看只是多几列字段,真到排查一条争议文本时,省下的是整轮猜测。
启动方式其实不复杂。官方最小配置就是下面两行。
vllm serve mistralai/Mistral-7B-Instruct-v0.3 \
  --watermark-config '{"algorithm":"gumbel","key":42}'
真实生产环境别把 42 当作示范之外的任何东西。它应该来自受控密钥,而不是被复制进部署脚本。默认上下文宽度是 4。调大水印对局部编辑会更敏感,超过 16 文档会给出告警。Beam search 和替换了 vLLM 采样器的自定义模型,也不在这项能力的适用范围里。
先把它当成「可回查」,别急着当成「可定罪」
水印提供的是统计证据,不是神谕。它能回答「这段文本和某个已知配置是否一致」,不能单独回答「这段内容是谁发的、意图是什么、有没有被人改过」。文本被改写、混入其他材料、样本很短,信号都会变弱。候选密钥、分词器或配置试得越多,偶然碰上的概率也会上升,阈值要跟着收紧。
所以最合适的第一站,不是拿它去自动裁决客户纠纷,而是用在内部调试、受控渠道的出站留痕、人工复核的证据补强。等你有了真实业务样本,知道检测分数和处理结果如何对应,再讨论它能承担多大的责任。
vLLM 这次最有价值的地方,不是给模型服务添了一枚「AI 生成」贴纸。它把一个原本容易牺牲质量和性能的选择,做进了高吞吐推理的采样路径。接下来轮到部署的人做那部分没那么耀眼、却更决定成败的工作:把密钥管住,把绕过权堵住,把检测结果接到真正有人看的地方。
你们的自建模型服务如果要做出站留痕,最先补的是性能基线、密钥治理,还是请求侧的绕过控制?