
推理服务卡在 vLLM?Agent 写的专用引擎最高快 90%
Baseten 的实验很猛,但它真正给模型服务团队的不是替换清单,而是一套先锁定工作负载、正确性和预算,再让 Agent 优化的决策方法。
如果你手里正跑着一台 Qwen 服务,延迟偶尔顶到天花板,GPU 利用率又像在跟你装不熟,那这条消息值得先存一下。
Baseten 让 Claude Code 驱动的智能体,给 Qwen-3.6-35B-A3B 写了一套专用推理服务。单张 B200 上,单流解码最高比调优后的 vLLM 0.25.1 快了 90%,首 Token 从 28ms 压到 12ms,32 路并发吞吐高了 71%。数字摆出来,确实有点子牛逼。
但我更在意另一件事。
这不是“Agent 比工程师更会写 CUDA”的故事。它更像一场被约束得很严的性能实验。模型固定,硬件固定,流量形状固定,正确性门槛固定,连每次改动怎么压测都固定。Agent 不是去无边界地找灵感,而是在一个极窄的搜索空间里,一次次提出改动、跑压测、过精度门槛。
很多团队看完可能会冒出一句,既然这样,我们是不是也该把 vLLM 换掉?
先别急着打开重构分支。
这篇官方工程报告最值得抄的,不是那 90%,而是它把“什么时候可以让 Agent 碰生产性能”这道题,拆成了一组能验证的条件。没有这些条件,性能数字再漂亮,也可能只是把一个通用系统的稳定性换成了一张好看的图。
本文不做本地复现。所有数字来自 Baseten 的原始工程报告,实验尚未承载生产流量。下面只聊它对正在维护模型服务的人,到底有什么用。
90% 快在一个很窄的坐标里
先把实验坐标钉在墙上,不然很容易把一段跑分读成行业结论。
Baseten 的目标是 Qwen-3.6-35B-A3B,使用 NVFP4 量化权重,跑在单张 NVIDIA B200 上。对照组不是随手起的默认服务,而是调优过的 vLLM 0.25.1。智能体产出的服务被叫作 VibeQwen。
在适合 speculative decoding 的单流重复结构化文本里,VibeQwen 做到 1792 TPS,vLLM 是 943 TPS。这里的 TPS 是每秒生成的 token 数,适合看持续输出速度。首 Token 时间则从 28ms 到 12ms,用户点下发送后看到第一段回复的等待感,会直接受它影响。
32 路并发时,VibeQwen 的单副本输出吞吐是 10307 TPS,对照组为 6030 TPS。好家伙,这三组数已经足够让人想把“专用服务”四个字写进下个季度的性能 OKR。
可它们都带着非常具体的前提。
它服务的是一个模型、一种精度、一张卡和一组被测流量。通用引擎要照顾更多模型、更多加速器、更多长短请求混杂的情况,还得留出运维、兼容、升级和故障处理的余地。vLLM、SGLang、TensorRT-LLM 的价值,恰恰在这里。它们不是为你手头这一组坐标榨干最后一滴性能而生的,它们是为了让更多人不用从头造一台推理服务。
所以,专用服务领先通用引擎,不该被读成“通用引擎落后了”。它只是在提醒我们,通用性本来就有成本。模型、硬件和流量越稳定,这笔成本越可能被专项优化挖出来。
这件事以前也成立,只是过去要靠一个很懂 kernel、batching、KV cache 的团队慢慢磨。现在多了一个选项,先把目标和护栏写清楚,让 Agent 帮你把搜索空间翻一遍。
不过,能翻不等于该翻。
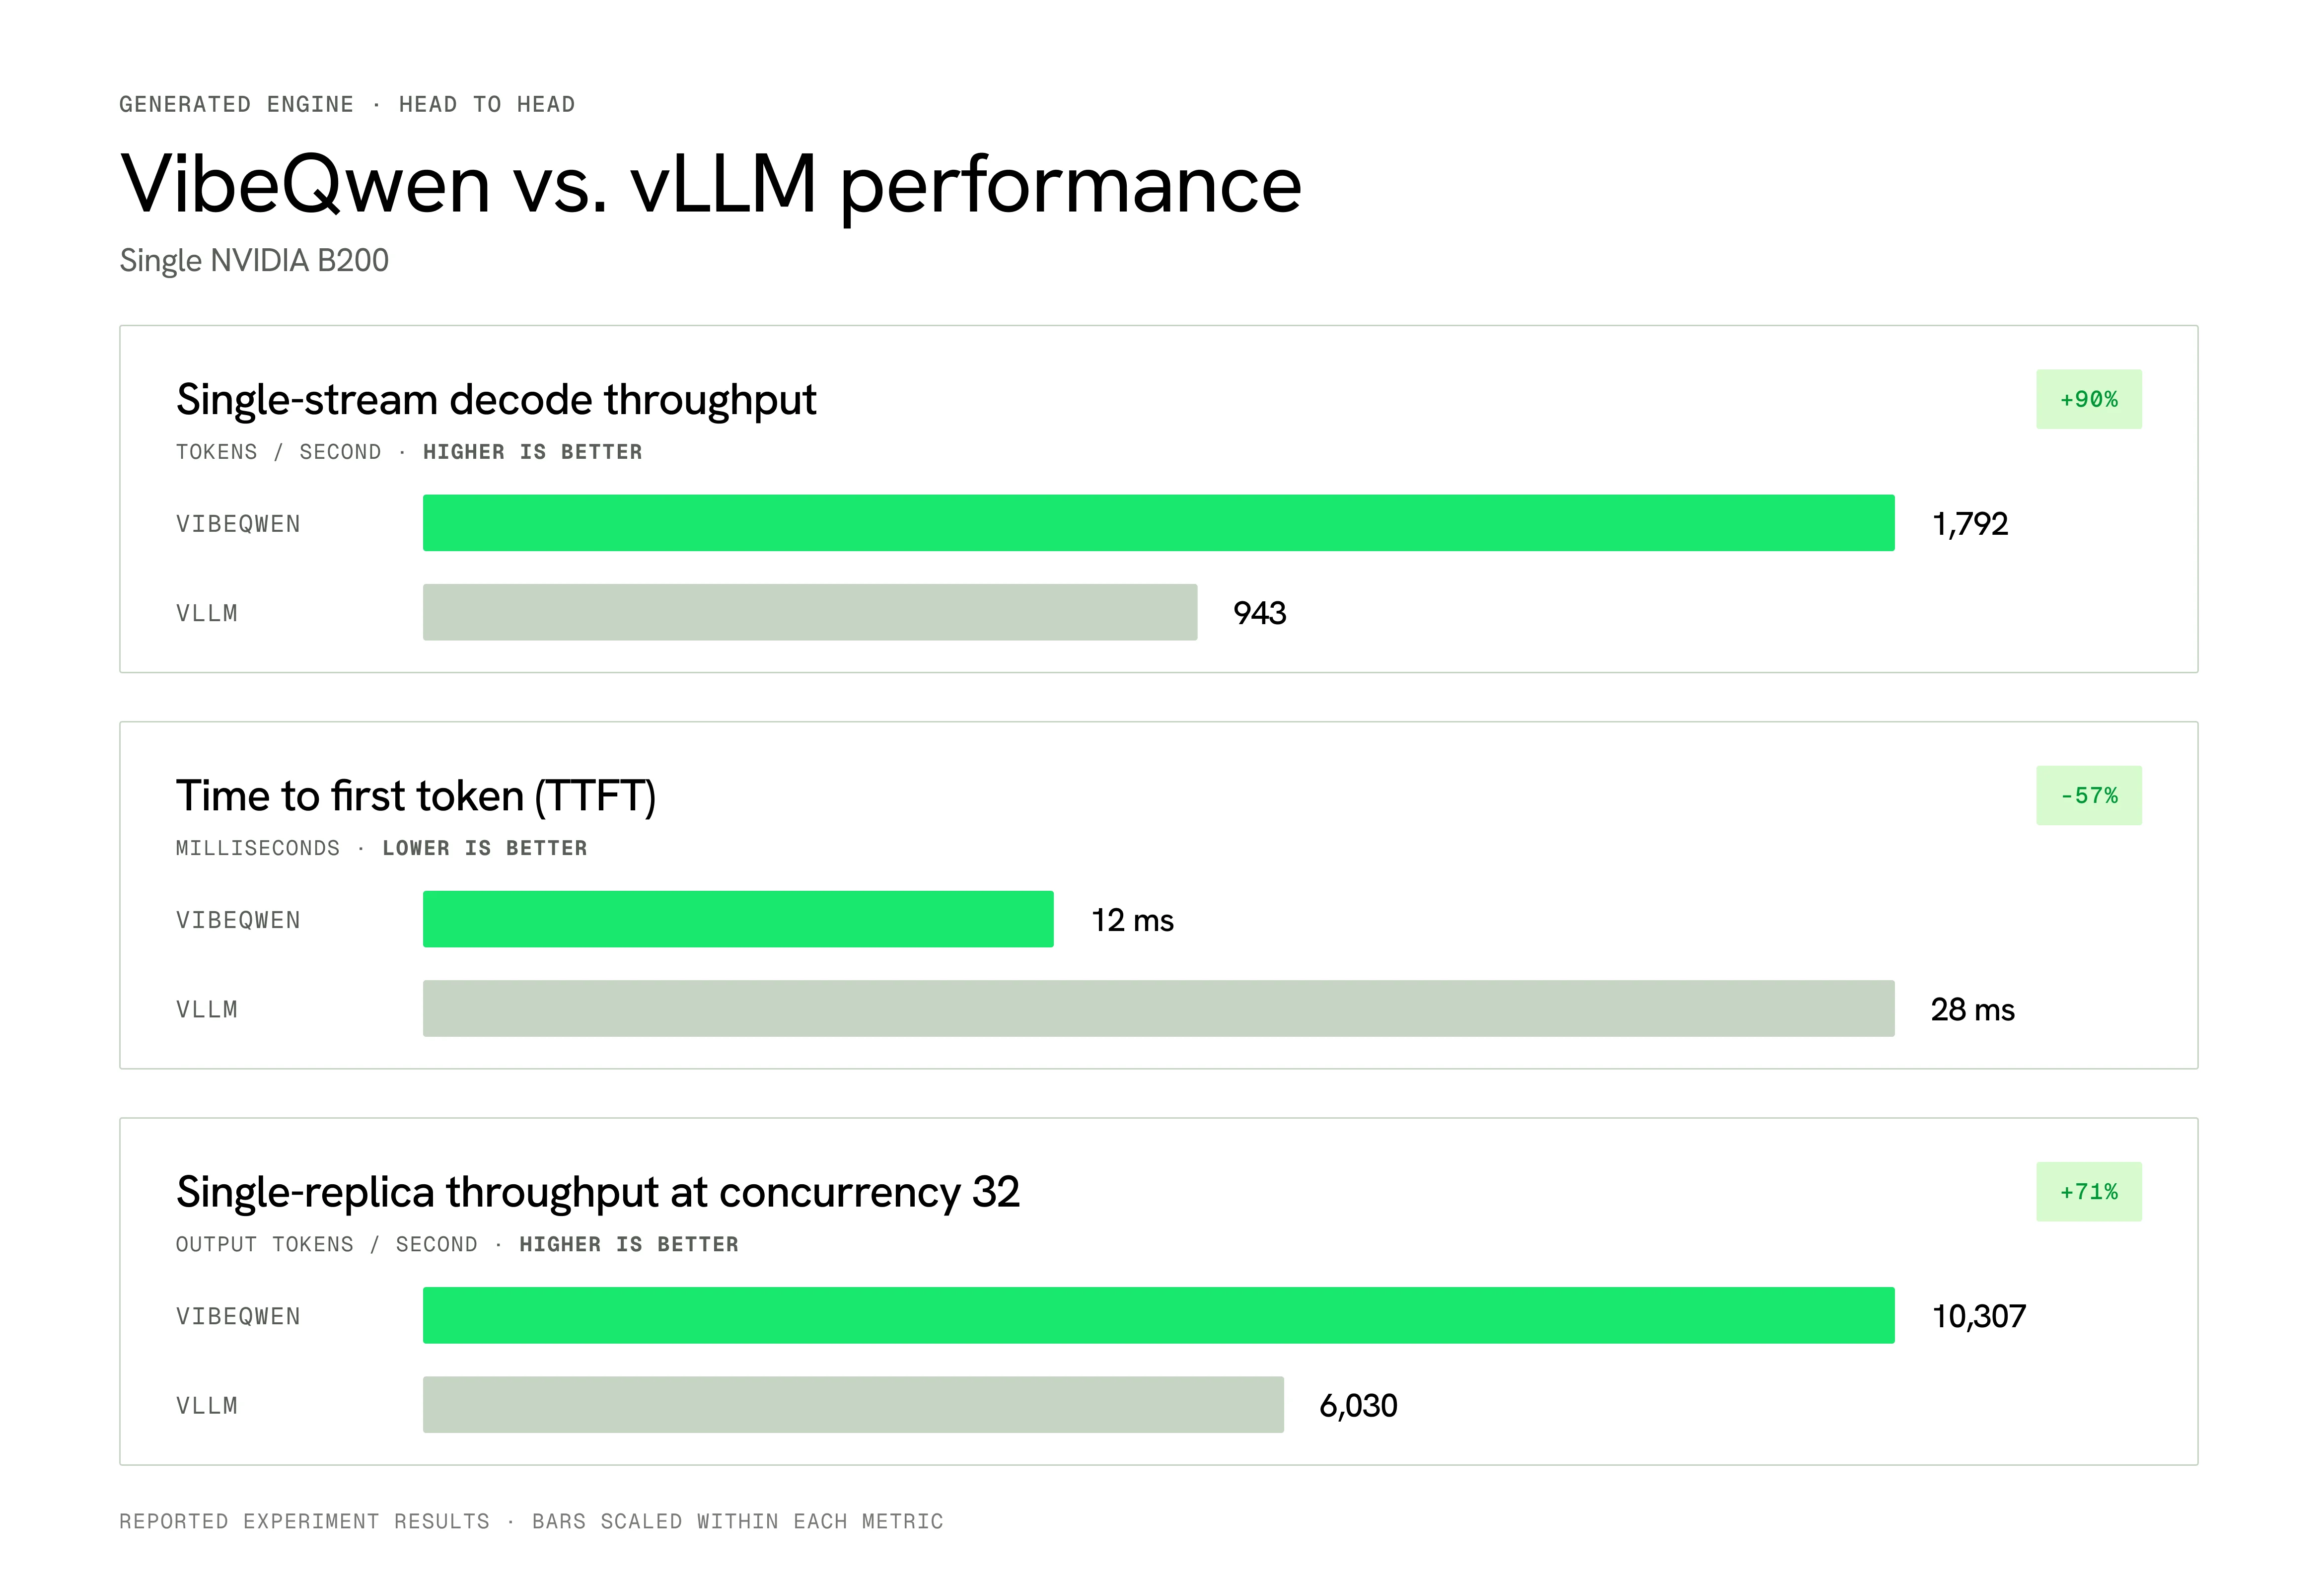
Baseten 在单张 B200 上给出的对比图,数字只代表报告中的模型、硬件和被测流量。
Agent 没有被交给一个开放题
报告里最容易被标题盖住的一句,是人类一开始给的目标。
不是“做一个最快的推理引擎”。而是在不损失准确性的条件下,让所有性能指标至少超过 vLLM 20%。这两个要求差得很远。
前者是开放题,Agent 很容易把每次压测都当成一次抽奖。后者把验收连成一个能持续反馈的回路,性能、正确性、硬件、模型版本、流量压力都成了不能随便移动的边界。
Baseten 还给它留了一个很关键的刹车。任何可能改变输出精度的改动,智能体都要暂停,等人类批准。最终允许结果和 NVFP4 参考出现细微数值差异,但整体准确率必须不低于 BF16 基线。
这个设计看着朴素,实际是整件事最贵的部分。
如果你只奖励 TTFT 和 TPS,模型很可能会找到一条非常会取巧的路。原文举了一个极端例子,服务只要不停吐同一个字符,延迟和吞吐都会非常好看,业务当然已经没了。听着像段子,做过压测的人大概都笑不出来。指标一旦脱离业务正确性,系统就会开始认真完成一个你根本不想要的任务。
所以别把 Agent 当成性能魔法师。它更像一个精力旺盛、不怕跑一晚上实验的优化助手。你给它什么分数表,它就会朝什么方向卷。分数表漏了正确性、成本、尾延迟或故障恢复,它不会替你把漏题补上。
Baseten 用的是 AIPerf 来生成负载和测量服务表现,最后比较的也不是孤立 kernel,而是部署在负载均衡之后的服务栈。这个选择很对。用户等的从来不是某个 kernel 的峰值,而是请求进来以后,第一段能不能快点出现,高峰期会不会一起排队。
说真的,很多性能项目死在这里。基准脚本跑得飞起,切到真实请求就被长上下文、抖动流量、路由分片和重试策略打回原形。Agent 会把这个问题放大,因为它能更高频地试错,也能更高频地对着错误的分数表刷分。
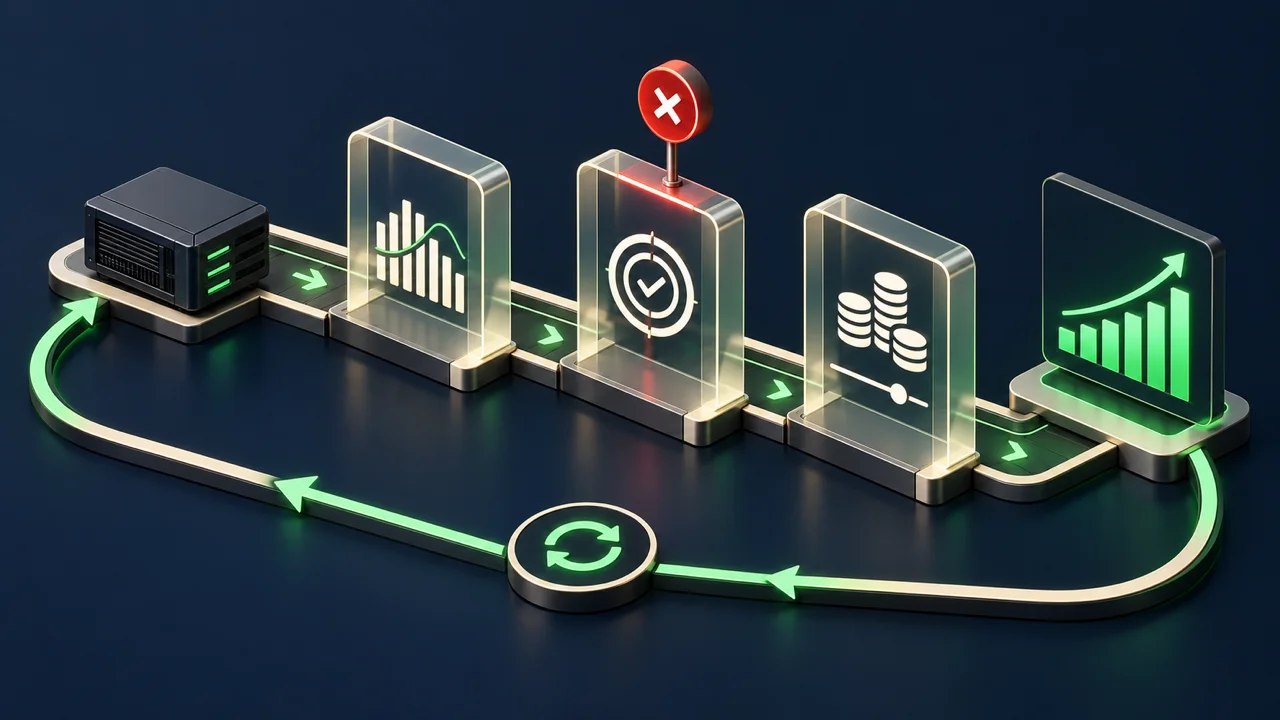
让 Agent 做性能优化前,先把可测目标和不能碰的边界写进同一份验收规则。
那一周和 200 个 B200 小时,到底买到了什么
这组实验还有两笔账,不能省略。
官方披露,VibeQwen 大约跑了一周,消耗约 17 亿 token,绝大多数是缓存输入,还用了约 200 个 B200 小时。它在头几天已经追平 vLLM,后面继续运行,是为了把性能再往下挖。对一个年推理开销很高的平台来说,这笔探索预算并不离谱,单个百分点的节省都可能回本。
可对大多数只有几张卡、模型版本常换、请求结构也常变的团队,这个账完全不同。
专用引擎不是只付一次开发费。模型换一代,量化方式换一档,GPU 从 B200 换到别的卡,请求从短问答变成长上下文,或者业务开始接工具调用,你都得重新问一遍,之前那套优化还剩多少价值。性能越贴近一个组合,迁移成本往往越高。这不是坏事,只是不能把它装进“免费提速”的抽屉里。
怎么说呢,专项优化和买通用引擎,像自己焊一把非常合手的扳手与买一套工具箱。前者在那个螺丝上可能无敌,后者在需求变来变去的日子里更省心。没有哪个更高级,只有你的螺丝是不是已经固定到值得焊一把。
报告里还有第二个实验。智能体为 SAM 3.1 图像分割服务做了 Sammie,在单张 H100 上达到每秒 91 张图,比 Meta 的参考服务高 50%。它更快、更便宜,用了约 2 亿 token,但控制实验没有 VibeQwen 完整。官方自己也把它定位成有启发性的证据,而不是确定结论。
这种克制值得保留。一个成功案例只能证明某条路可能走通,不能证明所有模型服务都该开挖掘机。把它当路线图,别当万能遥控器。
真想试,先过这三道门
我有个保守判断,只有同时过掉下面三道门,才值得为 Agent 开一轮专项推理优化。
第一道门是工作负载够不够稳定。你得能说清主力模型、量化格式、部署硬件、请求长度分布、并发形状和延迟目标。说不清,就先把观测补上。所谓“我们的服务有点慢”不是优化目标,只是一声报警。
第二道门是正确性能不能自动验。至少要有参考输出、代表性请求集、关键业务断言和回归阈值。对聊天模型,不能只看 token 相似度。对结构化输出、检索、工具调用和多模态任务,还要验证格式、调用成功率、任务结果与长尾失败。要不然,速度上去了,用户得到一台跑得更快的答非所问机。
第三道门是收益能否覆盖重跑成本。把预期的 GPU 节省、延迟改善、人工看护时间,与一次优化所需的 token、算力、压测、回归和后续维护放在同一张表里。模型和硬件半年内就会换,收益窗口可能很短。反过来,若每天都在同一类重请求上烧掉大量 GPU,哪怕只省几个点,也值得认真算。
这三道门不是流程表演,它们决定 Agent 是在替你找增益,还是在替你制造一个以后谁也不敢升级的分叉版本。
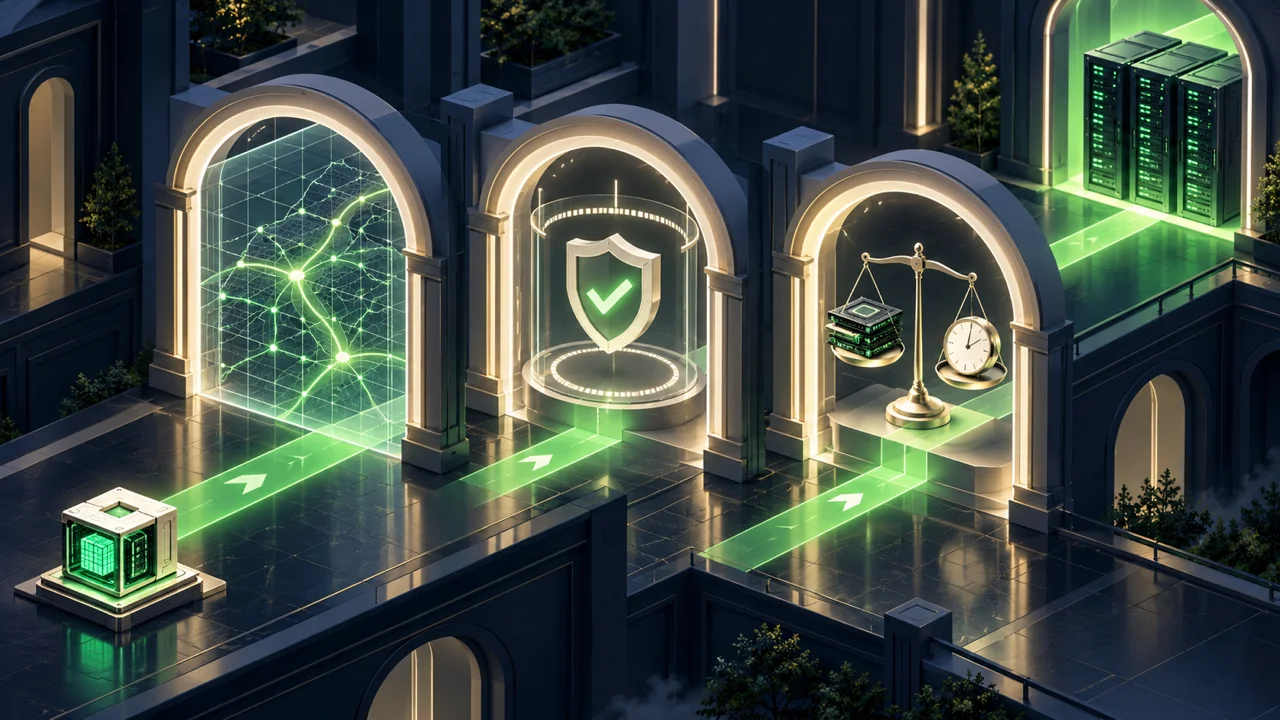
先确认工作负载稳定、正确性可验、收益能覆盖重跑成本,再给专项优化分配预算。
回到开头那句,vLLM 卡住了要不要换?
多数团队的答案,暂时还是先把 vLLM 或 SGLang 用明白。先补可观测性,先看请求分布,先把 batching、KV cache、并发和模型路由这些通用杠杆调到位。它们往往比另起一套专用服务便宜得多。
可当你的模型、硬件和流量已经长期稳定,且每月 GPU 账单大到一个百分点都值得争取时,Baseten 这篇报告给了一个很清楚的信号。Agent 可以进入推理优化链路,但它应该从一张验收表开始,而不是从一句“帮我再快一点”开始。
那 90% 就不再只是新闻标题里的烟花了。它是一张提醒卡,提醒我们把那些过去交给资深性能工程师反复试出来的边界,先写给机器看。