
AGENTS.md 该写在哪一层?拆开 pi 的系统提示词拼装线
全局一份、仓库一份、子目录再一份,这些规则最后怎么拼成一段系统提示词?pi 的做法是设置覆盖、规则拼接、越近越靠后。顺带讲清一件小事,它为什么把今天的日期从提示词里删掉了。
pi 的提交记录里,有一条 commit 只有一行。
remove current date from system prompt。
从系统提示词里,把今天的日期删掉。
我第一反应是,这也值得单独提交?日期这东西,塞在提示词里一行字,模型知道今天几号,写日志、算时间都方便,删它干嘛。
这个问题先放着,文章最后回来说。要讲清楚它,得先看 pi 的系统提示词是怎么一块块拼出来的。
这是「Pi系列」的第五篇,拆 pi 的配置分层。如果你给 Claude Code 写过 CLAUDE.md,或者给 Codex 写过 AGENTS.md,这篇大概会让你重新想一想,那些规则到底该写在哪。
一份配置,管不了一个人
先想一个很常见的处境。
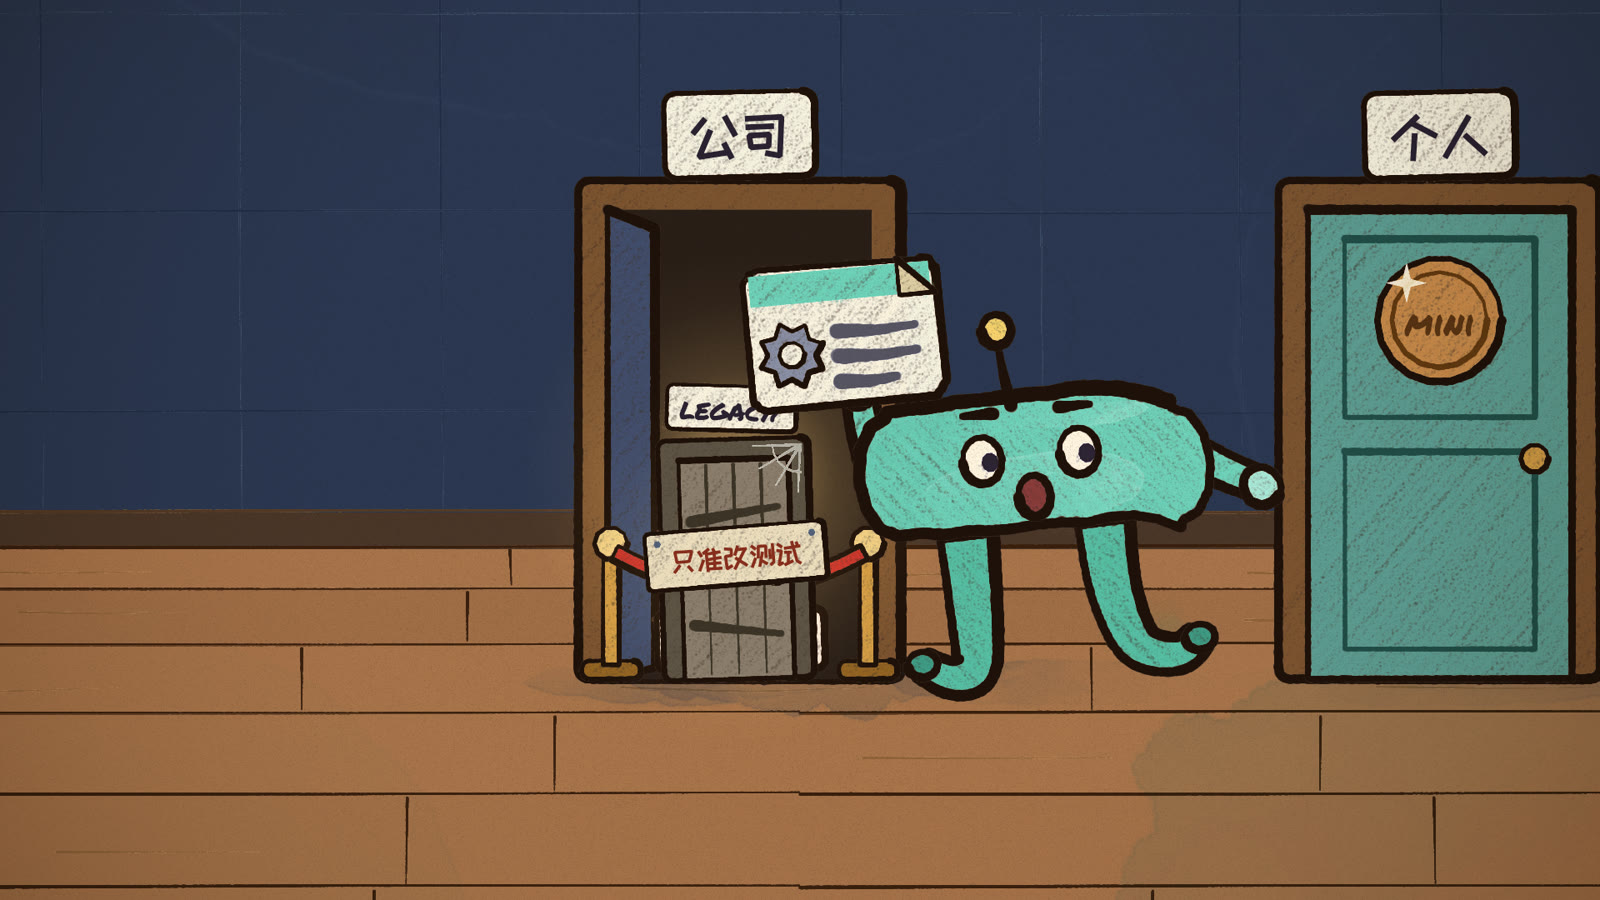
同一个人,公司项目用 Claude,思考强度开到最高,而且不许碰部署目录。个人项目换个便宜模型凑合用。公司仓库里还有个老目录,年久失修,只准改测试文件,别的一律不许动。
一份配置文件,管不了这么多。
pi 的答案是分层,全局、项目、目录,一层叠一层。但有意思的是,不同的东西,叠法不一样。
设置是覆盖,按格子覆盖
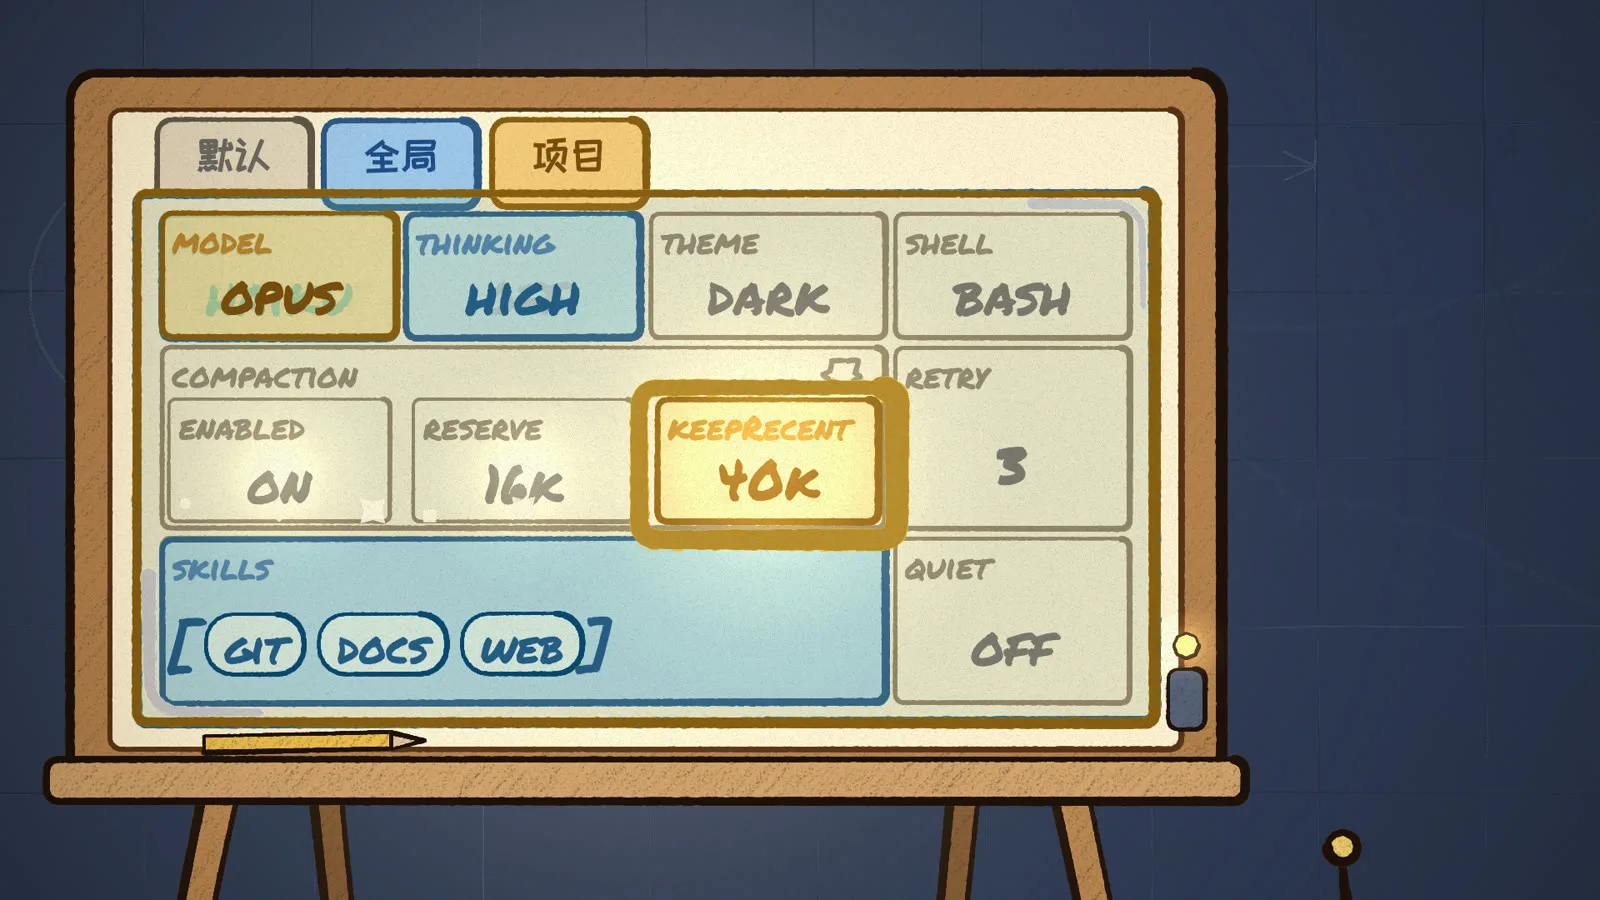
结构化的设置写在 settings.json 里。全局一份在 ~/.pi/agent/settings.json,项目一份在仓库的 .pi/settings.json。所有字段都是可选的,一个都不写,用默认值也能跑。
两份怎么合并,看这个函数
// 摘自 pi v0.66.0 packages/coding-agent/src/core/settings-manager.ts,有删减
function deepMergeSettings(base, overrides) {
  const result = { ...base };
  for (const key of Object.keys(overrides)) {
    const overrideValue = overrides[key];
    const baseValue = base[key];
    if (overrideValue === undefined) continue;

    if (isPlainObject(overrideValue) && isPlainObject(baseValue)) {
      result[key] = { ...baseValue, ...overrideValue };   // 嵌套对象,逐项合并
    } else {
      result[key] = overrideValue;                        // 普通值和数组,整个换掉
    }
  }
  return result;
}(isPlainObject 是我为了好读合并的写法,原文是一长串 typeof 和 Array.isArray 判断。)
规则就三条。项目覆盖全局。嵌套的设置逐项合并,比如全局设了压缩的三个参数,项目只改其中一个,另外两个照旧,只改你关心的那一格。列表不合并,项目里写了就整个换掉。
顺手看到一个小细节。函数上方的注释写的是 nested objects merge recursively,递归合并,实际代码只展开了一层。所以设置嵌套到第三层的时候,就不是逐项合并了。这种注释和代码对不上的情况,在任何项目里都挺常见,读源码的乐趣之一。
命令行参数还能临时再盖一层,走的是 applyOverrides,只改内存里的设置,不写回文件。今天临时换个模型,明天打开还是原样。
规则是拼接,越近越靠后
设置管的是开关和数值。写给 agent 看的规则,比如用什么命令跑测试、代码风格怎么定、哪些目录不许碰,放在 AGENTS.md 里。
这一层的叠法完全不一样。它不覆盖,是拼接。
// 摘自 pi v0.66.0 packages/coding-agent/src/core/resource-loader.ts,有删减
function loadContextFileFromDir(dir) {
  for (const filename of ["AGENTS.md", "CLAUDE.md"]) {   // 每层只认一个,AGENTS.md 优先
    if (existsSync(join(dir, filename))) return { path, content };
  }
  return null;
}

function loadProjectContextFiles({ cwd, agentDir }) {
  const contextFiles = [];
  const globalContext = loadContextFileFromDir(agentDir);   // ~/.pi/agent 下的全局规则
  if (globalContext) contextFiles.push(globalContext);

  const ancestorContextFiles = [];
  let currentDir = cwd;
  while (true) {                                            // 从当前目录一路往上找到根
    const contextFile = loadContextFileFromDir(currentDir);
    if (contextFile) ancestorContextFiles.unshift(contextFile);  // 越往上越排前面
    const parentDir = resolve(currentDir, "..");
    if (parentDir === currentDir) break;
    currentDir = parentDir;
  }
  contextFiles.push(...ancestorContextFiles);
  return contextFiles;
}
从当前目录一路往上找,每一层有 AGENTS.md 就收下,没有就看看有没有 CLAUDE.md。找到的文件用 unshift 插到前面,所以最后的顺序是,全局在最前,然后是离你最远的祖先目录,最后是当前目录。全部生效,一个都不丢。
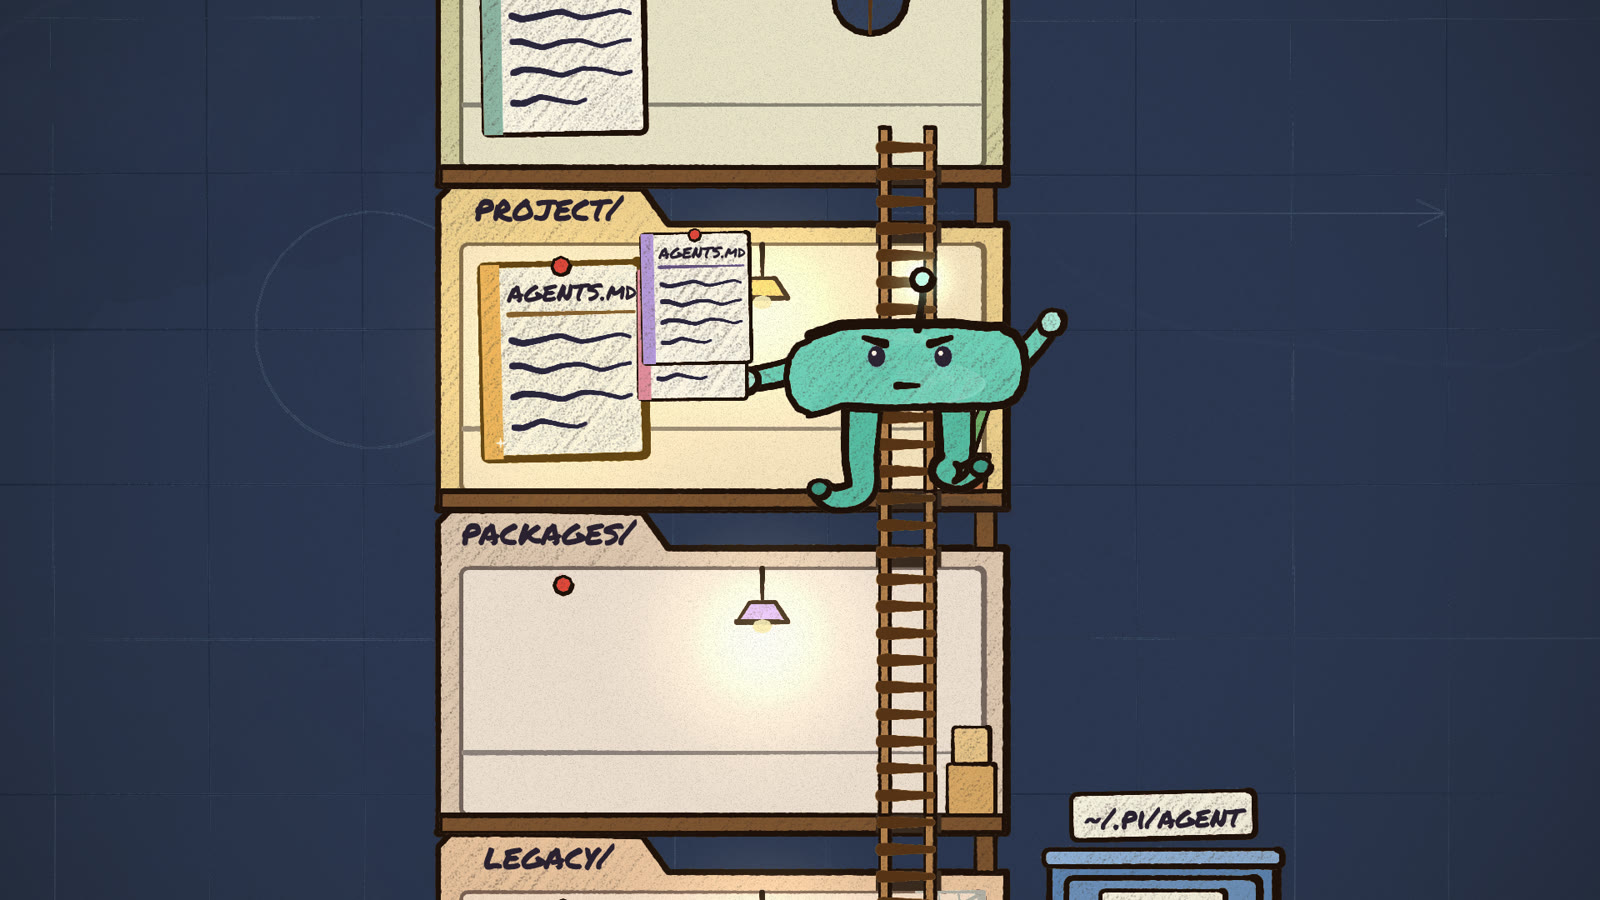
好家伙,它连 CLAUDE.md 都认。你给 Claude Code 写的那份规则,搬进 pi 不用改名。
还有两个特殊文件,行为又不一样。SYSTEM.md 会整个替换默认的系统提示词,pi 自带的那段开场白就没了。只想补几句的,用 APPEND_SYSTEM.md,追加在默认提示词后面。这两个文件项目里的优先,项目 .pi/ 下没有,才去全局目录找。
最后装配成一段话
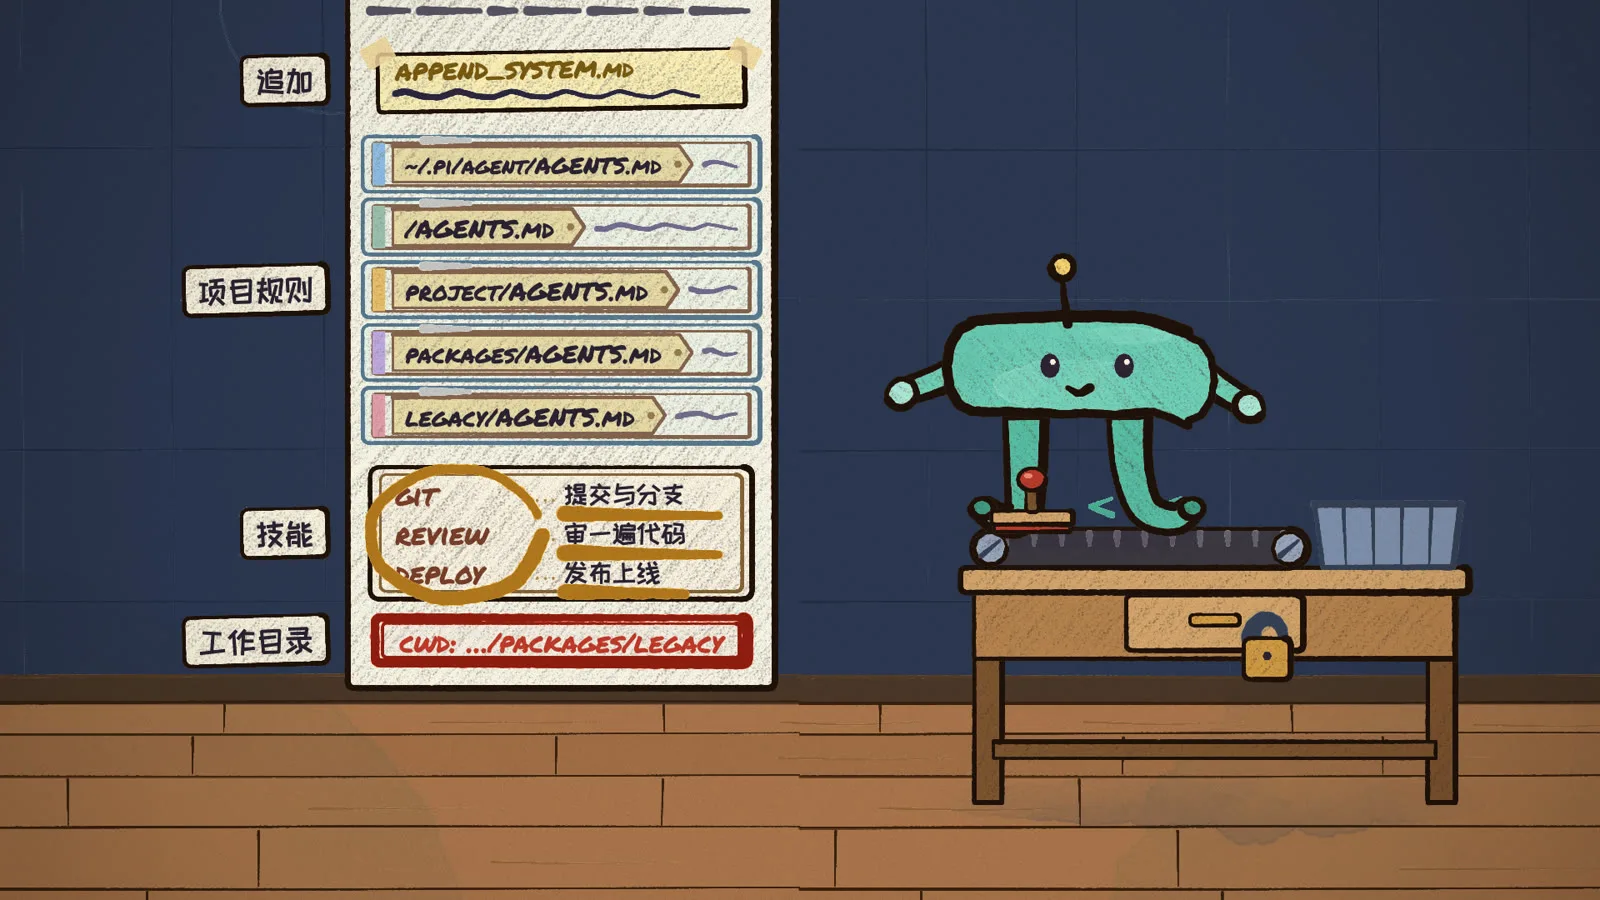
这些材料最后交给 buildSystemPrompt,拼成一整段系统提示词。拼的顺序是这样的
// 摘自 pi v0.66.0 packages/coding-agent/src/core/system-prompt.ts,有删减
let prompt = customPrompt ?? defaultPrompt;          // SYSTEM.md,或者默认开场白
if (appendSystemPrompt) prompt += `\n\n${appendSystemPrompt}`;

if (contextFiles.length > 0) {
  prompt += "\n\n# Project Context\n\n";
  for (const { path: filePath, content } of contextFiles) {
    prompt += `## ${filePath}\n\n${content}\n\n`;    // 每份规则标明来自哪个文件
  }
}
if (hasRead && skills.length > 0) prompt += formatSkillsForPrompt(skills);

prompt += `\nCurrent date: ${date}`;                 // 日期和工作目录压在最后
prompt += `\nCurrent working directory: ${promptCwd}`;
基础提示词,追加文本,项目规则,技能清单,最后是日期和工作目录。
几个细节挺有意思。
每份规则前面都带着它的文件路径,模型能看出这条规矩是从哪个目录来的。后来的版本把这里的 ## 标题换成了 <project_instructions> 这样的 XML 标签,路径写在标签的 path 属性里,提交说明里的理由是边界更清楚,模型不容易把两份规则读串。
技能只列名字、用途和文件位置,全文不进提示词。模型判断用得上了,再用读文件工具去读。这样装一百个技能,提示词也不会胖到哪去。
还有顺序。离你最近的目录规则排在最后。一般的经验是,越靠后的内容模型越重视,所以最具体、最贴近手头工作的那条规矩,放在最后压轴。
陌生仓库,先过一道闸
这里有个安全问题,v0.66.0 还没管,后来的版本补上了。
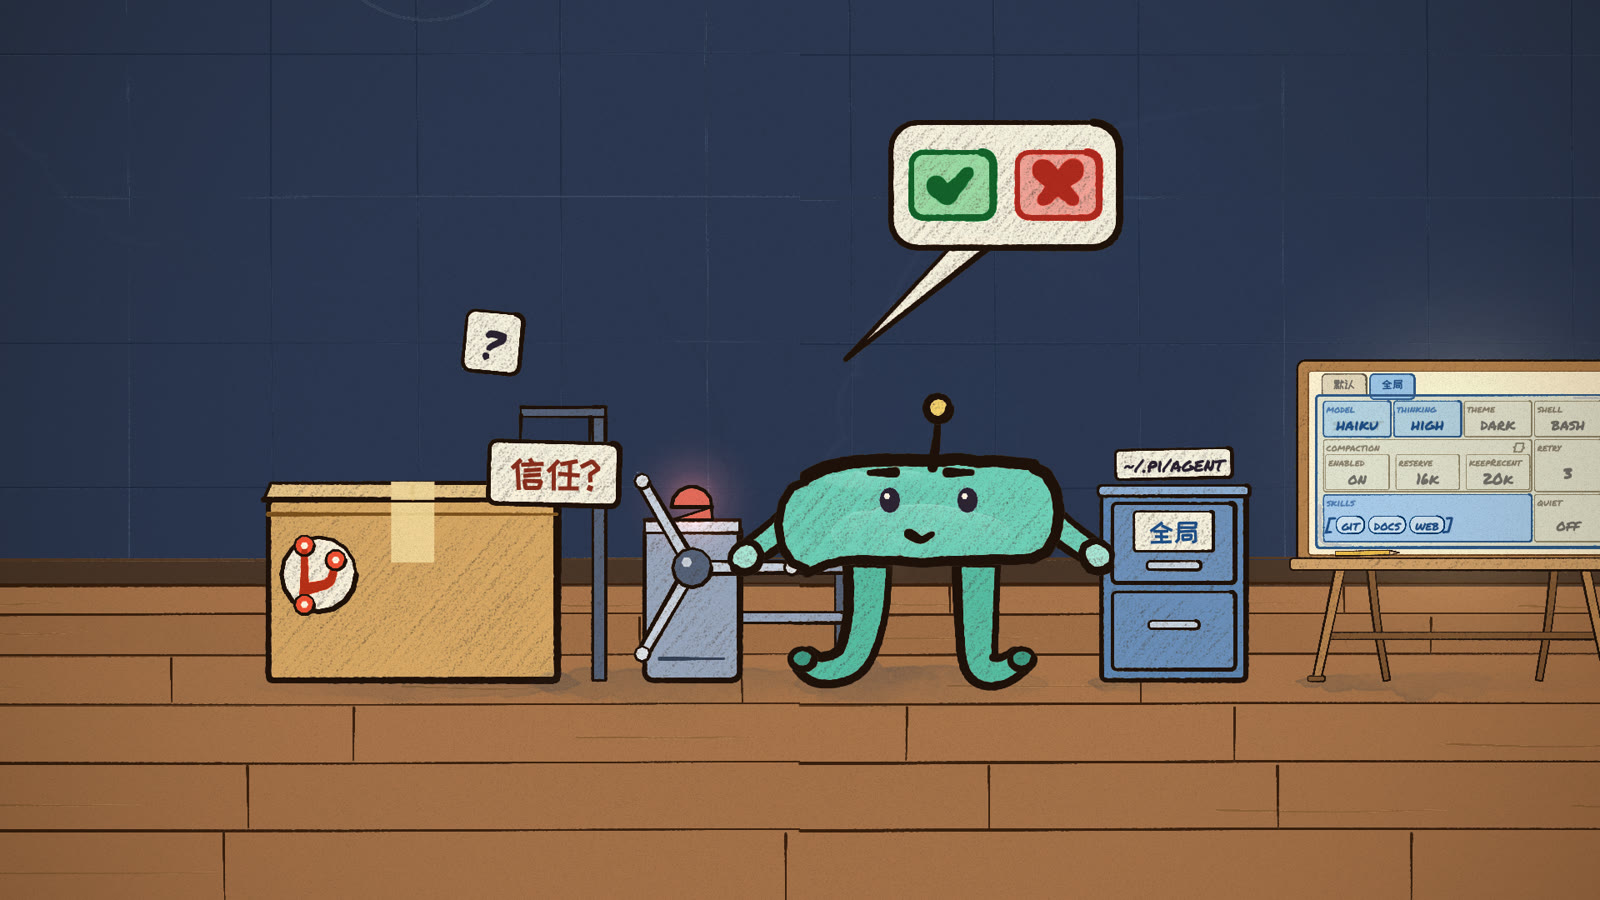
项目配置能做的事不少。settings.json 能指定要装的扩展,扩展是能执行的代码,SYSTEM.md 能改写模型的开场白。你克隆一个陌生仓库,一启动 pi,就可能执行别人预置在 .pi/ 里的东西。
2026 年 6 月,pi 加了项目信任闸门。仓库里带着这些东西的时候,默认先问你信不信任
// 摘自 pi 主分支 packages/coding-agent/src/core/trust-manager.ts(v0.66.0 之后新增)
const TRUST_REQUIRING_PROJECT_CONFIG_RESOURCES = [
  "settings.json", "mcp.json", "extensions", "skills",
  "prompts", "themes", "SYSTEM.md", "APPEND_SYSTEM.md",
] as const;
你的回答记在 ~/.pi/agent/trust.json 里,也就是你自己的全局目录,不放在仓库里。道理很简单,要是信任记录跟着仓库走,别人在仓库里预先写一个已信任,闸门就形同虚设了。
回到那个被删掉的日期
现在可以回答开头的问题了。
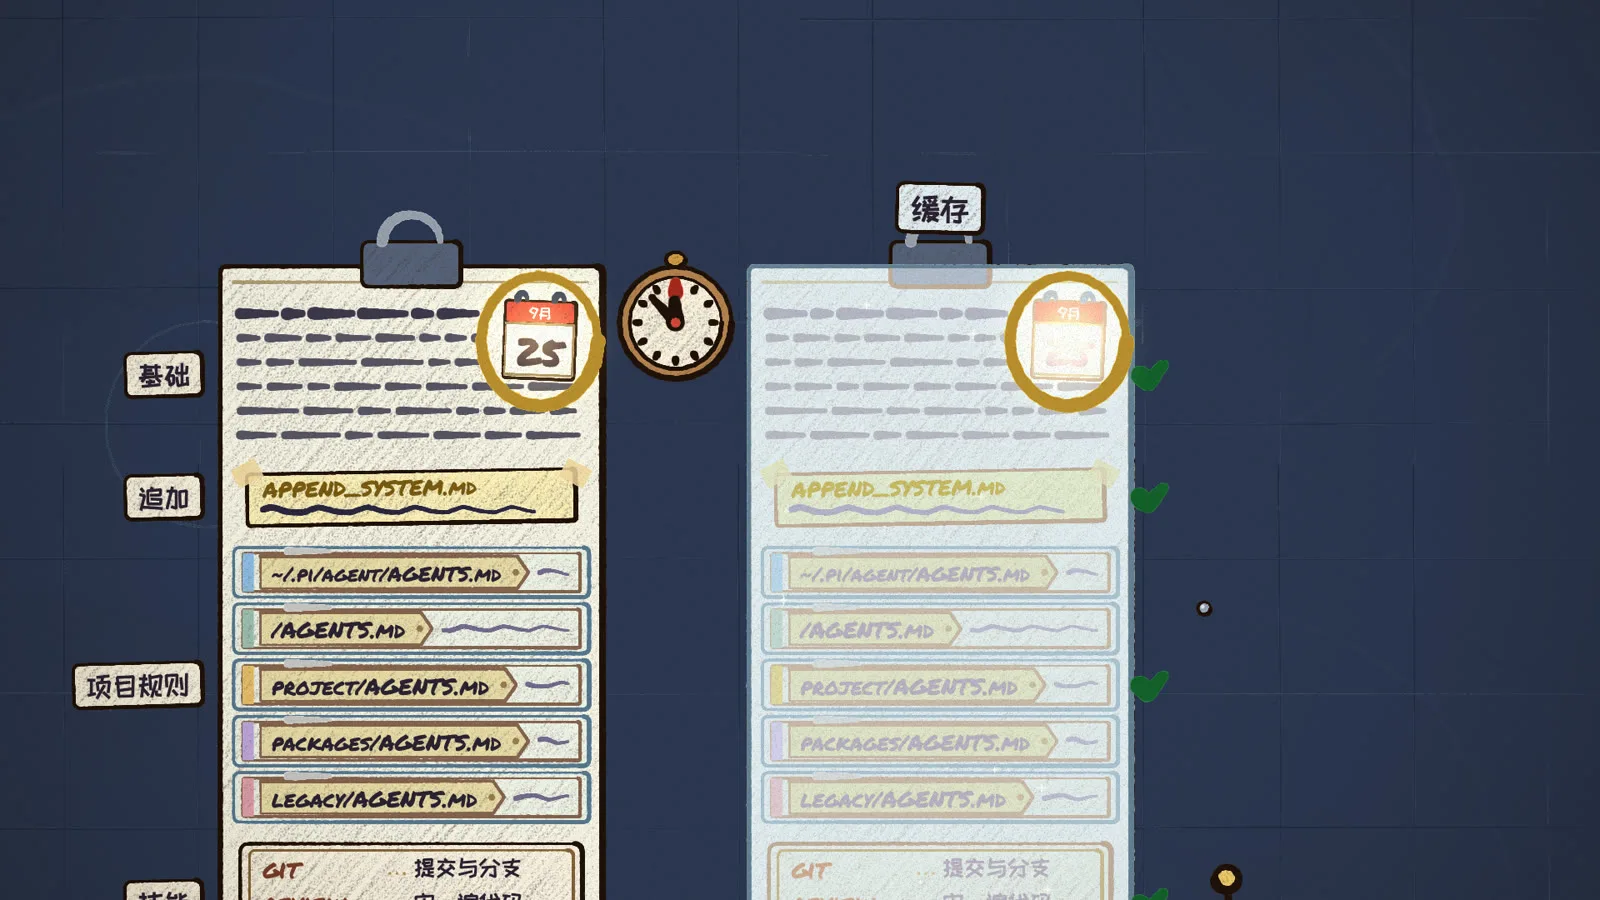
大模型的接口大多支持提示词缓存。同样的开头,第二次请求就不用重新算,又快又省钱。但缓存是按前缀算的,开头改一个字,后面全部作废。系统提示词恰好在最前面。
日期每天一变。v0.66.0 的提示词最后一行写着 Current date,跨过零点,整段缓存就作废一次。
这事在 issue 里吵过两轮。2026 年 3 月的 #2131,有人抱怨提示词里带着时间,每次 /reload 都把整个会话的缓存打掉,当时的修复是只留日期、去掉时分秒。到了 7 月的 #6621,一位在本地机器上跑模型的用户算了一笔账,他的设备读提示词只有每秒一两百个 token,在 25 万 token 的上下文上丢一次缓存,要等差不多 20 分钟才能重新读完。
于是日期被整个删掉了。那条只有一行的 commit,就是这么来的。
一行字,二十分钟。这个账我看完挺服气的。
你的 AGENTS.md 可以这么分
拆完 pi,我觉得最能带走的,是这套分层的思路。不管你用 pi、Claude Code 还是 Codex,写规则文件时都可以照着分。
全局那份,写你个人的偏好,回答用中文、提交信息的格式、你习惯的代码风格。这些跟着你走,不跟着项目走。
仓库根目录那份,写这个项目的事实,怎么装依赖、怎么跑测试、目录结构、团队约定。这些是所有人进这个仓库都该知道的。
子目录那份,只写这个目录特有的规矩,比如那个老目录只准改测试。它排在最后,离手头的工作最近,也最该被模型看重。
还有一条,是从那个日期学来的。规则文件里别放每天会变的东西,今天的待办、时间戳、临时的备注。规则越稳定,缓存越能命中,你的每一轮对话都更快也更便宜。
当然有代价。配置从好几个地方来,全局、祖先目录、当前目录、命令行,出了问题得挨个去查到底是哪一层说了算。换来的,是一个工具,适应你所有的项目。
下一篇拆模型那一层。pi 用一个接口接了二十来家模型,对话聊到一半换个模型,之前的记忆还在,它是怎么做到的。
你现在的 CLAUDE.md 或 AGENTS.md,是一份大文件,还是已经分层了?
这个系列的内容,我还做成了一套彩铅动画,13 集,每集两三分钟,一集讲透一个设计决定。今天这篇对应第 9 集,规则怎么一层层叠、提示词怎么拼起来,动起来看会更直观。
课程在 B 站课堂,预告和前两集可以免费看。
本文基于 pi v0.66.0 源码,文中标明的信任闸门、XML 标签和删除日期三处,来自之后的版本与公开 issue,新版本如有变化,以源码为准。讲解脉络参考了开源书《pi 的设计艺术》,想系统深入的推荐直接读原书。