
让 AI 参与研究后,论文里最该留下哪几条证据
Meta 公开了数学家与 Muse Spark 协作的六篇论文。比「模型会不会做研究」更值得学的是,他们把谁提出问题、谁起草、谁复核、哪些工作独立完成都留成了可检查的记录。
当一篇研究里出现了 AI,最容易被问的通常是。
“这到底算谁做的?”
这个问题听上去有点像署名八卦,其实一点也不轻。你把一份模型参与过的技术报告交给客户,或者把一篇人机共同写出的论文交给同行,别人真正想知道的不是它的文风像不像人,而是结论是怎么来的,谁检查过,错了又该追到哪里。
Meta 在 10 月 2 日公开了数学家与 Muse Spark 协作的六篇论文,其中五篇回答了此前公开的研究问题。这个新闻当然很大。开放研究不是做一道已有标准答案的竞赛题,走错方向很正常,甚至推到一半还得掉头。
但我看完最在意的,不是“模型能不能证明定理”这个热闹问题。
而是 Meta 在材料里留下了什么。
数学家选问题、引导探索和发展论证。
另一组数学家复核。
论文标出主要由研究者起草和主要由 AI 起草的段落。
既有工作和同题独立工作也被明确署名。
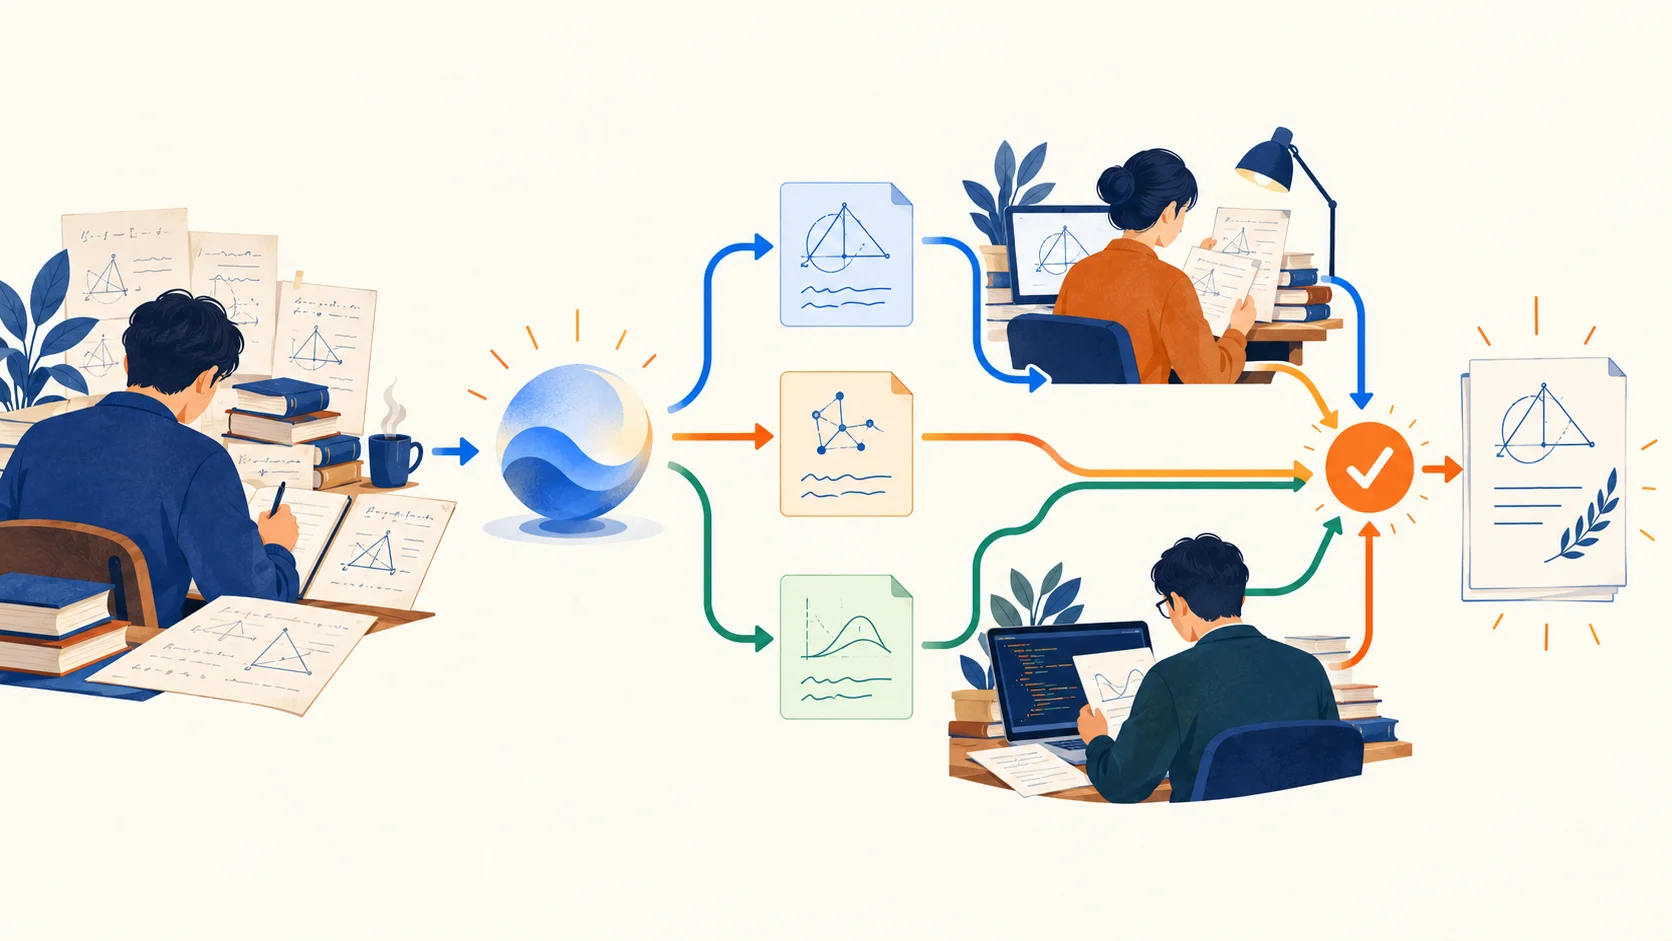
示意图。模型可以把候选路径铺开,结论仍要经过人类复核与材料追溯才进入交付。
厉害了。一个模型能力发布,居然先把证据链摆在台面上。
研究成果不是一段漂亮结论
很多人已经习惯让模型参与研究。它能帮你整理文献、写分析脚本、找反例、推候选公式、补一版报告。真正危险的阶段往往发生在交付前半小时,大家把一堆很顺的文本和图表拼起来,准备说“结论已经出来了”。
这时最容易丢的,恰好是结论身后的来路。
输入是哪些公开资料和数据。
哪一步是模型生成的假设,哪一步已经经过验证。
哪位专家在什么地方推翻或修改过它。
有没有别的团队在相近时间独立做出了同题结果。
模型写得越流畅,这些记录越不能省。它把中间过程抹得很平,人就会误以为一个结果从头到尾都很自然。其实研究最有价值的部分,常常就是那些被否掉的路线、发现的漏洞和重新定义的问题。
Meta 的官方说法很克制。研究团队不是让 Muse Spark 单独产出论文,而是通过普通 meta.ai 聊天界面使用 1.1 和 1.2 的 Thinking Mode,没有定制研究脚手架。官方也承认,项目完成后发现 Meta 外部团队已经用不同方法独立公布过部分同题解法,并在论文里标注了这些关系。
这个处理比抢一句“我们先解出来了”靠谱得多。科研不是抢答器。尤其面对公开问题,时间线、推导路径和独立贡献本身就是结论的一部分。
官方图展示的是六个方向。更值得带走的,是每个方向背后都要能说清人和模型分别做了什么。
一个 384 阶反例,最适合拿来当验收样本
在群论那篇论文里,团队反驳了一个 2024 年提出的猜想,找到一个 384 阶群作为反例。这个数字很具体,正好能把“模型参与研究”从一句口号落回动作。
官方材料写得很清楚,Muse Spark 生成了用于搜索反例的 GAP 程序。数学家核验结果并完成论证,另有两位数学家审阅。与此同时,Nilradical 智能体在 9 月 16 日已报告另一种反例,Meta 的论文将该工作说明为独立完成。
这里面没有魔法,反而有一套很硬的分工。
模型可以生成搜索程序,快速翻可能的结构。
研究者决定问题值不值得问,判断候选反例是不是正中要害。
审阅者负责从另一个视角找推导缺口。
公开材料负责把先前和并行工作放进正确位置。
这四件事,缺任何一件都可能让一个漂亮答案变得站不住。不是哥们,模型找到了一个数值例子,并不自动等于理论命题被证明。反过来,人类看过一遍也不是终点,复核要能回到原始计算、程序版本和推导步骤。
Meta 另一个案例里,模型帮助连起数论与 p 进弦理论,生成候选证明并起草三个核心技术章节,之后仍由研究者核查、更正和润色。这种表述比“AI 发表论文”朴素得多,也可靠得多。谁参与了什么,谁对哪一步负责,别留给读者猜。
给人机协作成果留一张证据单
不只有做数学的人需要这个。产品团队拿模型分析用户行为,工程团队让模型协助排故,咨询团队用模型起草重要判断,都会碰到同样的问题。结果能不能交付,不只看成稿那一句话,还要看它能不能被接住。
下一次你们准备把模型参与过的成果交出去,可以把下面这张单子贴到评审里。
问题与边界
原始问题是什么,哪些结论不在本次材料的覆盖范围内

材料来路
模型看过哪些数据、文献、代码和假设
哪些材料不能被外部复查,原因是什么

人机分工
模型生成了候选、代码、推导还是正文
人负责了哪些判断、修改和最终结论

独立复核
谁在没有沿用原始提示词的情况下检查过关键步骤
复核覆盖了计算、事实、推导还是表达

并行与归属
已有工作、相似公开结果和并行发现如何引用
贡献者与模型参与的边界如何标注

可复现入口
数据版本、代码提交、运行环境、随机种子或计算记录在哪里
哪些结果还没有独立复现
写这张单子时,最重要的不是让页面看起来更严肃。是给团队留下一句能抵抗自我催眠的话。
“这部分我们还不知道。”
独立复核也别做成“再让另一个模型看一遍”。那只是在同一层不确定性上又铺了一层文字。真正的第二视角,至少要能接触原始材料、重跑关键计算,或者从没有看过原始提示词的角度追问假设。Meta 的案例里,第二组数学家复核正是在承担这个角色。它不保证结论永远正确,却把错误有机会被发现的门留在了交付之前。
研究里最贵的不是不知道,而是不知道却把它包装成已经知道。模型很擅长把空白处补得很圆滑,人更要主动留下空白的边界。
有人会担心,这么多记录会拖慢探索。确实会多一点步骤。可把记录放在结尾才补,通常更慢。那时你已经分不清哪个版本的脚本找到了候选,谁改过关键条件,哪段文字只是模型的草稿,哪段才是研究者认可的论证。
把证据写进过程,反而能让模型继续大胆探索,人也敢更快地否掉不可靠的路。前者负责发散,后者负责让结论落地。这俩角色都很重要,别混成一锅。
Meta 的六篇论文未必能立刻回答所有人对 AI 科研的担心。官方发布也不能取代同行评审和独立复现。但它至少给了一个正确的起跑姿势,别急着把模型推到作者席中央,先问研究里留下了哪些别人能检查的脚印。
如果你们团队已经让模型参与分析或研究,现在最难补齐的是哪一环,分工记录、独立复核,还是可复现入口?