
给 Agent 换开源模型:816B Muse Spark Open 的三条接入路
Meta 放出了 816B 的 Muse Spark Open。开放权重不等于一台笔记本就能跑:从托管 API 到 1TB 本地部署,先按数据边界、成本和上下文规模选路。
想给 coding agent 换一个能自己掌控的模型,最容易踩的坑不是模型效果,而是把“开放权重”看成“下载下来就能用”。
Meta 这两天公开了 Muse Spark Open:816B 总参数、每个 token 激活 42B、原生支持图像/视频/音频输入,上下文窗口到 100 万 token。它的目标很明确:编程、长任务 agent 和复杂软件工程。
这几个参数当然很有吸引力。一个 agent 如果能把大仓库、需求文档、截图和工具输出放进同一条工作流里,少做几轮“把旧上下文塞回去”的搬运,体验会好很多。
但“权重公开”后,真正要回答的不是“要不要下载”,而是:你的 agent 要解决的是数据边界、稳定调用,还是把模型真正跑在自己机器上? 三个问题,对应三条完全不同的路。
第一条:只是想让 Agent 能用,先走托管推理
如果你的目标是给现有的代码助手、内部问答或工作流加一个可选模型,托管 API 往往是最短路径。Meta 已列出 Baseten、Fireworks AI、Groq、Modal、Nebius、OpenRouter、Together AI 等托管入口。
这条路的优点很朴素:不需要为模型权重、驱动、调度和故障恢复另起一套基础设施。你需要做的是把模型层抽成一个 provider,把超时、重试、上下文上限和费用统计放在同一个接口后面。模型换了,工具调用和验收链路别跟着散架。
真正值得先验证的是三件事:
- 你的任务真的需要 100 万 token,还是把 20 万 token 的噪声也一并塞进去了?
- 代码、日志和附件能否发往外部服务?哪些目录、密钥和客户资料必须在请求前剥离?
- 输出变长后,工具调用轮次和失败重试会不会把单任务成本推高?
把这三项写进一次灰度配置,比在第一天就讨论“最强开放模型”更有用。长上下文的价值是少丢信息,不是获得一张无限大的垃圾桶。
一个很实用的做法,是先给模型层一张“不能越界”的任务单:只挑 10 个真实但已脱敏的任务,里面既有改动小的 bug、跨文件重构,也有工具调用失败后要恢复的场景。每个任务都记录输入长度、总 token、工具调用次数、测试结果和人工接手分钟数。别只盯模型回答得像不像;对 agent 来说,能否在失败后停住、留下可复现的状态,往往比第一次写得多快更值钱。
灰度期还可以强制三条默认值:上下文先按任务类型给上限,而不是默认开到 1M;涉及写入、发消息和外部请求的工具继续要求确认;主模型超时或连续两轮工具报错时,退回一个已验证的模型或人工队列。这样即使新模型很强,也不会把一次发布变成整条流水线的单点故障。
还有一个常被参数表盖过去的问题:模型能力提高后,agent 很可能会主动读取更多文件、规划更长的步骤、发起更多工具调用。你原来按“每次补全”设的限额,到了长程任务里未必还成立。灰度时把任务拆成“读仓库”“提出方案”“执行改动”“验证结果”四段,给每段单独设时间和费用预算;任何一段越界,都让它留下摘要后停住。这样团队拿到的不是一台会无限加速的机器,而是一台知道什么时候该交棒的工具。
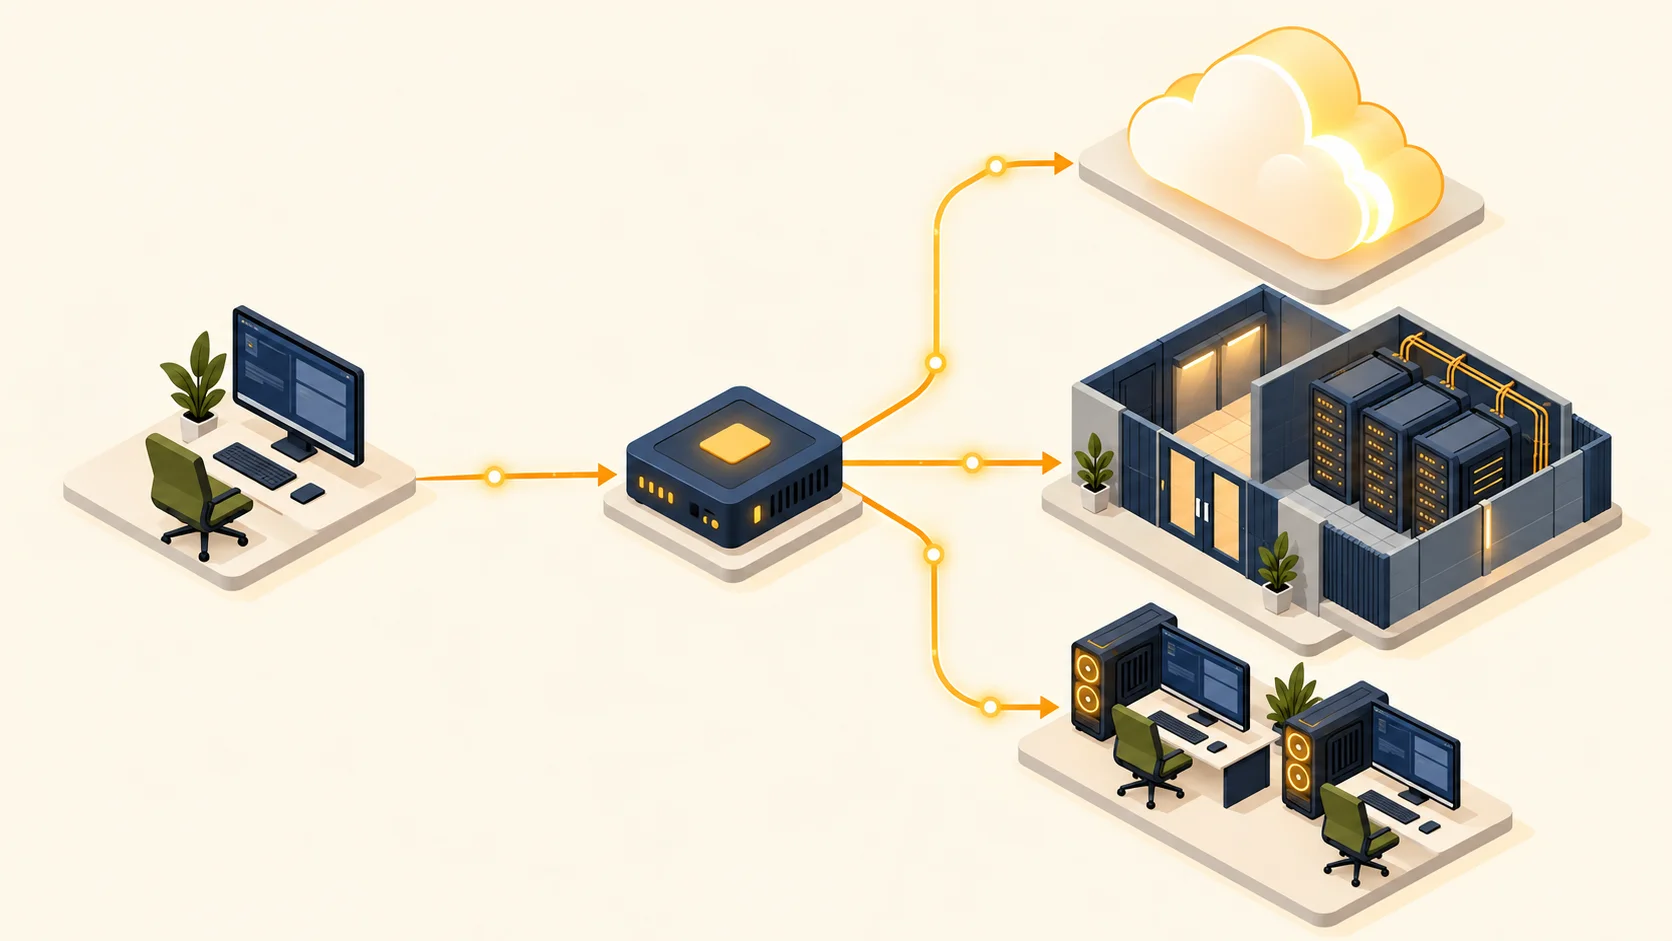
先选数据和运维边界,再选模型进入生产的路径。
第二条:数据不能出边界,再考虑受控部署
有些团队确实不能把代码、设计稿、客户文档或内部工单交给外部推理端点。这个时候,开放权重的价值才开始变得具体:你可以把推理服务放进自己的网络和权限体系,让审计、网络出口、密钥和保留策略跟现有环境对齐。
Muse Spark Open 官方列出了 SGLang、vLLM、TensorRT-LLM、Transformers、MLX、llama.cpp、Unsloth 等推理栈。名单很长,但不要把“有运行时支持”误读成“部署工作已经完成”。推理框架解决的是把 token 跑起来;你还需要决定模型版本怎么锁定、请求日志在哪里留存、出现异常时哪个服务接棒。
一个能被 agent 稳定调用的自建服务,至少还要补上四层:
- 准入层:谁能调用、哪些仓库和文件能进上下文、工具权限如何收紧。
- 服务层:排队、并发、超时、流式中断和回退模型不能靠调用方各自处理。
- 观测层:记录 token、延迟、失败率、工具调用结果和版本,才能知道“换模型”到底改善了什么。
- 验收层:对代码任务至少保留构建、测试、静态检查和人工 review;模型换得再快,merge 的门槛不能撤。
最小的试点不必一上来承接全公司流量。挑一个低风险仓库或一类内部文档,限制并发,把可执行工具收成只读或测试环境写入;连续跑一周后,再看失败任务是否更容易定位、人工是否真的少接手、账单是否在预期内。三项没有一起变好,就别急着扩大部署面。
这也是为什么开放权重对企业的意义常常不是“更便宜”,而是“可被纳入现有控制面”。如果团队没有维护推理服务的能力,先托管、后迁移,通常比一开始就搭一套半成品集群更稳。
第三条:真要本地跑,先把硬件账算明白
Meta 的 Apple Silicon 演示很漂亮:两台 M5 Ultra Mac Studio、每台最高 512GB 统一内存,合起来提供约 1TB 统一内存来容纳模型。官方说这是把此类模型放到桌面上的一条路线。
这句话的重点其实在“两台”和“1TB”。它不是“任何 Mac 都能跑”的暗示,而是对本地部署门槛的一次很诚实的展示。
本地部署有三个常被忽略的成本:
- 容量:除了模型本身,还要给运行时、KV cache、并发请求和工具进程留空间。上下文开得越大,这笔账越不能只看模型参数。
- 带宽与吞吐:模型每一步都要读活跃专家。能装下不代表多人同时用时仍然顺滑。
- 运维时间:驱动、量化、版本兼容、故障恢复和监控,归根结底都会回到一个问题:谁来值班。
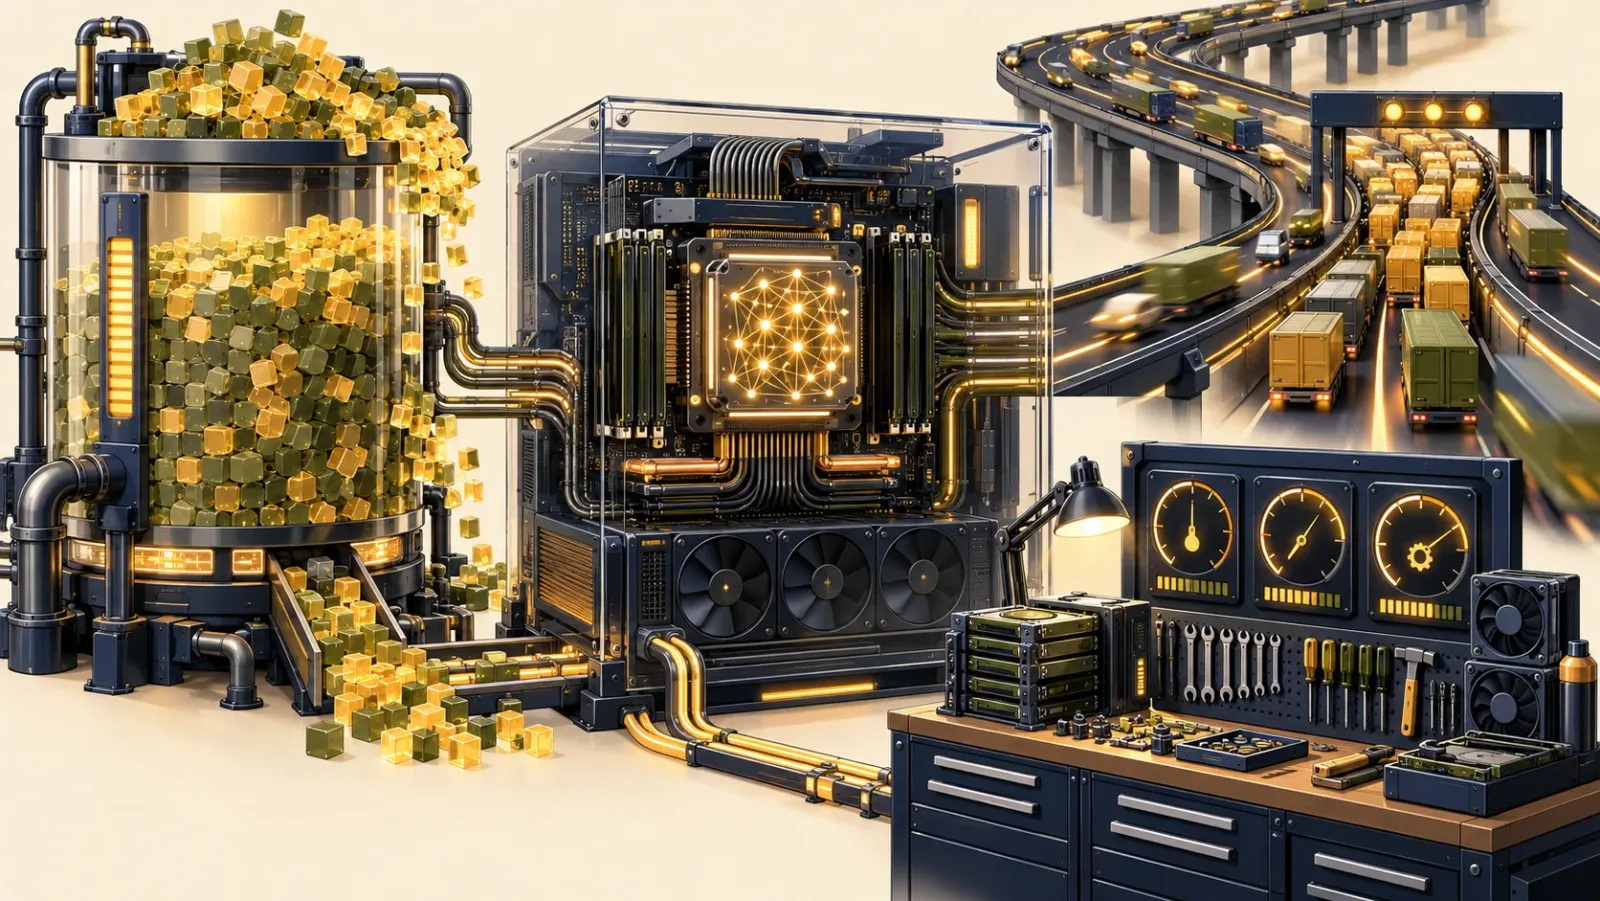
“放得下”只是本地部署的第一关;并发、上下文与恢复能力才决定它能否长期工作。
所以可以用一个简单判断来收束:
| 你的约束 | 更合适的第一步 |
|---|---|
| 想尽快给 agent 多一个强模型选项 | 托管 API,先做 provider 抽象和成本观测 |
| 代码和资料不能离开内网 | 在受控环境小流量部署,先补审计、回退与验收 |
| 有高配硬件且需要离线、深度定制 | 再评估本地部署与专人维护 |
这三条路也不是一次选定、永不改变。很多团队会先用托管端点验证任务价值,再把确定敏感、调用稳定的部分迁入受控环境;等硬件、维护人力和使用量都成熟了,才把本地部署当成长期能力。顺序可以变,前提是每一次迁移都有可比较的证据。
Muse Spark Open 的确给了开发者一个更大的选择空间:权重可下载、推理栈多、上下文长,还能处理多模态输入。它的 Muse Model License 仍然是带条件的许可,商业使用前应由法务或负责人核对具体条款;“开放权重”不是“什么场景都可以不经检查地拿去上线”。
我更愿意把这次发布理解成一次架构选择题:模型终于能选了,但数据去哪、谁来维护、失败时怎么退,仍然要由团队自己作答。
如果你正在给 agent 换模型,眼下卡住的是性能、数据边界,还是运维能力?
— 小岛AI