
本地跑模型,RTX Spark 笔记本的 128GB 值不值得买?
RTX Spark 笔记本今天开售,128GB 统一内存很诱人。但它真正解决的是模型、上下文和私有资料放不下的问题,不是把所有 AI 任务都搬回本地。
如果你最近想把代码库、内部文档,或者一个长对话 Agent 放到本地跑,最容易先撞上的不是模型能力,而是“装不下”。模型权重、KV Cache(模型为了继续理解长对话而保留的上下文缓存)、编辑器、浏览器和几个容器,很快就会把显存与内存挤成一团。
NVIDIA 今天让 RTX Spark 笔记本正式开卖,最抓人的数字是最高 128GB 统一内存。它看起来像是“终于能把大模型塞进笔记本”的答案。但买不买,先别盯着 1 petaflop、CUDA 核心和宣传页里的 Agent 名单。先回答一个更朴素的问题:你手里的活,到底是算得慢,还是根本放不下?
这两件事,差得挺远。
128GB 买到的不是一块更大的显存
传统笔记本上的独立显卡,显存和系统内存像两间分开的屋子。模型要住进显存,代码、浏览器、IDE 和数据集住在系统内存。模型一大,或者上下文一长,就开始搬家、卸载、量化,最后把一台机器调得像正在收纳搬家的出租屋。
RTX Spark 把 Grace CPU 和 Blackwell RTX GPU 放在同一颗超级芯片里,最高可用 128GB 统一内存。NVIDIA 的说法是:本地模型、创作任务和日常 Windows 工作可以在同一台便携设备上并行;官方也把本地大语言模型、智能体、超过 90GB 的 3D 场景和 8K 4:2:2 视频编辑放进了适用范围。官方发布材料在这里。
NVIDIA 发布材料里的 RTX Spark 笔记本主视觉。它展示的是平台能力,不是对具体机型、续航或软件兼容性的实测承诺。
“统一”不等于这 128GB 都能毫无代价地交给模型。系统、应用和显存共享同一个池子,内存带宽、散热、功耗和软件路径仍会影响体验;而且“最高 128GB”也不等于每个机型、每个地区都有这个配置。它更像给开发者多了一块可以灵活分配的工作台,而不是一张自动通关卡。
真正值得高配的人,通常有一个共同点:他们的问题已经不是“模型够不够聪明”,而是“本地工作上下文总被迫切断”。
还有一个容易被首发价格掩盖的事实:NVIDIA 给的是“2,599 美元起”,而不是“128GB 配置就是这个价格”。内存、存储、屏幕、地区税费与厂商机型会把实际预算拉开。看见“最高 128GB”时,先把它当成一个能力上限;等你确认模型与工作流确实需要它,再去比较那台具体机器的价格。
模型能放下,也不等于交互一定够快。首个 token 出来的速度、连续生成速度、检索等待、磁盘读写和工具调用,都会一起决定体验。官方的 1 petaflop FP4 指标有参考意义,但它不能替代你的模型、量化方式和真实任务的端到端测量。
先把你的任务放进这三格
我会用下面这张表先做筛选。它不是跑分榜,也不是购买建议;它只是把“要不要为 128GB 付钱”拆回你每天实际要做的事。
| 你的主要任务 | 高内存为什么可能有用 | 先别急着买的信号 |
|---|---|---|
| 在本地给代码库、合同、研发文档做问答或 Agent 原型 | 模型、向量库、长上下文和工具进程可以一起留在设备里,少一次把资料拆片或上传到云端 | 文档量不大、主要调用云端模型,或团队还没有明确的数据边界 |
| 反复调试长输出的代码 Agent | 更大的余量能减少模型、终端、容器和 IDE 之间抢资源;出差、内网或受限环境也更从容 | 任务大多由远程 CI、云端沙箱完成,本机只负责发起请求 |
| 做本地视频、图像、3D 与 AI 混合制作 | 统一内存让创作项目与本地推理不必立刻互相赶人,官方首日也把 Premiere、Photoshop、ComfyUI 等放进生态 | 主要工作流仍依赖特定 x86 插件,或没有确认 Windows on Arm 的驱动与素材工具兼容性 |
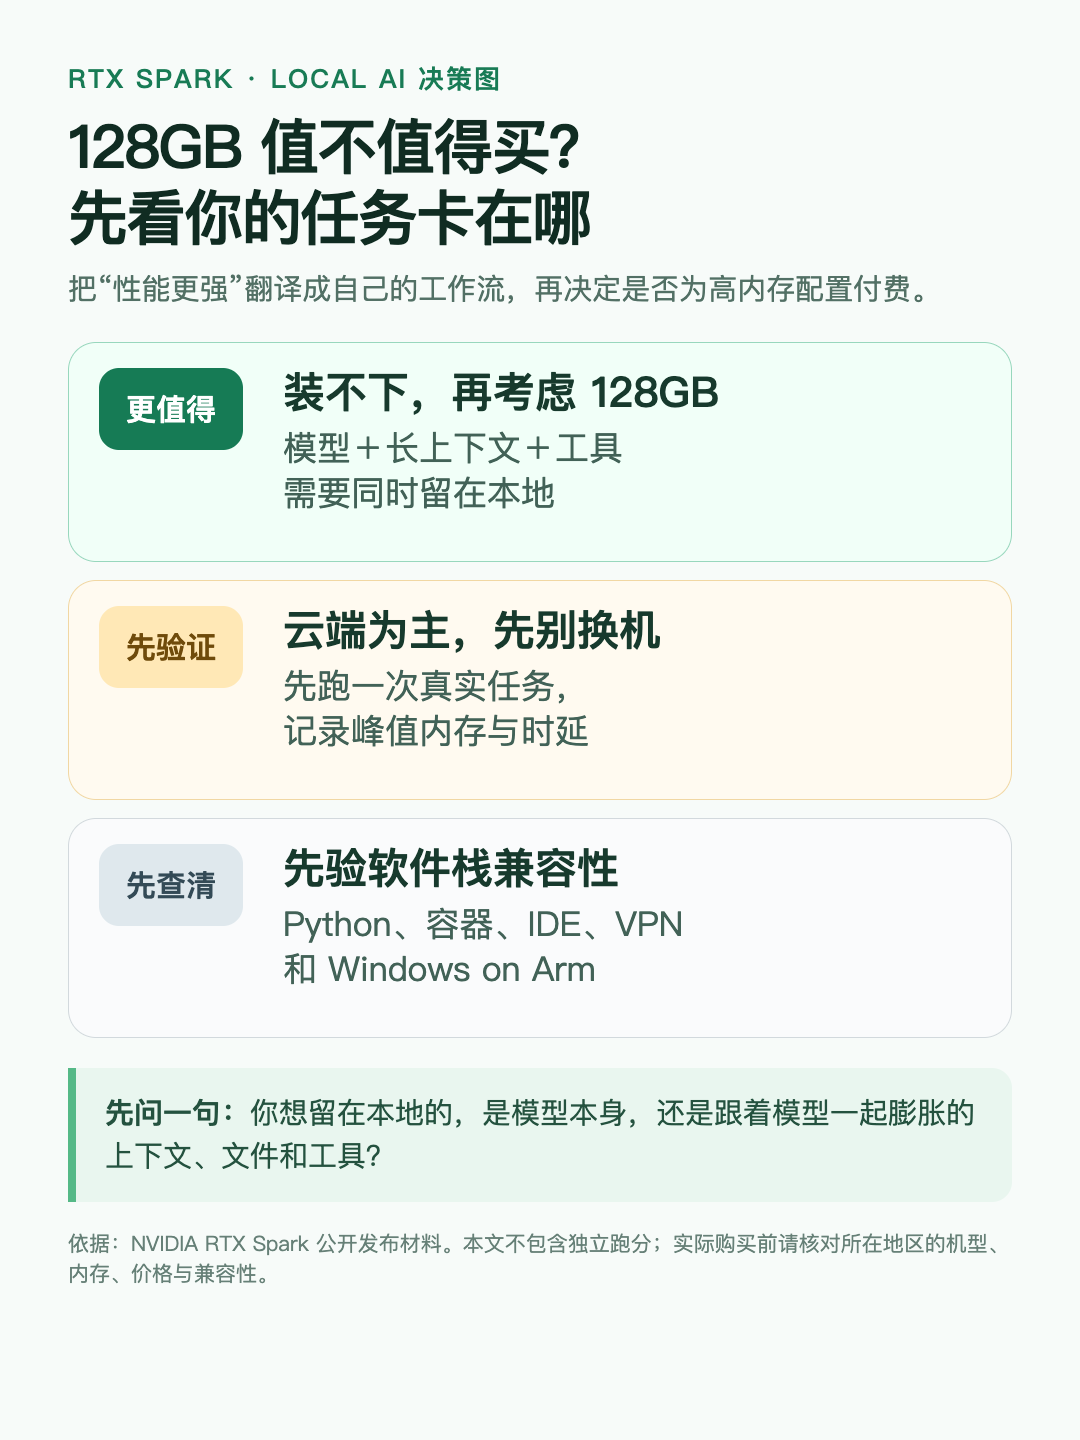
先从自己的工作负载出发,不用“最高配置”替你做判断。
表里最关键的是第二列。不是“模型参数越大越好”,而是你能不能把一条完整工作链留住。
假设你在本地跑一个会读代码、搜文档、调用命令行的 Agent。它需要的不只有模型权重,还要给当前仓库、检索结果、工具输出和多轮对话留出空间。内存不够时,最常见的体验不是报一个漂亮的 OOM(out of memory,内存不足)错误,而是:上下文被迫截断、缓存失效、模型换来换去,或者最后还是把敏感片段发去云端。
128GB 的价值就在这里。它让“本地优先”从一段演示文稿里的愿望,变成某些工作流可以认真评估的架构选项。
但这个判断要连着模型类型一起看。一个经过量化、上下文不长的模型,可能在远低于 128GB 的机器上已经能完成任务;反过来,模型本身能装下,也不代表系统还有余量留给检索、容器、浏览器和编辑器。购买前真正需要估算的是“峰值工作集”——模型、缓存、数据、工具和系统同时在场时,到底占了多少,而不是只查一条模型参数表。
如果你的任务允许把请求分开,混合工作流往往也更划算:私有文档先在本地检索和筛选,确实需要更强推理或协作能力的少数步骤再交给云端。RTX Spark 的意义并不在于替代所有云模型,而是给这种分流多了一个更宽的本地落点。
但别把它当成离线 AI 的万能答案
NVIDIA 在发布材料里列了 GitHub Copilot、Hermes、OpenClaw、Perplexity、Pi 和 WorkBuddy 等首日可用或可安装的 Agent,也提到 Windows on Arm 的 PyTorch-CUDA、原生 Python、Conda 和 WSL 支持。这个方向很重要:本地模型不是孤零零地跑一个聊天窗口,而是要接终端、接文件、接工具权限、接测试环境。
不过,软件栈刚起步时,兼容性往往比参数表更诚实。你现有的 Python wheel、Docker 镜像、IDE 扩展、浏览器自动化、公司 VPN,甚至一颗没有 Arm 构建的依赖,都可能比 GPU 算力更早把人拦在门外。
这也是为什么“官方首日支持”要逐项读。发布材料说有 Windows on Arm 的 PyTorch-CUDA、原生 Python、Conda、WSL,以及前 15,000 个 Python 包中 97% 的支持;这些是一个很好的起点,却不能替你的项目做兼容性验收。剩下的 3%,恰好可能是你训练脚本、图像处理链或公司代理绕不过去的那一个包。
所以别只问“它能不能跑 74B”。更有用的三个问题是:
- 我的目标模型、量化方式和上下文长度,真正需要多少内存余量?
- 我离线处理的数据,是否真的有隐私、网络或成本理由留在本地?
- 从编辑器、终端、容器到部署,哪些环节已经确认能在 Windows on Arm 上跑通?
第一个问题防止买了高配却只跑轻量任务;第二个问题防止把云端更擅长的活硬搬回来;第三个问题最现实——硬件到手当天,最容易卡住的经常不是模型,而是一条不起眼的依赖。
一个不花钱的预演办法
在下单前,先拿现在的机器做一次“本地优先演练”。选一个真实任务:例如给一份脱敏的项目文档做问答,或让 Agent 在一个小仓库里完成测试、修改和说明。把模型、上下文长度、工具调用次数、峰值内存、首次响应时间和总完成时间记下来。
接着故意把条件拉紧:多开一个容器,扩大文档范围,或者把对话延长到你平时会用的长度。你会很快知道自己的瓶颈是什么。
如果最先崩的是内存和上下文,RTX Spark 的高内存配置才有讨论空间;如果最先崩的是工具兼容、网络权限或任务验收,那先换机器,大概率只是把问题搬进一个更贵的包里。
NVIDIA 给 RTX Spark 的定位很明确:它想把 CUDA、本地模型、Agent、创作和 Windows PC 放到同一台机器里。这个方向值得关注,尤其对希望把代码与资料留在设备上的开发者。不过“最高 128GB”和“适合我”中间,还隔着一份工作负载清单。
你现在最想留在本地跑的,是模型本身,还是那堆跟着模型一起膨胀的上下文、文件和工具?
小岛AI
记录一线实战、踩坑与成长