
Claude Opus 5.5 fast mode 转正,生产流量别只看 2.5 倍
Fast mode 免申请了,但它只加快输出、不缩短首 token,还会切断缓存。把它接进生产,关键是路由、回退与观测。
一个会写长答案的 Agent 接进网页后,最磨人的时刻常常不是它多想了十秒,而是它已经开始回答,却一小段一小段地往外挤。代码改完后的解释、排障结论、长文档比对,用户盯着光标闪烁,系统看起来就像卡住了。
Anthropic 把 Claude Opus 5.5 的 fast mode 从研究预览里拿出来了。现在在 Start、Build、Scale 三个 usage tier 里,不用再申请访问,也不用再带 fast-mode-2026-02-01 beta header;请求里设置 speed: "fast" 就能使用。官方更新给出的承诺是:输出 token 的速度最高可到标准模式的 2.5 倍。
这个更新很容易被翻成一句“终于可以全开”。我觉得更准确的读法是:它终于可以进入正式路由表了,但还不该变成所有请求的默认路由。
因为 fast mode 不是更聪明的 Opus,也不是把整个请求都加速。它跑的是同一套模型权重,优势集中在 OTPS,也就是每秒吐出多少 token;首 token 时间(TTFT)没有同样的承诺。一个等待工具返回、等待数据库、等待远程网页的 Agent,瓶颈不在模型连续输出,打开 fast 很可能只是在更贵地等待别的东西。
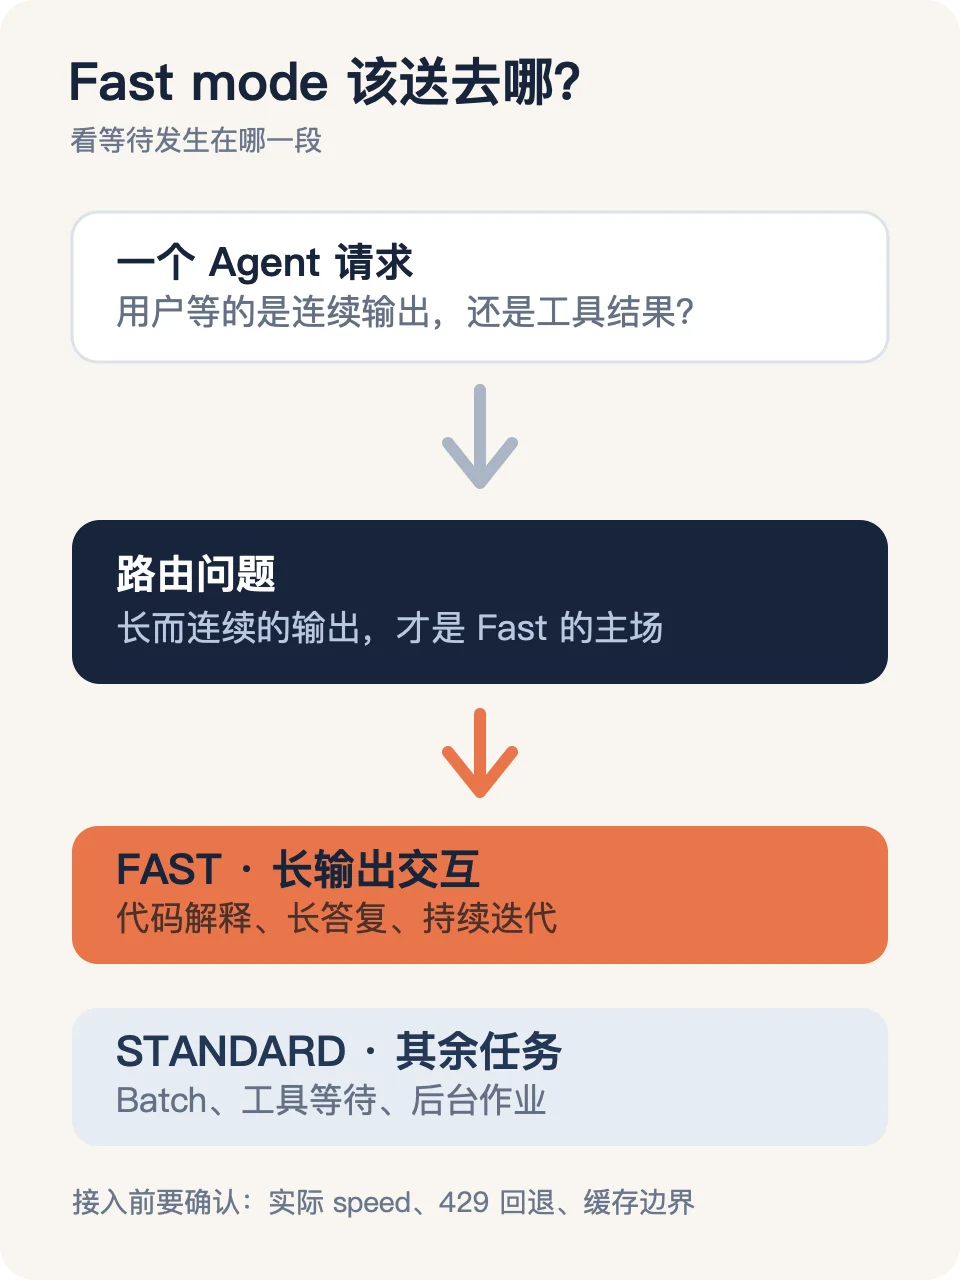
图:根据 Anthropic 公开的 Fast mode 适用范围整理。快的是持续输出,不是所有阶段都变快。
先分清:你在买的是哪一段等待
最适合 fast mode 的,是用户正在等一段较长、连续、可见输出的交互任务。比如让 Agent 把一次排障过程说清楚、把大 diff 的修改理由讲完整,或者在编辑器里反复生成和调整一段实现。这里每秒输出更快,用户确实能少盯一会儿屏幕。
但要是任务的大头在工具调用、搜索、构建、测试或多个 Agent 之间交接,别急着把 speed: "fast" 当万能旋钮。模型开始输出前已经被外部系统拖住时,OTPS 再高也救不了前半程的等待。官方也写得很直白:fast mode 不支持 Batch API;Priority Tier 和 Claude Platform on AWS 也不在支持范围里。完整限制在这里。
一个实用的分法,是别按“重要任务”或“大客户”分,而是按任务的时间形状分。交互式、长输出、用户在前台等待的请求,可以进入 fast 候选池;后台批处理、工具等待占多数的任务、可以稍后拿结果的工作,仍留在标准池。前者是在买体验,后者更该先看吞吐和总成本。
免申请,不等于没有容量边界
这次变化里,真正值得工程团队注意的不是 beta header 消失,而是 Opus 5.5 有了默认 Fast mode 限额。它和标准 Opus 的限流分开算,超出后 API 会返回 429 和 retry-after。如果调用方没把这件事写进路由策略,前台请求可能会从“更快”变成“在限流处排队”。
官方在响应头里提供了 Fast mode 输入、输出 token 的总限额、剩余额度和重置时间。别只记录一次调用花了多久,把这些字段连同 usage.speed 一起记下来。这样才能区分两种很不一样的情况:请求真的跑在 fast 上了,还是配置看起来开着,实际却退回了标准速度。
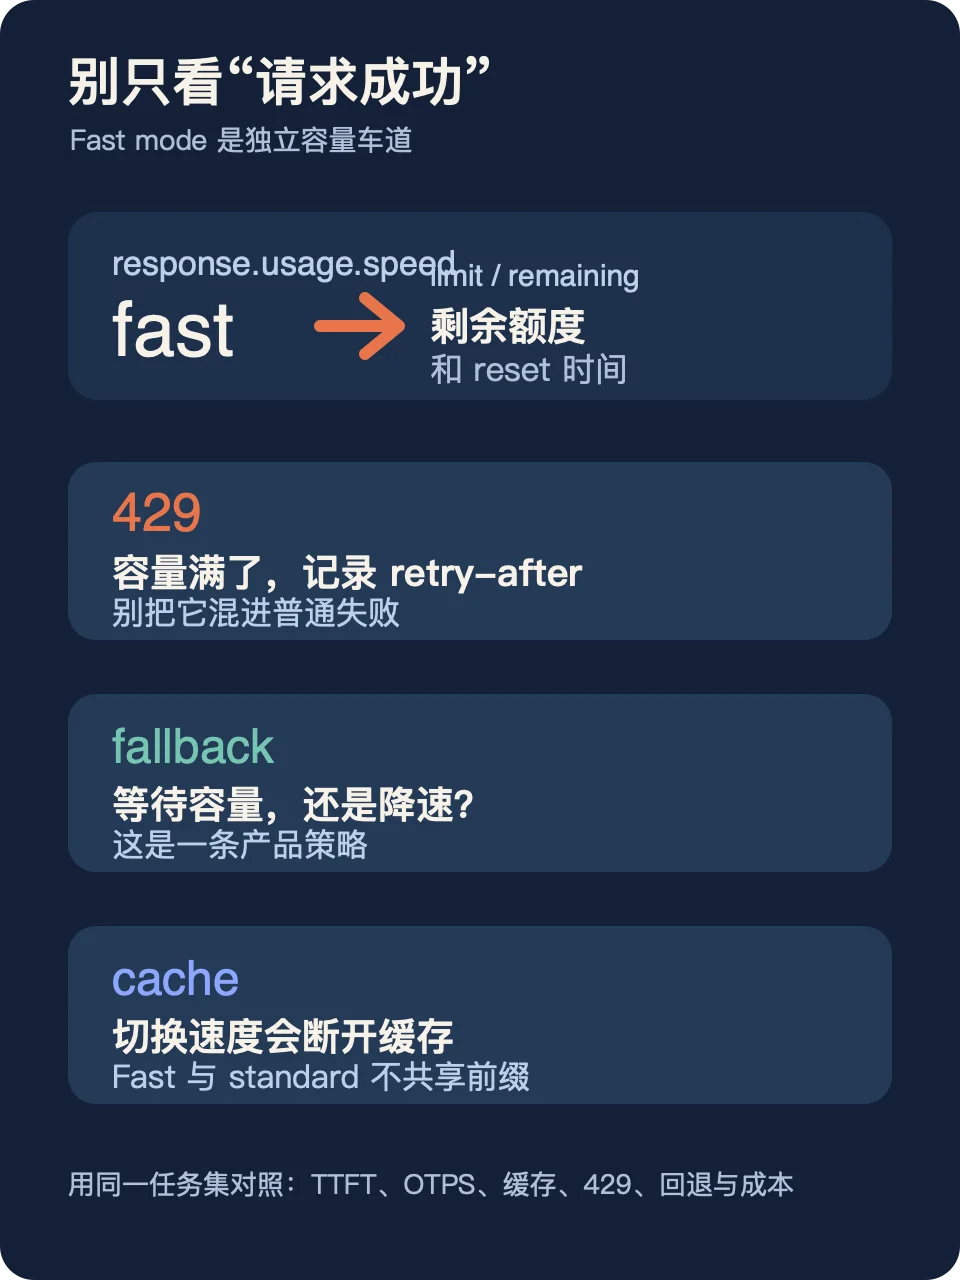
图:建议把 Fast mode 的限额和回退单独观测,不要混在总调用量里。
尤其别把“请求成功”当作验证完成。支持 fast 的请求成功后,usage.speed 才会明确显示 fast。官方还列出一个容易踩的例外:Claude Opus 4.6 即便收到了带 beta header 的 fast 请求,也可能正常返回,但实际按标准速度运行。把实际 speed 写进日志,比相信配置文件靠谱得多。
回退规则要比开关更早写
Fast mode 的价格、容量和缓存行为,决定它不适合只放一个布尔开关。至少要事先回答:遇到 429 时,是等服务器给的 retry-after,还是立刻降回标准速度?这两个选择对应的是两种产品承诺。
对用户正在盯着的交互任务,若页面已经展示了生成态,短暂等待也许可以接受;对必须及时给出下一步的编排任务,标准速度回退往往更稳。官方 SDK 默认会按 retry-after 自动重试最多两次。若想自己立刻切换,首次 fast 调用需要把自动重试设为 0,再只对限流错误降速重发。逻辑可以像这样:
def invoke(params):
    try:
        return client.with_options(max_retries=0).messages.create(
            speed="fast", **params
        )
    except anthropic.RateLimitError:
        return client.messages.create(**params)  # 标准速度回退
这不是要复制粘贴的生产代码。真实系统还要保留幂等键、取消信号、超时预算和对其他瞬时错误的默认重试;但“只在容量受限时降速,别把所有失败都吞成标准请求”这条边界最好固定下来。否则出一次网络错误,排障的人会误以为是 fast mode 自动回退,日志里却没有答案。
缓存会让“快”变成另一道算术题
最容易被漏掉的一项是提示缓存。官方说明,Fast 和标准速度之间切换会让缓存前缀失效,两条车道不共享。对于长上下文、重复系统提示和多轮 Agent 任务,这不只是一个小小的命中率波动;它会同时影响延迟和账单。
Opus 5.5 Fast mode 的公开价格为输入 $8/MTok、输出 $40/MTok,缓存与 data residency 的倍率还会继续叠加。价格规则本身不复杂,麻烦的是任务一会儿 fast、一会儿 standard 时,原本能复用的前缀也被切开了。
所以灰度时别只做一次短提示词的速度对比。选一组和真实业务相近的长上下文任务,分别记录 TTFT、OTPS、总时长、缓存命中、429 次数、回退比例和单次完成成本。Fast mode 的价值不该靠一句“体感很快”决定,而应看它有没有缩短用户真正等的那段时间,且没有把缓存损失和限流等待藏到账单后面。
我会把接入顺序压成四步:只挑一个长输出的交互场景;给它单独的路由标签;先把 usage.speed、限额头和回退原因接进日志;再用相同任务集跑标准与 fast 的对照。等这些数据稳定了,才值得扩大范围。
Fast mode 转正,解决的是“能不能把它当作一条正式车道”;它没有替团队回答“哪些请求值得走这条车道”。把这两个问题分开,才不会在下一次限流或缓存掉线时,才发现开关背后根本没有策略。
你们的 Agent 请求里,真正耗用户等待的是连续输出,还是工具和外部系统?
小岛 AI
记录一线实战、踩坑与成长