
Claude Code 换 Opus 5.5,省钱账该怎么验
降价幅度、订阅额度和完成一个任务的花费,是三笔不同的账。附五项费用算式与同任务对照模板,换模型前后都能用。
同样是让 Claude Code 改一个 Bug,你更愿意选单价低的模型,还是一次能改对的模型?
难就难在,付钱之前不知道谁能一次改对。最近 Opus 5.5 降价,给日常编码换主力模型多了一个理由。但真正有用的问题是,你手上的代码任务,换过去以后能不能更便宜地通过验收。
9 月 25 日,Claude 官方开发者博客发了一篇成本说明。有个小字很值得拎出来看,文中的交互计算器没有计入缓存写入。页面也明确说,数字里有按价格演算的示例,不能直接代表你的代码库。
好家伙,拿演示计算器做采购预算,少抄一行就可能算错。
我的判断是,Opus 5.5 值得放进日常编码的对照测试。但把它设成全队默认模型,要等同一批任务交卷再定。下面这套账,可以直接拿去对照。本篇做了价格算术核验,没有做两个模型的编码实测,后面的任务情境都是明确标注的假设。
价格表要抄全,缓存有两种动作
按 9 月 27 日核对的官方模型页面,Opus 5.5 标准 API 每百万 token 的价格分别是,普通输入 4 美元、输出 20 美元、五分钟缓存写入 5 美元、一小时缓存写入 8 美元、缓存读取 0.20 美元。这些是标准价,不能拿去覆盖另有定价的模式。
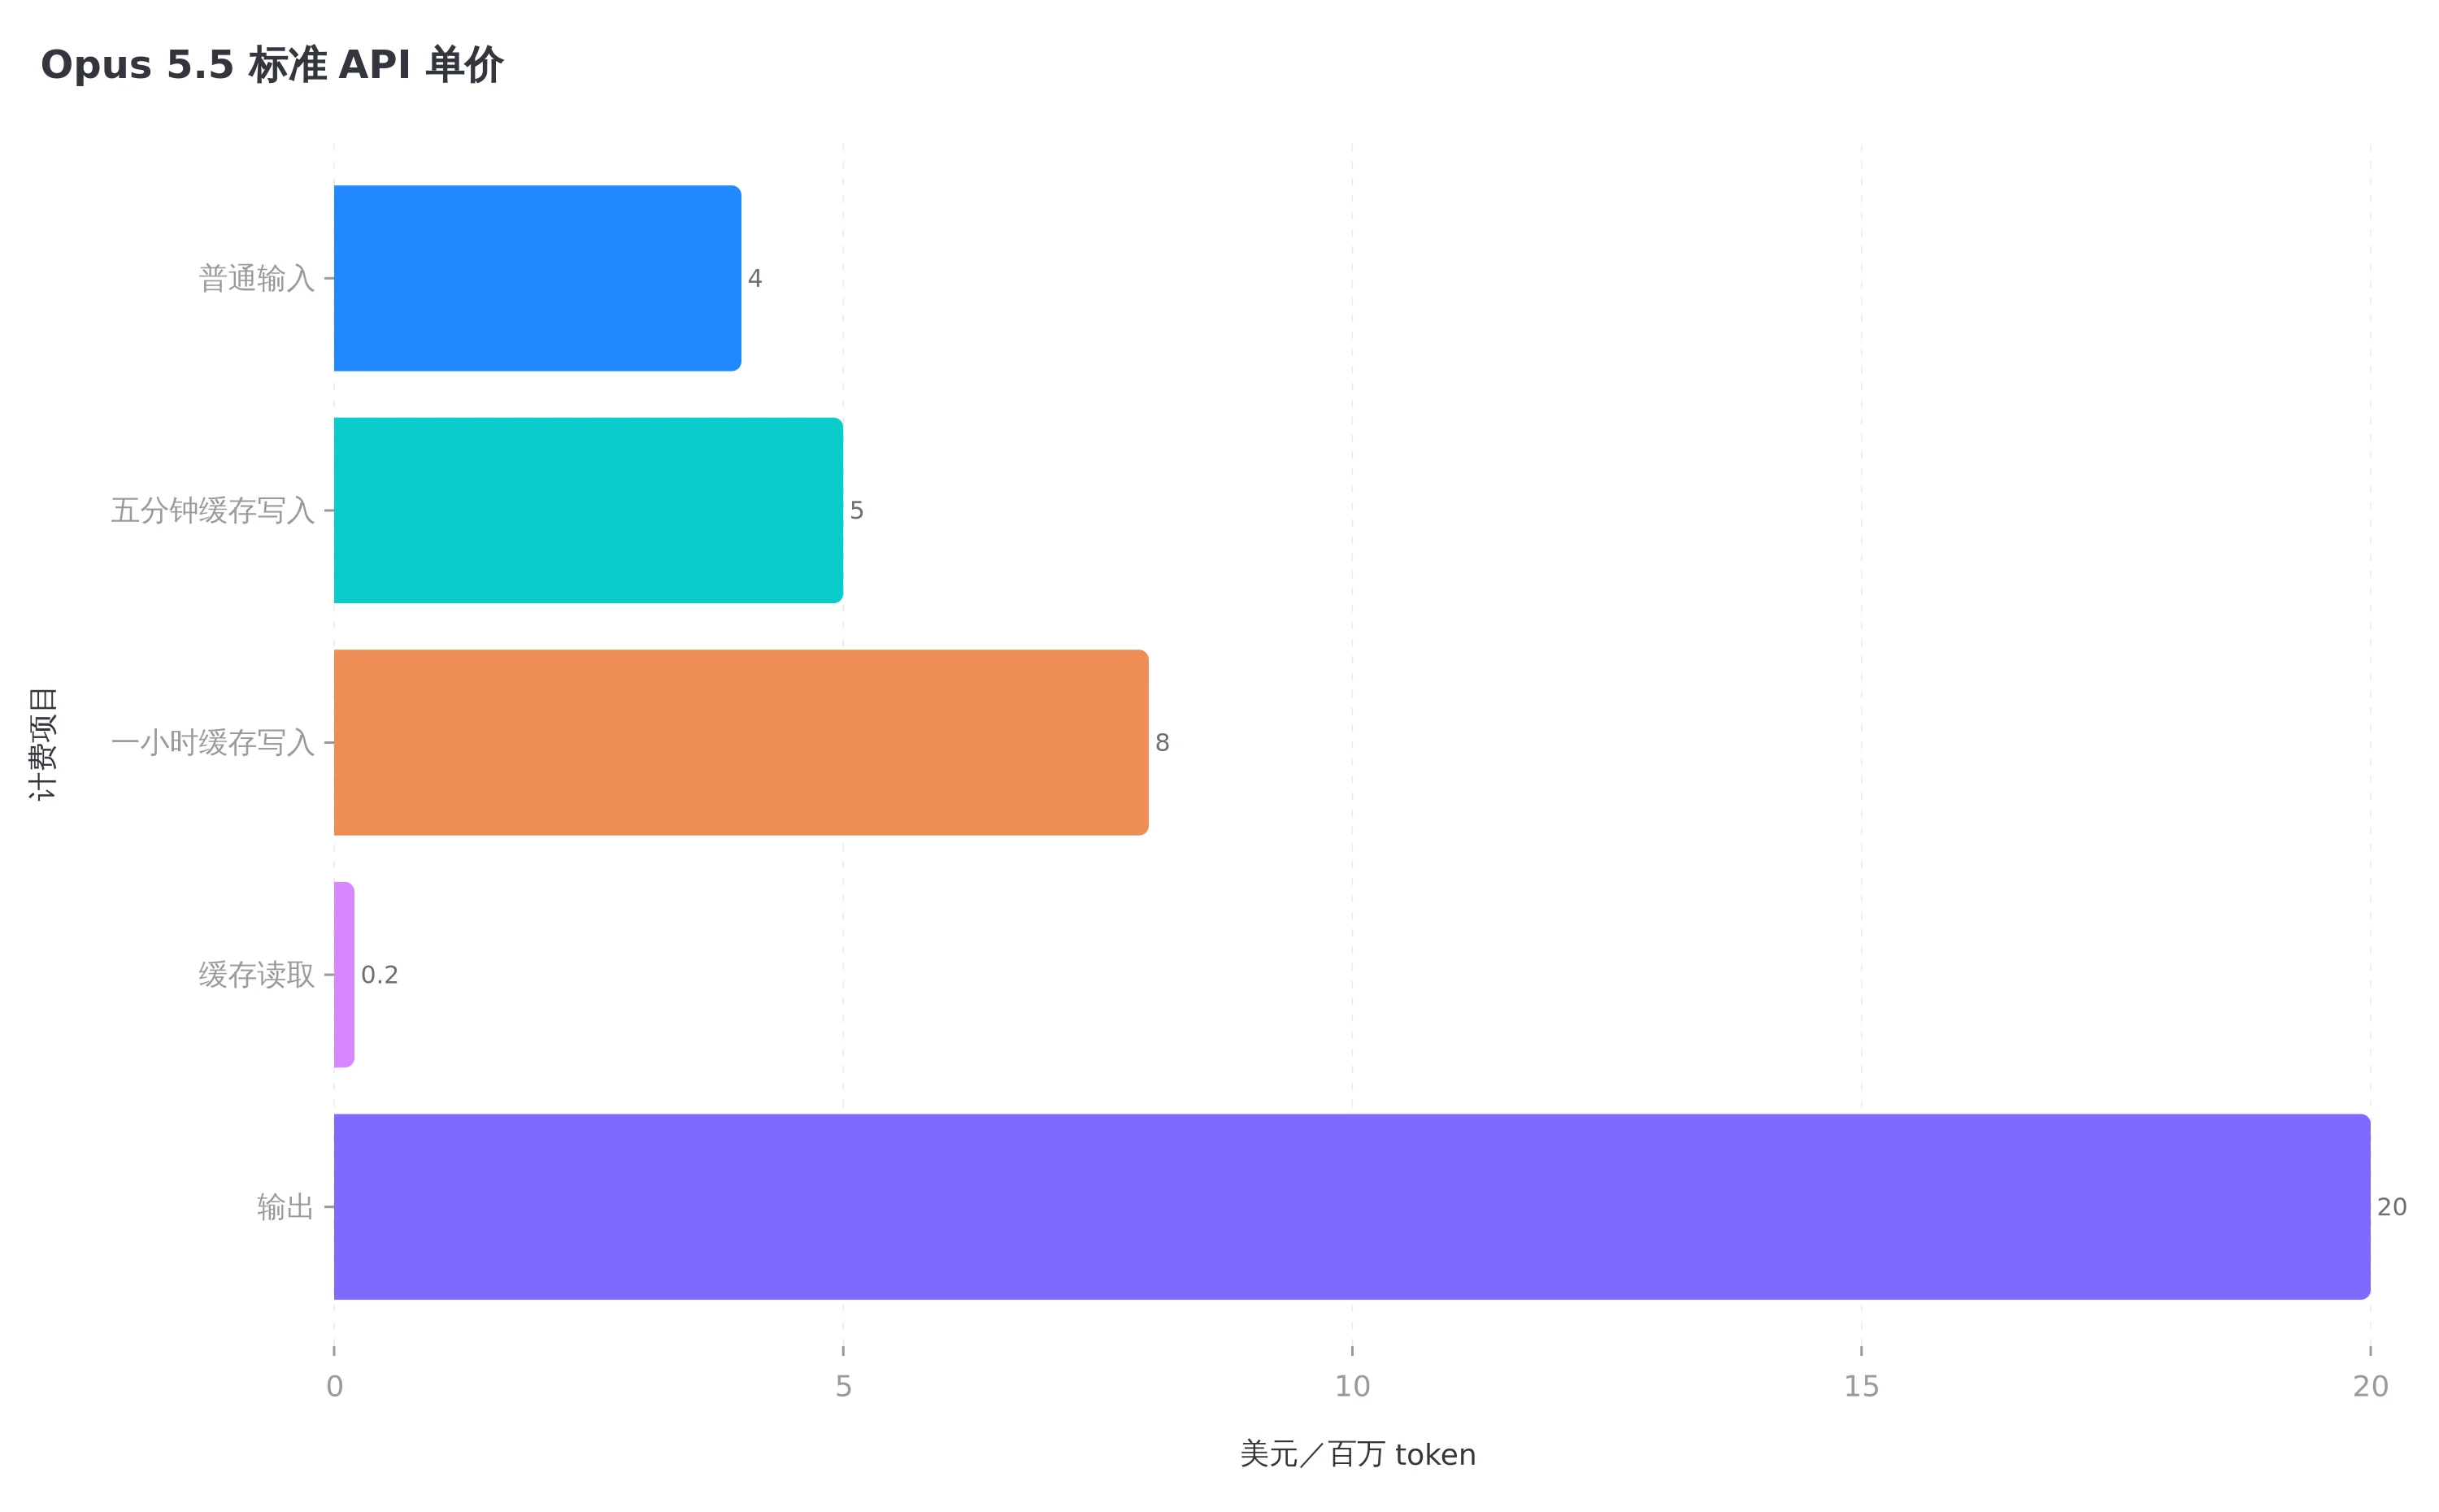
「写缓存」和「读缓存」容易被当成一件事。一个是把可复用内容存进去,另一个是后面的请求命中它。存进去有成本,后面复用才享受便宜的读取价。官方缓存文档把普通输入、缓存创建、缓存读取分开报告,创建部分还要分有效期。
你如果做后端,大概能理解这个区别。数据库查一次缓存很便宜,不代表构建缓存也免费。把请求里的所有输入 token 一股脑乘普通输入价,会失真;把所有重复内容都当作已命中缓存,也会失真。
这块得较真,因为一个会话的上下文大小,和整个任务累计处理的输入量也不是一回事。上下文是某一刻带着多少内容,任务总量要跨请求累计。把每轮用量混在一起再加一次会话汇总,还会重复计数。
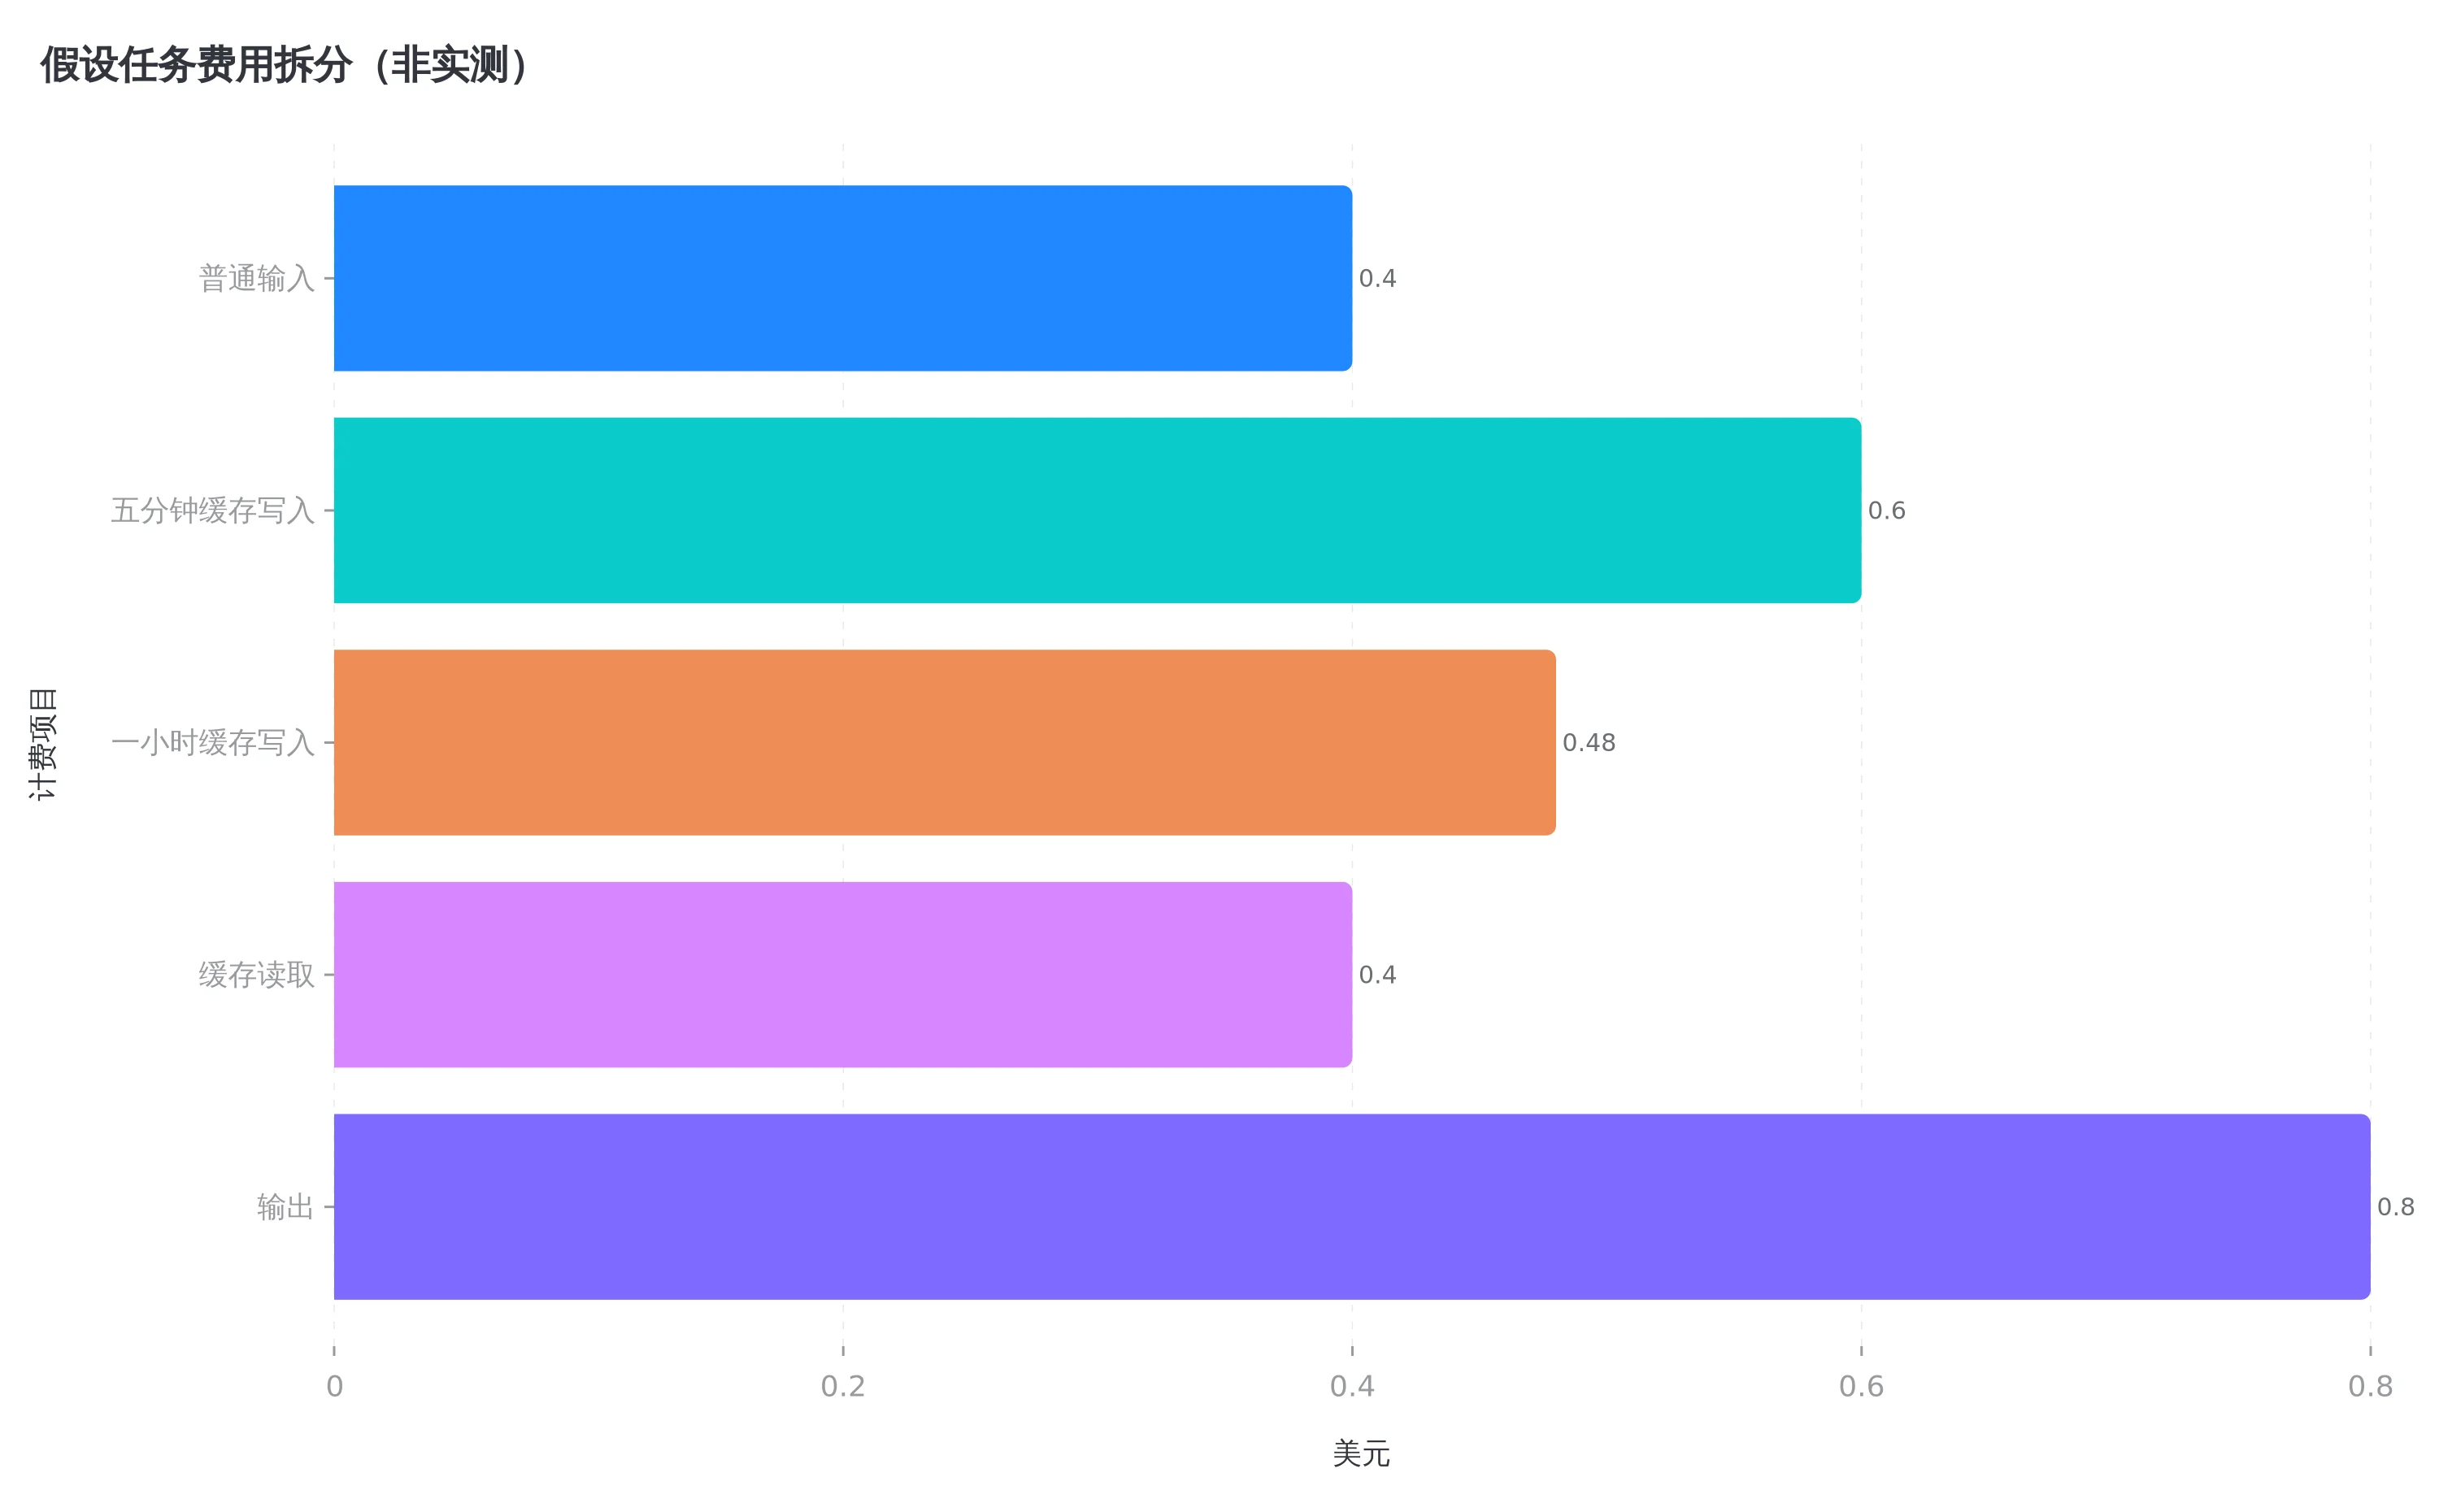
给一个我们自己设定的算例,便于检查公式,不代表典型用户。假设一项任务累计有十万普通输入、十二万五分钟缓存写入、六万一小时缓存写入、二百万缓存读取、四万输出 token。
五笔费用相加,是 0.40、0.60、0.48、0.40、0.80 美元,总共 2.68 美元。若完全漏掉缓存写入,两行共 1.08 美元就消失了,账面只剩 1.60 美元。这个差额来自我们设定的流量构成,不能说成所有人的账单都低估这么多。
下面这段可以复制到 Python 里算。五个输入量必须来自互不重叠的分类;不同平台的字段若已包含子项,要先确认口径再填,缺失就标缺失,别猜。
# 假设示例;替换成你的用量,单位为 token
fresh = 100_000
write_5m = 120_000
write_1h = 60_000
read = 2_000_000
output = 40_000
usd = (
    fresh * 4 + write_5m * 5 + write_1h * 8
    + read * 0.20 + output * 20
) / 1_000_000
print(f"{usd:.2f} USD")
这段只计算所列模型 token 费用。你任务里另付费的服务、运行机器、人员返工时间,都没有装进 2.68 美元。它解决的是「有没有漏掉计费分类」,不负责替你证明换模型划算。
模型便宜了,任务也可能没省下来
坦率讲,看价目表就宣布迁移成功,有点像只看云主机每小时多少钱,就决定数据库搬家。机器价格是确定的,应用到底要跑多久,还没测。
假设你要修改一个分页接口,验收包括旧参数兼容、空结果、边界页以及调用方能正常展示。模型 A 第一次交卷便宜,但只改了服务端。你指出前端还在传旧参数,再让它补一次;第二次测试又发现兼容分支丢了,继续补。此时每次单独会话都可能不贵,整张工单却越来越贵。
换成模型 B,第一次读得多一点,输出也多一点,把调用方和测试一起改完。B 是否更值,取决于最后的累计费用和结果,不能靠「思考得多」四个字直接判输。反过来,简单改一个固定文案,读遍仓库也可能只是白花钱。
我更愿意按任务分,而不是一次决定「所有代码都用谁」。机械修改、普通 Bug、跨模块迁移,要求模型做的判断不同。把它们混成一个均值,会把最需要关注的失败类型藏起来。
先挑你最近真的会做的几项工作,每种至少留一项。为了方便读者照做,这里给一份自行整理的对照记录,填项目名就能用,它不是官方模板。
任务名称与起始提交
完成条件与固定验收命令
模型、版本、平台、计费方式
effort 与其他运行设置
初始提示词、可见文件、可用工具
普通输入、两类缓存写入、缓存读取、输出
模型累计费用、外部服务费用
补做次数、人工介入内容、总耗时
最终验收结果与未解决项
运行时要从同一个代码起点开始。一个模型看着已经修好的测试和补丁,另一个从零排查,这样比出来的「更聪明」没什么说服力。测试数据、依赖和工具权限也尽量相同;一边拿到数据库连接,一边只能盯着报错猜,不公平。
还有一件小事,失败的会话也留在记录里。只统计成功那次,就把探索和返工的费用藏起来了。对日常工作而言,你的钱是真付了,时间也是真过去了。
我会把「同价目表重算」和「真实换模型运行」分开看。前者固定 token 用量,只回答降价本身能省多少;后者让模型真的工作,允许轮次、输出和失败次数变化,回答换模型后整项任务有没有改善。两张表都可以有,但列名要写清楚。
厉害了,表格里多留几个字段,比一句「便宜四成」更能帮助下周的自己做决定。
配置比较也得分清目的。如果想比较两个模型开箱即用的体验,就分别记录各自的默认设置。如果想看提高思考强度能否减少返工,就固定模型,只改一个设置。一次把模型、提示词、工具和验收方法都换掉,最后即使省了钱,你也说不清哪项变化起了作用。
失败判定也要提前写下来。例如规定最多补做几轮,或者到达既定时间预算就停止,记录当时进度。否则新模型一直跑到成功,旧模型却在第一次报错时被判失败,数字再精确也没用。这些停止条件是实验约定,不需要照抄别人的时长。
还可以留一列「人接手后做了什么」。手工补了一个参数,和重新理解整个模块,负担差得很远。不必急着把人的时间折成美元,但至少保留事实。模型费用低、人工补救明显增加的方案,适合个人愿意盯着用的场景,却未必适合后台无人看守的任务。
采购的人有时只想要一个最终结论。那就交两行结果,一行是通过验收的任务及累计费用,另一行是没完成的任务和失败位置。成功样本展示收益,失败样本决定使用范围。这比把所有运行揉成一个漂亮平均数,更接近要做的决定。
这里也有代价。做对照需要时间,不值得为每个小修小补都跑两遍。我的建议是,把它用在准备长期采用的新模型、团队默认配置变化,或近期费用明显异常时。已经稳定的任务,留下基本记录就够,不必把省钱实验做成新的工作负担。
订阅用户,还要换一本账
如果你用的是 Pro、Max 等订阅,看到终端里一个美元数字,先确认它在表达什么。Claude Code 成本文档区分了按 API 标价估算的用量成本与套餐使用情况。估算金额可以帮助比较消耗,不该直接拿来充当额外扣款凭证。
比如一个订阅用户想问「今天还能不能把这个需求做完」,最关心的是额度、是否触及限制和交付时间。API 用户问同一句话,还要关心后续调用会实际增加多少费用。两个人都在用 Claude Code,管理方式却不完全一样。
在任务结束后打开 /usage,留存模型与使用方式,记录当前会话用量以及套餐用量信息。账户实际收费仍以账单和对应套餐规则为准。你如果开了额外用量,尤其要把套餐内消耗和额外计费分开记录。
别嫌这个动作琐碎。过几天回头看,只有「花了两块多」这句笔记,你根本不知道那是 API 实付、订阅中的估值,还是少算了缓存写入的演示结果。模型都还没比较,计量单位先打起来了。
对准备迁移的团队,我会设一条朴素的通过线。相同验收条件下,多项代表性任务的完成质量稳定,累计费用或交付时间有明确改善,再逐步扩大使用。具体阈值让团队按自己的预算和上线节奏定,不拿别人的省钱比例当标准答案。
如果新模型总在某类任务上漏掉调用方,价格再好看,也要先缩小它的使用范围;如果它对常见 Bug 修得稳,而且返工更少,那就有理由让它成为这类任务的默认选择。结果允许有好有坏,不必给一整个模型打一个总分。
反正我觉得,降价最值得高兴的地方,是试用新能力的门槛低了。至于要不要全队迁移,让自己的任务给答案。
你现在更想压下去的,是 Claude Code 的账单,还是它做完以后你还得补的那一轮?