
九圈振幅跑通后,研究型 Agent 的验收线变了
Claude 完成九圈振幅,新闻里最重要的不是又多了一圈,而是结果同时留下了双路径、可下载产物和独立验算。长时 Agent 也该按这条线验收。
如果一个 Agent 连续跑了几天,收尾时往项目群里丢下一句「搞定了」,你敢把它合进主分支吗?
这不是抬杠。长任务最难的地方,从来不是让模型多跑一会儿,而是它跑完之后,谁来判断那堆产物到底能不能信。
Anthropic 刚公开了一件很适合拿来聊这个问题的事。Claude 在一个高度对称的理论物理模型里,把六粒子散射振幅从八圈推到了九圈。名字很长,没关系,先记住一个更工程化的版本,Claude 没有只交出一个「答案」,它还交出了两条计算路线、机器可读的结果文件,以及一位该领域教授的独立验算。
这一下就不只是「模型会做难题」了。
它碰到的是研究型 Agent 最硬的一根骨头,怎么把一段漫长、脆弱、没人能全程盯着的推理,变成别人可以复查的交付物。
这道题难在哪,先别被名词吓跑
这次算的是平面 N=4 超对称杨-米尔斯理论里的九圈六粒子散射振幅。散射振幅可以粗略理解成一套公式,用粒子的能量和动量去预测它们发生某种反应的概率。圈数越高,计算通常越接近完整描述,代价也会陡着往上爬。
物理学家 Matt von Hippel 在 Anthropic 的公开文章 里写得很实在,很多实际问题只算到两圈,能到三圈的已经不多,更高圈数往往卡在算力、代码和各种细小约束的组合地狱里。
但这不等于 Claude 给现实世界新添了一条物理定律。N=4 超对称杨-米尔斯是一个非常特殊的理论模型,它离真实世界很远,却因为对称性足够强,特别适合拿来磨计算方法。把它当成研究计算里的靶场,比把它当成宇宙说明书更靠谱。
好家伙,关键恰好在这里。
题目足够难,答案又足够清楚,领域里还留着一整套可以核对的约束和旧结果。对 Agent 来说,这类任务比「给我想个新理论」友好得多,也比普通 demo 严酷得多。

这张图来自原始研究文章。图像本身不是证据,真正的证据在可下载结果和验算路径里。
它不是蒙对了一次,而是留下了两条路
原文提到,Claude 分别走了直接 bootstrap 和经由 form factor 的间接路线。bootstrap 听着玄,其实很像一个极其凶残的数独。先列出满足已知结构的候选,再用各种边界条件、关系式和已有结论逐个淘汰,直到只剩下能同时通过检查的答案。
直接路线并不轻松。Lance Dixon 教授说,这类计算的配方很脆,只要某个细节错一位,整条链就可能垮掉,到头来只剩一片报错和一个大大的「为什么」。Claude 得自己把代码搭起来,把约束串起来,还得让任务一直往前走。
公开材料给了一组很难得的成本刻度。直接 bootstrap 路线的经典计算部分用 Python 和 SymPy 完成,大约相当于 96 个 CPU 跑一周,约 100 美元。算上长时间调用模型,每条完整路线对最终用户的成本约是一两千美元。
这两个数字别混在一起。100 美元说的是那段传统计算资源,一两千美元说的是整条长时模型工作流。把两个数硬加、硬比,都会把事情讲歪。
更有意思的是,Claude 没把两条路当成装饰。第二条 form factor 路线给了验证者另一套核对办法。Dixon 最终也主要通过由九圈振幅回推得到的 form factor 来检查结果。研究里最值钱的不是「再跑一遍同一份代码」,而是从不同结构绕回来,看看它们会不会在同一个答案上相遇。
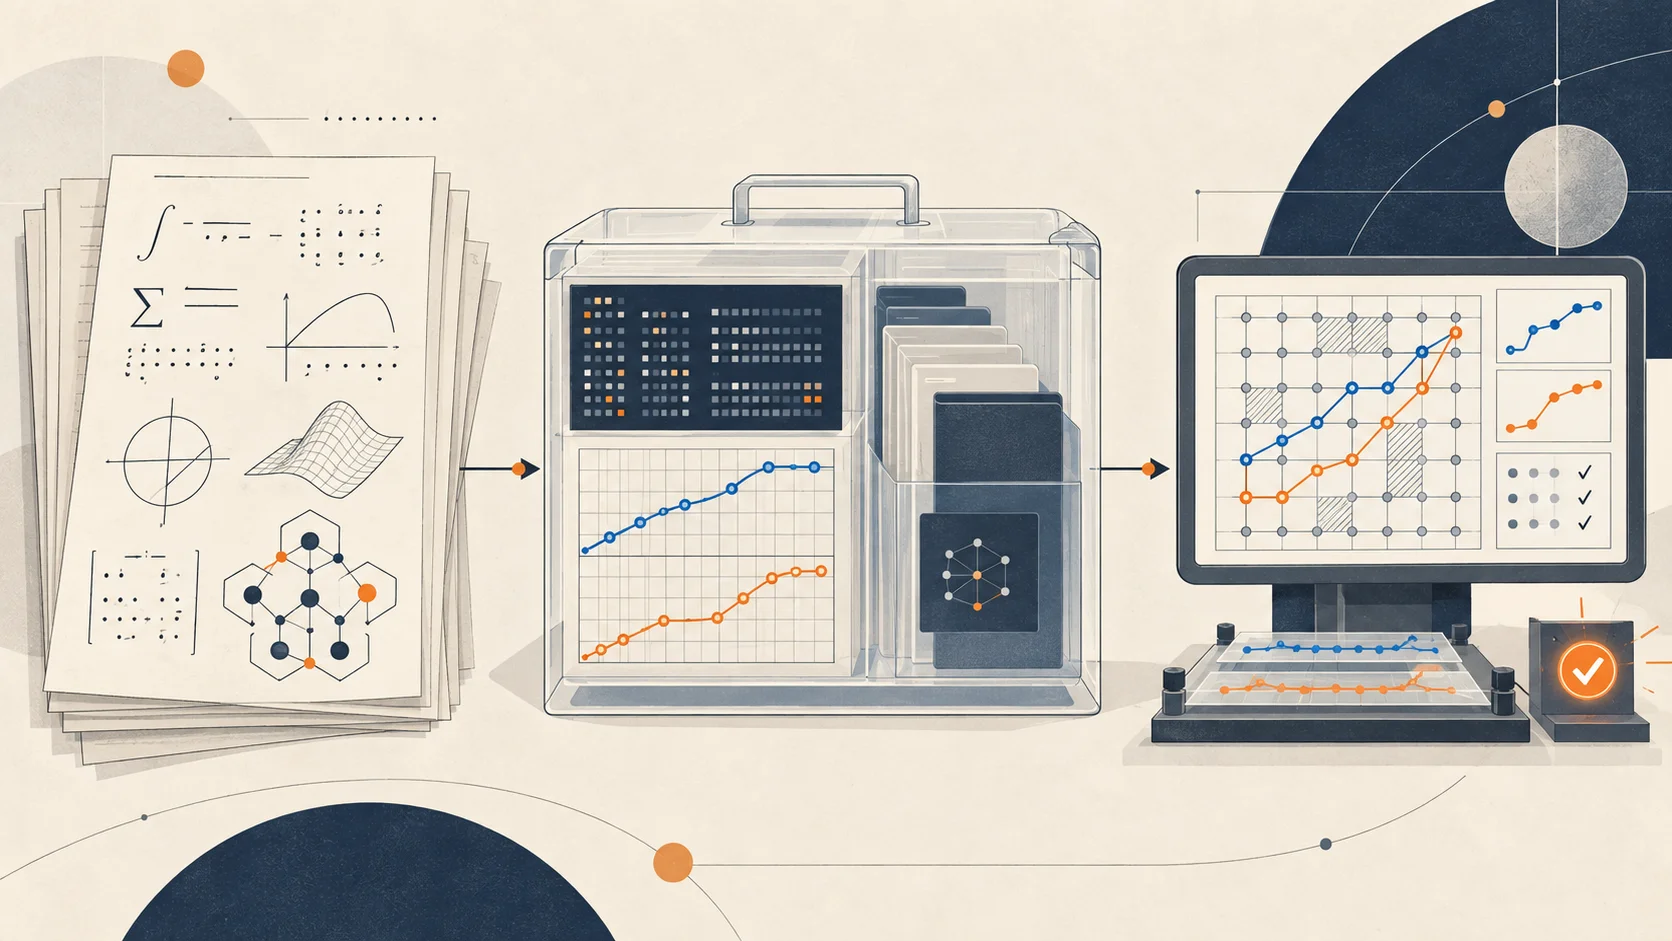
研究型 Agent 的交付,应该从候选答案一路走到可复跑文件和独立验证。
真正跨过去的,是验收线
我更愿意把这件事拆成三层。
第一层是候选答案。模型能写代码、调用工具、跑很久,随后给出一个看上去很漂亮的数或文件。这一层很热闹,也最容易被演示视频带跑。
第二层是可复核产物。此次结果被放到了 Cosmic9 页面,包括机器可读的九圈结果,并说明了它使用的约束和模素数认证方式。到这一步,别人不必信任 Claude 的叙述,可以拿着文件、方法和已知结构去检查。
第三层是独立验算。Dixon 不是把模型的长篇解释读一遍就点头,他用领域里已有的 form factor 关系去核查。这里面还有一个很朴素的事实,验算者早就有八圈结果、相关论文和自己的工具链。Claude 能跑得远,和人类社区先把路标、数据格式、验证器都铺好,缺一不可。
所以这次最该拿走的结论不是「以后科研不用人了」。恰好相反,能把研究 Agent 用到这一步的团队,往往是最早把人工判断编码进验收系统的团队。
厉害了,模型长出了长时间工作的耐力,但它还没有获得免检通行证。
这也是为什么官方文章里一个细节特别重要,中国科学院 Song He 团队也在并行推进九圈结果的一部分,并使用 GPT-6 协助计算约束。它提醒我们,别把一次成果归因成某个模型的神秘独门能力。题目本身、公开方法、已有代码、计算预算和验证环境,都是这次成功的一部分。
把这条线搬回自己的 Agent 项目
物理公式离多数工程团队有点远,可验收的结构一点也不远。
你让 Agent 做数据清洗、迁移数据库、批量改权限、排查线上事故,甚至只是改一大坨遗留代码,归根结底都在面对同一个问题,结果是不是能被不依赖它的东西检查。
我会先问四个问题。
任务开始前,有没有把输入、依赖版本、权限范围和成功条件冻结下来。没有这一层,过两天连「它当时看到了什么」都说不清,复跑只是玄学。
任务进行中,有没有留下能定位失败的中间产物。不是只留一份最终报告,而是保留关键命令、测试日志、数据快照、差异文件和工具调用记录。模型卡死、误读文件或走错分支时,团队需要能从半路把它捞回来。
任务结束后,有没有独立于主 Agent 的验证器。代码改动可以跑测试、静态检查和最小回归集。数据结论可以对照基线、抽样复算和异常阈值。权限变更可以由只读审计再走一遍。不要让同一个模型既出题又判卷,这事儿真的就是一声叹息。
收尾还得问,这次任务有没有留下成本和回滚边界。九圈计算把传统 CPU 成本和模型工作流成本分开写,工程项目也该这样。token、工具调用、人工复核时间和失败重试次数都要单独记。没有这些账,下一次你无法判断应该加预算、缩权限,还是干脆别让 Agent 碰这类事。
把它压成一句更方便贴在项目里的话,就是:
Agent 可以生成候选答案,但只有输入可重建、过程可追溯、结果可独立验证、失败可回滚时,它才算交付完成。
这不是要把每个小任务都搞成粒子物理。小修小补没必要弄一整套太空舱。可一旦任务会跨越数小时、触及真实数据、改动真实权限,或者它的结论会影响下一个决策,验收线就该往前推。
该保留的边界,比突破本身更重要
这项结果不是同行评审论文,也不能用它推出「模型已经会独立做所有科学」。原文是 Anthropic 邀请的客座文章,作者稿酬和验算者获得的 Claude 使用额度都公开披露了。披露本身是好事,但也提醒我们,新闻稿、公开展示、可复现文件和同行评审不是同一种证据。
另外,原文作者自己的判断也很克制。Claude 主要使用的是领域既有方法,并没有提出新的物理原理。它真正展示的是,在一个定义明确、约束丰富、验证工具成熟的前沿任务上,长时 Agent 已经可以把一套复杂配方执行到人类能检查的位置。
这已经够值得认真了。
以前我们会说,模型能写一段代码,不代表它能负责一个项目。现在还得再补半句,模型能跑完一个项目,也不代表它已经通过验收。
九圈只是一个特别醒目的例子。接下来更现实的问题是,你手里那条准备交给 Agent 的长任务,谁来当它的 Lance Dixon?