
用户数据进训练,Gboard 把隐私承诺做成了验收单
Google 在 Gboard 部署新一代 TEE 联邦学习系统。它不只说数据会被保护,还把访问策略、可复现构建、透明日志和恢复状态放进一条能检查的工程链路。
做一个会从用户数据里学习的 AI 功能,最难的往往不是把模型训起来。
而是产品评审临近结束,有人问了一句很实在的话。
“这些数据到底会去哪儿,谁能碰到,出了问题谁能证明没有乱碰?”
很多团队会拿出一份隐私说明。它当然必要。可说明写得再稳,也不等于线上真正跑着的系统遵守了它。模型训练、数据处理、密钥、重试、故障恢复,全都挤在一条链路里,任何一个环节变了,纸面上的承诺就可能只剩下纸面。
Google 10 月 2 日公布的 Gboard 联邦学习系统,做了一件很值得产品团队认真看的事。它没有把隐私当成事后贴上的标签,而是拆成了几条能够被检查的工程事实。
数据上传前在设备端加密。
设备预先同意哪些服务器端计算可以处理这些数据。
这套访问规则要出现在公开透明日志里。
密钥只交给符合规则的可信执行环境。
好家伙,终于不是一句“我们不会看”就结束了。
这里先把概念说人话。联邦学习不是把每个人输入过的内容直接打包上传,而是让很多设备在各自本地参与训练,再汇总训练结果。Google 以前就用它改进 Gboard 的下一个词预测。新一代系统把部分计算放到服务端的 TEE,也就是一段连服务提供方自己都不该随意窥探或篡改的隔离运行区。关键不在于 TEE 三个字多酷,而在于设备和审计者可以核验正在运行的工作负载是否符合先前的规则。
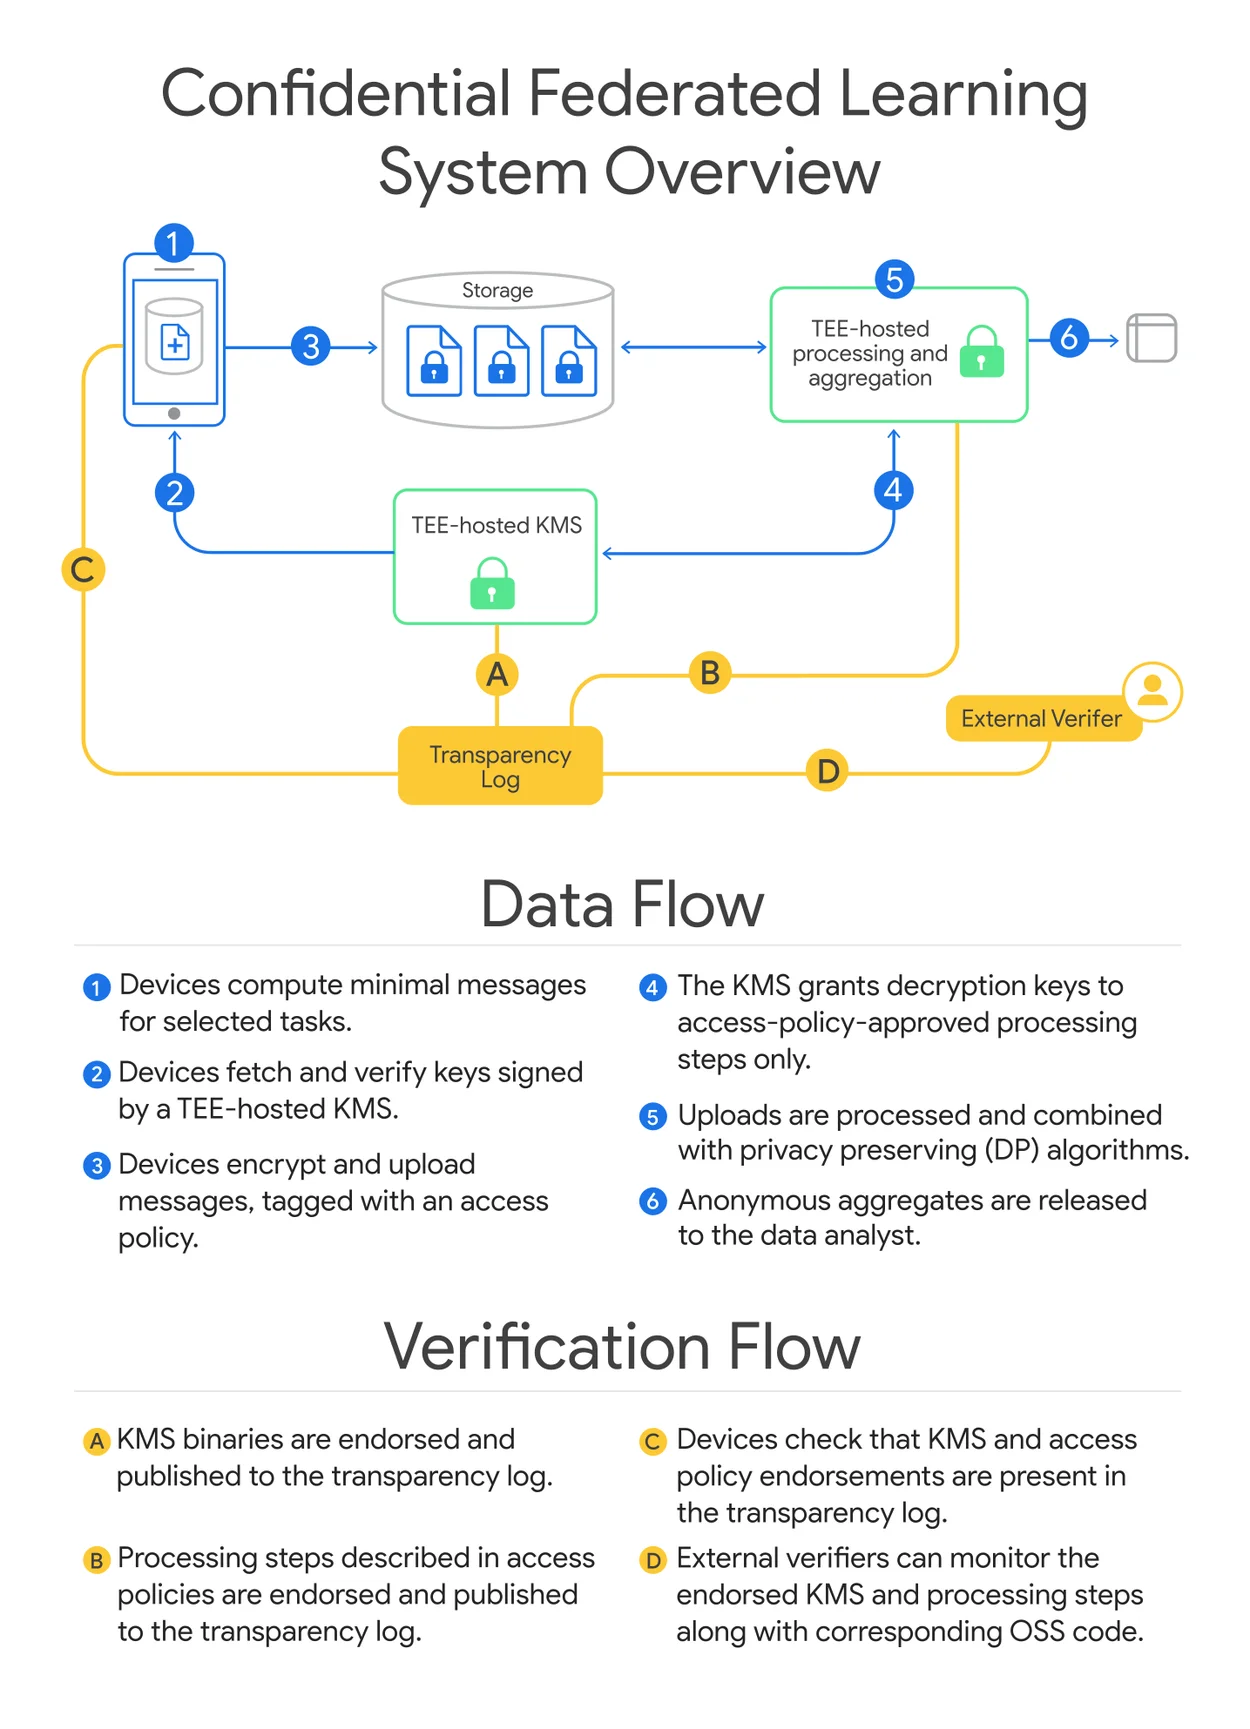
这张官方图最有价值的地方,不是组件多,而是把“谁能解密、跑什么程序、能输出什么”连成了一条可追溯的链。
隐私不是一层壳,是四张能对账的单子
Google 给完整的联邦学习系统列了四个目标,数据最小化、数据匿名化、透明与控制、可验证与可审计。前两个大家相对熟。少收一点数据,处理时加匿名化保护,听起来都没毛病。
麻烦在后两个。
假设你的团队做一个智能输入建议。用户设备先把训练样本加密上传,服务端再跑训练。此时真正要验收的不是“我们用了加密”,而是下面几个具体问题。
设备授权的到底是哪一类程序。
这次实际运行的二进制,是否就是被允许的那个版本。
模型训练中间产生的结果,是否只以约定的匿名化方式离开隔离区。
如果任务中断,恢复时会不会把同一份敏感数据多处理一次,或者换了一段没人审过的代码。
Google 的做法是,把访问策略发布到 Rekor 这类透明日志,再让 TEE 组成的密钥管理系统只向匹配策略的工作负载交付解密能力。数据处理程序和密钥管理程序还可以从公开代码中可复现构建。它们没有保证每个工程风险都消失,但至少把“相信我们”往“请检查这份证据”推了一大步。
有点子牛逼的不是加了一个新盒子,而是把盒子外面的规则也摆出来了。
这点对做产品的人很现实。很多隐私设计只会在上线评审里出现一次,之后数据管道、依赖、运行镜像和恢复脚本慢慢变了。若规则没有一份能跟运行物对上的证据,半年后再回头看,谁都说不清那句承诺还剩多少。
Gboard 的变化,给训练系统提了一个反问题
Google 已把这套系统用于英语和日语的下一个词预测。官方说,旧方式训练一个模型往往要一到两个月,瓶颈来自设备在线时间、设备端算力和多个任务争用同一批设备。新系统先收集设备上传,再在服务器端并行训练,当前主要受 TEE 资源约束。
官方图表来自 5000 轮训练、每轮 6500 台设备的英语下一个词预测实验。它显示,更灵活的设备参与计划可以在更强隐私或者更小噪声倍率下保持更好的效用。这里别把一张曲线直接翻译成“服务端训练更安全”。它证明的是这套具体系统在公开的实验条件里有更好的隐私效用权衡,系统能否被信任还依赖于策略、构建、密钥和运行时边界有没有一起成立。
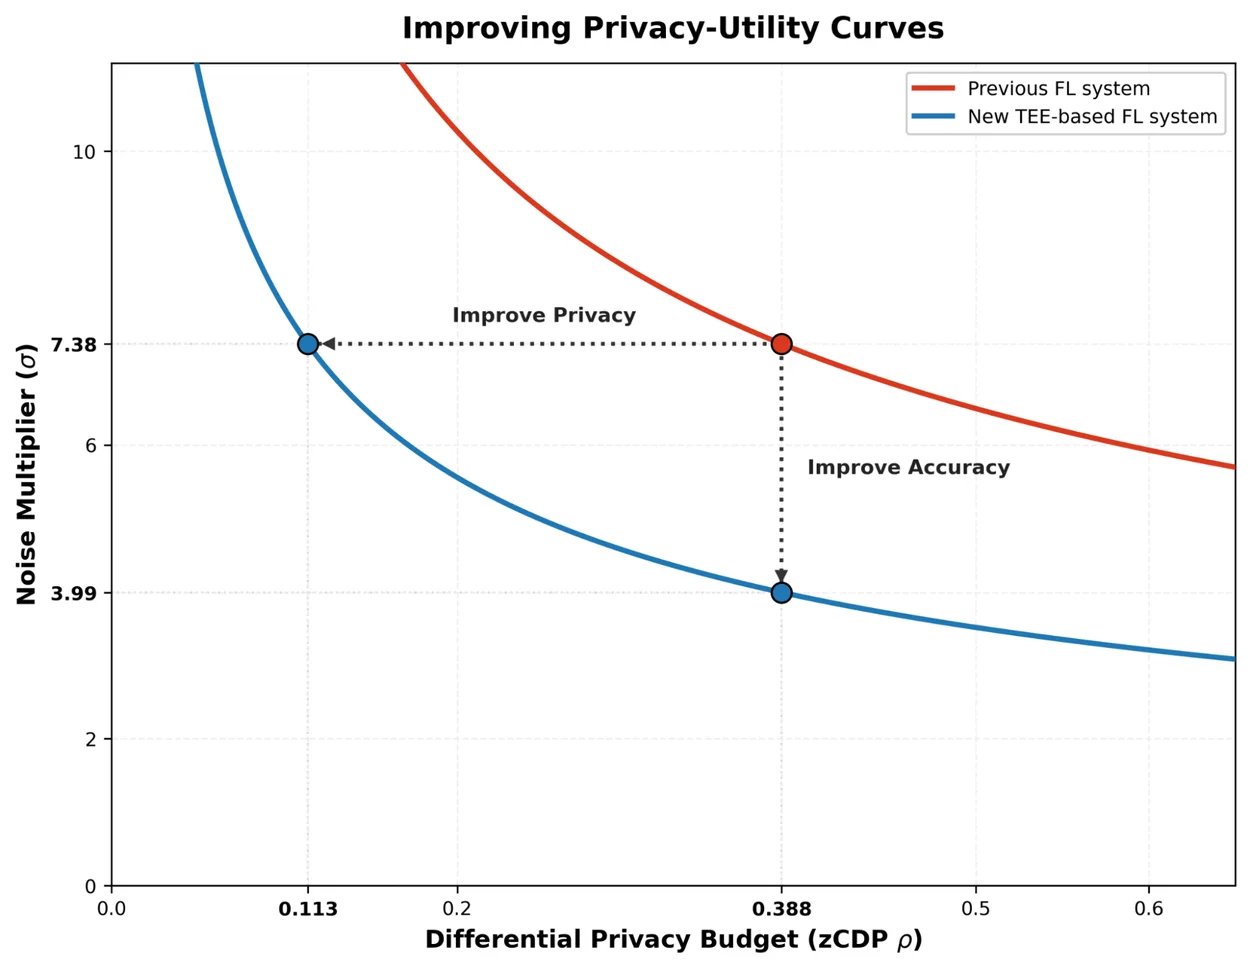
曲线只回答模型效果和隐私参数如何取舍。它替代不了对工作负载和恢复路径的审计。
所以真正值得问的反问题是。
如果我们也想把数据处理迁到更集中的服务器端,手里有什么东西能让用户、法务、内部安全团队和未来的自己检查?
不是“我们打算怎么做”。
是“当前这个部署究竟做了什么”。
Google 也没有装作 TEE 是终局。官方专门提到当前硬件限制与旁路观察风险,还把更强硬件、动态加载工作负载的研究列为下一步。这种边界说明反而很重要。严肃的隐私工程,不是把风险藏进免责声明,而是把尚未覆盖的风险也留在验收材料里。
把上线评审改成一张可跑的验收单
你不需要做一个 Gboard 规模的系统,才可以借这套思路。下次评审涉及用户文本、行为或设备数据的模型功能时,先试着写下面这张单子。
数据范围
哪些字段进入训练,保留多久,哪些字段永不进入

访问策略
允许哪些已命名的工作负载处理数据
策略变更由谁批准,记录在哪里

可验证执行
运行镜像、关键依赖和训练程序如何对应到可复现构建
密钥只会交给哪些受控运行环境

输出边界
训练过程可导出哪些聚合结果
哪些日志、样本和调试输出必须脱敏或禁止保存

故障恢复
中断后从什么状态恢复
如何避免重复处理和越权重试

未覆盖风险
当前 TEE、依赖供应链、旁路观察或人工运维还剩什么限制
这不是合规文档的换皮。它应该能被工程师拿去对应代码、镜像、日志和权限配置。哪一项没有证据,就不要把它写成已经做到。哪一项做不到,也别用模糊词糊过去,直接标成上线前必须补的风险。
还有一个容易被忽略的细节。Google 的系统允许为了保护专有模型结构,在运行时向程序侧载序列化信息。但官方给了边界,所有和隐私相关的逻辑仍必须硬编码在可审计的 Python 程序里。这很像一个朴素的工程原则。
可以保密的东西,和必须可被信任的东西,不该混在同一个黑箱里。
模型会越来越需要真实世界的数据来变好。用户也会越来越敏感地问,自己的数据到底替谁变好了。到那时,真正能让人放心的,不是承诺写得多温柔,而是每一条承诺能不能被拿出来对账。
如果你正在做一个会从用户数据持续学习的功能,你们现在最缺的是哪一张单子,数据范围、运行证据,还是故障恢复记录?